Unternehmen verarbeiten eine Vielzahl von Dokumenttypen, einschließlich Rechnungen, Bestellungen, Rechtsverträgen und technischen Handbüchern. Die manuelle Verarbeitung ist langsam, fehleranfällig und beansprucht geschätzte 15–25 % der Mitarbeiterzeit. Frühere Automatisierungsansätze (z. B. Robotic Process Automation (RPA), Optical Character Recognition (OCR) und Workflow-Tools) reduzierten einen Teil der Belastung, führten jedoch zu starren Pipelines, hohem Wartungsaufwand und isolierter Akzeptanz in einzelnen Geschäftsteams.
Dokumente weisen einen umfangreichen strukturellen Kontext auf (z. B. Tabellenhierarchien, räumliche Feldbeziehungen und querverwiesene Abschnitte), den die Flachtextverarbeitung nicht beibehalten kann. Durch das Entfernen eines Dokuments auf Nur-Text wird der Geschäftskontext verworfen, der die Extraktion genau und nützlich macht, was die Qualität von nachgelagerten Analysen, Rückschlüssen auf künstliche Intelligenz (KI) und Prozessautomatisierung beeinträchtigt.
Damit die intelligente Dokumentverarbeitung effektiv ist, müssen sie Dokumente nach Typ klassifizieren, strukturierte Daten genau aus Variablenlayouts extrahieren und diese Daten in einer geregelten, abfragbaren Form an nachgelagerte Systeme bereitstellen. IDPs müssen auch die Dokumentvariabilität im richtigen Maßstab verarbeiten, ohne dass für jedes neue Dokumentformat eine Konfiguration pro Vorlage erforderlich ist, und sie müssen zentralisiert und geschäftseinheitsübergreifend zugänglich sein. Diese Herausforderung wird durch das Volumen des Schlüsselproblems noch verstärkt: Unstrukturierte Daten machen etwa 80 % aller Unternehmensdaten aus und der Großteil wird in Dokumentform in Dateisystemen, Cloud-Speichern und Inhalts-Repositorys gesammelt, die sich außerhalb der Reichweite von Customer Relationship Management (CRM)-Systemen, AI-Agenten und Analyseplattformen befinden.
Bei der Data 360-Dokument-AI handelt es sich um die Salesforce-Dokumentverarbeitungsfunktion in Data 360, mit der diese Lücke geschlossen werden soll. Sie extrahiert, klassifiziert und analysiert unstrukturierte und halbstrukturierte Dokumentinhalte mithilfe von Large Language Models (LLMs), Optical Character Recognition (OCR), Natural Language Processing (NLP) und Machine Learning (ML). Bei der Ausgabe handelt es sich um strukturierte, gesteuerte und abfragbare Daten, die in die Data 360-Pipeline integriert werden, wo Agentforce-Agenten, Analysetools und Automatisierungs-Workflows über Standardschnittstellen darauf zugreifen können, ohne dass benutzerdefinierte Extrahierungs- oder Transformationsebenen erforderlich sind.
Enterprise-Datenplattformen verarbeiten strukturierte tabellarische Daten. Die meisten Unternehmensdaten werden jedoch als Dokumente erfasst und bleiben für CRM-, ERP-, AI-Agenten und Analyse-Pipelines unzugänglich, bis sie manuell extrahiert werden. Dies ist eine architektonische Lücke und kein Workflow-Problem.
Frühere Ansätze kombinierten die manuelle Neuschlüsselung, regelbasierte OCR- und RPA-Skripts. Diese Methoden funktionierten in kleinem Umfang, konnten jedoch das Volumen, die Vielfalt und die Geschwindigkeit der Dokumenttypen, die moderne Unternehmen generieren, nicht verarbeiten. Regelbasierte Tools erfordern explizite Vorlagen pro Layoutvariante. Jede Formatänderung unterbricht die Extraktion und erfordert einen Entwickler, eine neue Vorlage und einen Bereitstellungszyklus.
Im großen Maßstab führt dies zu anfälligen Punktlösungen ohne zentralisierte Verwaltung, gemeinsames Schema und Pfad zur AI-Bereitschaft. Inkonsistente Extraktionspipelines werden nachgelagert übernommen. Anders ausgedrückt: Analysen übernehmen Dateninkonsistenzen, AI-Modelle produzieren unzuverlässige Ausgaben und regulierte Inhalte wie Persönliche Gesundheitsinformationen (PHI) und Persönlich identifizierbare Informationen (PII) weisen keine systematische Steuerung auf.
LLMs extrahieren Felder ohne explizite Vorlagen. Eine einzelne Schemakonfiguration steuert die Extraktion über Layoutvarianten, Sprachen und Formate hinweg, die sich an das Dokument anpasst, statt das Dokument an eine feste Struktur anzupassen. Dadurch wird die Dokumentverarbeitung von einem wartungsintensiven, isolierten Vorgang zu einer gesteuerten, zentralisierten Funktion verschoben.
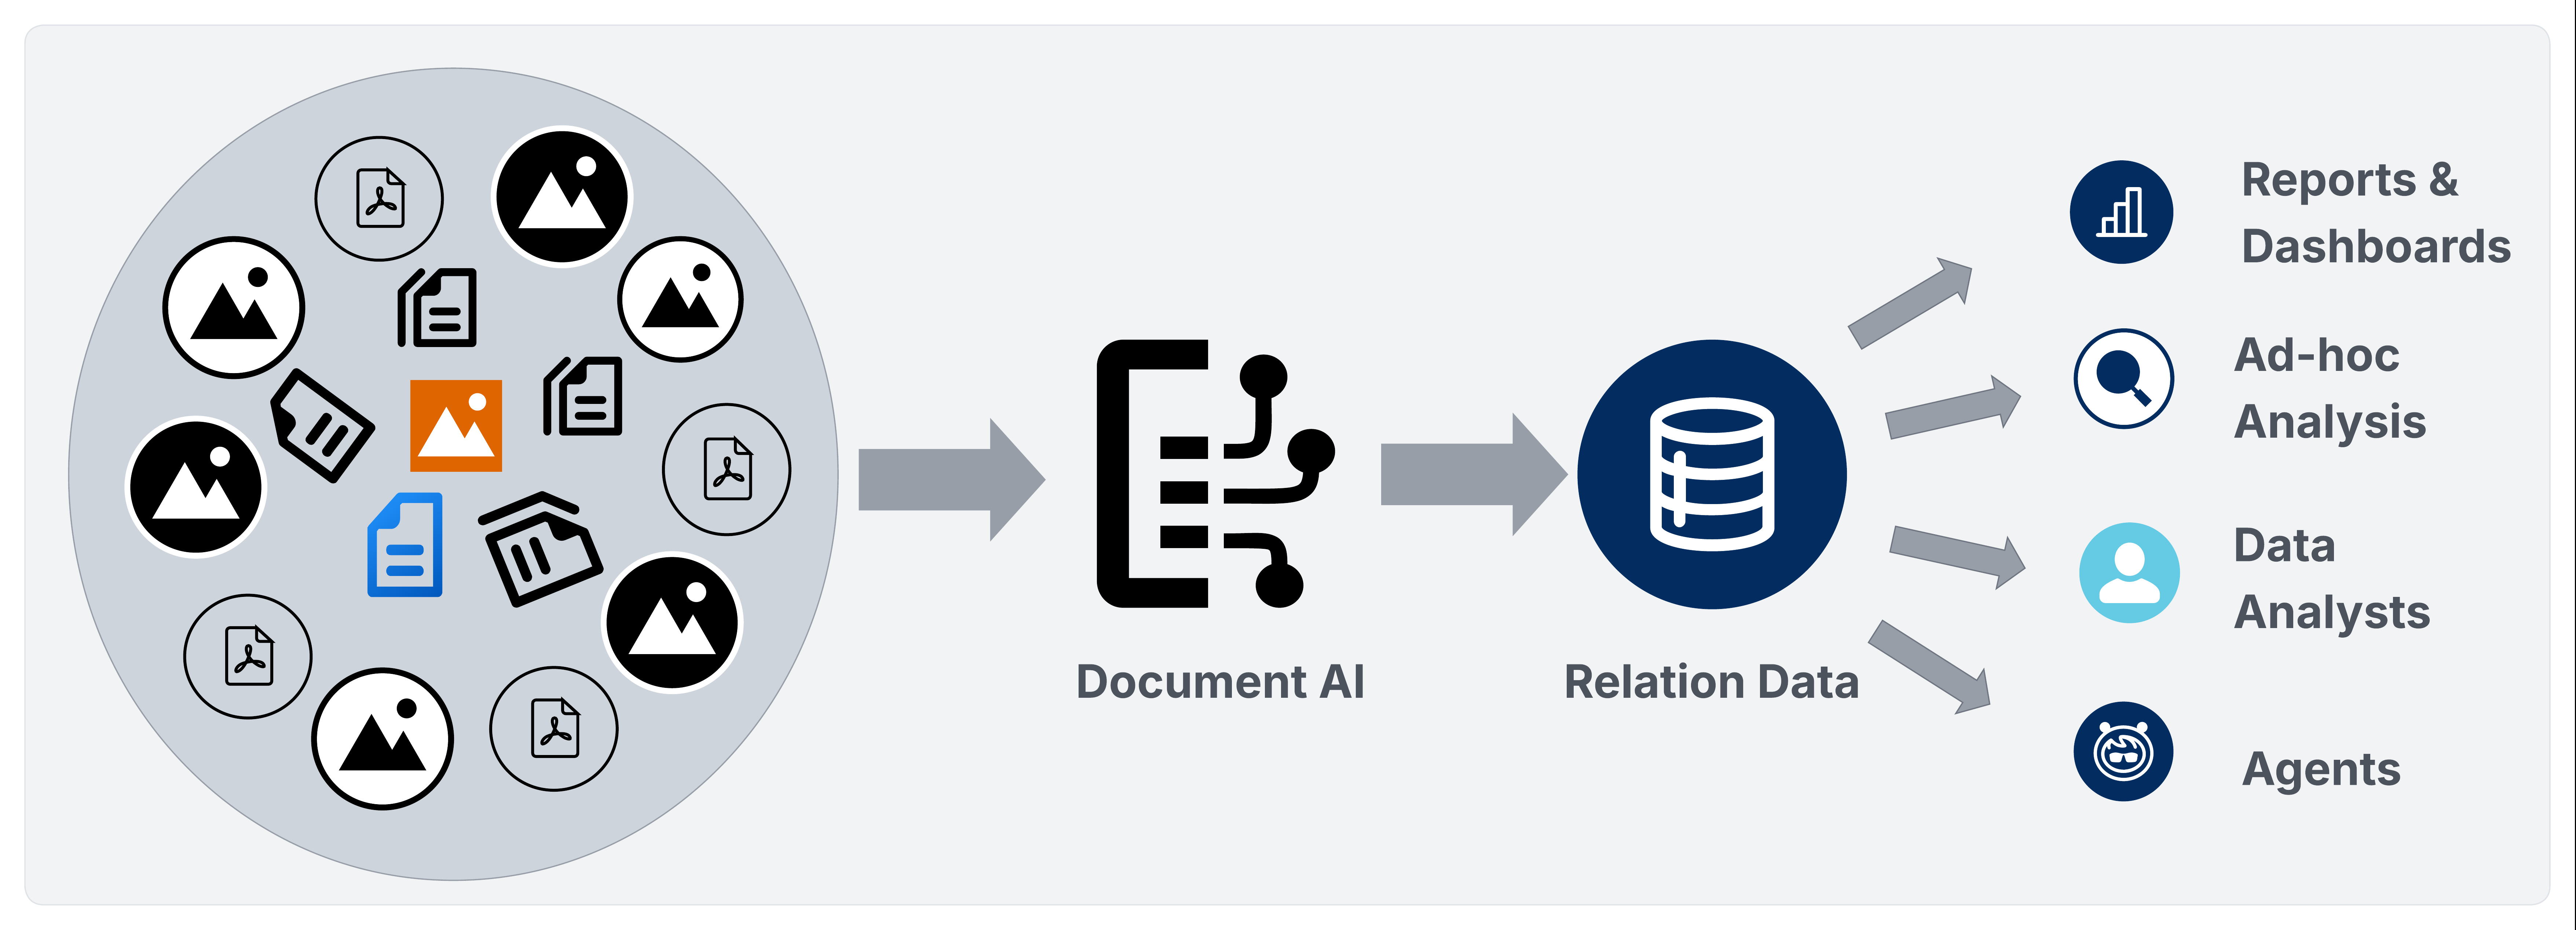
Die Dokumentverarbeitung auf der Data 360-Plattform wird über zwei Pipelines von der Data 360-Dokumenten-AI operationalisiert.
- Die Batch-Pipeline leitet extrahierte Daten durch die Aufnahme, Identitätsbestimmung, berechnete Statistiken, Aktivierungen, Analysen und Agentforce Aktivierung weiter.
- Die Transaktionsverarbeitungspipeline stellt eine REST-API bereit, die strukturierte JSON synchron zurückgibt. Dadurch können Architekten dokumentenabgeleitete Daten an Salesforce-SObjects, die Pipeline Data 360 Data Lake Object / Data Model Object (DLO/DMO) oder externe Datenbanken und Lagerhäuser ohne Batch-Setup-Aufwand weiterleiten.
In beiden Fällen werden extrahierte Daten in ein geregeltes, schemagesteuertes Modell und nicht in einen fragmentierten Satz von Punkttools eingegeben.
Bei der Data 360-Dokumenten-AI handelt es sich um die native Salesforce-Funktion für die intelligente Dokumentverarbeitung auf der Data 360-Plattform. Sie wandelt unstrukturierte und halbstrukturierte Dokumentinhalte in geregelte, abfragbare Daten um, die während des gesamten _Data 360-_Lebenszyklus vollständig beteiligt sind.
Bei der Data 360-Dokumenten-AI handelt es sich um die native Salesforce-Funktion für die intelligente Dokumentverarbeitung in Data 360. Sie nimmt unstrukturierte und halbstrukturierte Dokumente auf, extrahiert strukturierte Daten mithilfe einer deklarativen Schemakonfiguration und stellt diese Daten zur Harmonisierung, Identitätsbestimmung, Analyse und Agentforce Aktivierung an die Data 360-Pipeline bereit.
Data 360-Dokument-AI unterstützt zwei Verarbeitungsmodalitäten:
- Verarbeitung von Massenvorgängen: Verarbeitet große Dokumentsets, die in _Unstrukturierten Datenmodellobjekten (_UDMOs) definiert sind, ereignisgesteuert.
- Transaktionsverarbeitung: Verarbeitet ein einzelnes Dokument über die REST-API und gibt synchron eine strukturierte _JSON-_Nutzlast zurück. Architekten können diese Nutzlast dann über MuleSoft, Apex Callouts oder Einstein Trust Layer (ETL)-Pipelines an die Data 360 DLO/DMO-Pipeline, Salesforce-SObjects oder externe Datenbanken und Lagerhäuser weiterleiten. Die Zielklasse ist eine architektonische Entscheidung, die von Latenz-, Governance- und Datenresidenzanforderungen gesteuert wird.
Die Dokument-AI unterstützt derzeit PDF-Dateien, Bilddateien (JPEG, PNG) und handschriftliche Dokumente.
Die AI von Data 360-Dokumenten vereint vier Verarbeitungstechnologien in einer einzigen geregelten Pipeline. Jede Komponente verarbeitet eine unterschiedliche Phase des Lebenszyklus von Dokumenten zu Daten:
- Optische Zeichenerkennung (OCR): Wandelt gescannte Bilder, handgeschriebene Inhalte und bildbasierte PDFs vor der LLM-Verarbeitung in maschinenlesbaren Text um. Für eine zuverlässige Extraktion werden mindestens 150 DPI empfohlen.
- Large Language Models (LLMs): Leiten Sie die Extraktion mithilfe des vom Benutzer ausgewählten Modells durch das Einstein LLM-Gateway weiter. Der LLM empfängt die OCR-Ausgabe zusammen mit der _JSON-_Schemakonfiguration und gibt eine strukturierte Extraktionsnutzlast zurück. Gemini- und zusätzliche Modelle sind für die zukünftige Implementierung geplant.
- Natürliche Sprachverarbeitung: Führt Kontextverständnis, Einheitenerkennung, Datumsanalyse und semantische Feldextraktion direkt in der LLM über strukturiertes Aufforderungs-Engineering durch – die schemadefinierte Aufforderung und die OCR-Ausgabe dienen als einzige Eingaben. Alle LLM-Interaktionen werden über das ETL weitergeleitet. Dadurch wird eine Datenaufbewahrung von null bei Modellanbietern erzwungen und personenbezogene Daten werden in textbasierten Eingaben maskiert, bevor sie das Modell erreichen. Es wird kein separates NLP-Modul verwendet.
- Multimodale Verarbeitung: Verarbeitet eingebettete Bilder in PDFs als separate Extraktionseingaben, wodurch die LLM Daten aus Diagrammen, bildgerenderten Tabellen und Seiten mit gemischtem Inhalt extrahieren kann, die OCR allein nicht analysieren kann.
Zusätzlich zu den vier Verarbeitungstechnologien verarbeitet die Dokument-AI auch Folgendes:
- Einstein Trust Layer: Leitet alle LLM-Interaktionen durch das ETL weiter, wodurch die Aufbewahrung von Daten mit Modellanbietern null wird und personenbezogene Daten maskiert werden, bevor Eingaben das LLM erreichen. Dies gilt jedoch nicht für multimodale Daten (z. B. angehängte Dokumente, die über die Dokument-AI verarbeitet werden), bei denen die Maskierung personenbezogener Daten derzeit nicht unterstützt wird und Daten unverändert an externe Modelle gesendet werden. Das ETL steuert nur den LLM-Interaktionspfad. Extrahierte Daten, die in Data-Lake-Objekte (DLOs) geschrieben werden, werden unverändert gespeichert. Die Maskierung auf Feldebene im Leerlauf muss über nachgelagerte Steuerelemente für die Datenverwaltung behoben werden.
- Obergrenzen für Dateigrößen: Die Dokument-AI verarbeitet Dateien mit einer Größe von bis zu 10 MB pro Anforderung. Obergrenzen für die LLM-Kontextlänge können die Verarbeitung für dichte, mehrseitige Dokumente innerhalb dieser Grenze weiter einschränken.
Unternehmensarchitekten, die Data 360-Dokument-AI bereitstellen, sollten diese Prinzipien anwenden, bevor sie sich auf ein Implementierungsdesign festlegen.
- Wählen Sie die Pipeline aus, bevor Sie das Schema entwerfen. Die Pipelines für die Batch- und Transaktionsverarbeitung unterscheiden sich hinsichtlich Aufnahmemodell, Schemabindung, Zielflexibilität und Latenz. Es ist wichtig, zu überprüfen, welche Pipeline für jeden Anwendungsfall erforderlich ist, bevor Sie das Schema definieren, da die Nachrüstung vermeidbare Nacharbeit hinzufügt.
- Entwerfen Sie Schemas auf Dokumenttypebene. Die Verwendung eines einzelnen, gut ausgearbeiteten Schemas pro Dokumenttyp ist pflegeleichter als die Verwendung von Konfigurationen pro Anwendungsfall und zudem der größte Hebel für die Extraktionsqualität. Um dies richtig zu tun, müssen Sie eine Vielzahl von Dokumenten – einschließlich Edge-Kundenvorgängen – verwenden, statt sie anhand eines einzelnen Beispiels zu entwerfen. Verwenden Sie Eingabeaufforderungen iterativ auf Feld-, Tabellen- und Schemaebene, um Lücken zu finden, und testen Sie sie dann und verfeinern Sie sie anhand mehrerer Dokumentbeispiele, bevor Sie sie abschließen. Beachten Sie, dass ein Schema, das für ein Dokument gut funktioniert, bei anderen möglicherweise zu kurz kommt. Daher sind Breite und Iteration unerlässlich. Ebenso wichtig ist die Flexibilität des Schemas, einschließlich des Entfernens von Spalten, die nicht zuverlässig über Dokumenttypen hinweg extrahiert werden. Das Festhalten an Feldern, die zu Rauschen oder Inkonsistenzen führen, untergräbt die Gesamtextraktionsqualität. Daher ist es wichtig, die Spaltenentfernung als erstklassige Designentscheidung zu behandeln.
- Wählen Sie die richtige Zielklasse pro Feldgruppe aus. Felder, die CRM-Workflows oder -Genehmigungen steuern, werden in SObjects geschrieben. Felder, die das zusammengeführte Profil anreichern oder Analysen einspeisen, gehören zur _DLO/DMO-_Pipeline. Felder, die externe Systeme bereitstellen, gehören zur _RDBMS-_Klasse. Beachten Sie, dass ein einzelnes Schema möglicherweise mehrere Stufen gleichzeitig umfasst.
- Erzwingen Sie die Verwaltung, bevor Sie regulierte Inhalte verarbeiten. Regulierte Daten müssen auf jeder Ebene geschützt werden. Daher ist es wichtig, die personenbezogene Maskierung, Datenklassifizierungs-Tags und die attributbasierte Zugriffssteuerung zu konfigurieren, nachdem extrahierte Daten in den Ausgabe-Data-Lake-Objekten (DLOs) gespeichert wurden Dies bietet eine optimierte Erzwingung und kontextbezogenen Zugriff, der auf der Datenklassifizierung, der Benutzerrolle und dem Organisationskontext basiert. Die Governance ist auf zwei Pfade aufgeteilt: Das ELT steuert die LLM-Interaktion, während die extrahierten Daten, die in DLOs gespeichert sind, separat – direkt auf DLO- und Datenbankebene – über Datenbereichskonfigurationen, Berechtigungssätze und _ABAC-_Richtlinien verwaltet werden müssen. Diese Steuerelemente müssen die Konsistenz auf der Speicherebene – nicht nur auf der Anwendungsebene – aufrechterhalten, sodass die Zugriffsbeschränkungen intakt bleiben, unabhängig davon, wie nach der Aufnahme auf Daten zugegriffen wird. Beachten Sie, dass Lücken in einer beliebigen Ebene regulierte Daten nachgelagert offenlegen können, selbst wenn andere richtig konfiguriert sind.
- Design für Fehlermodi vor der Produktion. Berücksichtigen Sie die Akzeptanz von Nullfeldern, OCR-Qualitätsschwellenwerte, die Vorvalidierung der Dateigröße, den LLM-Kontextüberlauf, die RDBMS-Schreibidempotenz und Obergrenzen für das Gutschriftsbudget vor der Ausführung des ersten Produktionsbatches. Hierbei handelt es sich nicht um Edge-Kundenvorgänge, sondern um vorhersehbare Fehleroberflächen, die explizit im Pipeline-Design behandelt und während der Laufzeit nicht erkannt werden müssen.
- Behandeln Sie Konfidenzbewertungen als erstklassiges Weiterleitungssignal und nicht als Diagnosenachbearbeitung. Extraktionsergebnisse enthalten Konfidenzwerte auf Feldebene, die aus den Protokollwahrscheinlichkeiten (logprobs) der zugrunde liegenden Modellausgabe abgeleitet werden. Für jedes extrahierte Feld, jede extrahierte Tabelle oder jede extrahierte Spalte spiegelt die Bewertung die Sicherheit des Modells auf Tokenebene für den extrahierten Wert wider. Dadurch werden Konfidenzbewertungen zu einem statistisch fundierten Signal, das zuverlässig genug ist, um als primäres Tor für Eskalationsschwellenwerte vom Typ “Human-in-the-Loop” zu fungieren. Verwenden Sie Konfidenzbewertungen, um systematisch Extraktionen mit geringer Qualität zu identifizieren und HITL-Prüfpunkte für Feldwerte mit geringer Konfidenz, mehrdeutige Schemaübereinstimmungen oder wiederholte Pipeline-Fehler zu initiieren, statt sich auf Heuristiken oder manuelle Stichprobenüberprüfungen zu verlassen. Wenn eine automatisierte Wiederherstellung nicht möglich ist, wird durch die HITL-gestützte Konfidenzbewertung sichergestellt, dass das menschliche Urteilsvermögen genau dort angewendet wird, wo es benötigt wird.
- Entwerfen Sie Aktivierungspfade parallel zum Schemadesign. Der Wert der Dokument-AI besteht darin, extrahierte Daten in Salesforce-Workflows und -Agenten aktivieren zu können. Damit können Sie Agentforce Aktionen, Flows und berechnete Statistiken zusammen mit dem Entwurf des Extraktionsschemas entwerfen und nicht erst danach.
Die Dokument-AI funktioniert in zwei Pipelines:
- Eine _Batch-_Pipeline für die Verarbeitung mit hohem Volumen und UDMO-Unterstützung
- Eine transaktionale _Verarbeitungs-_Pipeline für die API-gesteuerte Extraktion in Echtzeit
Beide Pipelines haben denselben Schemakonfigurationsvertrag und dieselbe ETL-Governance, unterscheiden sich jedoch darin, wie Dokumente in das System gelangen und wo extrahierte Daten landen.
Sehen wir uns die einzelnen Pipelines genauer an.
Die _Batch-_Pipeline verarbeitet wiederkehrende Dokumentsätze, die durch ein UDMO definiert sind. Sie eignet sich für geplante oder ereignisgesteuerte Anwendungsfälle, in denen Dokumente aus dem Unternehmensspeicher aufgenommen werden, dann die Dokumentextraktion durchlaufen und zur Harmonisierung, Identitätsbestimmung und Aktivierung an die Data 360 DLO/DMO-Pipeline geliefert werden.
Real-World-Szenario
Jeden Tag erhält ein Versicherungsunternehmen Tausende medizinische Anspruchsdokumente von Anbieterportalen, die als PDFs in Amazon S3 hochgeladen werden. Das UDMO definiert den Dokumentsatz im Umfang und sendet alle Anspruchs-PDFs innerhalb eines 24-Stunden-Fensters an den /claims/incoming/-Bucket.
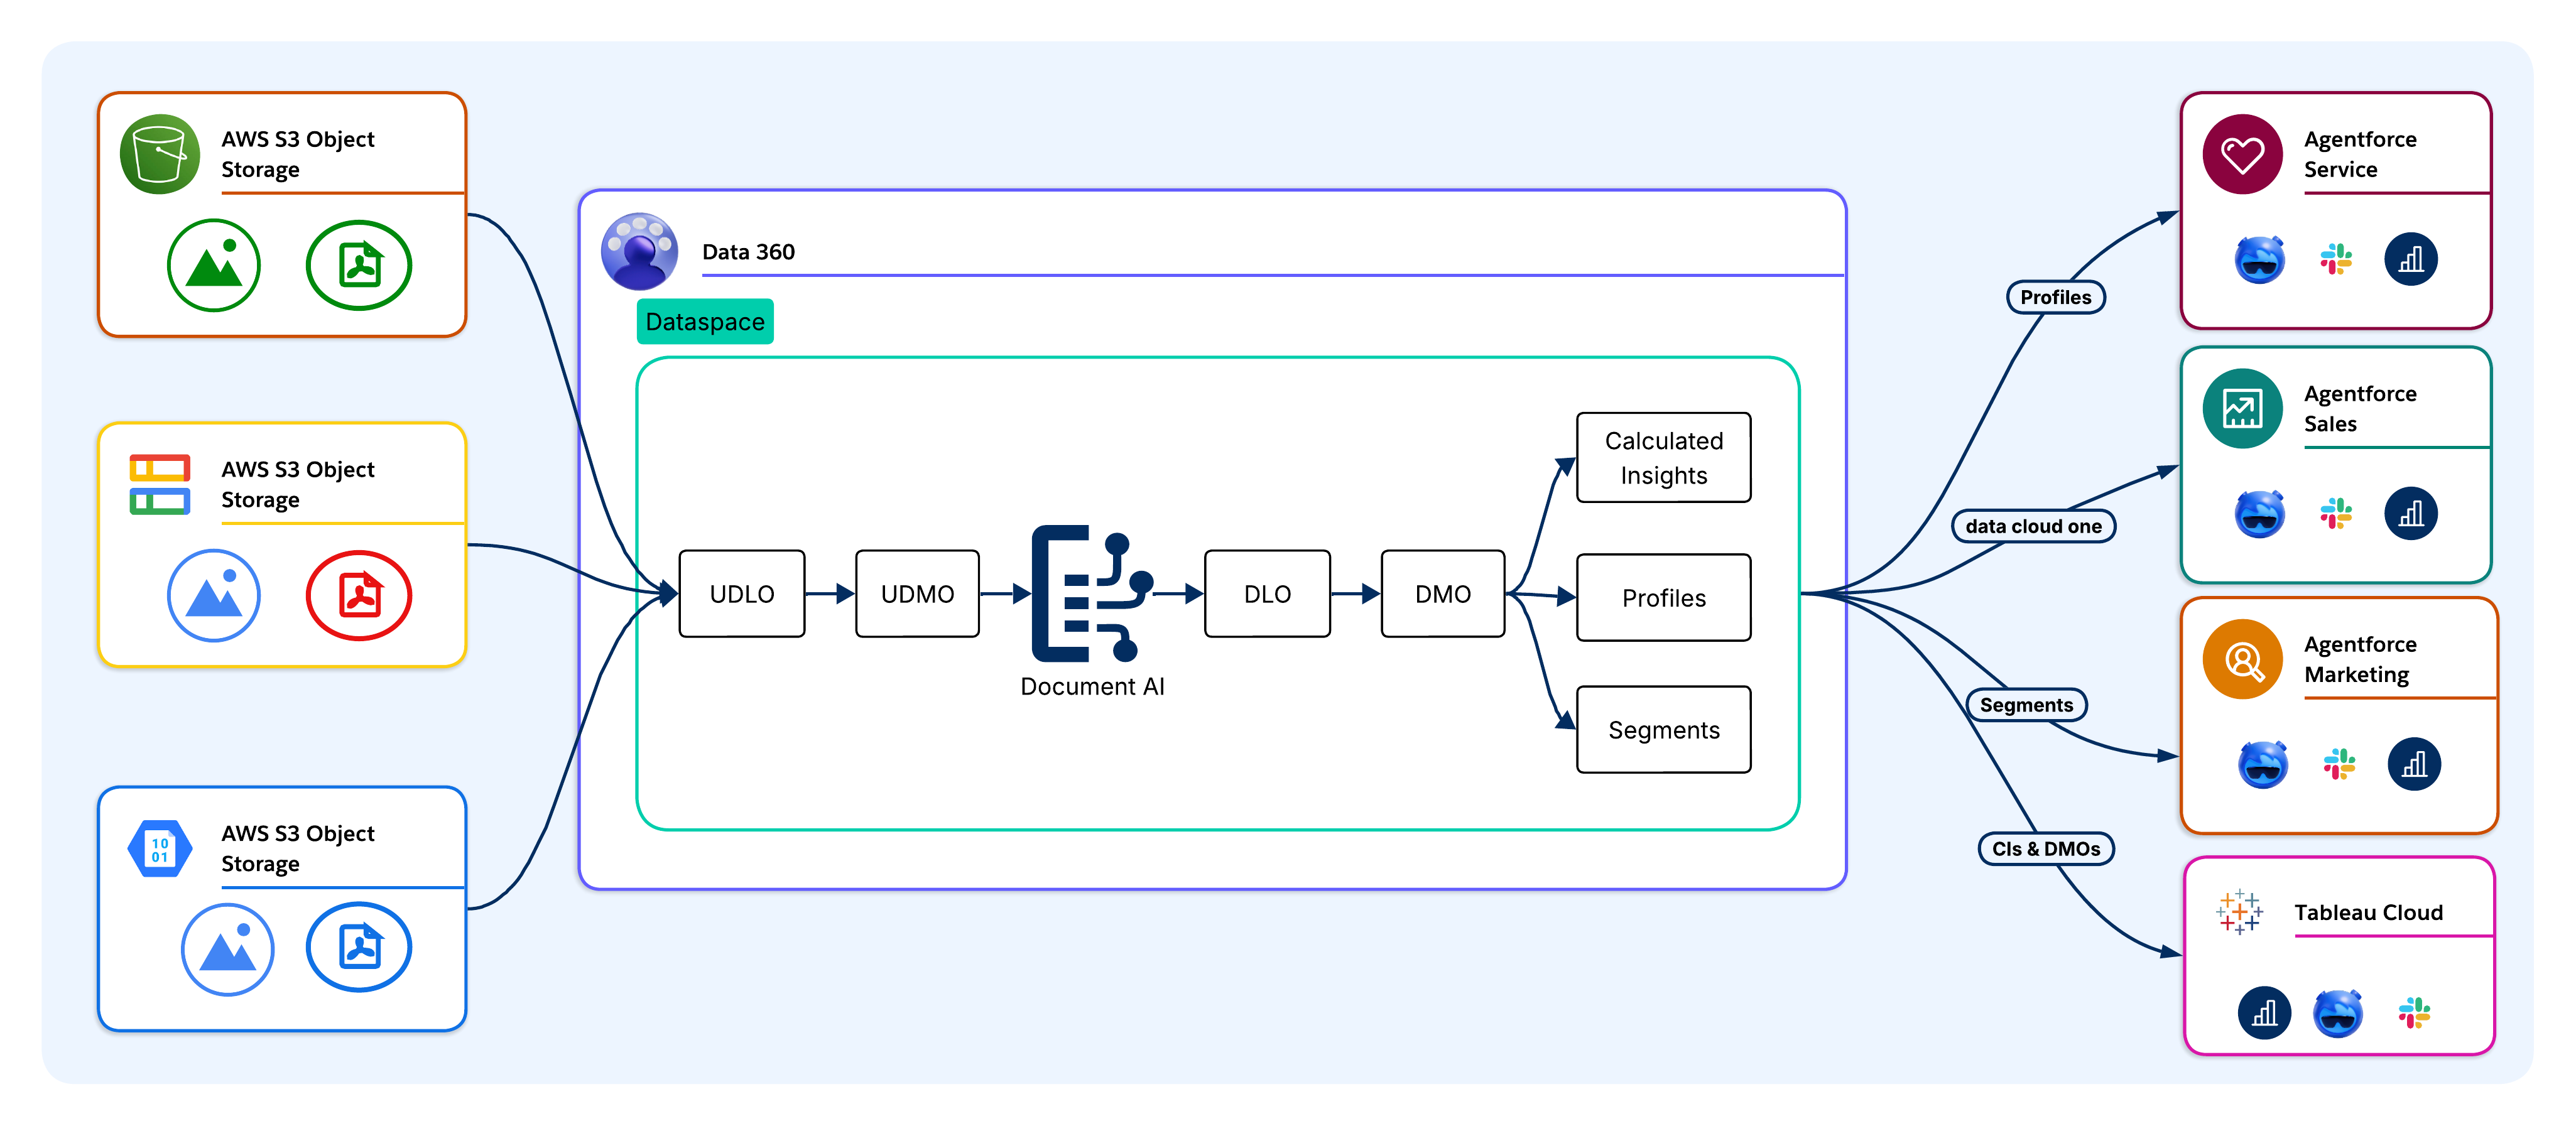
Dokumente werden ohne physische Duplikate aus Unternehmensquellsystemen in Data 360 aufgenommen. Zu den unterstützten Quellen zählen Amazon S3, Google Cloud Storage, Salesforce CRM-Dateiobjekte, MuleSoft-orchestrierte Pipelines und direkte API-Uploads. Bei _Headless 360-_Bereitstellungen werden Dokumente über Cloud-Speicher-Konnektoren oder die Aufnahme-API aufgenommen, wodurch die CRM-Ebene umgangen wird. Der Server Model Context Protocol (MCP) stellt die Aufnahme als aufrufbares Tool für externe AI-Agenten und LLM-Clients bereit.
Bei der Aufnahme werden Rohdokumente als _Unstrukturierte Data-Lake-Objekte (_UDLOs) gespeichert, die dem physischen Speicherort und den Metadaten jedes Dokuments zugeordnet werden, ohne die Quelldatei zu verschieben oder umzuwandeln.
Beispiel:
Über den Cloud-Speicher-Konnektor werden Anspruchs-PDFs aus S3 in Data 360 aufgenommen. Jedes Dokument wird als UDLO gespeichert, das auf das _S3-_Objekt verweist. Es erfolgt keine physische Duplizierung.
Die Dokument-AI verarbeitet jedes UDLO anhand einer Schemakonfiguration, die definiert, welche Felder zusammen mit ihren Zieldatentypen extrahiert werden sollen. Das UDMO definiert, welche Dokumente in den Geltungsbereich fallen. Der LLM (GPT-4o, Gemini oder Claude) liest jedes Dokument und gibt eine strukturierte Extraktionsnutzlast zurück.
Beispiel:
Die Dokument-AI verarbeitet jedes UDLO anhand eines Anspruchsschemas, das Felder wie die folgenden definiert: ClaimID, PatientName, DiagnosisCode, BillingAmount und ServiceDate. LLMs lesen dann jede PDF und geben eine strukturierte Extraktionsnutzlast zurück.
Sobald die Daten extrahiert wurden, werden sie in DLOs beibehalten, bei denen es sich um die Rohspeicherebene von Data 360 handelt. DLOs behalten extrahierte Felder bei, ohne Geschäftslogik aufzuzwingen, wodurch eine genaue physische Darstellung für die nachgelagerte Transformation und Rückverfolgbarkeit erhalten bleibt. Das UDLO behält einen Verweis auf das Quelldokument bei, um die Abstammung auf Feldebene an jedem Punkt der Pipeline zu aktivieren.
Beispiel:
Alle extrahierten Felder werden in einem Claims-DLO angezeigt, das eine rohe, genaue Darstellung jedes Anspruchs mit vollständiger Abstammung bewahrt, die bis zur Quell-PDF zurückverfolgt werden kann.
DLO-Felder werden DMOs zugeordnet, die mit dem standardmäßigen Customer 360 Data Model übereinstimmen. Dies ist die Grenze, an der dokumentabgeleitete Daten von rohen, extrahierten Feldern zu geschäftsrelevanten Einheiten übergehen. Das DLO “Rechnung” wird einem DMO “Rechnung” zugeordnet und Felder wie CustomerID und BillingAmount werden zu Verknüpfungsschlüsseln und gleichen Attribute im vereinheitlichten Datenmodell ab. Harmonisierte Dokumentdaten sind über dieselben Schnittstellen wie CRM- und Transaktionsdaten an der Segmentierung, berechneten Statistiken und Aktivierung beteiligt.
Beispiel:
Das DLO “Claims” (Ansprüche) wird einem DMO für Ansprüche zugeordnet. Die Felder PatientID und PolicyNumber werden zu Verknüpfungsschlüsseln, die Anspruchsdatensätze mit vereinheitlichten Patientenprofilen verknüpfen.
Harmonisierte DMO-Daten sind an der Identitätsbestimmung beteiligt. Extrahierte Felder (z. B. Kundennamen, E-Mail-Adressen oder Accountnummern) dienen als Abgleichsschlüssel für die Verknüpfung von Dokumentdatensätzen mit zusammengeführten Einzelpersonen (Goldene Datensätze), wodurch die Lücke zwischen Dokument und Profil geschlossen wird.
Beispiel:
Extraktionsfelder (z. B. PatientName, DateOfBirth und PolicyNumber) dienen als Abgleichsschlüssel für die Identitätsbestimmung, wodurch Anspruchsdatensätze mit der richtigen zusammengeführten Einzelperson verknüpft werden. Dies geschieht selbst dann, wenn derselbe Patient in den Dokumenten unter leicht unterschiedlichen Namen angezeigt wird.
Architekten definieren berechnete Statistiken. Hierbei handelt es sich um aggregierte Kennzahlen, die über harmonisierte Dokumentdaten hinweg berechnet werden (z. B. die Gesamtausgaben aus verschiedenen Rechnungsposten, Risikobewertungen für Vertragsverlängerungen und Indizes zum Schweregrad von Ansprüchen).
Beispiel:
Berechnete Statistiken berechnen TotalClaimsPerPatient, AverageClaimAmount und HighRiskClaimScore für harmonisierte Anspruchsdaten für Agentforce-Abfragen.
Agentforce Agenten, Tableau, Marketingplattformen und Salesforce-SObjects können auf harmonisierte, identitätsaufgelöste Daten zugreifen. Die Zielklasse ist eine architektonische Entscheidung, die von Latenz-, Governance- und Datenresidenzanforderungen bestimmt wird.
Beispiel:
Ein Agentforce Agent für die Beurteilung von Ansprüchen fragt die Data 360-DMOs und -CIs ab, um Ansprüche mit hohem Risiko für die Prioritätsüberprüfung zu finden. In _Tableau-_Dashboards werden Trends zum Anspruchsvolumen und zur Anomalie angezeigt. Genehmigte Anspruchsdatensätze kehren zum SObject “Claims” zurück, um Zahlungs-Workflows zu initiieren.
In Headless 360-Architekturen wird die Aktivierung direkt über die Abfrage-API, die Pub/Sub-API oder die Cloud Data Warehouse-Aktivierungsziele an externe Systeme weitergeleitet. Anschließend findet der MCP-Server harmonisierte Dokumentdaten und berechnete Statistiken als aufrufbare Tools für externe AI-Agenten.
Die _Transaktionsverarbeitungs-_Pipeline verarbeitet die Einzeldokumentextraktion zur Laufzeit ohne ein UDMO oder ein vorintegriertes UDLO, das für ereignisgesteuerte Anwendungsfälle geeignet ist (beispielsweise wenn ein Kunde ein Formular hochlädt, ein Agent eine PDF empfängt oder ein externes System die Extraktion innerhalb eines Transaktionsverarbeitungs-Workflows initiiert). Die ETL-Governance gilt für beide Pipelines identisch.
Real-World-Szenario
Beim Beantragen eines Darlehens lädt ein Bankkunde über die mobile Anwendung der Bank eine PDF seiner Versorgungsrechnung hoch. Das Ereignis initiiert die Extraktion in Echtzeit, d. h., es ist kein vorgefertigtes UDLO oder UDMO beteiligt.
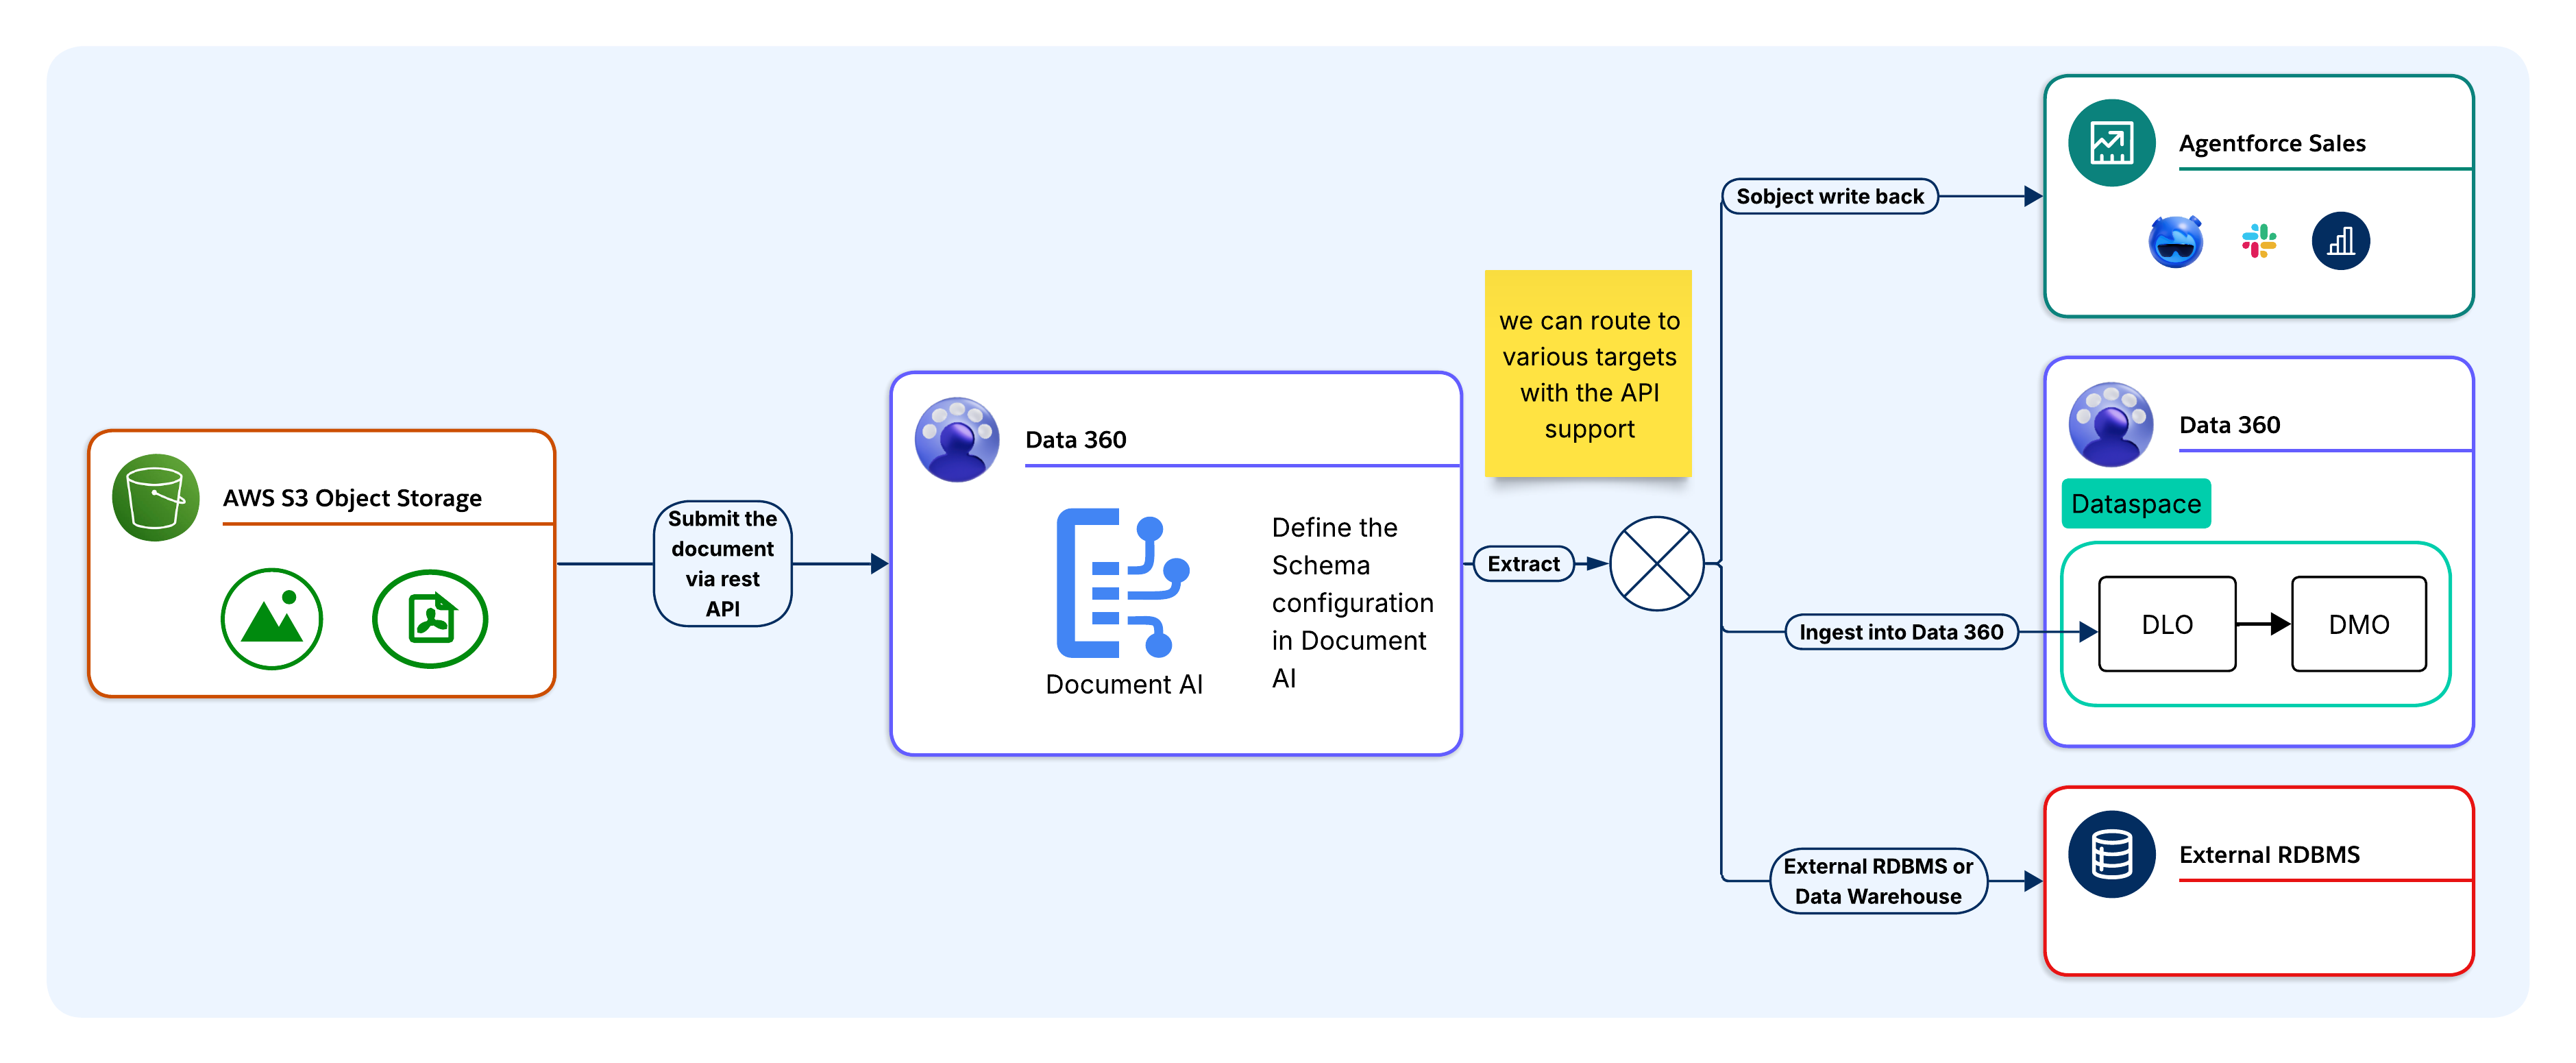
Vor dem Aufrufen der API müssen Architekten ein Schema in Data 360 definieren und speichern, das die Felder, Datentypen und Extraktionsanweisungen im JSON-Schemaformat angibt. Jedem Schema wird eine eindeutige Schema-ID zugewiesen. Zur Laufzeit verweist die aufrufende Anwendung auf die Schema-ID, um die Extraktionslogik in Data 360 zentral zu halten, statt sie in Anwendungscode einzubetten.
Beispiel:
Das Team der Bank verfügt über ein vordefiniertes ProofOfAddress in Data 360, das Felder wie CustomerName, AddressLine1, City, PostCode und DocumentDate angibt. Diese Informationen werden als versionierte Konfiguration gespeichert, auf die über eine Schema-ID verwiesen werden kann.
Die aufrufende Anwendung sendet das Dokument und die Schema-ID in einer einzelnen REST-API-Anforderung als base64-codierte Nutzlast oder Dateireferenz. Es ist keine UDLO-Aufnahme erforderlich. Die Dokument-AI wendet die Dokumentextraktion an und gibt die strukturierte Ausgabe basierend auf dem bereitgestellten Schema zurück.
Beispiel:
Die mobile Anwendung sendet die Versorgungsrechnung als base64-codierte Nutzlast zusammen mit der ProofOfAddress-Schema-ID in einem einzelnen REST-API-Aufruf. Für diesen Prozess ist kein UDLO-Aufnahmeschritt erforderlich.
Der LLM verarbeitet die OCR-Ausgabe anhand des Schemas und gibt synchron eine strukturierte JSON-Nutzlast zurück. Felder, die im Dokument nicht gefunden werden, werden als null zurückgegeben. Der Aufrufer ist Inhaber der vollständigen JSON-Antwort und fährt mit der Weiterleitung fort.
Beispiel:
Die Dokument-AI wendet OCR auf die PDF an und der LLM gibt eine strukturierte JSON-Nutzlast mit extrahierten Adressfeldern zurück. Felder, die nicht gefunden werden (beispielsweise wenn der PostCode in der Rechnung fehlt), werden als null zurückgegeben.
Nach der Extraktion kann die JSON-Nutzlast je nach Anwendungsfall an eine oder mehrere Zielklassen weitergeleitet werden:
- Salesforce-Objekte: Ordnet _SObject-_Feldern direkt über Apex oder Flow für CRM-Workflows und -Genehmigungen zu.
- Data 360-DLO/DMO-Pipeline: Leitet sie zur Harmonisierung, Identitätsbestimmung, berechneten Statistiken und Agentforce-Kontextbildung an ein DLO weiter.
- Externes RDBMS oder Data Warehouse: Leitet über MuleSoft, Apex Callout, Plattformereignisse oder ETL für Systeme weiter, die sich außerhalb von Salesforce befinden.
- Benutzerdefinierte Integration: Gibt strukturierte JSON-Nutzlasten zur Speicherung in einem externen System oder Datenspeicher an die aufrufende Anwendung zurück.
- Nachgelagerter Flow oder Agent: Übergibt die strukturierte JSON-Ausgabe direkt an einen nachgelagerten Flow oder Agenten ohne Persistenz in ein SObject. Dies ist ein gängiges Muster für Kunden, die die Dokument-AI als Echtzeitextraktionsschritt innerhalb eines größeren Automatisierungs- oder Agenten-Workflows verwenden.
Beachten Sie, dass ein einzelnes Schema möglicherweise mehrere Stufen gleichzeitig umfasst, wobei unterschiedliche Feldgruppen vom selben Extraktionspunkt aus an unterschiedliche Ziele weitergeleitet werden.
Beispiel:
Eine ProofOfAddress-Nutzlast kann auf drei Klassen gleichzeitig aufgefächert werden (beispielsweise durch Schreiben von CustomerName und AddressLine1 in das Kontakt-SObject), wodurch ein Flow zur Adressüberprüfung initiiert wird. Anschließend wird die vollständige Nutzlast zur Harmonisierung und Risikobewertung in ein DLO und eine Kopie zur Protokollierung der Einhaltung gesetzlicher Vorschriften über MuleSoft an das KYC-System der Bank weitergeleitet.
Sobald die extrahierten Daten geschrieben wurden, werden sie sofort im Zielsystem aktiviert. Bei _SObject-_Zielen werden die Auslöser, Flows und Genehmigungsprozesse im aktualisierten eingefügten Datensatz aktiviert. Bei DLO/DMO-Zielen gelangen Daten in die Pipeline für Harmonisierung und Identitätsbestimmung und in den Kontext von Agentforce. Bei externen _RDBMS-_Zielen sind Daten für nachgelagerte Abfragen verfügbar, sobald der Schreibvorgang abgeschlossen ist.
Beispiel:
Der Adressüberprüfungs-Flow wird sofort im aktualisierten Kontaktdatensatz aktiviert, wodurch der Darlehensantrag in die nächste Phase übergeht. Der Agentforce Darlehenssachbearbeiter Agent findet die überprüfte Adresse aus Data 360 und das KYC-System zeichnet die Vorlage des Dokuments zu Prüfungszwecken auf.
Dokument-AI eignet sich am besten für spezifische architektonische Bedingungen. Die Anwendung außerhalb dieser Bedingungen führt zu unnötiger Komplexität und zusätzlichen Kosten.
Als Architekten ist es wichtig, diese Kriterien auszuwerten, bevor Sie sich auf die Dokument-AI als Extraktionsmechanismus festlegen.
Verwenden Sie Dokument-AI in folgenden Fällen:
- Dokumente sind die primäre Datenquelle. Die erforderlichen Informationen sind nur in Dokumentform vorhanden und über eine strukturierte API oder Datenbank (z. B. gescannte Verträge, Laborberichte, Aufnahmeformulare oder Versicherungsansprüche) nicht verfügbar.
- Dokumentlayouts variieren je nach Quelle. Derselbe Dokumenttyp stammt von mehreren Anbietern, Partnern oder Regionen mit unterschiedlichen Außendienstpositionen und -formaten. Die schemagesteuerte LLM-Extraktion wird ohne Layoutwartung angepasst.
- Extrahierte Daten müssen Data 360 oder Agentforce zuführen. Die Extraktion muss an der Identitätsbestimmung, berechneten Statistiken oder Agentforce-Kontextbildung beteiligt sein. Die Dokument-AI wird ohne separate ETL-Ebene direkt in die _DLO/DMO-_Pipeline bereitgestellt.
- Das Volumen rechtfertigt eine geregelte Automatisierung. Das Dokumentvolumen übersteigt die Möglichkeiten der manuellen Verarbeitung ohne messbare Arbeitskosten oder Datenqualitätsrisiken.
- Dokumente enthalten regulierte Inhalte. PHI-, PII- oder Finanzdaten müssen durch eine Zero-Data-Retention-Schicht mit PII-Maskierung geleitet werden, bevor sie eine LLM erreichen. Die ETL erfüllt dies nativ. Kunden, die möchten, dass zu keinem Zeitpunkt extrahierter Inhalt beibehalten wird, sollten auch den Transaktions-API-Flow in Betracht ziehen, der die strukturierte Ausgabe direkt an die aufrufende Anwendung zurückgibt, ohne in ein SObject oder einen Datenspeicher schreiben zu müssen.
- Der Anwendungsfall ist ereignisgesteuert. Ein Dokument kommt zur Laufzeit an (beispielsweise ein Kunden-Upload, ein PDF-Anhang für Agenten oder ein externer Systemauslöser). Die _Transaktionsverarbeitungs-_Pipeline verarbeitet die synchrone Extraktion mit einem einzelnen Dokument ohne Batch-Setup.
Verwenden Sie in folgenden Fällen keine Dokument-AI:
- Quelldaten sind bereits strukturiert. Wenn das Upstream-System eine REST-API, eine Datenbanktabelle oder eine strukturierte Datei (z. B. CSV, JSON oder XML) bereitstellt, verwenden Sie einen standardmäßigen _Data 360-_Konnektor. Die Ausführung strukturierter Daten durch eine LLM-Extraktions-Pipeline führt zu Latenz- und Kreditkosten ohne zusätzliche Vorteile.
- Dokumente werden mit einem festen Schema maschinell generiert. Systemgenerierte PDFs aus einer bekannten ERP- oder Abrechnungsplattform mit stabilem Layout eignen sich besser für einen deterministischen Parser. Die LLM-Extraktion ist auf Variabilität ausgelegt und bei der Anwendung auf Dokumente mit festem Schema werden Kontext und Gutschriften verschwendet.
- Genauigkeitsanforderungen überschreiten LLM-Konfidenzschwellenwerte. Die Dokument-AI garantiert keine 100 %ige Extraktionsgenauigkeit. Anwendungsfälle, in denen ein verpasster oder falscher Feldwert ein erhebliches finanzielles, rechtliches oder klinisches Risiko birgt, erfordern einen HITL-Validierungsschritt. Verwenden Sie die Dokument-AI nicht als einzige Extraktionsebene für Entscheidungen mit hohem Einsatz ohne Validierungs-Workflow.
- Dokumente überschreiten Plattformeinschränkungen. Aufgrund der derzeitigen Obergrenze von 10 MB Dateigröße und der begrenzten LLM-Kontextlänge ist die Dokument-AI für große oder dichte Dokumente ohne Vorverarbeitung ungeeignet, um sie außerhalb der Plattform aufzuteilen und wieder zusammenzufügen.
- Hinweis: Bei Salesforce werden diese Akzeptanzrichtlinien aktiv verbessert, um die unterstützten Dateigrößen, Seitenzahlen und Dateierweiterungen zu erweitern. Einschränkungen werden sich auch in Zukunft weiterentwickeln.
Sehen wir uns einige Szenarien genauer an, in denen die Document AI Batch-Pipeline verwendet wird, die durch ein UDMO-Quellobjekt unterstützt wird. In diesen Fällen werden extrahierte Daten zur Harmonisierung, Identitätsbestimmung, berechneten Statistiken und Agentforce-Aktivierung durch die Data 360 DLO/DMO-Pipeline geleitet. Jeder Anwendungsfall eignet sich am besten für die geplante oder ereignisgesteuerte Dokumentverarbeitung mit hohem Volumen.
Agentforce Sales: Vertrags- und Rechnungsintelligenz
_Vertrags-_PDFs werden über die _Batch-_Pipeline aus dem Cloud-Speicher aufgenommen. Das Schema extrahiert “ContractValue”, “RenewalDate”, “PaymentTerms” und “CounterpartyName” und ordnet sie dann den Datenmodellobjekten “Account” und “Vertrag” zu. Berechnete Statistiken leiten Bewertungen für Verlängerungsrisiken ab. Agentforce benachrichtigt Kundenbeauftragte vor dem Schließen von Verlängerungszeitfenstern, wodurch die manuelle Vertragsüberprüfung und verpasste Verlängerungen entfallen.
Agentforce Services: Kundenvorgangsableitung und Knowledge Grounding
_Umfrage-_PDFs und Kundenvorgangsanhänge werden über die _Batch-_Pipeline aufgenommen. Das Schema extrahiert Stimmungsindikatoren, Problemkategorien und Lösungshinweise und ordnet sie dann den DMOs für Kundenvorgänge und Knowledge-Artikel zu. Agentforce fragt beim Öffnen des Kundenvorgangs die harmonisierte Knowledge Base ab und sucht relevante Schritte zur Fehlerbehebung, wodurch der Aufwand für die Agentensuche reduziert wird.
Agentforce Health: Klinische Dokumentverarbeitung
Laborberichte, Aufnahme-PDFs und handschriftliche klinische Formulare werden über die _Batch-_Pipeline aufgenommen. Das Schema extrahiert Felder wie PatientID, DiagnosisCode, MedicationName und TestResult und ordnet sie dann den DMOs der Health Cloud zu, die HIPAA-konforme Workflows für die Versorgungskoordination und die klinische Forschung unterstützen.
Finanzdienstleistungen: Automatisierung von Darlehens- und Steuerdokumenten
Darlehensanträge, Steuererklärungen und Gewinn- und Verlustrechnungen werden über die Batch-Pipeline aufgenommen. Das Schema extrahiert Felder wie “Jahreseinkommen”, “Steuerjahr” und “EmployerName” und ordnet sie dann den Datenmodellobjekten für Finanz-Accounts zu. Berechnete Statistiken verbinden dokumentenbasierte Einkommensdaten und CRM-Daten, um die automatisierte Kreditrisikobewertung zu erleichtern. Agentforce sucht die extrahierten Darlehensdetails während der Kundendienstinteraktionen inline. Dieses Muster unterstützt direkt den Anwendungsfall “Darlehenspräqualifikationsagent”, der im Salesforce Agentic Enterprise Solutions-Entwicklercenter veröffentlicht wird.
HR: Belegschaftsdokumentverarbeitung
Einarbeitungsdokumente, Steuerformulare und Zertifizierungs-PDFs werden über die _Batch-_Pipeline aufgenommen. Die extrahierten Felder werden den Datensatz-DMOs für Mitarbeiter zugeordnet und dann mit dem Profil “Zusammengeführter Mitarbeiter” verknüpft. Bestimmte Flows initiieren Aufgaben für die Einarbeitung und Compliance-Prüfungen anhand der extrahierten Daten. Dieses Muster unterstützt direkt den Anwendungsfall “Automatische Fortsetzung – Verarbeitungsagent”. Die Dokument-AI extrahiert Fertigkeiten, den Beschäftigungsverlauf und Qualifikationen aus Lebenslauf-PDFs, die Agentforce dann verwendet, um Kandidaten anhand offener Rollenkriterien abzugleichen und sie an Einstellungs-Workflows weiterzuleiten.
Professionelle Dienstleistungen: Vorschlags- und Forschungsintelligenz
Vorschlagsdecks und Forschungsberichte werden über die _Batch-_Pipeline aufgenommen. Extrahierte Frameworks, Benchmarks und Engagementzusammenfassungen werden benutzerdefinierten DMOs zugeordnet und dann für die Vektorsuche indiziert. Agentforce ruft zum Abfragezeitpunkt kontextrelevante Empfehlungen ab, die auf extrahiertem Dokumentinhalt basieren. Dieses Muster erweitert das Muster “Ground Agentforce on Website Content” (Grundlegende Agentforce für Websiteinhalte). Dokumente werden über die Dokument-AI indiziert und dienen für Agentenantworten der gleichen Kontextfunktion wie Website-Inhalte, die über _Data 360-_Konnektoren indiziert werden.
HIPAA-Compliance-Status:
Die in diesem Papier beschriebenen Health Cloud-Muster wenden ETL-Steuerelemente (z. B. Null-Datenaufbewahrung und PHI-Maskierung) für Texteingaben an. Diese Steuerelemente allein stellen keine HIPAA-Zertifizierung dar. Architekten, die für regulierte klinische Umgebungen konzipieren, müssen den aktuellen HIPAA-Zertifizierungsstatus beim Salesforce-Compliance-Team bestätigen, bevor sie sich in diesen Kontexten auf eine _AI-_basierte Dokumentarchitektur festlegen.
Sehen wir uns einige Szenarien genauer an, in denen die REST-API für Dokument-AI mit einem Schema aufgerufen wird, das nicht an ein UDMO gebunden ist. Extrahierte JSON-Nutzlasten werden zur Laufzeit synchron direkt an externe Systeme weitergeleitet.
Lieferkette: Lieferantenrechnungsverarbeitung für ERP
Wenn eine PDF-Lieferantenrechnung in einem überwachten Speicher-Bucket oder E-Mail-Gateway eingeht, ruft ein Ereignisauslöser die REST-API der Dokument-AI mit der Rechnung und einer vordefinierten Schema-ID auf. Das Schema extrahiert die VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount und DueDate. Die JSON-Nutzlast wird über MuleSoft an das Modul “ERP Accounts Payable” (Zahlungspflichtige ERP-Accounts) mit Validierung des Nullfelds und idempotenter Aktualisierungs-Einfügelogik weitergeleitet, wodurch die Vorlagenwartung für die Varianz des Lieferantenformats entfällt.
Rechtsgeschäfte: Vertragsüberprüfung an CLM
Wenn eine _Vertrags-_PDF in das Rechtsportal hochgeladen wird, ruft das Backend die REST-API für die Dokument-AI synchron auf. Das Schema extrahiert “GoverningLaw”, “IndemnityCapAmount”, “TerminationNoticePeriod”, “AutoRenewalClause” und “CounterpartySignatory”. Die JSON-Nutzlast wird über Apex Callout an das System Contract Lifecycle Management (CLM) weitergeleitet. Alle Felder, die nicht gefunden werden, werden als null zurückgegeben und das CLM wendet die Standardpflichtregeln auf die fehlenden Werte an.
Versicherungsansprüche: Erste Meldung der Verlustverarbeitung
Wenn ein Versicherungsnehmer ein Formular für die erste Verlustanzeige sendet, ruft das Backend-Portal die REST-API der Dokument-AI synchron auf. Das Schema extrahiert “PolicyNumber”, “IncidentDate”, “IncidentLocation”, “DamageDescription”, “ClaimantName” und “ContactPhone”. Die JSON-Nutzlast wird über Apex Callout oder ETL an die Anspruchsverwaltungsdatenbank weitergeleitet, wodurch ein vorab ausgefüllter Anspruchsdatensatz erstellt wird, der von den Anpassungen überprüft werden kann, bevor der formelle Anspruch geöffnet wird.
Bevor Sie in die Produktion wechseln, müssen Sie Entwürfe für diese Fehlerszenarien erstellen.
- Null-Feldverarbeitung: Der LLM gibt null für Felder zurück, die nicht gefunden oder sicher extrahiert werden können. Validieren Sie die Nullverarbeitungslogik beim Schemadesign und implementieren Sie die Standardwert- oder Ablehnungslogik in der Integrationsebene, bevor Sie Ziele mit _NICHT NULL-_Einschränkungen oder erforderlichen Übereinstimmungsschlüsseln schreiben.
- OCR-Qualitätsminderung: Die OCR-Genauigkeit nimmt unter 150 DPI, bei unregelmäßiger Handschrift oder bei verrauschten Scans ab. Fehlanzeigen werden als beschädigte Eingabe ohne Fehlersignale in die LLM-Extraktion übernommen. Erzwingen Sie die Mindestscanqualität bei der Aufnahme und implementieren Sie Konfidenzschwellenwertprüfungen für numerische Felder und Datumsfelder.
- Nicht übereinstimmende Schemaversion: Wenn Sie eine Schemakonfiguration aktualisieren, nachdem ein Batchauftrag geplant wurde, werden Dokumente im laufenden Betrieb mit der vorherigen Version verglichen, wodurch fehlende oder umbenannte Felder erzeugt werden, die die nachgelagerte Zuordnung beeinträchtigen. Versionsschemas explizit und koordinieren Aktualisierungen mit Batchauftragsplänen.
- Obergrenzen für Dateigrößen: Dokumente, die größer als 10 MB sind, werden abgelehnt. Batch-Pipeline-Fehler sind ohne konfigurierte Überwachung stumm und Transaktionsanrufer erhalten einen Fehler vom Typ 4xx. Validieren Sie die Dateigrößen bei der Aufnahme vorab und implementieren Sie die Vorverarbeitung, um Dokumente aufzuteilen oder zu komprimieren, die sich regelmäßig der Obergrenze nähern.
- LLM-Kontextüberlauf: Dichte oder mehrseitige Dokumente können das LLM-Kontextfenster innerhalb der Obergrenze von 10 MB überschreiten. Der LLM verwirft Inhalte, die den Kontext überschreiten. Implementieren Sie eine Blockierungsstrategie, die Dokumente nach Seitenbereich aufteilt und die extrahierten Felder erneut zusammenstellt, bevor sie an das Ziel übertragen werden.
- Trust Layer Masking Affecting Extraction (Vertrauensebenenmaskierung mit Auswirkungen auf die Extraktion): Die ETL wird auf Aufforderungsebene ausgeführt, nicht auf Dokumentebene. Daher wird die Maskierung nicht auf Dokumentinhalte angewendet, die die Dokument-AI durchlaufen. Schemafelder, die von den personenbezogenen Werten im Dokument abhängen, sind von Richtlinien für die ETL-Maskierung nicht betroffen.
- Externe RDBMS-Schreibidentität: Die Pipeline für die Transaktionsverarbeitung verfügt nicht über eine integrierte Identität für externe _RDBMS-_Ziele. Bei Wiederholungen auf Integrationsebene werden doppelte Zeilen erstellt, es sei denn, die Schreiblogik verarbeitet die Duplizierung explizit. Implementieren Sie idempotente Upserts mithilfe eines Dokumentfingerabdrucks oder einer externen ID für alle externen Schreibpfade.
- Krediterschöpfung zur Mitte der Ausführung: Bei großen Batch-Ausführungen kann es sein, dass Digital Wallet-Guthaben vor der Verarbeitung aller Dokumente erschöpft ist, was unvollständige DLO-Datensets zur Folge hat, die von nachgelagerten Schritten als abgeschlossen betrachtet werden. Legen Sie Verbrauchsbenachrichtigungen auf 75 % und 90 % der verfügbaren Gutschriften fest und begrenzen Sie die Batchgrößen, um für jeden Zyklus innerhalb des Gutschriftsbudgets zu bleiben.
- Schemafeldobergrenze – architektonische Einschränkung: Die Dokument-AI erzwingt eine Obergrenze von 50 Feldern für Felder auf Stammebene in einer Schemakonfiguration. Hierbei handelt es sich um eine Design-Zeit-Einschränkung – kein Laufzeitfehler –, die Architekten beim Datenmodell- und Schemadesign berücksichtigen müssen.
- Für Anwendungsfälle, die eine umfassendere Extraktion erfordern:
- Priorisieren Sie rücksichtslos. Grenzen Sie das Schema auf Felder ein, die den Automatisierungswert steigern, nicht auf eine vollständige Dokumentabdeckung.
- Verwenden Sie verschachtelte Objekte (bis zu 3 Ebenen; Batch-Modus nur mit Quellobjekt), um die Anzahl der Stammfelder zu reduzieren, ohne die Extraktionstiefe zu beeinträchtigen.
- Zerlegen Sie komplexe Dokumente über mehrere Dokument-AI-Konfigurationen hinweg, die auf unterschiedliche Dokumentabschnitte abzielen, und schreiben Sie Ergebnisse in separate DLOs, die in Data 360 nachgelagert verbunden werden.
- Für Anwendungsfälle, die eine umfassendere Extraktion erfordern:
- API-Ratenobergrenzen: Die Dokument-AI erzwingt eine Obergrenze von 50 Extraktions-API-Aufrufen pro Minute und Mandant. Die theoretische Obergrenze liegt bei 300 Aufrufen pro Minute, was durch das Einstein LLM Gateway geregelt wird. Transaktionsintegrationen mit hohem Volumen müssen mit exponentiellem Backoff, Warteschlangen für Anforderungen und Budgetierung des Durchsatzes auf Mandantenebene konzipiert werden. Gehen Sie nicht davon aus, dass die Burst-Kapazität in Produktionsumgebungen mit mehreren Mandanten verfügbar ist.
- API-Latenzprofil: Die Extraktions-APIs für die Dokument-AI sind vollständig synchron. Typische Antwortzeiten liegen zwischen 5 und 15 Sekunden und variieren je nach Dateigröße und Schemakomplexität.
- Dies hat direkte Auswirkungen auf die Integrationsarchitektur:
- Legen Sie die Anrufer-Timeouts auf mindestens 30 Sekunden fest.
- Rufen Sie keine Dokument-AI in Flows mit SLA-Anforderungen im Sekundenbereich auf.
- Latenz bei der Berechnung des Durchsatzes im Vergleich zur Ratenobergrenze für Batch-Verarbeitungspipelines.
- Legen Sie die Anrufer-Timeouts auf mindestens 30 Sekunden fest.
- Dies hat direkte Auswirkungen auf die Integrationsarchitektur:
- Verschlüsselte und kennwortgeschützte Dokumente: Dokument-AI verarbeitet keine kennwortgeschützten Dateien (Benutzerkennwörter sind zum Öffnen von Dateien erforderlich) oder PDFs, die mit einem Kennwort für Inhaber/Berechtigungen verschlüsselt sind. Dies gilt auch für Dateien, die normal geöffnet werden, jedoch das Kopieren, Drucken oder Bearbeiten auf der Ebene der PDF-Berechtigungen einschränken.
- Diese Einschränkung befindet sich an der Aufnahmegrenze:
- Entwerfen Sie Pipelines zur Dokumentaufnahme, um verschlüsselte Dateien zu erkennen und an einen Ablehnungs- oder manuellen Verarbeitungspfad weiterzuleiten, bevor sie die Dokument-AI erreichen.
- Verlassen Sie sich nicht auf die Fehlerverarbeitung während der Laufzeit als primäres Gate.
- Diese Einschränkung befindet sich an der Aufnahmegrenze:
Die Data 360-Dokument-AI ist auf mehrere Säulen des Salesforce Well-Architected Framework abgestimmt.
- Trust: Das ETL erzwingt die Aufbewahrung von Nullwerten bei LLM-Anbietern, maskiert personenbezogene Eingaben, bevor sie das Modell erreichen, und scannt Ausgaben auf sensible Inhalte. Architekten müssen diesen Status auf extrahierte Daten im Leerlauf erweitern. Die Feldebenenmaskierung in DLOs wird vom ETL nicht angewendet und erfordert nachgelagerte Datenbereichsrichtlinien und Berechtigungssätze.
- Zuverlässigkeit: Jeder Fehlermodus im Abschnitt “Überlegungen zum Design” (Extraktion von Nullfeldern, OCR-Fehllesung, Schemaversionsabweichung, Dateigrößenverletzung, LLM-Kontextüberlauf, ETL-Maskierungsinterferenz, RDBMS-Schreibidentität und Krediterschöpfung) stellt eine eindeutige Fehlerklasse mit dokumentiertem Erkennungssignal und Lösungspfad dar.
- Operational Excellence (Änderungsverwaltung): Das schemagesteuerte Extraktionsmodell entkoppelt die Extraktionslogik vom Dokumentlayout. Wenn ein Anbieter ein Rechnungsformat ändert oder ein behördliches Formular aktualisiert wird, müssen Architekten nur eine Schemakonfiguration aktualisieren, statt den Integrationscode zu ändern.
- Operational Excellence (Wartbarkeit): Wenn Sie Schemakonfigurationen in Data 360 zentralisieren und keine Extraktionslogik in Anwendungscode einbetten, wird der Extraktionsabsicht explizit, versioniert und überprüfbar. Alle nachgelagerten Ziele verwenden denselben Schemavertrag unabhängig von ihrer Zielklasse.
- Operational Excellence (Wiederverwendung der Integration): Dokument-AI stellt die Extraktion über mehrere Integrationsoberflächen hinweg bereit: REST-API, Apex, Flow, MuleSoft, Agentforce Actions und der MCP-Server. Eine einzelne Schemakonfiguration wird gleichzeitig auf mehrere Zielklassen aufgefächert, ohne die Extraktionsfunktion pro Verbraucher neu erstellen zu müssen.
- Ressourcen- und Kostenoptimierung: Die Pipeline-Auswahlanleitung, die Dateigrößenbegrenzung von 10 MB und die LLM-Kontextlänge vor der Montage stellen leistungsorientierte Designentscheidungen dar. Im Abschnitt “Verwendungszweck” werden die Bedingungen für den Fall formalisiert, dass die Dokument-AI nicht das richtige Tool ist (z. B. Latenzanforderungen im Sekundenbereich, vollständig strukturierte Quelldaten und maschinell generierte Dokumente mit festem Schema).
Dies ist ein strukturierter Ausgangspunkt für die Konfiguration der AI von Data 360-Dokumenten in einer Sandbox-Umgebung. Schließen Sie alle Phasen in der Sandbox ab, bevor Sie in die Produktion wechseln.
Bevor Sie mit der Konfiguration beginnen, müssen Sie Folgendes bestätigen:
- Dateigröße: Überprüfen Sie, ob die repräsentativen Dokumentgrößen unter 10 MB liegen.
- Pipeline: Überprüfen Sie, ob für den Anwendungsfall die _Batch-_Pipeline (UDMO-gestützt, hohes Volumen) oder die _Transaktionsverarbeitungs-_Pipeline (API-gesteuert, einzelnes Dokument) erforderlich ist. Dies steuert die gesamte nachfolgende Konfiguration.
- Zielstufe: Bestätigen Sie, wo die extrahierten Daten landen: Salesforce SObject, Data 360 DLO/DMO, externes RDBMS oder eine Kombination.
- Agentforce Abhängigkeit: Stellen Sie vor dem Bereitstellen einer von Agentforce unterstützten Dokumentverarbeitung sicher, dass eine unterstützte LLM (z. B. GPT-4o) in Ihrer Organisation über die ETL-Einstellungen aktiviert ist. Agentforce ist eine harte Plattformvoraussetzung für die Dokument-AI. Die gesamte Oberfläche der _AI-_Funktion für Dokumente, einschließlich aller Extraktions-APIs, ist erst verfügbar, wenn Agentforce in der Zielorganisation aktiv ist. Berücksichtigen Sie dies bei der Bewertung der Organisationsbereitschaft und der Bereitstellungsreihenfolge. Es kann einige Minuten dauern, bis die API-Verfügbarkeit nach der Aktivierung stabilisiert ist.
- Auswirkung der Agentforce-Deaktivierung: Wenn Agentforce deaktiviert ist, nachdem die Dokument-AI konfiguriert und bereitgestellt wurde, wird die gesamte Extraktionsverarbeitung (Benutzeroberfläche und API) sofort blockiert. Dasselbe gilt für die Modelldeaktivierung. Das Deaktivieren des zugrunde liegenden Modells hat eine entsprechende Auswirkung auf die Verfügbarkeit von Dokument-AI. In beiden Fällen werden die vorhandenen Schemakonfigurationen beibehalten und bleiben sichtbar – es treten keine Konfigurationen oder Datenverluste auf –, die Funktion ist jedoch erst dann vollständig funktionsunfähig, wenn Agentforce und das Modell erneut aktiviert sind. Entwerfen Sie operationelle Runbooks, um die Agentforce-Verfügbarkeit und die Modellaktivierung als Gesundheitsabhängigkeiten der Dokument-AI zu behandeln.
- Kreditverbrauch/-preise: Verwenden Sie Data 360-Gutschriften oder Flex-Gutschriften für TCO-Schätzungen, die aus repräsentativen Beispieldokumenten abgeleitet werden.
- Erstellen Sie die Schemakonfiguration. Definieren Sie Extraktionsfelder, Datentypen und Anweisungen im JSON-Schemaformat im AI-Setup für Data 360-Dokumente. Binden Sie sie für die _Batch-_Pipeline an ein UDMO. Erstellen Sie für die _Transaktionsverarbeitungs-_Pipeline diese ohne Quellobjekt. Notieren Sie sich die Schema-ID.
- Passen Sie Feldnamen an die Zielklasse an. Gleichen Sie Feldnamen mit DLO-Spaltendefinitionen, SObject-API-Namen oder RDBMS-Spaltennamen ab. Falsch ausgerichtete Namen verursachen den Zuordnungs-Overhead in der Integrationsebene.
- Konfigurieren Sie das UDMO-Quellobjekt (nur Batch). Definieren Sie Dokumente im Umfang und konfigurieren Sie die Aufnahmequellenkonnektivität (z. B. S3, Google Cloud Storage, Salesforce Files oder MuleSoft). Stellen Sie sicher, dass der Aufnahmeservice-Account über den erforderlichen Umfang für IAM- oder _OAuth-_Anmeldeinformationen verfügt.
- Wenden Sie Richtlinien für die Maskierung personenbezogener Daten an. Konfigurieren Sie Richtlinien für die Datenmaskierung in den ETL-Einstellungen, bevor Sie regulierte Inhalte verarbeiten. Definieren Sie, welche Feldtypen (PHI, PII und Finanzkennzeichner) maskiert werden sollen, bevor Eingaben in das LLM gelangen. Stellen Sie diesen Schritt nicht zurück.
- Umfang und Berechtigungssätze für den Datenbereich zuweisen. Grenzen Sie die Verarbeitung auf den entsprechenden Datenbereich ab und konfigurieren Sie Berechtigungssätze, um die Schemaerstellung, die Ausführung von Batchaufträgen, den REST-API-Aufruf und die nachgelagerte Aktivierung zu steuern.
- Konfigurieren der API-Authentifizierung (nur Transaktionsverarbeitungs-Pipeline). Erstellen Sie eine verbundene Anwendung mit den _OAuth-_Geltungsbereichen cdp_ingest_api und api. Verwenden Sie für organisationsinterne Anrufer Anmeldeinformationen mit Namen, die auf externe Anmeldeinformationen verweisen. Konfigurieren Sie für externe Anrufer _OAuth 2.0-_Client-Anmeldeinformationen oder einen JWT-Bearer-Flow. Testen und validieren Sie die Extraktion, bevor Sie fortfahren.
- SObject Write-back: Implementieren Sie ein Apex (@InvocableMethod)- oder _Flow-_Element, das JSON-Antwortfelder _SObject-_Feldern zuordnet. Verwenden Sie Database.upsert() mit einer externen ID, um Duplikate zu verhindern. Wenden Sie die Feldebenensicherheit auf _SObject-_Zielfelder an.
- Data 360 DLO/DMO-Pipeline: Ordnen Sie extrahierte DLO-Felder DMOs zu, die mit dem Customer 360 Data Model übereinstimmen. Konfigurieren Sie Regeln für die Identitätsbestimmung, um Dokumentdatensätze mit zusammengeführten Einzelpersonen zu verknüpfen. Definieren Sie berechnete Statistiken und fügen Sie DMOs für Agentforce hinzu. Leiten Sie für die Transaktionsverarbeitungs-Pipeline die JSON-Nutzlast zunächst über die _Aufnahme-_API an ein DLO weiter.
- Externes RDBMS oder Data Warehouse: Wählen Sie das Integrationsmuster aus: MuleSoft (vorhandenes Integrationsgewebe), Apex HTTP-Callout (leichtgewichtig, organisationsnativ), Plattformereignisse mit dem _Pub/Sub-_Abonnenten (ereignisgesteuert) oder ETL (Batch mit hohem Volumen). Implementieren Sie idempotente Upserts mithilfe eines Dokumentfingerabdrucks oder einer externen ID für alle externen Schreibpfade.
- Aktivierungspfade: Verbinden Sie Agentforce-Aktionen mit Schemakonfigurationen für die interaktive Extraktion. Konfigurieren Sie Flow- oder Apex-Auslöser für automatisierte Verarbeitungs-Workflows und richten Sie die Aktivierungsziele für jede Feldgruppe ein.
- Fehlerbehandlung (nur Transaktionsverarbeitungs-Pipeline). Konfigurieren der vollständigen HTTP-Antwortoberfläche: 200 (erfolgreich, einschließlich teilweiser _Null-_Antworten), 400 (fehlgebildete Anforderung oder Schema-ID nicht gefunden), 413 (Datei größer als 10 MB), 5xx (Servicefehler). Implementieren Sie eine exponentielle Sicherung für 5xx Wiederholungen mit maximal 3 Versuchen. Protokollieren Sie die JSON-Rohantwort und die Schema-ID bei jedem Aufruf.
- Testen Sie Schemas anhand von Beispieldokumenten. Senden Sie repräsentative Beispiele über die Dokument-AI-Schnittstelle oder die REST-API. Bestätigen Sie die Extraktionsgenauigkeit, die Feldabdeckung und die Akzeptanz von Nullwerten über Layoutvariationen hinweg.
- Validieren Sie die Akzeptanz von Nullfeldern. Stellen Sie sicher, dass alle nachgelagerten Ziele Nullwerte für Felder verarbeiten können, die in einem Dokument nicht gefunden werden. Beachten Sie, dass NICHT NULL-Einschränkungen ohne explizite Nullverarbeitung fehlschlagen.
- Dateigrößen vorab validieren. Stellen Sie sicher, dass Produktionsdokumente unter 10 MB bleiben. Implementieren Sie die Vorverarbeitung, um Dokumente aufzuteilen oder zu komprimieren, die sich regelmäßig der Obergrenze nähern.
- Validieren Sie die durchgängige Extraktion. Initiieren Sie für die _Batch-_Pipeline eine vollständige Ausführung und überprüfen Sie, ob die extrahierten Felder in jeder Zielklasse richtig landen. Verfolgen Sie für die Pipeline zur Transaktionsverarbeitung die JSON-Antwort über die Integrationsebene bis zum Ziel. Überprüfen Sie den Auslöser und die Flow-Ausführung für die _SObject-_Ziele, die Identitätsbestimmungsverknüpfung für die _DLO/DMO-_Ziele und die Identitätsbestimmung für die _RDBMS-_Ziele.
- Verhalten der Trust Layer bestätigen. Die ETL wendet keine personenbezogene Maskierung auf Dokumentinhalte an. Daher gibt die LLM personenbezogene Daten in extrahierten Feldern unverändert zurück. Stellen Sie sicher, dass Ihre Schemafelder, die Datenweiterleitung und der nachgelagerte Speicher für die angemessene Verarbeitung personenbezogener Daten ausgelegt sind, und stellen Sie sicher, dass alle Compliance- oder Aufbewahrungsanforderungen außerhalb der Plattform erfüllt werden.
- Legen Sie Digital Wallet-Benachrichtigungen fest. Konfigurieren Sie Verbrauchsbenachrichtigungen bei 75 % und 90 % der verfügbaren Gutschriften. Legen Sie für jeden Zyklus Obergrenzen für die Batchgröße und Ad-hoc-Satzschätzungen im Kreditbudget fest.
- Batchüberwachung validieren (nur Batch-Pipeline). Überprüfen Sie in der Data 360-Überwachungskonsole die Erfolgsraten bei der Extraktion, die Nullfeldraten und den Auftragsabschluss. Bestätigen Sie die Tag-Übertragung aus dem UDLO über das DLO in das DMO in der Datenherkunft.
- API-Fehlerbehandlung validieren (nur Transaktionsverarbeitungs-Pipeline). Testen Sie alle Fehlerbedingungen: 413 (Dokumente über 10 MB), 400 (ungültige Schema-IDs), 200 (gültige Extraktionen mit Teilnullwerten). Stellen Sie sicher, dass die Wiederholungslogik auf simulierte **5xx-**Antworten ausgelöst wird, ohne doppelte Schreibvorgänge zu erstellen.
In diesem Dokument werden die architektonischen Grundlagen der Data 360 Document AI: hervorgehoben.
- Zwei Verarbeitungspipelines und wann sie verwendet werden sollen
- Das Schemakonfigurationsmodell
- Das Entscheidungs-Framework der Zielklasse
- Kerntechnologieneinschränkungen
- Fehlermodi
- Gute Framework-Ausrichtung
Die Schnellstartanleitung für Architekten bietet die Konfigurationsreihenfolge für einen Sandbox-Konzeptnachweis.
Der zentrale Architekturstatus unterstützt dokumentenabgeleitete Daten, die auf der Schemaebene geregelt, über eine ETL-erzwungene LLM-Pipeline verarbeitet und an denselben _Data 360-_Datenlebenszyklus bereitgestellt werden, der auch alle anderen Unternehmensdaten regelt.
Architekten, die diese Prinzipien anwenden – die Auswahl der richtigen Pipeline, das Entwerfen von Schemas auf Dokumenttypebene und das Entwerfen von Fehlermodi vor der Produktion –, erstellen Extraktionsfunktionen, die entsprechend den regulierten Anforderungen an die Unternehmensführung skaliert und dauerhaft sind.
Yugandhar Bora ist Software-Entwickler bei Salesforce und hat sich auf die Datenarchitektur innerhalb der Plattform für Daten- und Intelligenzanwendungen spezialisiert. Er leitet Initiativen des Enterprise Architecture Review Board (EARB), die sich auf die Datenverwaltung und vereinheitlichte Datenmodelle konzentrieren, und trägt gleichzeitig zu automatisierten Plattformbereitstellungslösungen bei.
Annth Anto ist Director of Product Management bei Salesforce Data 360 und leitet die Initiativen für Dokument-AI und Datendiagramme. Er lebt in Bangalore und arbeitet mit Unternehmenskunden zusammen, um die Herausforderungen der realen Dokumentverarbeitung und Datenintelligenz zu lösen. Es macht ihm Spaß, Unternehmensanwendungsfälle für generative AI (Generative AI) zu erkunden.
Nishan Naseer ist Software-Entwickler bei Salesforce und beschäftigt sich mit unstrukturierter Datenverarbeitung, _RAG-_Pipelines und Dokumentintelligenz. Er nutzt mit Leidenschaft die Leistungsfähigkeit der KI, um reale Herausforderungen anzugehen und kreative Lösungen für komplexe Kundenprobleme zu finden.