Enterprise-Datenarchitekturen befinden sich selten in einem System. Salesforce verwaltet Kundenengagement-, Pipeline- und Serviceinteraktionen. Analyseplattformen wie Snowflake enthalten historische Transaktionen, Finanzdatensätze, Nutzungsdaten und betriebliche Kennzahlen. Traditionell bedeutete die Überbrückung dieser beiden Welten das Erstellen und Pflegen von ETL-Pipelines: geplante Aufträge, die Daten aus der Quelle extrahieren, umwandeln und Kopien in Salesforce laden. Aufgrund dieser Pipelines erhalten die Daten Verzögerungen, die Governance-Richtlinien vervielfachen sich systemübergreifend und Pipelines erfordern eine kontinuierliche betriebliche Versorgung.
Die Salesforce-Datenvirtualisierung bietet ein anderes Modell. Anstatt Daten in Salesforce zu verschieben, ermöglicht sie Salesforce die Abfrage von Daten direkt an der Quelle zur Laufzeit ohne Abgleich. Benutzern werden externe Live-Daten über Salesforce-Standardoberflächen angezeigt. Die Daten verlassen niemals ihren maßgeblichen Speicherort. In diesem Dokument wird am Beispiel von Snowflake erläutert, wie das Muster funktioniert, wann es verwendet werden soll und wie Sie loslegen.
Bei der Salesforce-Datenvirtualisierung handelt es sich um ein Integrationsarchitekturmuster, mit dem Salesforce Daten zur Laufzeit direkt aus externen Systemen abfragen kann, ohne diese Daten in den Salesforce-Speicher kopieren oder replizieren zu müssen. Statt Daten einzugeben, sendet die Plattform die Abfrage aus.
Daher interagieren Salesforce-Benutzer über vertraute Salesforce-Oberflächen (wie Seitenlayouts, Themenlisten, Berichte oder Flows) mit externen Daten, während die Daten im zugehörigen Quellsystem verbleiben. Governance, Zugriffssteuerung und Datenresidenz bleiben dort, wo sie hingehören.
Dieses Muster basiert auf einem einzigen Architekturprinzip: Daten verbleiben an der Quelle. Die Berechnung wird in die Daten verschoben.
Die meisten Salesforce-Bereitstellungen in Unternehmen können über Abgleichspipelines in externe Datenplattformen (wie Data Warehouses, betriebliche Datenbanken oder Analyse-Shops) integriert werden. Pipelines extrahieren, transformieren und laden Daten nach Plan in Salesforce. Dieser Ansatz funktioniert, aber die Replikation führt zu strukturellen Kompromissen:
- Abgeglichene Daten werden immer verzögert. Pipelines führen zu Verzögerungen und veraltete Daten führen zu schlechten Entscheidungen.
- Jede Kopie der Daten erweitert den Compliance-Geltungsbereich. Für sensible Daten (wie personenbezogene Daten, Finanzdatensätze oder Gesundheitsdaten) in mehreren Systemen müssen mehrere Governance-Richtlinien verwaltet werden.
- Pipelines erfordern laufende betriebliche Investitionen, Überwachung, Fehlerbehandlung, Schemadrift-Verwaltung und Wiederverarbeitungslogik.
Die Datenvirtualisierung behebt diese Kompromisse direkt. Sie entfernt die Pipeline vollständig für schreibgeschützte Anwendungsfälle, behält die Daten an ihrem maßgeblichen Speicherort bei und bietet Salesforce-Benutzern eine kontrollierte Echtzeitansicht der externen Daten ohne den Aufwand für den Abgleich.
Externe Objekte sind der primäre Mechanismus, über den bei der Datenvirtualisierung externe Daten in Salesforce angezeigt werden. Sie verhalten sich wie Salesforce-Standardobjekte: über SOQL abfragbar, in Seitenlayouts und Themenlisten sichtbar und über Salesforce-Standard-APIs zugänglich. Der wesentliche Unterschied besteht darin, dass keine Daten in Salesforce gespeichert werden. Das externe Objekt ist eine Schemaprojektion: eine Definition, wie die externen Daten aussehen, und keine Kopie der Daten selbst.
Wenn ein Benutzer eine Seite lädt oder einen Bericht ausführt, der auf ein externes Objekt verweist, führt Salesforce eine Live-Abfrage für das externe System aus und gibt nur den Ergebnissatz für diese Interaktion zurück.
Wenn Salesforce eine SOQL-Abfrage für ein externes Objekt ausführt, übersetzt es Filter (WHERE-Klauseln), Sortieraufträge (ORDER BY) und Obergrenzen (LIMIT) in die entsprechende SQL und sendet sie an das externe System. Das externe System führt die Abfrage in seinem eigenen Rechenmodul aus und gibt nur den gefilterten Ergebnissatz zurück. Die Arbeit erfolgt dort, wo sich die Daten befinden, und nur die Antwort wird an Salesforce zurückgesendet.
Die Datenvirtualisierung erzwingt zwei unabhängige Sicherheitsebenen gleichzeitig. Das externe System wendet seine eigenen Zugriffssteuerungen zum Zeitpunkt der Abfrageausführung an, einschließlich Sicherheit auf Zeilenebene, Spaltenmaskierung und rollenbasiertem Zugriff. Salesforce wendet obendrein sein eigenes Sicherheitsmodell an: Profile, Berechtigungssätze, Feldebenensicherheit und Freigaberegeln. Beide Ebenen sind bei jeder Abfrage aktiv. Keines ersetzt das andere.
Architekten beschreiben die Datenvirtualisierung häufig als “Null-Kopie”-Muster. Nullkopie bedeutet, dass kein persistenter Abgleich in den Salesforce-Speicher erfolgt. Es gibt keine ETL-Pipeline, die Datensätze in Salesforce-Objekte schreibt. Es gibt keine geplante Synchronisierung, die eine lokale Kopie erstellt. Das externe Objekt enthält keine Zeilen.
Zero-Copy bedeutet nicht null Datenübertragung. Sobald ein Benutzer ein externes Objekt abfragt, wird eine Ergebnismenge vom externen System über das Netzwerk an Salesforce übertragen. Bei großen Ergebnismengen oder hoher Abfragehäufigkeit sind die Kosten für den Datenausgang und die Netzwerklatenz echte Faktoren für Architekten, für die sie konzipieren müssen. Dies ist keine Einschränkung zum Ausblenden: Hierbei handelt es sich um eine zu berücksichtigende Designeinschränkung.
Beachten Sie diese architektonischen Unterschiede, wenn Ihr Anwendungsfall hohe Volumen, häufigen Zugriff oder eine geringe Latenz erfordert.
Snowflake ist eines der gängigsten externen Systeme, die über die Datenvirtualisierung mit Salesforce verbunden sind. Es dient als konkretes Beispiel dafür, wie das Muster von Anfang bis Ende funktioniert.
In dieser Konfiguration stellt Salesforce über Salesforce Connect mit dem SQL-Adapter für Snowflake eine Verbindung zu Snowflake her. Snowflake-Tabellen und -Ansichten werden in Salesforce als externe Objekte angezeigt. Wenn ein Benutzer ein externes Objekt abfragt, übersetzt Salesforce die SOQL in SQL und sendet sie über einen authentifizierten HTTPS-Callout an die Snowflake-Anweisungs-API. Snowflake führt die Abfrage in seinem virtuellen Lagerhaus aus, wendet seine eigene Sicherheit auf Zeilenebene und Spaltenmaskierung an und gibt nur den Ergebnissatz zurück. Zu keinem Zeitpunkt werden Daten in den Salesforce-Speicher geschrieben.
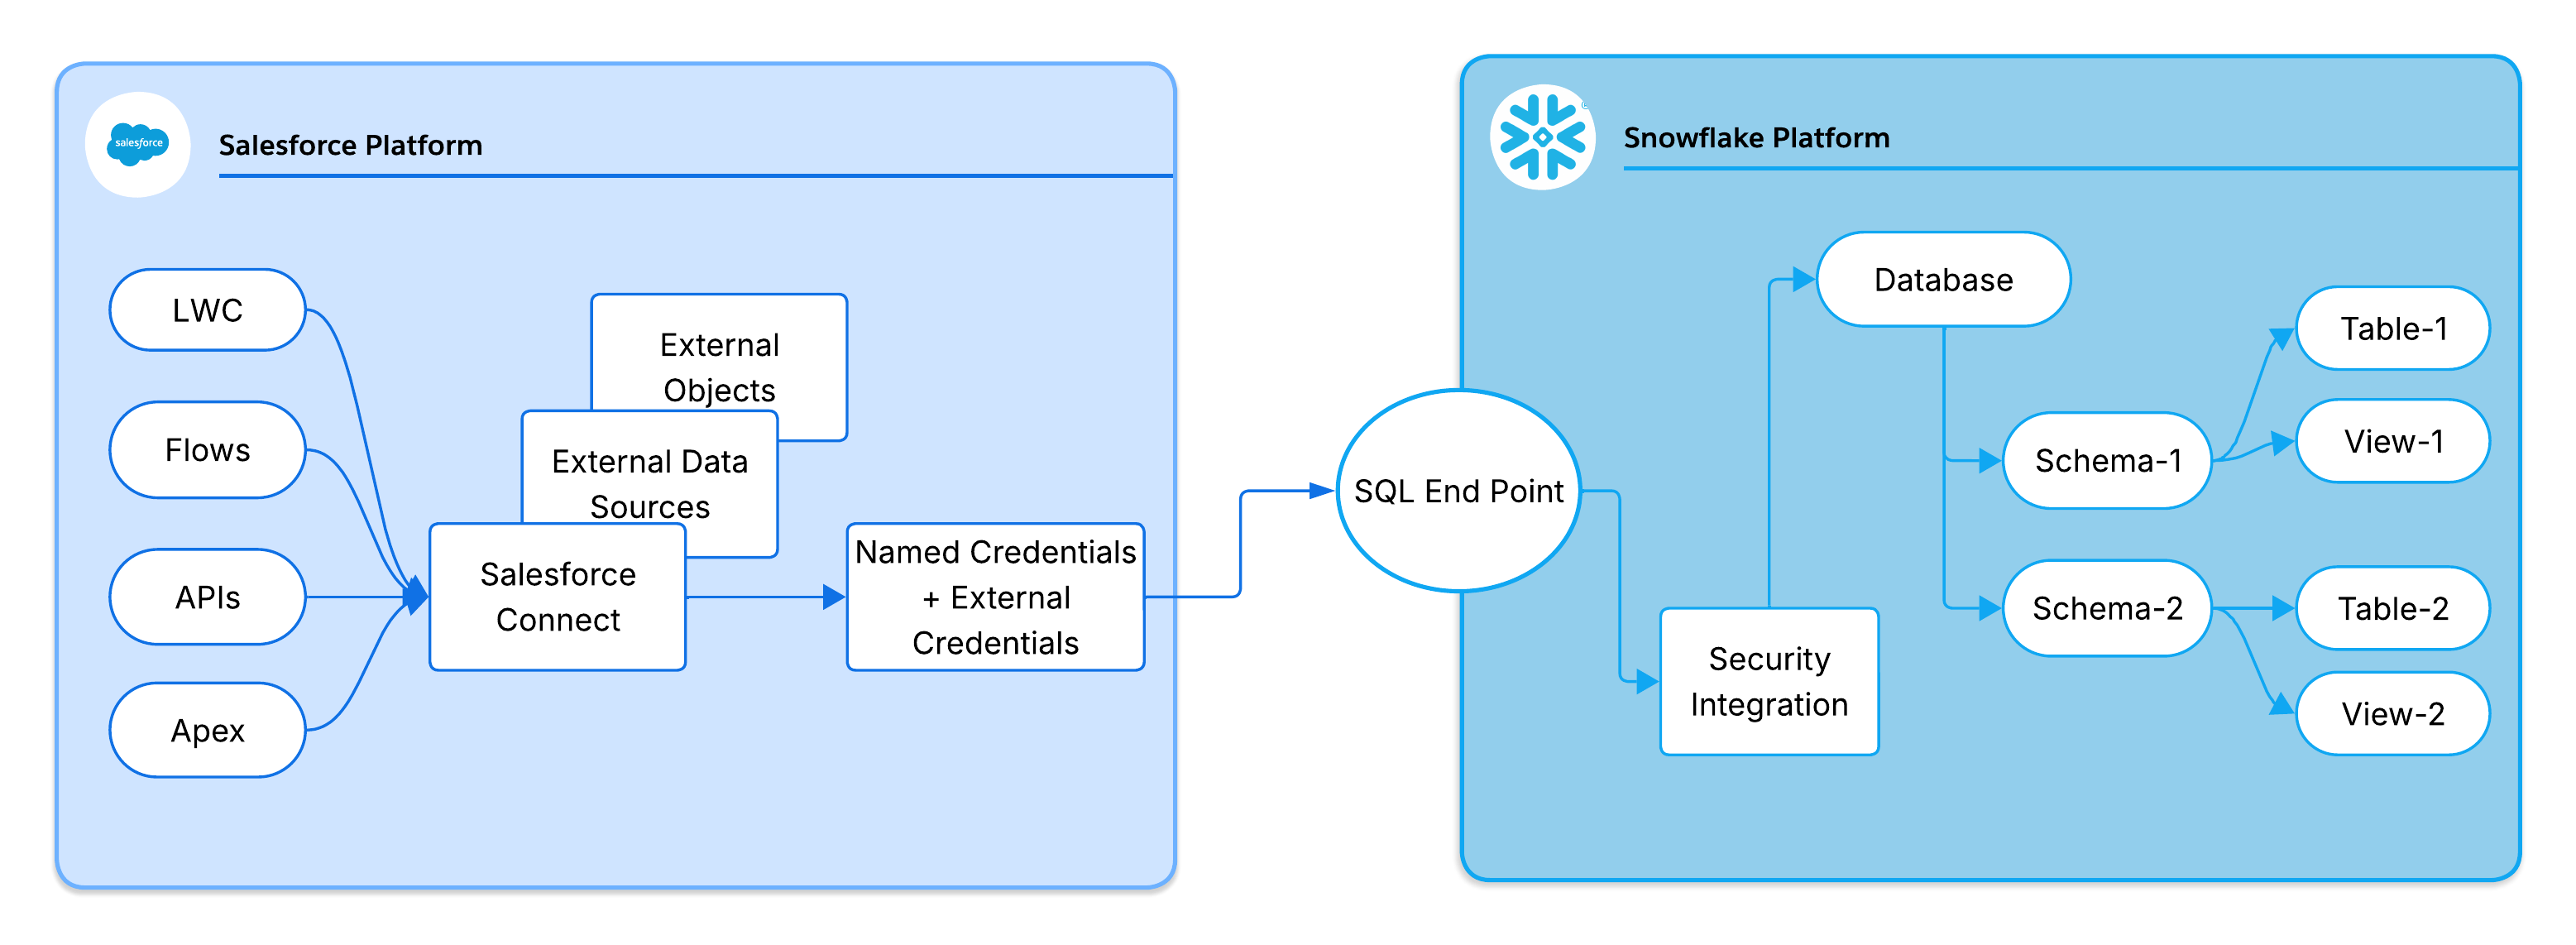
Salesforce Connect verwendet für die Authentifizierung bei Snowflake ein delegiertes OAuth 2.0-Modell. Die wichtigsten Komponenten sind:
- Auth-Anbieter: Verwaltet den OAuth-Handshake mit Snowflake. Verarbeitet Tokenanforderungen und ordnet das zurückgegebene Token den Salesforce-Anmeldeinformationen zu.
- Externe Anmeldeinformationen: Enthält die OAuth-Zugriffs- und Aktualisierungstoken sicher im Speicher für verschlüsselte Salesforce-Anmeldeinformationen und schleust sie in ausgehende Callouts ein.
- Anmeldeinformationen mit Namen: Definiert den Snowflake-Endpunkt-URL und verweist auf die externen Anmeldeinformationen.
- Snowflake-Sicherheitsintegration: Registriert Salesforce als vertrauenswürdigen OAuth-Client in Snowflake. Definiert den zulässigen Umleitungs-URI, OAuth-Flows und Token-TL.
Diese Komponenten bilden eine Abhängigkeitskette: Die externe Datenquelle verweist auf die Anmeldeinformation mit Namen, die auf die externen Anmeldeinformationen verweist, die auf den Authentifizierungsanbieter verweisen. Das Verständnis dieser Kette ist bei der Fehlerbehebung bei der Konnektivität oder bei Zugriffsfehlern unerlässlich.
Salesforce unterstützt bei der Authentifizierung mit Snowflake zwei Identitätsdelegationsmodelle:
- Benannter Prinzipal: Ein freigegebener Serviceaccount authentifiziert alle Salesforce-Benutzer bei Snowflake. Dies ist einfacher zu konfigurieren, weist jedoch keine Überprüfbarkeit pro Benutzer oder eine detaillierte Snowflake-Zugriffssteuerung auf.
- Pro-Benutzer-Prinzipal: Jeder Salesforce-Benutzer authentifiziert sich mit seinem eigenen OAuth-Token. Dadurch werden Snowflake-Sicherheit auf Zeilenebene und vollständige benutzerbasierte Audit-Trails mit einem Kompromiss aus höherem Token-Verwaltungsaufwand (OAuth-Flows pro Benutzer, Aktualisierung, Widerruf) ermöglicht.
Entscheidungshilfe: Verwenden Sie “Prinzipal pro Benutzer” für regulierte Daten oder personenbezogene Daten. Verwenden Sie Benannter Prinzipal, wenn Salesforce-Freigaberegeln eine ausreichende Zugriffssteuerung bieten und Einfachheit Priorität hat.
Diese Salesforce-Obergrenzen prägen das Lösungsdesign bei Verwendung externer Objekte mit Snowflake direkt:
- Callout-Obergrenze: 100 pro Apex Transaktion. Seiten oder Flows mit mehreren Abfragen für externe Objekte können diese Obergrenze schnell erreichen.
- Callout-Timeout: Maximal 120 Sekunden. Langfristig ausgeführte Snowflake-Abfragen führen zu einer Laufzeitausnahme.
- SOQL-Zeilenobergrenze: 50.000 Zeilen. Paginieren Sie große Ergebnissätze.
- Asynchrone Einschränkungen: Callouts werden durch Batch-Apex und die meisten asynchronen Kontexte eingeschränkt. Behalten Sie den Zugriff auf externe Objekte innerhalb synchroner Transaktionsgrenzen bei. Ziehen Sie für asynchrone Anwendungsfälle, die externe Objekte abfragen, Fortsetzungs-Callouts für vom Benutzer initiierte asynchrone Interaktionen in Betracht oder erstellen Sie den Flow, um externen Datenzugriff in einer synchronen Transaktion auszuführen und Ergebnisse asynchron weiterzugeben.
Gestaltungsanleitung: Fragen Sie keine externen Objekte in Schleifen ab. Übertragen Sie WHERE-Klauselfilter an Snowflake, um die Ergebnisgröße und die Callout-Häufigkeit zu reduzieren.
Jede Abfrage, die Salesforce an Snowflake sendet, wird im Snowflake-Abfrageverlauf mit vollständigen Ausführungsmetadaten protokolliert: Latenz, gescannte Zeilen, verwendete Lagerhalle und die ausführende Identität. Dieser Verlauf bietet eine durchgängige Überprüfbarkeit von der Salesforce-Benutzeraktion bis zur Snowflake-Ausführung und ist das primäre Diagnosetool für die Leistungsoptimierung und Zugriffsvalidierung.
Die Datenvirtualisierung eignet sich gut für Anwendungsfälle, in denen Echtzeitzugriff, Governance und reduzierter Abgleichsaufwand die Einschränkungen eines Verbund-Abfragezeitzugriffsmodells überwiegen.
Verwenden Sie es in folgenden Fällen:
- Vorrangige Voraussetzung ist ein schreibgeschützter Analysezugriff. Wenn Benutzer externe Daten in Salesforce-Benutzeroberflächen, -Berichten oder -Flows abfragen und anzeigen müssen, ohne zurückschreiben zu müssen, entfällt durch die Datenvirtualisierung der Pipeline-Aufwand für schreibgeschützte Szenarien.
- Die Datenaktualisierung ist entscheidend. Wenn veraltete replizierte Daten ein Geschäftsrisiko darstellen (z. B. veraltete Finanzsalden, Inventarwerte oder Compliance-Status), garantiert das Verbundmodell, dass jede Abfrage Live-Daten widerspiegelt.
- Governance- und Datenresidenzanforderungen sind streng. Wenn es aufgrund gesetzlicher oder vertraglicher Einschränkungen nicht möglich ist, sensible Daten in Salesforce zu kopieren, werden die Daten durch die Virtualisierung an ihrem maßgeblichen Speicherort beibehalten und gleichzeitig in Salesforce zugänglich gemacht. Nur ein System enthält die Daten.
- Eine zweischichtige Zugriffssteuerung ist erforderlich. Wenn die nativen Zugriffssteuerungen des externen Systems und das Salesforce-Sicherheitsmodell gleichzeitig angewendet werden, erzwingt das Verbundmodell beides ohne Datenduplizierung.
- Das externe System ist bereits das maßgebliche Datensatzsystem. Wenn die Daten bereits im Quellsystem bereinigt, verwaltet und abfragbar sind, werden durch die Virtualisierung redundante Transformations-, Speicherkosten- und Divergenzrisiken vermieden.
Vermeiden Sie Folgendes:
- Schreibvorgänge mit geringer Latenz sind erforderlich. Externe Objekte sind schreibgeschützt. Anwendungsfälle für das Writeback erfordern ein anderes Integrationsmuster.
- Komplexe Verknüpfungen mit mehreren Objekten sind erforderlich. SOQL für mehrere externe Objekte unterstützt keine Verknüpfungen. Materialisieren Sie verbundene Daten vorab als einzelne Ansicht im Quellsystem.
- Für Salesforce AI oder Agentforce Funktionen sind native Daten erforderlich. Derzeit funktionieren die Funktionen von Einstein und Agentforce (einschließlich der Kontextbildung für Einstein Copilot, Prognosebewertungen und Agentforce-Aktionen) in nativen Salesforce-Objekten. Externe Objekte werden von diesen Funktionen nicht als Kontext- oder Aktivierungsdatenquelle unterstützt. Wenn die AI-Aktivierung für diese Daten gilt, ist Salesforce Data 360 die empfohlene ergänzende Lösung.
- Hochfrequente Zugriffsmuster mit hohem Volumen. Externe Objekte sind für den On-Demand-Zugriff konzipiert. Bei Arbeitslasten, die Hunderte von Abfragen pro Minute auslösen, werden Obergrenzen ausgeschöpft und die Leistung beeinträchtigt.
In den folgenden Anwendungsfällen wird veranschaulicht, wie die Salesforce-Datenvirtualisierung in gängigen Unternehmensszenarien angewendet wird. In jedem Beispiel wird Snowflake als externes System verwendet. Das zugrunde liegende Muster gilt jedoch für alle SQL-kompatiblen Datenquellen, die von Salesforce Connect unterstützt werden.
Aufforderung: Supportteams benötigten zusammengeführte Berichte, in denen Salesforce-Kundenvorgangsdaten mit dem Ticketvolumen, der Lösungszeit und den in Snowflake gespeicherten Eskalationskennzahlen kombiniert wurden. Das Erstellen und Verwalten einer Abgleichs-Pipeline für diese Daten führte zu Verzögerungen und erhöhtem operativem Aufwand für einen schreibgeschützten Berichtsanwendungsfall.
Lösung: Das Team hat Snowflake-Ansichten mit Ticketkennzahlen als externe Objekte in Salesforce angezeigt. Das Team hat Salesforce-Berichte so konfiguriert, dass sie native Kundenvorgangsobjekte mit den externen Ticketdaten verknüpfen.
Ergebnis:
- Berichte berücksichtigen immer Snowflake-Live-Daten. Keine Pipeline-Verzögerung.
- Die Steuerung sensibler Supportkennzahlen verbleibt in Snowflake.
- Keine ETL-Pipeline zum Erstellen, Überwachen oder Verwalten.
Aufforderung: Ein Finanzteam hat in Snowflake Daten zur Obergrenze und zum Saldo für Kredite verwaltet. Wenn diese Werte über die umgekehrte ETL in Salesforce repliziert wurden, führte dies zu Verzögerungen bei der Replikation, wodurch sich Vertriebsmitarbeiter auf Geschäfte basierend auf veralteten Kreditinformationen einlassen mussten. Das Compliance-Team hat zudem das Risiko gekennzeichnet, dass sensible Finanzdaten im Salesforce-Speicher gespeichert werden.
Lösung: Das Team virtualisierte die Snowflake-Finanzansicht als externes Objekt und zeigte sie im Account-Seitenlayout an. Vertriebsmitarbeitern wird der Live-Guthabenstatus nun als Teil ihrer standardmäßigen Accountansicht in Salesforce angezeigt.
Ergebnis:
- Echtzeit-Kreditdaten auf jeder Accountseite. Keine Verzögerung.
- Die umgekehrte ETL-Pipeline wurde für Finanzdaten entfernt.
- Vertrauliche Finanzdaten wurden nie in den Salesforce-Speicher kopiert. Der Compliance-Geltungsbereich verbleibt in Snowflake.
Aufforderung: Während einer Fusion musste das übernehmende Unternehmen Salesforce-Benutzern Einblick in die Betriebsdaten von 6 Snowflake-Datensets mit hohem Volumen geben, die Transaktionen, Abrechnungen und Nutzung abdecken. Das Replizieren von Terabyte-Daten in Salesforce war auf der Zusammenführungszeitachse nicht tragfähig und das Erstellen benutzerdefinierter ETL-Pipelines für jedes Datenset hätte erhebliche technische Investitionen erfordert.
Lösung: Das Team hat externe Objekte für alle 6 Snowflake-Datensets mit Salesforce Connect mit einer Integrationsrolle mit den geringsten Berechtigungen konfiguriert. Kein benutzerdefinierter Code erforderlich. Abfragen werden direkt in Snowflake ausgeführt und alle Aktivitäten werden im Snowflake-Abfrageverlauf für Compliance-Berichte protokolliert.
Ergebnis:
- Vollständig deklarative Konfiguration. Kein benutzerdefinierter Code oder benutzerdefinierte Pipelines erforderlich.
- Garantierte Datenaktualisierung. Jede Abfrage berücksichtigt Snowflake-Live-Daten zur Ausführungszeit.
- Vollständiger Überprüfungspfad im Snowflake-Abfrageverlauf für behördliche und Compliance-Berichte.
Durch die Datenvirtualisierung wird ein eigenes betriebliches Profil eingeführt. Design für die folgenden Fehlerszenarien:
- Ablauf des OAuth-Tokens: Token haben eine endliche Lebenszeit. Abgelaufene Token führen zu Callout-Fehlern. Überwachen Sie 401 nicht autorisierte Antworten und implementieren Sie eine Aktualisierungslogik.
- Warehouse Kaltstart (Schneeflockenspezifisch): Automatisch ausgesetzte Lagerhäuser addieren 5–30 Sekunden für die erste Abfrage. Für benutzerorientierte Anwendungsfälle mit Latenzanforderungen sollten Sie sich während der Geschäftszeiten mit einer geplanten leichten Abfrage vorwärmen.
- Rolleninkongruenz: Eine falsch konfigurierte Rolle im externen System kann null Zeilen stillschweigend zurückgeben und nicht als Fehler. Validieren Sie Rollen-zu-Objekt-Berechtigungen im externen System unabhängig von Salesforce.
- Ergebnissatzüberlauf: Übergroße Nutzlasten überschreiten die API-Obergrenzen. Wenden Sie immer LIMIT-Klauseln an und stellen Sie gefilterte Ansichten anstelle von Rohtabellen bereit.
- Ausfall des externen Systems: Es ist kein Ausweich- oder Cache vorhanden. Verpacken Sie Callouts in Try/Catch und zeigen Sie auf der Benutzeroberfläche informative Fehlerstatus an. Ziehen Sie für geschäftskritische Daten einen gestuften Ansatz in Betracht: virtualisieren Sie sie für den Echtzeitzugriff und pflegen Sie ein leichtes, repliziertes Ausweichmodell für die wichtigsten Felder, um die Verfügbarkeit bei Ausfällen des Quellsystems zu garantieren.
Die Salesforce-Datenvirtualisierung ist auf die folgenden Säulen des Salesforce Well-Architected Framework abgestimmt.
- Trust: Das delegierte OAuth 2.0-Modell und die Hilfestellung für Rollen mit den geringsten Berechtigungen sind auf Trust abgestimmt. Die Zugriffssteuerung mit zwei Ebenen (Quellsystem + Salesforce) erzwingt die Verteidigung im Detail.
- Zuverlässigkeit (Fehlertoleranz): Im Abschnitt “Fehlermodi” wird die Zuverlässigkeit direkt angesprochen: “Tokenablauf”, “Kaltstart”, “Rollenfehlkonfiguration”, “Ergebnissatzüberlauf” und “Ausfallbehandlung” stellen jeweils eine unterschiedliche Fehlerklasse mit einem dokumentierten Lösungspfad dar.
- Zuverlässigkeit (Skalierbarkeit): Abfrage-Pushdown, Anleitungen zur Lagerhausgröße und Callout-Einschränkungen optimieren die Ausführungseffizienz innerhalb der Salesforce-Einschränkungen, was bei Lösungen, die in großem Umfang funktionieren, ein Problem der Zuverlässigkeit darstellt.
- Operational Excellence: Snowflake-Abfrageverlauf als primäres Beobachtbarkeitstool unterstützt Operational Excellence: Architekten entscheiden sich bewusst für die Verwendung von plattformeigenem Tooling für die durchgängige Überprüfbarkeit und Leistungsdiagnostik, statt eine benutzerdefinierte Protokollierungsinfrastruktur zu erstellen.
In diesem Abschnitt erhalten Architekten und Designer einen strukturierten Ausgangspunkt für die Erstellung des Musters für die Datenvirtualisierung in einer Sandbox-Umgebung. Es handelt sich nicht um eine vollständige Implementierungsanleitung. Behandeln Sie sie als eine validierte Sequenz von Entscheidungen und Konfigurationsschritten, um sich an Ihrem ersten Proof of Concept zu orientieren.
Bestätigen Sie Folgendes, bevor Sie mit Konfigurationsarbeiten beginnen:
- Lizenzanspruch: Salesforce Connect ist nicht in allen Salesforce-Editionen enthalten. Für den SQL-Adapter für Snowflake ist eine separate Add-On-Lizenz erforderlich, die über den Salesforce Connect-Basisanspruch hinausgeht. Überprüfen Sie beides in Ihrer Organisation, bevor Sie fortfahren.
- Sandbox zuerst: Schließen Sie alle Phasen in einer Sandbox-Umgebung ab, bevor Sie Ihre Konfiguration in die Produktion höherstufen.
- Snowflake-Zugriff: Bestätigen Sie, dass Sie berechtigt sind, eine Sicherheitsintegration in Snowflake zu erstellen, und dass Sie auf die Zieldatenbank, das Schema und die Objekte zugreifen können.
- Adapterversion: Überprüfen Sie, ob der SQL-Adapter für Snowflake in Ihrer Organisations-Edition verfügbar ist und ob Ihr Snowflake-Account-URL keine Unterstriche enthält (ersetzen Sie ihn durch Bindestriche, wenn dies der Fall ist). Dies ist eine Salesforce Platform-Einschränkung für die Callout-Hostnamensbestimmung).
Das Einrichten der Datenvirtualisierung mit einem externen SQL-System wie Snowflake ist ein deklarativer, konfigurationsgesteuerter Prozess – kein benutzerdefinierter Code erforderlich. Das Setup besteht aus drei aufeinanderfolgenden Phasen: Herstellen von Identity und Trust, Konfigurieren der Datenoberfläche und Bereitstellen von Daten für Endbenutzer.
In dieser Phase wird eine sichere delegierte OAuth 2.0 Trust Chain zwischen Salesforce und dem externen System aufgebaut. Schließen Sie diese Phase ab, bevor Sie mit der Konfiguration der Datenoberfläche beginnen.
- Erstellen Sie einen Authentifizierungsanbieter in Salesforce. Verwenden Sie den OpenID Connect-Typ. Verwenden Sie Platzhalterwerte in dieser Phase – return, um sie nach dem Abrufen von Werten aus dem externen System abzuschließen. Nach dem Speichern generiert Salesforce einen Rückmeldungs-URL. Behalten Sie diesen Wert bei.
- Registrieren Sie Salesforce als OAuth-Client im externen System. In Snowflake bedeutet dies das Erstellen einer Sicherheitsintegration (OAuth, Typ “Vertraulicher Client”). Geben Sie den Salesforce-Rückmeldungs-URL als Umleitungs-URI an. Rufen Sie nach der Erstellung die Client-ID, das Client-Geheimnis, den Autorisierungs-URL und den Token-URL aus der Integration ab.
- Schließen Sie die Konfiguration des Authentifizierungsanbieters ab. Kehren Sie zum Salesforce-Authentifizierungsanbieter zurück und füllen Sie ihn mit den aus dem externen System abgerufenen Werten aus: Verbraucherschlüssel, Verbrauchergeheimnis, Autorisierungs-URL und Token-URL.
- Erstellen Sie die externen Anmeldeinformationen. Legen Sie “Protokoll” auf “OAuth 2.0” fest, verknüpfen Sie es mit dem Authentifizierungsanbieter und fügen Sie einen Prinzipal hinzu (Named or Per-User, based on your identity model decision). Dieses Objekt verwaltet den OAuth-Token-Lebenszyklus.
- Erstellen Sie die Anmeldeinformation mit Namen. Legen Sie den Endpunkt auf den API-URL des externen Systems fest (z. B.
https://<account>.snowflakecomputing.com/api/v2/statements/) und verknüpfen Sie ihn mit den externen Anmeldeinformationen. - Erteilen Sie Profilzugriff auf die externen Anmeldeinformationen. Ohne diesen Schritt können Benutzer keine Verbundabfragen aufrufen, selbst wenn alle anderen Konfigurationen richtig sind.
- Initiieren Sie den OAuth-Flow, um die Authentifizierung abzuschließen. Lösen Sie den OAuth-Handshake in Salesforce aus. Die Plattform leitet zur Anmeldung des externen Systems um, validiert die Anmeldeinformationen und speichert die resultierenden Token sicher in den externen Anmeldeinformationen. Dieser Schritt bindet den Benutzerkontext an ein gültiges Token. Alle Verbundabfragen schlagen fehl, bis dieser Schritt abgeschlossen ist.
In dieser Phase wird Salesforce mit dem externen Datenschema verbunden und es werden die Definitionen für externe Objekte erstellt, die Benutzer und die Plattform abfragen.
- Erstellen Sie die externe Datenquelle. Wählen Sie den entsprechenden Adapter aus (z. B. SQL-Adapter für Snowflake), verweisen Sie auf die Zieldatenbank und das Zielschema und verknüpfen Sie ihn mit den Anmeldeinformationen mit Namen, die Sie in Phase 1 erstellt haben.
- Validieren Sie die Verbindung. Verwenden Sie die integrierte Validierung für die externe Datenquelle. Ein erfolgreiches Ergebnis bestätigt, dass die OAuth Trust Chain abgeschlossen ist und das externe System erreichbar ist.
- Synchronisieren Sie Metadaten. Initiieren Sie eine Metadatensynchronisierung über die externe Datenquelle. Salesforce untersucht das Zielschema selbst und generiert Definitionen für externe Objekte, wobei externe Spalten Salesforce-Feldtypen zugeordnet werden.
- Wählen Sie die erforderlichen Tabellen oder Ansichten aus und stellen Sie sie zur Verfügung. Wählen Sie aus, welche externen Tabellen oder Ansichten als externe Objekte angezeigt werden sollen. Als bewährte Vorgehensweise sollten Sie zusammengestellte Ansichten anstelle von Rohtabellen anzeigen. Ansichten ermöglichen das Vorfiltern von Spalten, Einschränkungen auf Zeilenebene und eine strengere Kontrolle darüber, worauf die Salesforce-Ebene zugreifen kann.
In dieser Phase werden externe Objekte für Endbenutzer in Salesforce Lightning Experience sichtbar und nutzbar.
- Registerkarten für externe Objekte erstellen. Über Registerkarten können externe Objekte direkt in Lightning Apps aufgerufen werden.
- Fügen Sie Seitenlayouts externe Objekte hinzu. Zeigen Sie relevante externe Daten neben nativen Salesforce-Datensätzen an (fügen Sie beispielsweise dem Account-Seitenlayout eine Snowflake-Finanzansicht hinzu).
- Zu Themenlisten hinzufügen. Fügen Sie externe Objekte in Themenlisten ein, um Benutzern eine einheitliche Ansicht der nativen und externen Daten im Kontext zu bieten.
- Validieren Sie die durchgängige Abfragezuordnung. Laden Sie eine Seite oder führen Sie eine Abfrage aus, die auf ein externes Objekt verweist. Untersuchen Sie dann den Abfrageverlauf des externen Systems (z. B. Snowflake-Abfrageverlauf), um zu bestätigen, dass die Abfrage an der Quelle ausgeführt wurde. Überprüfen Sie, ob die Abfrage von der richtigen Rolle, dem richtigen Lagerhaus und der richtigen Identität ausgeführt wurde.
Nachdem alle drei Phasen abgeschlossen sind, können Salesforce-Benutzer über standardmäßige Salesforce-Oberflächen mit externen Live-Daten interagieren, ohne sich bewusst zu sein, dass die Daten außerhalb von Salesforce stammen.
Die Salesforce-Datenvirtualisierung ersetzt die replikationsbasierte Integration durch die Abfrage-Zeit-Verbundverbindung. Die Daten verbleiben in ihrer maßgeblichen Quelle. Salesforce-Benutzer interagieren mit ihnen über standardmäßige Plattformoberflächen. Es muss keine Pipeline erstellt, keine Kopie verwaltet und keine Verzögerungen verwaltet werden.
Dieses Muster ist die richtige Wahl, wenn schreibgeschützter Zugriff, Datenaktualisierung in Echtzeit, strenge Governance und Zugriffskontrolle mit zwei Ebenen die primären Faktoren sind. Sie ist die falsche Wahl, wenn Schreibvorgänge erforderlich sind, KI- oder Automatisierungsfunktionen von nativen Salesforce-Objekten abhängen oder wenn Zugriffsmuster zu häufig sind, um Obergrenzen zu berücksichtigen.
Snowflake veranschaulicht das Muster gut: eine gesteuerte Verbundverbindung zur Abfragezeit, die deklarativ ohne benutzerdefinierten Code hergestellt wird, durchgängig über den Snowflake-Abfrageverlauf beobachtbar ist und sowohl über die nativen Snowflake-Zugriffssteuerungen als auch über das vollständige Salesforce-Sicherheitsmodell erzwungen werden kann.
Validieren Sie vor dem Commit für diese Architektur den Lizenzanspruch, bewerten Sie die Obergrenze anhand Ihrer erwarteten Zugriffsmuster und bestätigen Sie die OAuth-Bereitschaft in einer Sandbox-Umgebung. Das Muster belohnt durchdachtes Design im Voraus: Legen Sie das Identitätsmodell, die Anmeldeinformationskette und die Anzeigestrategie richtig fest und die betriebliche Bilanz ist minimal.
Yugandhar Bora ist Software-Entwickler bei Salesforce und spezialisiert sich auf die Datenarchitektur innerhalb der Plattform “Data & Intelligence Applications”. Er leitet Initiativen des Enterprise Architecture Review Board (EARB), die sich auf die Datenverwaltung und vereinheitlichte Datenmodelle konzentrieren, und trägt gleichzeitig zu automatisierten Plattformbereitstellungslösungen bei.