Die meisten Unternehmensintegrations-Pipelines zwischen Salesforce und externen Analyseplattformen basieren auf benutzerdefiniertem Code. Sie funktionieren, bis etwas kaputt geht. Schemaabweichungen, API-Erschöpfung und Lücken beim endgültigen Löschen erfordern ständige technische Eingriffe. Da Unternehmen auf agile, bürgerentwicklerfähige Architekturen umsteigen, wird dieses Modell zu einem Engpass: Analytics-Teams warten in Engineering-Sprints darauf, einem nachgelagerten Schema ein Salesforce-Feld hinzuzufügen, fehlgeschlagene nächtliche Ladevorgänge verzögern die Berichterstellung am Montagmorgen und einfache Konfigurationsänderungen erfordern Codeüberprüfungen und Bereitstellungen.
CRM Analytics, die native Salesforce Analytics- und Business Intelligence-Plattform, löst dieses Problem, indem Unternehmen Daten erkunden, interaktive Dashboards erstellen und AI-gestützte Statistiken aufdecken können, ohne das Salesforce-Ökosystem zu verlassen. Zentral für diese Funktion ist eine deklarative Low-Code-Datensynchronisierungsfunktion, die nativ in die Plattform integriert ist: CRM Analytics SyncOut und CRM Analytics SyncIn.
CRM Analytics SyncOut verschiebt Salesforce-Datensätze nach einem konfigurierten Zeitplan in externe Datenspeicher. Verwenden Sie dazu die Datenerfassung (CDC) für inkrementelle Ladevorgänge und die integrierte Verfolgung der endgültigen Löschung, um dauerhaft entfernte Datensätze zu kennzeichnen. CRM Analytics SyncIn integriert externe Daten wieder in Salesforce, ordnet Objektfeldern Spalten zu und aktualisiert Datensätze mithilfe der Bulk-API 2.0. Beide werden vollständig über das Salesforce-Setup konfiguriert. Keine Pipelines, keine Staging-Skripts, keine benutzerdefinierte Überwachung. Administratoren konfigurieren einen Synchronisierungsauftrag in einer einzelnen Setup-Sitzung. Die Plattform übernimmt die Ausführung, Wiederholung, Fehlerprotokollierung und Schemazuordnung automatisch.
In dieser Anleitung wird das Muster erläutert, wann es verwendet werden soll, wie es mit Snowflake als einem bearbeiteten Beispiel implementiert werden kann und welche architektonischen Überlegungen darüber entscheiden, ob es zu einem bestimmten Integrationsproblem passt.
Lizenzhinweis: CRM Analytics SyncIn und SyncOut sind in Salesforce-Basis-Editionen ohne CRM Analytics-Lizenz-Add-On nicht verfügbar. Bestätigen Sie Lizenzansprüche, bevor Sie eine Synchronisierungsarchitektur entwerfen, die von diesen Funktionen abhängt.
Die Datenintegration ist eine der reibungsreichsten Oberflächen in der Unternehmensarchitektur. Für eine benutzerdefinierte ETL-Pipeline von Salesforce zu einer Analytics-Plattform sind in der Regel eine verbundene Anwendung für die Authentifizierung, ein geplanter Auftrag für die SOQL-Extraktion, eine Transformationsebene zum Abstimmen von Feldtypen, ein Staging-Bereich für das Massenladen und eine Überwachungsebene zum Erkennen von Fehlern erforderlich. Jede Komponente des benutzerdefinierten Codes stellt einen Fehlerpunkt dar.
Die Kosten dieser Reibmassen im Laufe der Zeit. Die Schemaabweichung in Salesforce (ein umbenanntes Feld, ein neuer Auswahllistenwert, ein geänderter API-Name) unterbricht die Pipeline stillschweigend. Die API-Erschöpfung während der Spitzennutzung verzögert die Extraktion. Hart gelöschte Datensätze werden nie in der Zieltabelle angezeigt, sodass veraltete Daten, die von nachgelagerten Analysen als live behandelt werden, erhalten bleiben. Das Engineering-Team wird zum Engpass für routinemäßige Datenvorgänge.
CRM Analytics SyncIn und SyncOut ändern das Betriebssystem. Die Konfiguration ersetzt Code. Die Plattform übernimmt die Verantwortung für die Ausführung, die Fehlerbehandlung, die Schemazuordnung und die Beobachtbarkeit. Administratoren können Synchronisierungsaufträge definieren, ändern und überwachen, ohne ein Entwicklungs-Ticket zu erstellen.
Das Ergebnis dieses neuen Betriebsmodells ist eine kürzere Zeit vom Integrationsdesign bis zur Betriebssynchronisierung, ein geringerer Engineering-Aufwand und ein Integrationsmodell, das innerhalb von Plattformeinschränkungen skaliert werden kann, statt benutzerdefinierte Codepflege zu erfordern.
SyncIn und SyncOut sind die beiden Richtungsmodi der CRM Analytics-Datensynchronisierung. SyncOut verschiebt Salesforce-Datensätze auf eine externe Plattform. SyncIn integriert externe Datensätze in Salesforce. Beide arbeiten mit einem deklarativen Konfigurationsmodell, wobei kein benutzerdefinierter Code erforderlich ist.
Deklarative Konfiguration bedeutet, dass das gesamte Synchronisierungsverhalten über die Zeigen-und-Klicken-Benutzeroberfläche im Salesforce-Setup definiert wird. Quellobjekt, Zieltabelle, Feldzuordnungen, Synchronisierungszeitplan, Synchronisierungsmodus und Filter werden alle über Konfigurationsmetadaten festgelegt. Die Plattform leitet den Ausführungsplan aus diesen Metadaten ab und verwaltet ihn durchgängig.
Die vollständige Synchronisierung im Vergleich zur inkrementellen Synchronisierung steuert, welche Daten bei jeder Ausführung verschoben werden. Eine vollständige Synchronisierung fragt alle Datensätze ab, die bei jeder Ausführung den Filterkriterien entsprechen. Bei einer inkrementellen Synchronisierung wird CDC verwendet, um nur Datensätze abzufragen, die sich seit der letzten Ausführung geändert haben. Die inkrementelle Synchronisierung ist der empfohlene Modus für Objekte mit hohem Volumen, da sie den API-Verbrauch und die Synchronisierungsdauer erheblich reduziert.
Bei der Datenerfassung (Change Data Capture, CDC) handelt es sich um eine Salesforce Platform-Funktion, die Änderungen auf Feldebene an Objekten als Ereignisströme aufzeichnet. SyncOut verwendet CDC, um Erstellungen, Aktualisierungen und Löschungen zu erkennen, ohne vollständige Tabellenscans durchzuführen. CDC muss pro Objekt im Salesforce-Setup aktiviert sein, bevor durch eine Synchronisierungskonfiguration darauf verwiesen werden kann.
Die Verfolgung beim endgültigen Löschen löst eines der hartnäckigsten Probleme in Salesforce-to-Externe ETL. Wenn ein Datensatz in Salesforce endgültig gelöscht wird, wird er aus SOQL-Standardabfragen ausgeblendet. Ohne explizite Verfolgung erfährt die externe Plattform nie, dass der Datensatz entfernt wurde. Wenn die Verfolgung der endgültigen Löschung von SyncOut aktiviert ist, werden gelöschte Datensätze in der Zieltabelle mit DEL_FLAG = 'Y' gekennzeichnet, wodurch nachgelagerte Systeme ein zuverlässiges Signal zum Filtern veralteter Daten erhalten.
Die Synchronisierungshäufigkeit kann von 15 Minuten bis wöchentlich konfiguriert werden. Die Auswahl ist ein Kompromiss zwischen Datenaktualisierung, API-Verbrauch und Snowflake-Warehouse-Berechnungskosten. 15-minütige Synchronisierungen erfolgen nahezu in Echtzeit für betriebliche Dashboards. Tägliche Synchronisierungen sind für Batch-Berichtsarbeitslasten geeignet.
Gouverneur schränkt die Gestaltung von Synchronisierungsaufträgen ein: Die Obergrenze für Salesforce-API-Anforderungen (15.000 Aufrufe pro 24 Stunden in der Unlimited Edition), die Bulk-API 2.0-Batchgröße von 10.000 Datensätzen und die SOQL-Abfragezeilenobergrenze von 50.000 pro Transaktion bestimmen die Größe und Planung von Synchronisierungsaufträgen. Die Plattform verarbeitet das Blockieren und Paginieren automatisch. Architekten müssen jedoch bei allen in der Organisation ausgeführten Synchronisierungsaufträgen einen begrenzten Freiraum berücksichtigen.
Snowflake ist ein primäres Ziel und eine Quelle für die Datensynchronisierung mit Salesforce CRM Analytics. Sie dient als konkretes Beispiel dafür, wie die Batch- und inkrementelle Datenverschiebung durchgängig funktioniert.
In diesem Abschnitt finden Sie eine Übersicht über die Implementierung von CRM Analytics SyncOut und SyncIn mit Snowflake als externer Analyseplattform. Sie deckt jede Methode, die freigegebenen Authentifizierungsmodelle, Sicherheits-Frameworks, wichtige Plattformüberlegungen und Beobachtbarkeitspraktiken ab.
In dieser SyncOut-Konfiguration verwendet Salesforce CRM Analytics SyncOut, um Datensätze an Snowflake zu übertragen. Die Plattform extrahiert Daten über SOQL, verarbeitet Typkonvertierungen automatisch und lädt sie in Snowflake-Tabellen nach einem konfigurierten Zeitplan (15 Minuten bis wöchentlich). Informationen zur spezifischen Ladesemantik finden Sie in der aktuellen Salesforce- und Snowflake-Dokumentation.
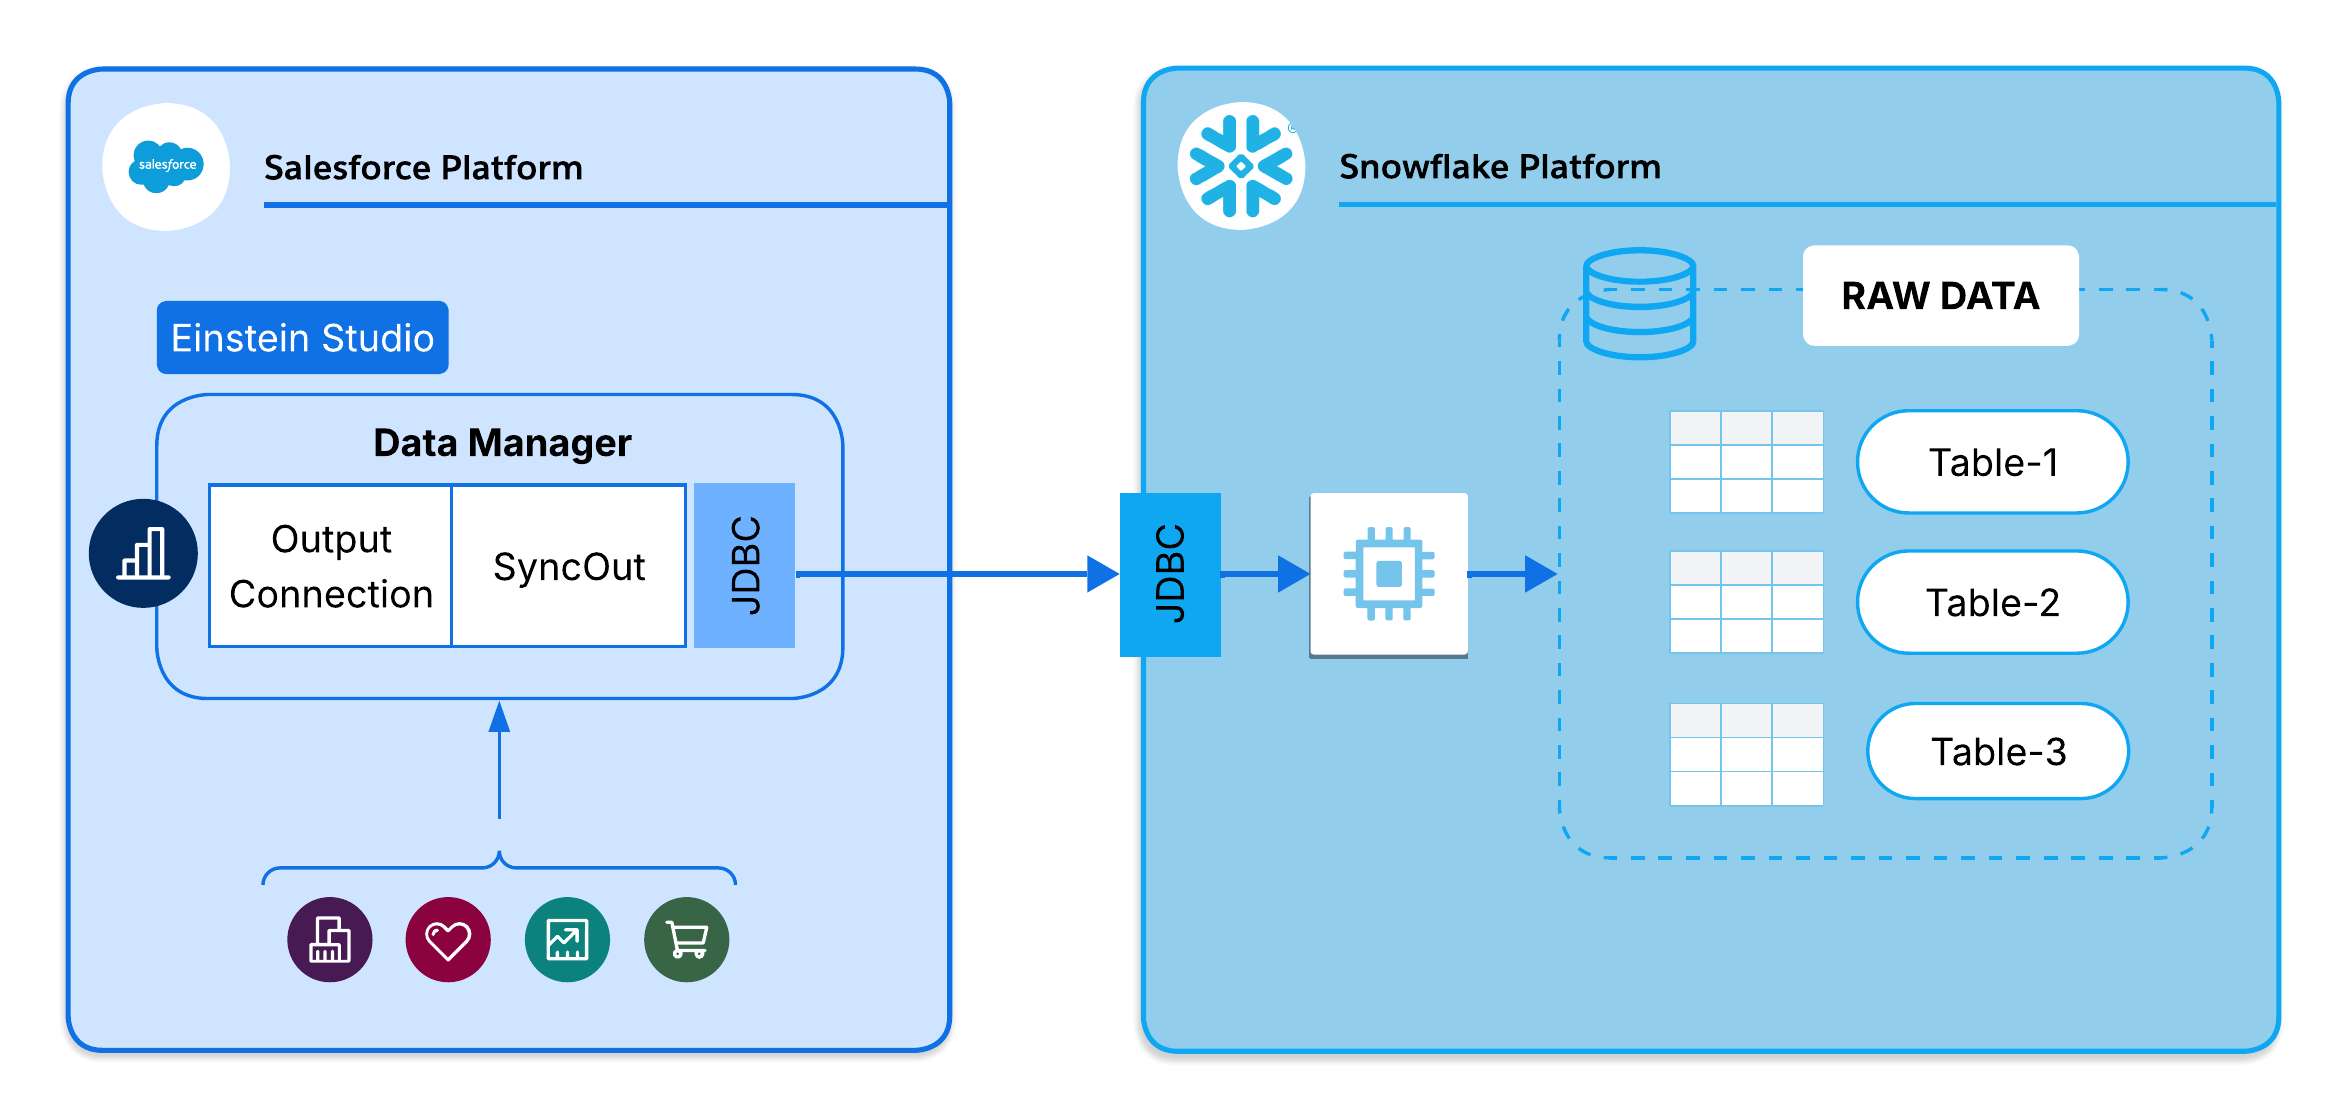
In dieser SyncIn-Konfiguration verwendet Salesforce CRM Analytics SyncIn, um Daten wieder in Salesforce abzurufen. Die Plattform fragt Snowflake über die Anweisungs-API ab und fügt Ergebnisse mithilfe der Bulk-API 2.0 in Salesforce ein. Große Ergebnissätze werden automatisch paginiert, um die API-Obergrenzen einzuhalten. Die Synchronisierung wird nach einem konfigurierten Zeitplan ausgeführt, der zwischen 15 Minuten und wöchentlich liegt.
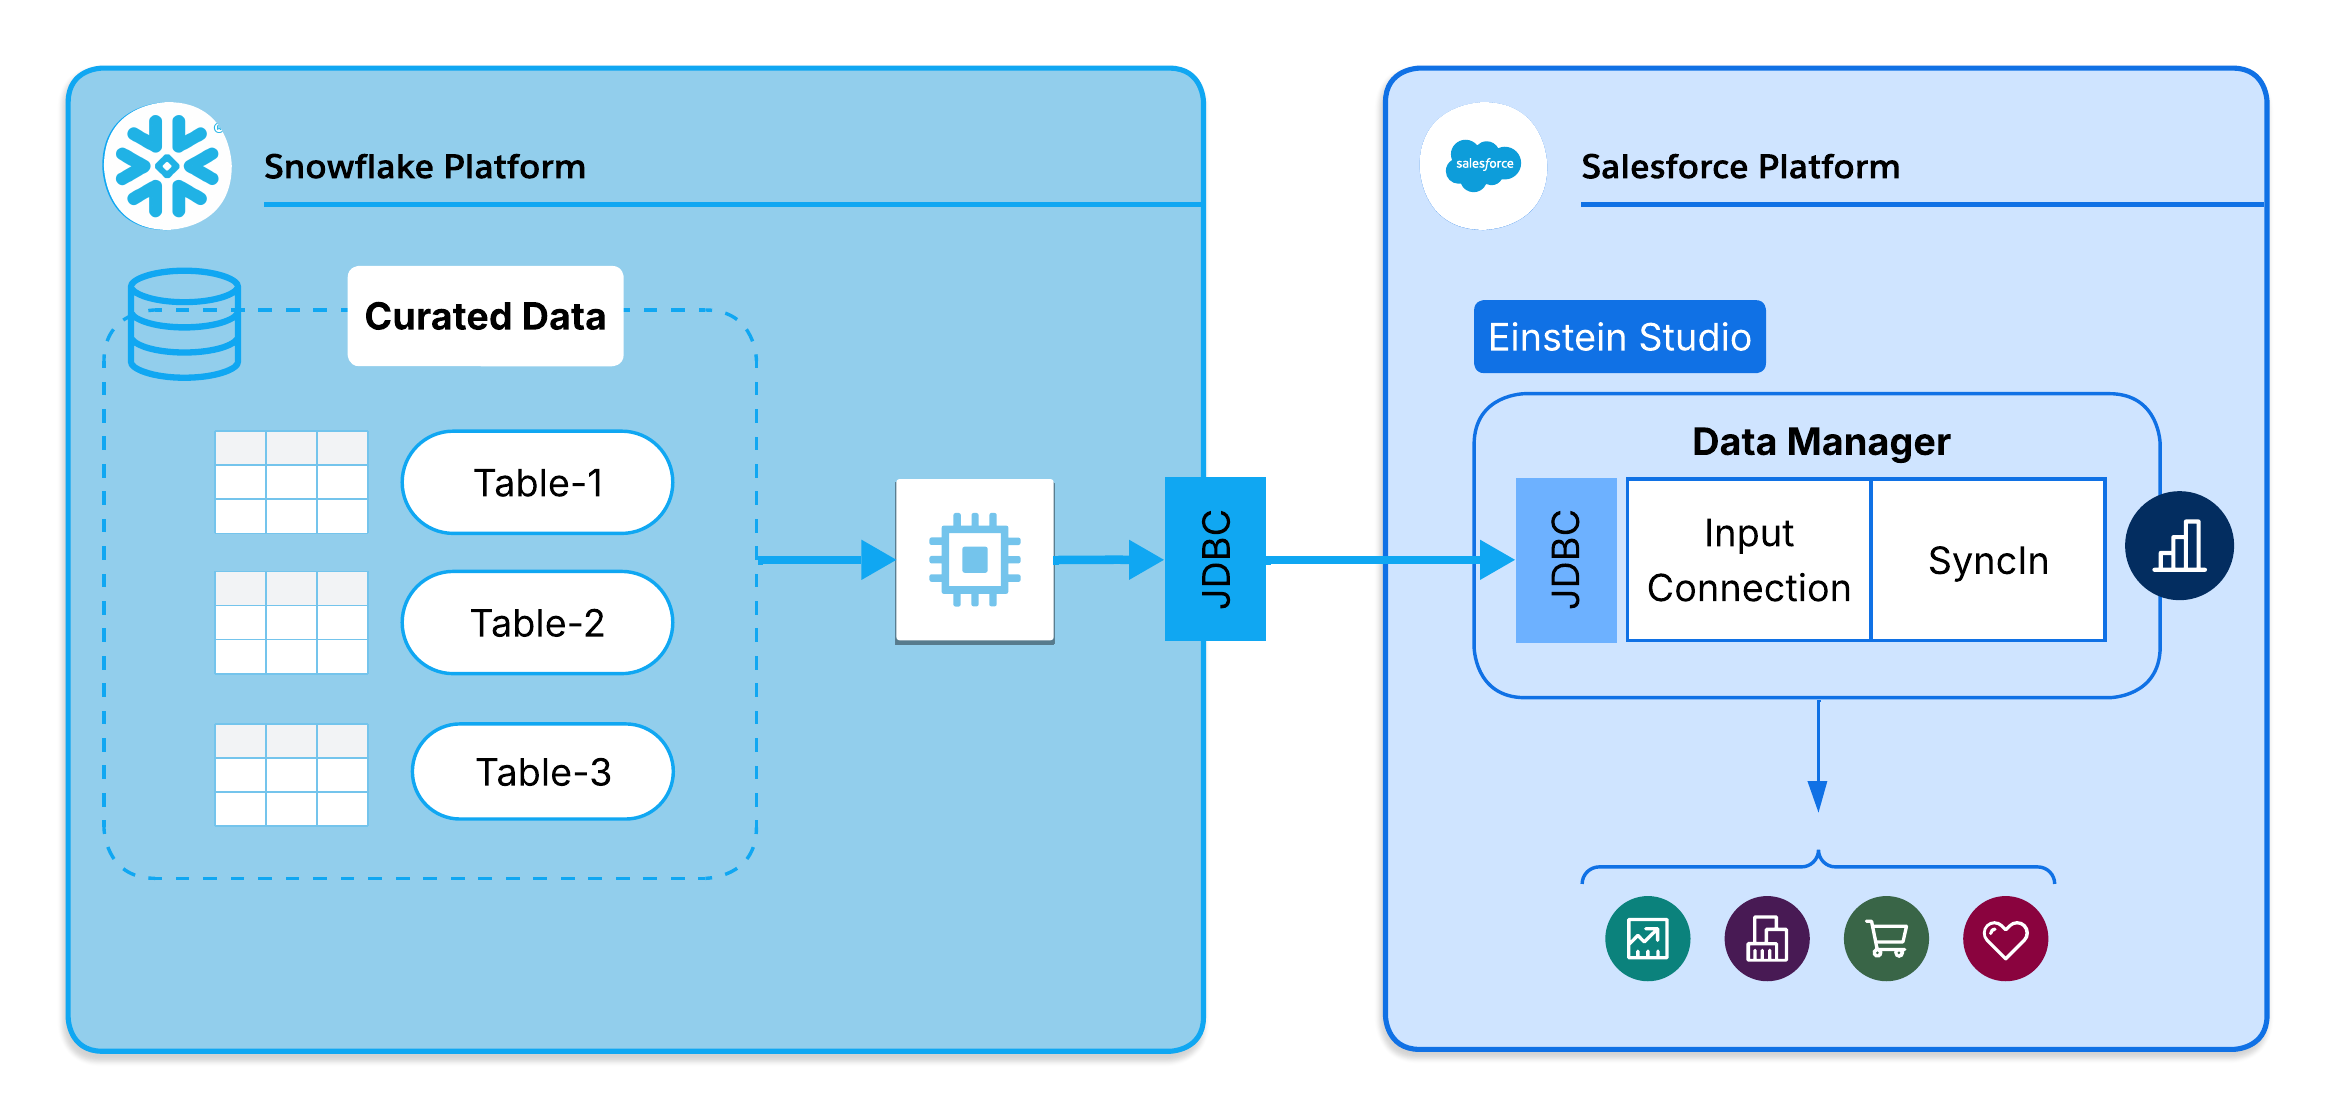
Die Salesforce-Synchronisierung unterstützt mehrere Authentifizierungsmethoden, um eine sichere Verbindung mit Snowflake herzustellen. Die beiden primären Ansätze für Unternehmensintegrationen sind “Schlüsselpaar (Privater Schlüssel)” und “Delegierter OAuth 2.0”.
Methode 1: Authentifizierung mit Schlüsselpaar (Privater Schlüssel): Die Schlüsselpaarauthentifizierung ist der empfohlene Ansatz für die automatisierte Übertragung von Daten zwischen Systemen wie CRM Analytics SyncIn und SyncOut. Die Authentifizierung basiert auf JSON-Webtoken (JWT) und nicht auf Kennwörtern oder aktualisierbaren Token. Dadurch eignet sie sich gut für unbeaufsichtigte geplante Aufträge, für die keine Tokenaktualisierung erforderlich ist.
- Salesforce-Zertifikat: Generieren Sie einen privaten Schlüssel und speichern Sie ihn sicher in der Salesforce-Zertifikat- und -Schlüsselverwaltung.
- Externe/benannte Anmeldeinformationen: Konfiguriert für die Verwendung eines JWT-Austauschs. Salesforce verwendet den gespeicherten privaten Schlüssel zum Signieren ausgehender Verbindungsanforderungen.
- Öffentlicher Snowflake-Benutzerschlüssel: Der übereinstimmende öffentliche Schlüssel wird direkt dem dedizierten Snowflake-Serviceaccount zugewiesen (z. B. ALTER USER CRM_ANALYTICS_SYNC_USER SET RSA_PUBLIC_KEY = ’…’). Snowflake verwendet diesen Schlüssel dann, um die eingehende JWT-Signatur zu überprüfen. Für diese Methode ist keine Sicherheitsintegration erforderlich.
Methode 2: Delegierte OAuth 2.0-Authentifizierung: Alternativ kann Salesforce zur Authentifizierung einen OAuth-Handshake verwenden. Die wichtigsten Komponenten sind:
- Auth-Anbieter: Verwaltet den OAuth-Handshake mit Snowflake mithilfe der Client-Anmeldeinformationen, die aus der Snowflake-Sicherheitsintegration abgerufen wurden.
- Externe Anmeldeinformationen: Enthält die OAuth-Token sicher in Salesforce und fügt sie automatisch in die Synchronisierungs-Callouts ein.
- Anmeldeinformationen mit Namen: Definiert den Snowflake-Endpunkt-URL (z. B. https://<account>.snowflakecomputing.com) und verweist auf die externen Anmeldeinformationen.
- Snowflake-Sicherheitsintegration: Registriert Salesforce als vertrauenswürdigen OAuth-Client in Snowflake (OAUTH_CLIENT = CUSTOM). Definiert den zulässigen Umleitungs-URI und aktiviert Aktualisierungstoken.
Konfigurationsabhängigkeit: Unabhängig von der ausgewählten Methode bilden diese Komponenten eine Abhängigkeitskette, die die Synchronisierungskonfiguration mit dem Endpunkt verbindet. Es ist erforderlich, den entsprechenden Salesforce-Profilen Zugriff auf die Anmeldeinformationen mit Namen zu erteilen. Ohne diesen Zugriff schlagen Synchronisierungsaufträge unabhängig von allen anderen Konfigurationen aufgrund von Authentifizierungsfehlern fehl.
Die Hintergrundsynchronisierung basiert auf einer einzelnen Integrationsidentität.
- Dedizierter Service-Account: Erstellen Sie einen dedizierten Snowflake-Service-Account mit einer Rolle mit den geringsten Berechtigungen, die nur auf die für die Synchronisierung erforderlichen Datenbanken, Schemas und Tabellen beschränkt ist.
- Granulare Berechtigungen: Für SyncOut sind für diese Rolle die Optionen EINFÜGEN, AKTUALISIEREN und AUSWÄHLEN in Zieltabellen erforderlich. Verwenden Sie niemals Rollen mit hohen Berechtigungen wie ACCOUNTADMIN, SECURITYADMIN oder SYSADMIN.
- Obergrenzen für Gouverneure und Aufteilung: Während der SyncOut-Extraktion werden große Ergebnismengen automatisch in Gruppen unterteilt, um die Salesforce SOQL-Obergrenzen einzuhalten. SyncIn ruft große Ergebnissätze über die Snowflake-Anweisungs-API über die automatische Paginierung ab, um Datenvolumen effizient zu verwalten.
- Datenerfassung ändern (CDC): Die inkrementelle SyncOut-Funktion basiert auf dem Salesforce CDC-Ereignisstrom, um erstellte, aktualisierte oder gelöschte Datensätze zu identifizieren. Wenn die Verfolgung endgültig gelöscht wird, werden gelöschte Salesforce-Datensätze nicht verworfen, sondern in Snowflake mit
DEL_FLAG = 'Y'gekennzeichnet. - Einschränkungen zum Aktualisieren und Einfügen: SyncIn verwendet die Bulk-API 2.0, um Daten wieder in Salesforce zu laden. Dazu muss für das Salesforce-Zielobjekt ein angegebenes Feld mit externer ID konfiguriert werden, das als Schlüssel zum Aktualisieren und Einfügen fungiert.
- Gestaltungsanleitung: Synchronisieren Sie immer über zusammengestellte Snowflake-Ansichten anstelle von Rohtabellen. Ansichten ermöglichen die Vorfilterung von Zeilen, die Spaltenauswahl und die Anwendung von Geschäftslogik, wodurch das Datenvolumen, die Synchronisierungsdauer und die Snowflake-Warehouse-Berechnungskosten im Verhältnis zur angewendeten Vorfilterung reduziert werden.
Bei jeder Synchronisierungsausführung werden umfassende Überwachungsprotokolle generiert, um die Datenbewegung zu validieren. Das Dashboard “Sync Job Monitor” (Synchronisierungsauftragsüberwachung) bietet Echtzeitstatus, verarbeitete Datensatzzahlen, Ausführungsdauer und detaillierte Fehlerprotokolle für SyncIn und SyncOut. Auf der Snowflake-Seite wird jede von Salesforce gesendete Abfrage im Snowflake-Abfrageverlauf protokolliert und bietet einen vollständigen Überblick über die Ausführungslatenz, die gescannten Zeilen und die Nutzung der Lagerhausberechnung. Darüber hinaus definieren Architekten spezielle Snowflake-Aktivierungstabellen, um Metadaten der Synchronisierungsausführung zu erfassen – Zeitstempel, Datensatzzahlen und Fehler. Diese werden nicht automatisch von der Plattform generiert. Vergleichen Sie für die durchgängige Validierung die Anzahl der Datensätze auf beiden Plattformen: Überprüfen Sie aktive Datensätze in Snowflake (WHERE DEL_FLAG = 'N') für SyncOut-Ausführungen und vergleichen Sie die Anzahl der Salesforce-Zielobjekte direkt mit der ursprünglichen Snowflake-Quellansicht für SyncIn-Ausführungen.
Verwenden Sie CRM Analytics SyncIn und SyncOut in folgenden Fällen:
- Bidirektionale Synchronisierung ist eine Voraussetzung: Daten fließen über SyncIn in Salesforce und über SyncOut an eine externe Plattform.
- Die Verfolgung beim endgültigen Löschen ist wichtig: Die integrierte Kennzeichnung von SyncOut löst ein historisch komplexes ETL-Problem ohne benutzerdefinierte Schlichtungslogik.
- CDC-basierte inkrementelle Synchronisierung ist möglich: Bei Salesforce-Objekten mit hohem Volumen reduziert CDC den API-Verbrauch und die Synchronisierungsdauer im Vergleich zu vollständigen Scans erheblich.
- Geplante Batchsynchronisierung erfüllt Latenzanforderungen: Die Mindestsynchronisierungshäufigkeit beträgt 15 Minuten und eignet sich für operative Dashboards und Analysenberichte nahezu in Echtzeit.
- Niedriger Betriebsaufwand hat Priorität: Integrierte Dashboards bieten vollständige Synchronisierungssichtbarkeit ohne benutzerdefinierte Protokollierungs- oder Warninfrastruktur und die deklarative Setup-Benutzeroberfläche ermöglicht es Administratoren, Synchronisierungsaufträge zu definieren, zu ändern und zu überwachen, ohne ein Entwicklungs-Ticket zu erstellen.
Verwenden Sie dieses Muster nicht in folgenden Fällen:
- Komplexe Transformationen sind erforderlich: Verknüpfungen mit mehreren Tabellen, JSON-Analysen oder die Verarbeitung erweiterter Geschäftslogik in Snowflake-Ansichten oder einer speziellen Transformationsebene vor oder nach der Synchronisierung.
- Eine Latenz von weniger als 15 Minuten ist erforderlich: Verwenden Sie für Echtzeit-Anwendungsfälle Plattformereignisse oder Streaming-APIs.
- Streaming-Arbeitslasten mit sehr hohem Volumen sind im Umfang: Objekte mit Millionen von Transaktionen pro Stunde werden durch dedizierte Streaming-Pipelines (Kafka, Plattformereignisse) besser bedient.
- Benutzerdefinierte Fehlerbehandlungslogik ist erforderlich: Die Plattform bietet standardmäßige Wiederholungen und Fehlerprotokollierungen. Komplexe Wiederholungsmuster oder benutzerdefinierte Benachrichtigungen erfordern Apex oder eine externe Orchestrierung.
- Organisationsübergreifende oder cloudübergreifende Synchronisierung: CRM Analytics SyncIn und SyncOut funktionieren in einer einzigen Salesforce-Organisation. MuleSoft oder eine benutzerdefinierte Integrationsebene ist für Szenarien mit mehreren Organisationen erforderlich.
Ein Team hat komplexe ETL-Pipelines ausgeführt, um Snowflake-Analysedaten in CRM Analytics-Datensets hochzuladen. Die Pipelines waren langsam, anfällig und erforderten ständige technische Wartung.
CRM Analytics SyncIn wurde so konfiguriert, dass zusammengestellte aggregierte Snowflake-Ansichten direkt mit benutzerdefinierten Salesforce-Objekten synchronisiert werden. Das Team hat CRM Analytics-Dashboards neu konfiguriert, sodass sie aus diesen Objekten und nicht aus CRM Analytics-Datensets gelesen werden. Das Ergebnis: zwei ETL-Pipelines wurden entfernt, die Synchronisierungsdauer wurde von vier Stunden auf 30 Minuten reduziert und Administratoren können Synchronisierungskonfigurationen ändern, ohne ein Engineering-Ticket zu erstellen.
Ein Datenteam musste endgültig gelöschte Salesforce-Datensätze in seinem Snowflake-Betriebsdatenspeicher verfolgen. Herkömmliche Ansätze erforderten Aufteilungsaufträge und eine komplexe ID-Abstimmungslogik, deren Ausführung Stunden in Anspruch nahm und die über Schemaänderungen hinweg spröde war.
Das Team hat CRM Analytics SyncOut mit aktivierter CDC und aktivierter Verfolgung der endgültigen Löschung konfiguriert. Gelöschte Datensätze werden nun in der Snowflake-Verbrauchstabelle automatisch mit DEL_FLAG = ‘Y’ gekennzeichnet. Bei nachgelagerten Analyseabfragen wird WHERE DEL_FLAG = ‘N’ angewendet, um nur aktive Datensätze anzuzeigen. Die Schlichtungslogik wurde vollständig entfernt und die Synchronisierungsdauer wurde von acht Stunden auf 15-minütige inkrementelle Ausführungen reduziert.
Während einer Übernahme synchronisierte das übernehmende Unternehmen sechs Salesforce-Objekte mit hohem Volumen in Snowflake, um organisationsübergreifende Berichte zu erstellen und die Einhaltung gesetzlicher Vorschriften innerhalb eines festgelegten Zeitraums zu gewährleisten.
Das Team hat CRM Analytics SyncOut für alle sechs Objekte mit CDC-basierten inkrementellen Synchronisierungen konfiguriert. Überprüfungsmetadatentabellen verfolgten Schemaänderungen und Datensatzzahlen über den Integrationszeitraum hinweg. Sie haben keinen benutzerdefinierten Code geschrieben. Die Datenaktualisierung wurde von täglichen auf 15-Minuten-Intervalle verbessert und die Überprüfungsmetadatentabellen boten die für Compliance-Berichte erforderliche Rückverfolgbarkeit.
Synchronisierungsaufträge verwenden das API-Budget der Organisation. Eine Organisation, die viele Hochfrequenz-Synchronisierungsaufträge für große Objekte ausführt, riskiert, dass die Obergrenze von 15.000 API-Aufrufen pro 24 Stunden ausgeschöpft ist. Inventarisieren Sie alle Synchronisierungsaufträge, schätzen Sie den API-Verbrauch pro Ausführung und staffeln Sie Pläne, um die Last zu verteilen. Bei Objekten mit niedrigen bis moderaten Änderungsraten kann der inkrementelle CDC-basierte Modus den API-Verbrauch pro Ausführung im Vergleich zur vollständigen Synchronisierung erheblich reduzieren.
SyncIn und SyncOut führen Abfragen und Datenladevorgänge für ein Snowflake-Warehouse aus und verbrauchen dabei Rechenguthaben. Für einfache SELECT-Abfragen ist in der Regel ein X-Small- oder Small Warehouse ausreichend. Bei großen SyncOut-Lasts kann Medium oder Large erforderlich sein. Konfigurieren Sie die automatische Aussetzung (5 Minuten Inaktivität) und die automatische Fortsetzung für das Lagerhaus. Verwenden Sie ein spezielles Lagerhaus für Produktionssynchronisierungsaufträge, um Kosten zu isolieren und Streitigkeiten mit Benutzerabfragen zu vermeiden.
Wenn ein Salesforce-Feld umbenannt, entfernt oder der API-Name geändert wird, schlägt die entsprechende SyncOut-Feldzuordnung stillschweigend fehl oder protokolliert Fehler. Richten Sie einen Änderungsverwaltungsprozess ein, der die Überprüfung aktiver Synchronisierungskonfigurationen im Rahmen von Salesforce-Metadatenänderungen beinhaltet. Die Snowflake-Aktivierungstabellen enthalten einen Änderungsverlauf, mit dem Sie ermitteln können, wann ein Drift-Ereignis aufgetreten ist.
Für die Verfolgung der endgültigen Löschung in SyncOut muss CDC im Salesforce-Objekt aktiviert sein. Wenn die CDC nicht aktiviert ist, hat die Option “Harte Löschungen verfolgen” keine Auswirkungen. Validieren Sie die CDC-Aktivierung als Teil der Checkliste für die Synchronisierungskonfiguration, insbesondere während der ersten Einrichtung oder nach Organisationsmigrationen.
Die häufigste Fehlerklasse ist der Ablauf von Anmeldeinformationen oder der Verlust von Berechtigungen. Anmeldeinformationen mit Namen müssen gültig bleiben und der Snowflake-Service-Account muss seine Lagerhausnutzungsgenehmigungen und Tabellenberechtigungen beibehalten. Bei OAuth-basierten Setups können Tokenaktualisierungsfehler Synchronisierungsaufträge stillschweigend verzögern. Überwachen Sie das Dashboard “Sync Job Monitor” (Auftragsüberwachung synchronisieren) auf Authentifizierungsfehlermuster und konfigurieren Sie Chatter oder E-Mail-Benachrichtigungen für Auftragsfehler.
SyncIn verwendet ein externes Salesforce-ID-Feld als Schlüssel zum Aktualisieren und Einfügen. Wenn die Snowflake-Quellansicht doppelte Werte im Schlüsselfeld enthält, schlägt das Aktualisieren und Einfügen für betroffene Datensätze fehl. Erzwingen Sie die Eindeutigkeit für das Schlüsselfeld in der Snowflake-Ansichtsebene, bevor es die Synchronisierungskonfiguration erreicht.
Wenn Synchronisierungsaufträge fehlschlagen, protokolliert die Plattform detaillierte Fehlermeldungen pro Datensatz in der Synchronisierungsauftragsüberwachung. Allgemeine Fehlerszenarien und ihre Lösungen:
- Authentifizierungsfehler: Überprüfen Sie den Status der Anmeldeinformationen mit Namen und den Snowflake-Accountablauf. Authentifizieren Sie OAuth erneut, wenn die Tokenaktualisierung fehlgeschlagen ist.
- Fehler bei der Feldzuordnung: Überprüfen Sie die Typkompatibilität zwischen Snowflake-Spalten und Salesforce-Feldern. Überprüfen Sie die Feldebenensicherheit für den aktuellen Benutzer.
- Obergrenze überschritten: Reduzieren Sie die Synchronisierungshäufigkeit oder wechseln Sie in den inkrementellen CDC-Modus, um den API-Verbrauch zu verteilen.
- Schneeflockenlager ausgesetzt: Konfigurieren Sie die automatische Fortsetzung im Lagerhaus oder lösen Sie eine manuelle Fortsetzung vor der nächsten geplanten Synchronisierung aus.
- Hard-Delete-Verfolgung funktioniert nicht: Bestätigen Sie, dass CDC für das Objekt aktiviert ist und die Kennzeichnung “Harte Löschungen verfolgen” in der Synchronisierungskonfiguration festgelegt ist.
Die CRM Analytics-Datensynchronisierung ist auf mehrere Säulen des Salesforce Well-Architected Framework abgestimmt.
- Zuverlässigkeit (Fehlertoleranz): Die Plattform verwaltet die Ausführung, die Wiederholungslogik und die Verarbeitung von Teilfehlern automatisch. Fehlerhafte Datensätze werden einzeln in der Synchronisierungsauftragsüberwachung protokolliert. Implementieren Sie die Datensatzzahlabstimmung nach Fehlern, um die Konsistenz zu bestätigen, um Fehlerbenachrichtigungen zu ergänzen und die Synchronisierungsauftragsüberwachung auf wiederkehrende Fehlermuster zu überwachen. Die CDC-basierte inkrementelle Synchronisierung reduziert den Explosionsradius einer fehlgeschlagenen Ausführung, indem der Umfang des Datenfensters begrenzt wird.
- Trust: Das Modell für Anmeldeinformationen (Anmeldeinformationen mit Namen, externe Anmeldeinformationen, Authentifizierungsanbieter) erzwingt verschlüsselte Speicherung, automatische Tokenaktualisierung und zentralisierte Verwaltung. Der Zugriff mit den geringsten Berechtigungen auf der Snowflake-Seite begrenzt den Explosionsradius kompromittierter Anmeldeinformationen. Die Feldebenensicherheit wird während der Synchronisierung erzwungen. Benutzer können keine Felder synchronisieren, für die sie nicht autorisiert sind.
- Ressourcen- und Kostenoptimierung: Der inkrementelle CDC-Modus ist der primäre Hebel für die Leistungsoptimierung. Sie reduziert den API-Verbrauch, die Synchronisierungsdauer und die Snowflake-Berechnungskosten im Vergleich zur vollständigen Synchronisierung. Die Snowflake-Ansichtsvorfilterung reduziert das Datenvolumen bei der Übertragung weiter. Die automatische Aussetzung des Lagerhauses verhindert Leerlauf der Rechenausgaben.
- Operational Excellence: Das deklarative Konfigurationsmodell bedeutet, dass Synchronisierungsaufträge in Metadaten und nicht in Code definiert sind. Dadurch sind sie überprüfbar, reproduzierbar und ohne technisches Zutun verwaltbar. Integrierte Überwachungs-Dashboards bieten vollständige Beobachtbarkeit ohne benutzerdefinierte Protokollierungsinfrastruktur.
- Zuverlässigkeit (Skalierbarkeit): Die Plattform verarbeitet das Chunking, die Paginierung und das Bulk-API-Batching automatisch. Bei Objekten mit sehr hohem Datensatzvolumen sind der inkrementelle CDC-Modus und die Planung außerhalb der Spitzenzeiten die primären architektonischen Hebel für die Aufrechterhaltung des Durchsatzes innerhalb der Obergrenzenbeschränkungen.
Diese Checkliste umfasst die Mindestschritte zum Einrichten und Validieren einer Synchronisierungskonfiguration.
Checkliste vor der Konfiguration:
- Aktivieren Sie die Datenerfassung ändern für alle Salesforce-Objekte, die für den inkrementellen SyncOut-Modus vorgesehen sind (Setup → Datenerfassung ändern).
- Erstellen Sie einen dedizierten Snowflake-Service-Account mit einer Rolle mit den geringsten Berechtigungen und erteilen Sie nur die erforderlichen Tabellen- und Lagerhausberechtigungen.
- Erstellen Sie eine Snowflake-Sicherheitsintegration, wenn Sie die OAuth-Authentifizierung verwenden.
- Identifizieren Sie das Feld “Externe ID” in jedem Salesforce-Objekt, das SyncIn als Schlüssel zum Aktualisieren und Einfügen verwendet. Überprüfen Sie die Eindeutigkeit in den Quelldaten.
Konnektivität:
- Erstellen Sie einen Authentifizierungsanbieter in Salesforce (Setup → Authentifizierungsanbieter).
- Erstellen Sie externe Anmeldeinformationen und verlinken Sie auf “Authentifizierungsanbieter” (Setup → Anmeldeinformationen mit Namen → Externe Anmeldeinformationen).
- Erstellen Sie Anmeldeinformationen mit Namen und verlinken Sie auf Externe Anmeldeinformationen (Setup → Anmeldeinformationen mit Namen).
- Erteilen Sie Anmeldeinformationen mit Namen Zugriff auf relevante Salesforce-Profile.
SyncOut-Konfiguration:
- Erstellen Sie eine Snowflake-Verbindung (Setup → Analytics Studio → Datenmanager → Verbindungen → Snowflake-Verbindungen).
- Create SyncOut Configuration (SyncOut-Konfiguration erstellen): Quellobjekt, Zieltabelle, Synchronisierungsmodus, Feldzuordnungen, CDC, Verfolgung der endgültigen Löschung, Zeitplan.
- Beginnen Sie mit der täglichen Synchronisierung. Validieren Sie diese Datenqualität und Leistung, bevor Sie die Häufigkeit erhöhen.
SyncIn-Konfiguration:
- Erstellen einer externen Datenquelle (Setup → Analytics Studio → Datenmanager → Verbindungen → Snowflake-Verbindungen).
- Create SyncIn Configuration (Synchronisierungskonfiguration erstellen): Quellansicht, Zielobjekt, Feld “Externe ID”, Feldzuordnungen, Zeitplan.
- Die Synchronisierung erfolgt über Snowflake-Ansichten, nicht über Rohtabellen.
Validierung:
- Überprüfen Sie die Synchronisierungsauftragsüberwachung nach der ersten Ausführung (Setup → Analytics Studio → Datenmanager → Synchronisierungsauftragsüberwachung).
- Fragen Sie Snowflake-Aktivierungstabelle ab, um zu bestätigen, dass Synchronisierungsmetadaten geschrieben wurden.
- Validieren Sie die Kennzeichnung durch endgültiges Löschen, indem Sie bestätigen, dass die Spalte DEL_FLAG vorhanden und ausgefüllt ist.
- Vergleichen Sie die Anzahl der Datensätze zwischen Quelle und Ziel.
- Konfigurieren Sie Fehlerbenachrichtigungen per Chatter oder E-Mail.
Verwenden Sie dieses Muster, wenn die geplante Batchsynchronisierung die Latenzanforderungen erfüllt, ein bidirektionaler Datenfluss erforderlich ist und die Reduzierung der technischen Abhängigkeit von Integrationsvorgängen Priorität hat.
Das Snowflake-Arbeitsbeispiel in diesem Handbuch veranschaulicht den vollständigen Lebenszyklus: Einrichtung, Konfiguration, Ausführungs-Flow und Validierung der Konnektivität. Dieselben Prinzipien gelten für alle unterstützten externen Datenplattformen.
Wenn Latenzzeiten von weniger als 15 Minuten, komplexe Transformationen oder Szenarien mit mehreren Organisationen vorliegen, sollten Sie Plattformereignisse, Streaming-APIs oder MuleSoft als ergänzende oder alternative Ansätze bewerten.
Yugandhar Bora ist Software-Entwickler bei Salesforce und spezialisiert sich auf die Datenarchitektur innerhalb der Plattform “Data & Intelligence Applications”. Er leitet Initiativen des Enterprise Architecture Review Board (EARB), die sich auf die Datenverwaltung und vereinheitlichte Datenmodelle konzentrieren, und trägt gleichzeitig zu automatisierten Plattformbereitstellungslösungen bei.