Agenten argumentieren über Ziele, leiten Parameter aus dem Kontext ab und wählen Aktionen dynamisch aus. Daher muss jede Integration, die ein Agent anspricht, Mehrdeutigkeiten verarbeiten, sichere Wiederholungen unterstützen und fehlschlagen, damit der Agent sie autonom wiederherstellen kann.
Agentische Systeme setzen verschiedene Annahmen außer Kraft, die beim traditionellen Integrationsdesign als selbstverständlich angesehen werden. Eingaben sind nicht immer formiert. Eine einzelne Benutzeraktion kann eine Kette von Agenten über Organisationsgrenzen hinweg hervorrufen, für die jeweils eine delegierte Handlungsvollmacht erforderlich ist.
In diesem Dokument werden die Architekturverschiebungen dargestellt, die sich aus dieser Realität ergeben: die neuen Designprinzipien, die Agentenmuster und wie sie von der Salesforce Platform bereitgestellt werden.
Jedes Muster in diesem Dokument weist dieselbe Struktur auf:
Name: Der Musterkennzeichner, der den im Muster enthaltenen Integrationstyp angibt.
Kontext: Das allgemeine Integrationsszenario, auf das sich das Muster bezieht. Kontext bietet Informationen darüber, was Benutzer erreichen möchten und wie sich die Anwendung entsprechend ihren Anforderungen verhält.
Probleme: Die Herausforderung (ausgedrückt als Frage), die das Muster lösen soll. Lesen Sie beim Überprüfen der Muster diesen Abschnitt, um schnell nachzuvollziehen, ob das Muster auf Ihr Integrationsszenario zutrifft.
Kräfte: Die Einschränkungen und Umstände, die die Lösung des Problems erschweren können.
Anwendung für Salesforce-Muster: Die empfohlene Methode, das Muster auf das Szenario anzuwenden.
Skizze: Ein Sequenzdiagramm der einheitlichen Modellierungssprache (Unified Modeling Language, UML), das zeigt, wie die Musteranwendung das Szenario angeht.
Ergebnisse: Wie das Muster die dem Szenario zugeordneten Kräfte auflöst. Dieser Abschnitt enthält auch neue Herausforderungen, die durch die Anwendung des Musters auftreten können.
Überlegungen zum Design: Plattformunabhängige Anleitung zur richtigen Anwendung der Lösung, gefolgt von Salesforce-spezifischen Implementierungshinweisen. Diese Überlegungen beziehen sich auf die Grundsätze des Aktionsdesigns und die plattformspezifischen Konfigurationsanforderungen.
Fehlerbehandlung und -behebung: Anleitung zum Verwalten von Fehlern während der Musteranwendung. Dieser Parameter deckt vier Bereiche ab:
- Wie Aktionen Fehler an den Agenten durch strukturierte, handlungsrelevante Fehlerantworten kommunizieren, die ausreichend Kontext für die nachgelagerte Entscheidungsfindung bieten
- Wie der Agent bestimmt, ob er es wiederholt, selbst korrigiert oder die Ausführung anhält
- Wie Vergütungsaktionen Teilergebnissen und nicht übereinstimmenden plattformübergreifenden Status begegnen
- Identitätsanforderungen für eingestellte Schreibvorgänge
Sicherheitsüberlegungen: Sicherheitsanforderungen für die sichere Anwendung des Musters. Zu diesen Überlegungen zählen die Verwaltung von Anmeldeinformationen, die Begrenzung der Mindestberechtigungen für Integrationsbenutzer und verbundene Anwendungen, die Überprüfungsprotokollierung von vom Agenten aufgerufenen Aktionen und Eingabevalidierungsanforderungen für Parameter, die aus vom Benutzer bereitgestellten oder abgeleiteten Inhalten stammen.
Beispiel: Ein durchgängiges Szenario, das beschreibt, wie das Designmuster in einem realen Salesforce-Szenario verwendet wird. Im Beispiel werden die Ziele erläutert und erläutert, wie das Muster angewendet wird, um diese Ziele zu erreichen.
In der folgenden Tabelle sind die abgedeckten Implementierungsmuster aufgeführt.
Liste der Muster
| Muster | Was es bewirkt |
|---|---|
| Aufruf der sequenziellen Aktion | Ein Agent ruft eine Reihe von Aktionen auf, bei denen jeder Schritt vom überprüften Ergebnis des vorherigen abhängt. Der Agent behält den Kontext über die gesamte Kette hinweg bei, beispielsweise Kennzeichner, Statuscodes und Zwischendaten, und verwendet ihn, um zu entscheiden, ob der nächste Schritt fortgesetzt werden kann. |
| Aufruf einer parallelen Aktion | Wenn eine Reihe von Aktionen unabhängig voneinander sind, ruft der Agent sie gleichzeitig und nicht nacheinander auf. Die gesamte Workflow-Zeit ist an den langsamsten Anruf und nicht an die Summe aller Anrufe gebunden. |
| Aufruf asynchroner Aktionen | Ein Agent sendet einen Vorgang über ein Plattformereignis, eine Nachrichtenwarteschlange oder einen Hintergrundauftrag an ein nachgelagertes System, ohne auf das Ergebnis zu warten. Die Verpflichtung des Agenten endet mit dem bestätigten Aufruf. Das nachgelagerte System übernimmt die Ausführung unabhängig von der Agentensitzung. |
| Aufruf von Agenten nach Bedarf | Eine externe Anwendung oder ein AI-Orchestrierer ruft einen Agenten programmgesteuert auf, stellt Kontext bereit und wartet auf eine strukturierte Antwort. Der Agent fungiert als intelligenter Backend-Service, den der Anrufer initiiert, der Agent begründet und handelt und das Ergebnis wird vom Anrufer verbraucht. |
| Autonome ereignisgesteuerte Agentenausführung | Eine Datenbedingung wie Einkaufswagenabbruch, Zahlungsausfall oder Nutzungseinbruch löst einen Agenten autonom aus, ohne dass eine Person die Interaktion initiiert. Es wartet kein Anrufer auf eine Antwort. Der Agent empfängt die Ereignisnutzlast als Kontext für die Kontextbildung und führt einen Antwort-Workflow vollständig selbst aus. |
| Knowledge-Kontextbildung aus Unternehmensinhalten | Vor dem Generieren einer Antwort ruft der Agent relevante Dokumente aus einem Knowledge Store für Unternehmen ab und fügt sie in sein Kontextfenster ein. Der LLM liefert die Überlegungen, die Abrufebene die Fakten. |
| Verifizierte Kundenkontextinjektion | Geprüfte strukturierte Attribute aus einem zusammengeführten Kundenprofil werden als Aktionseingaben vorausgefüllt, bevor der Agent eine Aktion aufruft. Der Agent erhält Fakten wie Segment, Stufe, Abwanderungsrisiko und Lebenszeitwert, statt sie abzuleiten. |
| Systemübergreifende Tool-Integration | Ein Agent stellt über eine einheitliche Tool-Oberfläche, die auf dem MCP-Standard (Model Context Protocol) basiert, eine Verbindung zu externen Systemen außerhalb der Salesforce Platform her. Jedes externe System stellt seine Funktionen wie beschrieben als aufrufbare Tools bereit. Der Agent erkennt sie und ruft sie auf, ohne die native API oder das Schema des jeweiligen Systems kennen zu müssen. |
| Geschäftsfunktionen als aufrufbare Tools | Unternehmensfunktionen wie Geschäftseinheiten, Prozesse und Statistiken werden als MCP-Tools angezeigt, die jeder externe Agent in einem beliebigen Framework entdecken und aufrufen kann. |
| Agentenübergreifende Delegation | Ein aufrufender Agent zerlegt eine komplexe Anforderung und delegiert domänenspezifische Teilaufgaben mithilfe des A2A-Protokolls (Agent-zu-Agent) an spezialisierte Peer-Agenten auf verschiedenen Plattformen oder Anbietersystemen. Der aufrufende Agent verwaltet den Aufgabenlebenszyklus und aggregiert die Ergebnisse der Remote-Agenten. |
| Agenten als anrufbare Services | Ein interner Agentforce veröffentlicht seine Domänenfunktionen als kontrollierten, auffindbaren A2A-Endpunkt, sodass externe Orchestrierer oder Peer-Agenten Aufgaben an ihn delegieren können. Der Agent verwaltet den eingehenden Aufgabenlebenszyklus und gibt strukturierte Ergebnisse an den Remote-Anrufer zurück. |
Die Muster in diesem Dokument sind in drei Kategorien unterteilt. Diese Kategorisierung hilft Architekten, schnell zu erkennen, welche Muster für die Integrationsherausforderung relevant sind, die sie lösen, unabhängig davon, ob sie das entwerfen, was ein Agent nennt, was einen Agenten auslöst oder wie ein Agent auf Knowledge basiert, bevor er handelt. Statt jedes Muster zu lesen, können Sie direkt zu der Kategorie navigieren, die Ihrem Designanliegen entspricht.
Aktionsaufruf:
Diese Muster decken ab, wie ein Agent externe Systeme anruft, um Daten abzurufen oder Vorgänge im Rahmen seines Argumentationszyklus auszuführen. Hierbei handelt es sich um ausgehende Muster, bei denen der Agent der Initiator ist. Sie betreffen die Sequenzierung (wenn Schritte voneinander abhängen), Parallelität (wenn sie nicht vorhanden sind), Idempotenz und die Verarbeitung von Teilfehlern. Verwenden Sie diese Muster, wenn Sie die Tools entwerfen, die ein Agent aufruft, um seine Arbeit zu erledigen.
Agentenaufruf:
Diese Muster behandeln, wie externe Systeme oder Ereignisse einen Agenten in Aktion setzen. Hierbei handelt es sich um eingehende Muster, bei denen externe Systeme diese Agenten auslösen. Bei dem Auslöser kann es sich um eine Anwendung handeln, die einen programmgesteuerten Aufruf vornimmt und auf eine Antwort wartet, oder um eine autonome Datenbedingung, die den Agenten auslöst. Verwenden Sie diese Muster, wenn Sie entwerfen, wie und wann ein Agent ausgelöst wird.
Kontextbildung mit Unternehmensdaten:
Die Muster in dieser Kategorie behandeln, wie Agenten mit genauem, aktuellem, organisationsspezifischem Knowledge fundiert sind, bevor sie Gründe dafür haben oder handeln.
Die Wahl der richtigen Strategie ist nicht trivial. Jedes Muster zielt auf ein bestimmtes Anliegen ab: Systemfunktionen, Datenvolumen, Fehlerverarbeitung und Transaktionalität.
In den Auswahlmatrixtabellen werden die Muster und ihre wichtigsten Aspekte aufgeführt, damit Sie bestimmen können, welches Muster Ihren Integrationsanforderungen am besten entspricht. Die Muster werden anhand dieser Dimensionen kategorisiert.
| Aspekt | Beschreibung |
|---|---|
| Typ | Gibt die Kategorie der Integration an: Aktionsaufruf, Agentenaufruf oder Kontextbildung mit Unternehmensdatenaktionsaufruf**:** Diese ausgehenden Integrationen reichen von einfachen Tool-Aufrufen mit einem Schritt bis hin zu komplexen Sequenzen mit mehreren Schritten und parallelen Fan-Outs und erfordern eine sorgfältige Überlegung der Anordnungseinschränkungen, der Identität und der teilweisen Fehlerverarbeitung über heterogene Backends hinweg. Agentenaufruf: Agentenaufrufe sind die Möglichkeiten, mit denen externe Systeme oder Ereignisse einen Agenten in die Tat umsetzen. Diese eingehenden Integrationen reichen von synchronen programmgesteuerten Aufrufen, die von Anwendungen mit menschlichem Gesicht getätigt werden, die auf eine strukturierte Antwort warten, bis hin zu vollständig autonomen ereignisgesteuerten Ausführungen, bei denen eine Datenbedingung den Agenten auslöst, ohne dass ein Mensch die Interaktion initiiert oder darauf wartet. Kontextbildung mit Unternehmensdaten: Mithilfe von Kontextintegrationen wird einem Agenten genaues, aktuelles, organisationsspezifisches Knowledge bereitgestellt, bevor er Gründe dafür hat oder handelt. Diese Integrationen reichen vom Abrufen unstrukturierter Dokumente aus Inhaltsspeichern für Unternehmen bis hin zum Einschleusen überprüfter strukturierter Attribute aus zusammengeführten Kundenprofilen, um sicherzustellen, dass der Agent Fakten verarbeitet und nicht auf halluzinierte Rückschlüsse stößt. |
| Zeitpunkt | Gibt den Integrationsstil anhand des Zeitpunkts an: Synchron oder Asynchron Synchron im Vergleich zu Asynchron bezieht sich in diesem Dokument darauf, wie der Agent selbst ausgelöst wird oder wie er die Aktionen aufruft. Sie deckt nicht ab, was intern geschieht. Im Allgemeinen wartet ein Benutzer jedoch, während der Agent Aktionen aufruft und Ergebnisse verarbeitet. Der Agent adressiert die nächste Benutzernachricht erst, nachdem er den aktuellen Zug abgeschlossen hat. Synchron: Blockierungs- und Echtzeitanforderungen sind Anforderungs-/Antwortvorgänge. Das Ergebnis wird über diesen Vorgang sofort an den Anrufer zurückgegeben. Asynchron: Anforderungen ohne Blockierung, Warteschlange oder nachrichtenbasierte Anforderungen werden nahezu in Echtzeit durch einen unidirektionalen Vorgang aufgerufen. Die Ergebnisse und etwaige Fehler werden durch Aufrufen anderer Einbahnvorgänge zurückgegeben. Der Anrufer sendet daher die Anforderung und fährt fort, ohne auf eine Antwort zu warten. |
In dieser Tabelle sind die Muster und ihre wichtigsten Aspekte aufgeführt, damit Sie bestimmen können, welches Muster Ihren Anforderungen am besten entspricht, wenn Ihre Integration von Salesforce in ein anderes System erfolgt.
| Typ | Zeitpunkt | Zu berücksichtigendes Schlüsselmuster |
|---|---|---|
| Aktionsaufruf | Synchron | Aufruf der sequenziellen Aktion Aufruf einer parallelen Aktion Systemübergreifende Tool-Integration Agentenübergreifende Delegation |
| Aktionsaufruf | Asynchron | Aufruf asynchroner Aktionen |
| Agentenaufruf | Synchron | Aufruf von Agenten nach Bedarf Agenten als anrufbare Services |
| Agentenaufruf | Asynchron | Autonome ereignisgesteuerte Agentenausführung |
| Kontextbildung mit Unternehmensdaten | Synchron | Knowledge-Kontextbildung aus Unternehmensinhalten Verifizierte Kundenkontextinjektion |
In jedem Abschnitt der Muster wird beschrieben, wie sie erstellt werden. Jedes Muster ist eine wiederholbare Lösung für ein bestimmtes Integrationsproblem in Agentenarchitekturen. Sie behandelt, wann das Muster verwendet werden soll, welche Kräfte die Entscheidung beeinflussen und wie die Salesforce Platform es bereitstellt.
Kontext
Viele Geschäfts-Workflows sind von Natur aus sequenziell. Für jeden Schritt ist ein überprüftes Ergebnis aus dem vorherigen Schritt erforderlich, bevor er fortgesetzt werden kann. Beispielsweise kann eine Rückerstattung erst initiiert werden, nachdem die Berechtigung bestätigt wurde, ein Abrechnungsaccount kann erst erstellt werden, nachdem der Auftragsdatensatz vorhanden ist, und eine Compliance-Prüfung kann erst protokolliert werden, nachdem die Prüfung bestanden wurde.
Bei der traditionellen Automatisierung werden diese Abhängigkeiten als hartcodierte Flow-Logik codiert. In einem Agentensystem wertet der Agent das Ergebnis jeder Aktion aus und bestimmt, ob die Voraussetzungen für den nächsten Schritt erfüllt sind.
Dieses Muster beschreibt das grundlegende ausgehende Integrationsmodell. Hier arbeitet ein einzelner Agent innerhalb einer Domäne und ruft eine Sequenz auf, wobei die Ausgabe jeder Aktion den Aufruf der nächsten Aktion in der Kette ansteuert. Der Orchestrierungsagent behält den Transaktionskontext in der gesamten Kette bei und sammelt Kennzeichner, Statuscodes und Daten an, die von jedem Schritt zurückgegeben werden. Sie verwendet diesen Kontext, um nachfolgende Entscheidungen zu treffen.
Dieses Muster ist das agentische Gegenstück zu Remote Process Invocation – Request and Reply from the Integration Patterns Guide, das einen einzelnen synchronen Callout beschreibt. Das Agentenmuster erweitert das Muster auf eine agentengesteuerte Kette abhängiger Aufrufe innerhalb eines einzelnen Argumentationszyklus.
Probleme
Wenn ein Agent einen aus mehreren Schritten bestehenden Workflow ausführt, der sich über das Hostsystem und ein oder mehrere Remote-Systeme erstreckt, müssen vier Herausforderungen angegangen werden:
- Sequenzierung: Aktionen müssen in der richtigen Reihenfolge aufgerufen werden, wobei jeder Schritt nach dem erfolgreichen Abschluss des vorherigen Schritts ausgeführt wird.
- Datenübernahme: Die Antwortdaten aus jedem Schritt müssen als Eingabe an den nächsten übergeben werden.
- Fehlerisolierung: Fehler an einem beliebigen Punkt der Kette dürfen nicht zu einem teilweisen oder inkonsistenten systemübergreifenden Zustand führen.
- Abschlussüberprüfung: Der Agent muss bestätigen, dass alle Schritte erfolgreich abgeschlossen wurden, bevor er ein Ergebnis meldet.
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
-
Hängt jede Aktion in der Kette von den durch die vorherige Aktion zurückgegebenen Daten ab oder sind die Abhängigkeiten nur vom Erfolgs- oder Fehlerstatus?
Datenabhängigkeiten erfordern, dass der Agent Kennzeichner und Attribute schrittweise überträgt.
-
Sind alle Remote-Endpunkte in der Lage, innerhalb der Zeitüberschreitung des Argumentationszyklus des Agenten zu reagieren?
Ein langsames externes System blockiert bei jedem Schritt in der Kette die gesamte Sequenz.
-
Erfordert die Kette einen vollständigen durchgängigen Erfolg oder ist ein Teilabschluss akzeptabel?
-
Wenn ein vollständiger Erfolg erforderlich ist, definieren Sie eine Vergütungsstrategie für Schritte, die bei einem nachgelagerten Fehler zurückgesetzt werden müssen.
-
Können Schreibvorgänge in der Kette sicher wiederholt werden?
Alle Schreibaktionen müssen idempotent sein. Die Argumentationsschleife des Agenten ruft dieselbe Aktion aufgrund von Wiederholungen des Large Language Model (LLM) oder mehrdeutigen Bestätigungen möglicherweise mehrmals auf.
-
Wird die Kette durch eine Benutzerinteraktion (Unterhaltung, niedrige Gleichzeitigkeit) oder durch einen automatisierten Auslöser (potenziell hohe Gleichzeitigkeit) aufgerufen?
Dadurch wird bestimmt, ob eine synchrone Blockierung zulässig ist oder ob ein asynchrones Muster erforderlich ist.
Anwendung für Salesforce-Muster
| Lösung | Passend | Kommentare |
|---|---|---|
| Apex Aktionen | Bestens geeignet für externe Callouts und komplexe Logik | Für einen Schritt ist ein HTTP-Callout an ein Remote-System, eine benutzerdefinierte Datentransformation oder eine Fehlerbehandlungslogik erforderlich, die die deklarativen Funktionen von Flow überschreitet. Apex-Aktionen stellen die vollständige Integrationsplattform zur Verfügung, können jedoch weiterhin vom Agenten über die Anmerkung @InvocableMethod aufgerufen werden. |
| Flow-Aktionen (automatisch gestartet) | Bestens geeignet für Geschäftsregelschritte und leichte CRM-Vorgänge | Ein Schritt wendet deklarative Geschäftslogik an, fragt CRM-Datensätze ab oder aktualisiert sie oder orchestriert einen Prozess, für den kein benutzerdefinierter Code erforderlich ist. Automatisch gestartete Flows können nativ von Agentforce-Unteragenten aufgerufen werden und geben typisierte Ausgabevariablen zurück, die der Agent zum Bestimmen des nächsten Schritts verwendet. |
| Externe Services (OpenAPI-Import) | Bestens geeignet für die typisierte, erkennbare externe API-Integration | Ein externes System stellt eine OpenAPI-Spezifikation bereit. Externe Services generieren Apex Stubs mit starkem Typ, die direkt als Agentenaktionen aufgerufen werden können, wodurch die manuelle Schemazuordnung entfällt und die Vorgänge der externen API für den Agenten als benannte Funktionen sichtbar werden. Jeder Vorgang in der importierten Spezifikation wird zu einer benannten aufrufbaren Aktion. Der Agent wählt Aktionen anhand seiner generierten semantischen Bezeichnungen aus. Registrieren Sie generierte Aktionen im Agentforce Topic Center, damit der Agent sie zum Zeitpunkt der Überlegungen erkennen kann. Notiz: Wenn der extern gehostete Service RESTful ist, die OpenAPI-Spezifikation jedoch nicht verfügbar oder tragfähig ist, verwenden Sie Anmeldeinformationen mit Namen in Apex oder Flows, um den HTTP-Callout direkt vorzunehmen. Zum Analysieren der Ergebnisse ist Apex Code erforderlich. |
| Verbundene MuleSoft-Aktionen | Bestens geeignet für komplexe Middleware-Fanouts oder ältere Systemintegrationen | Wird verwendet, wenn das Remote-System eine Protokollübersetzung, Datentransformation oder Orchestrierung über mehrere Backend-Systeme hinweg erfordert, bevor eine Antwort zurückgegeben wird. Der Agent sendet einen einzelnen Callout an MuleSoft und MuleSoft übernimmt die nachgelagerte Komplexität und gibt eine einheitliche Antwort zurück. |
Skizze
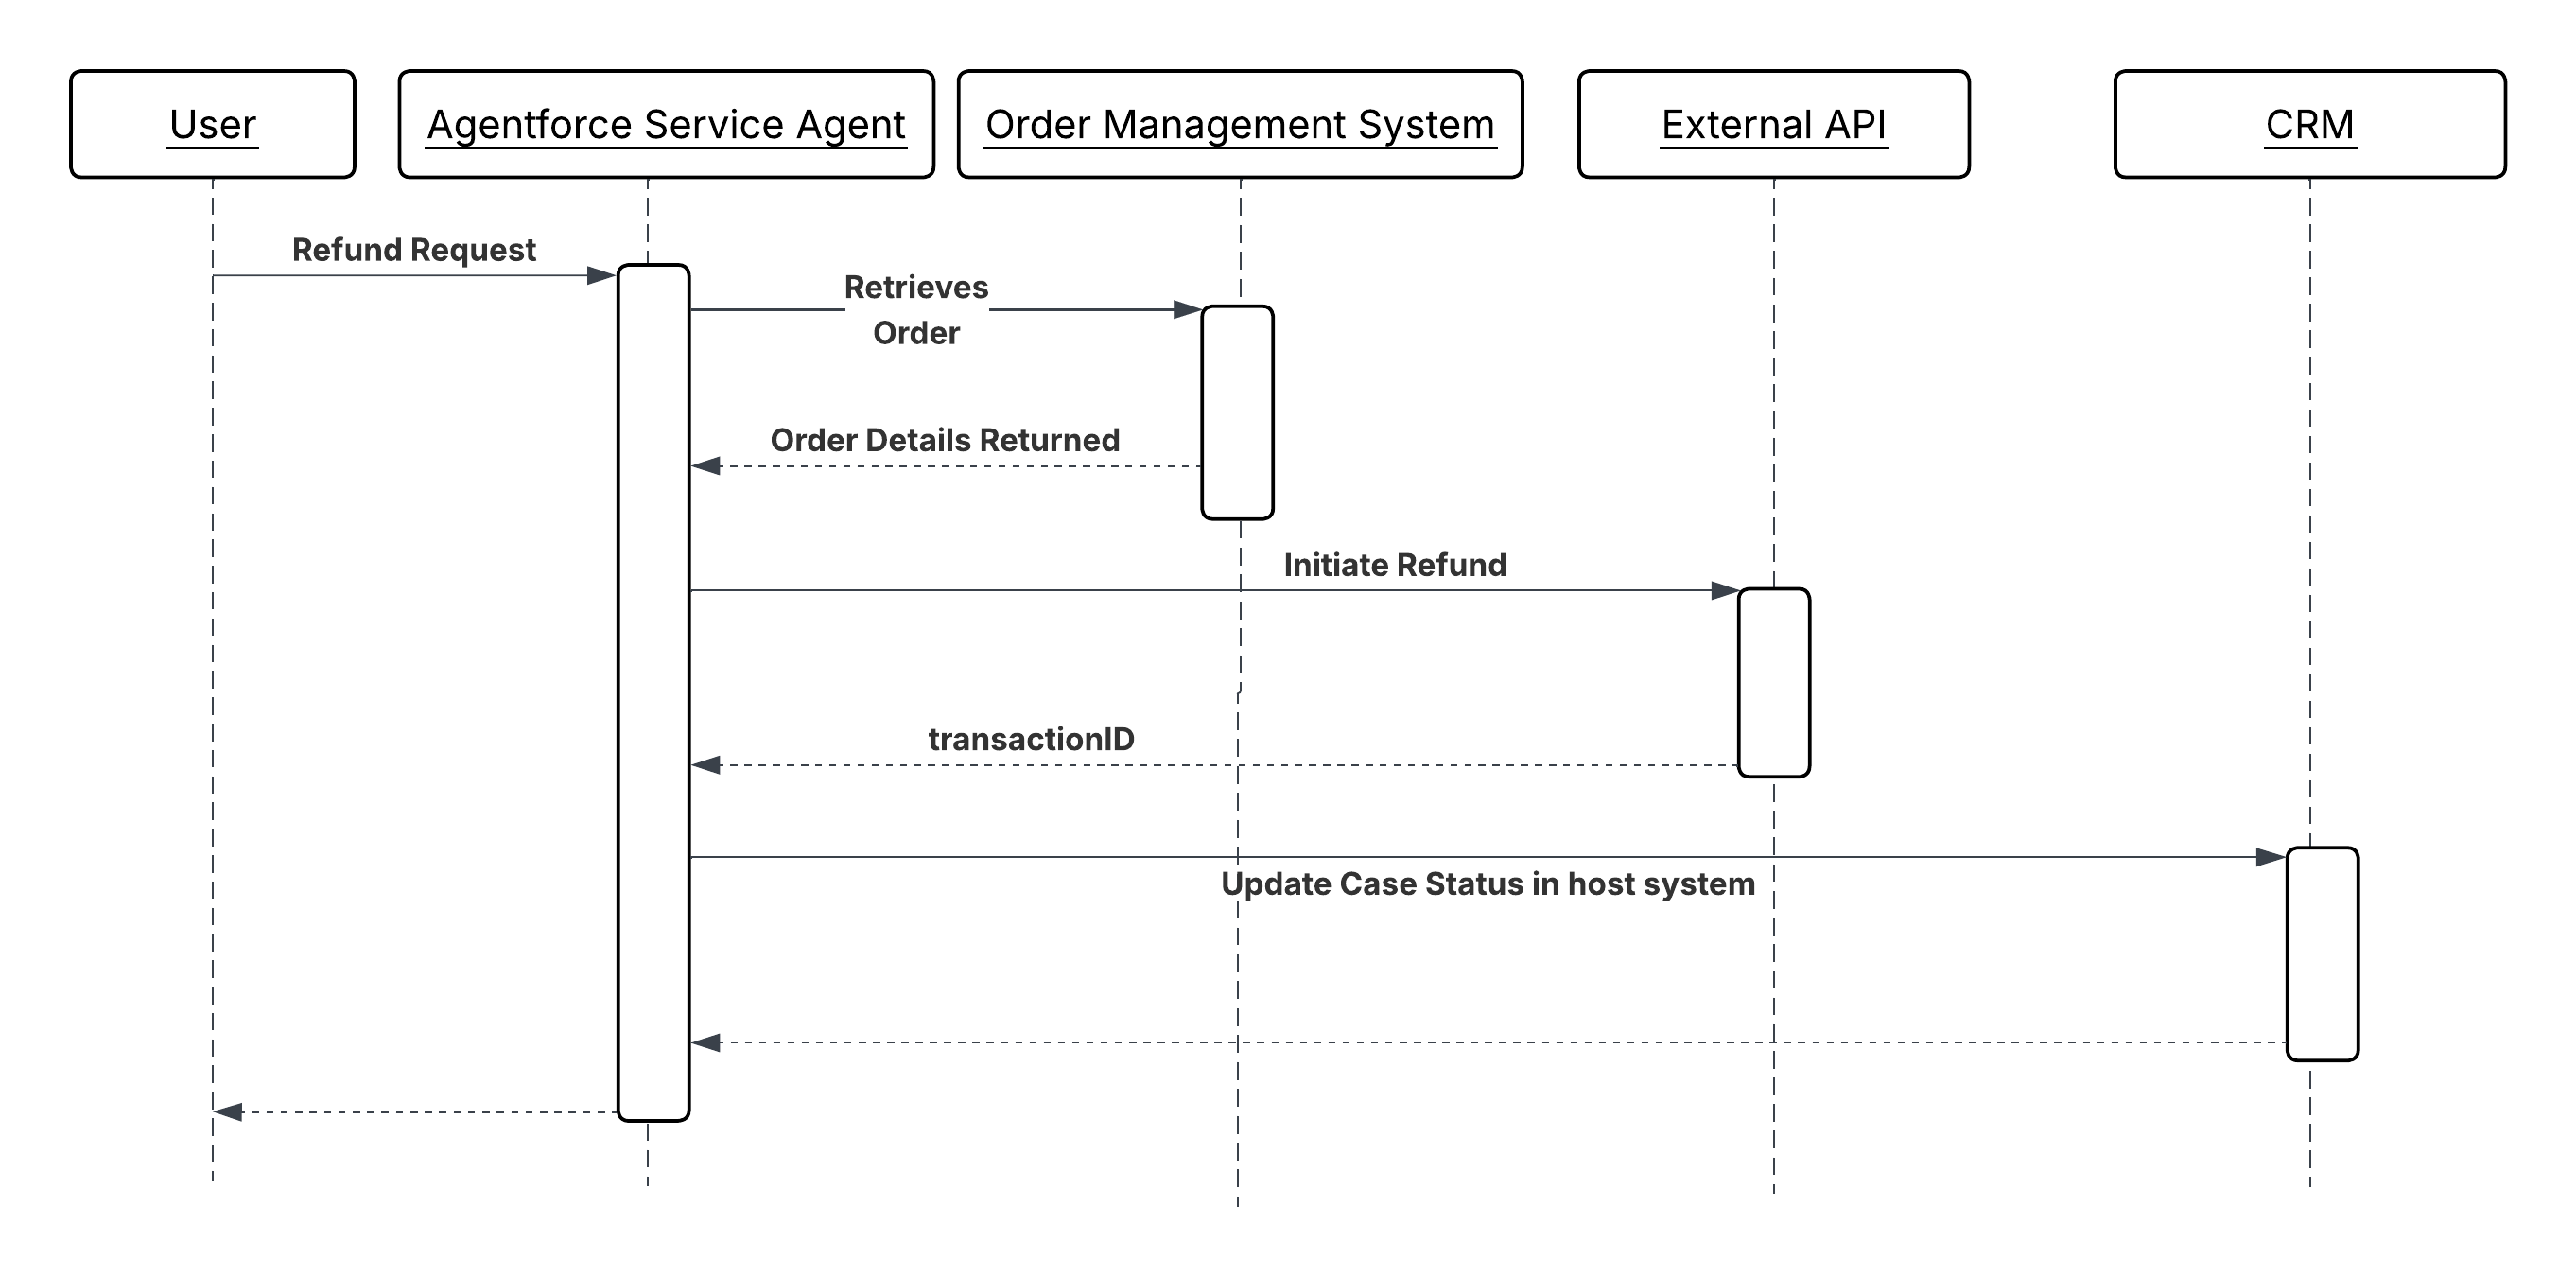
Sequenzdiagramm für den Aufruf sequenzieller Aktionen
Ergebnisse
Der Agent führt einen systemübergreifenden Workflow als kohärente, überwachte Sequenz und nicht als Feuer-und-Vergessen-Skript aus. Das Ergebnis jedes Schritts wird ausgewertet, bevor der nächste Schritt aufgerufen wird. Auf diese Weise erkennt der Agent Fehler zum frühestmöglichen Zeitpunkt, statt einen Teilabschluss nach der Tat zu erkennen.
Das Hostsystem (Salesforce CRM) wird erst aktualisiert, nachdem der Remote-Vorgang den Status bestätigt hat (Erfolg oder Fehler). Von externen Systemen zurückgegebene Kennzeichner und Status, beispielsweise Abrechnungsaccountnummern, Transaktions-IDs und Bestätigungscodes, werden durch die Kette übernommen und beibehalten, wodurch ein vollständiger, rückverfolgbarer Datensatz des Workflow-Ergebnisses erstellt wird.
Der Agent ist für die Argumentation der Ergebnisse und die Sequenzierung der Entscheidungen verantwortlich. Jede Aktion ist nur für ihren eigenen Vorgang und für das Zurückgeben eines strukturierten Ergebnisses verantwortlich. Keine der Ebenen codiert die Logik der anderen.
Überlegungen zum Design
Plattformunabhängige Anleitung
- Stellen Sie sicher, dass jede Aktion in der Kette eine semantische Beschreibung enthält, die in Intent-basierter Sprache und nicht als Signatur der technischen Methode geschrieben wurde. Der Agent wählt Aktionen anhand dieser Beschreibungen aus. Eine Beschreibung mit der Aufschrift “Rechnungsstellungs-API aufrufen” ist weniger nützlich als eine mit der Aufschrift “Rechnungsstellungsaccount im Abrechnungssystem und Rückgabe des neuen Accountkennzeichners”.
- Legen Sie alle Schreibvorgänge in der Kette als idempotent fest. Die Argumentationsschleife des Agenten kann eine Aktion wiederholen, wenn sie eine mehrdeutige Antwort erhält. Die Aktion muss bei wiederholtem Aufruf dasselbe Ergebnis liefern.
- Validieren Sie alle abgeleiteten LLM-Eingabeparameter defensiv an der Aktionsgrenze. Gehen Sie niemals davon aus, dass die vom Agenten übergebenen Parameter gut ausgebildet sind, innerhalb des Bereichs liegen oder den erwarteten Typ aufweisen.
- Entwerfen Sie jede Aktion für eine einzelne Verantwortung. Eine Aktion, die einen Abrechnungsaccount erstellt und im selben Anruf eine Bestätigungs-E-Mail sendet, ist schwieriger zu wiederholen, schwieriger zu testen und für den Agenten schwieriger zu erklären, dass es sich um zwei separate Aktionen handelt.
Salesforce-Implementierungshinweise
- Anmerkung für Apex Aktionen: @InvocableMethod(label=’…“ description=’…’). Die “Beschreibung” wird vom Agenten gelesen, um zu bestimmen, wann die Aktion aufgerufen werden soll. Deklarieren Sie alle Eingabe- und Ausgabevariablen mit @InvocableVariable unter Verwendung der aussagekräftigen Felder “label” und “description”. Geben Sie strukturierte Ergebnisobjekte mit expliziten Erfolgs-/Fehlerindikatoren und menschenlesbaren Fehlermeldungen zurück.
- Für Flow-Aktionen verwenden Sie ausschließlich automatisch gestartete Flows. Bildschirm-Flows werden in Kontexten autonomer Agenten nicht unterstützt. Halten Sie jeden Flow atomar; eine Aktion, eine Verantwortung. Konfigurieren Sie Fehlerpfade für jedes externe Callout-Element, um Integrationsfehler zu erkennen und handlungsrelevante Fehlermeldungen an den Agenten zurückzugeben, statt die Sitzung durch nicht erkannte Ausnahmen beenden zu lassen.
- Importieren Sie für “Externe Services” die OpenAPI-Spezifikation des Zielsystems und registrieren Sie die generierten Aktionen im Thema “Agentforce”. Wickeln Sie die generierten Stubs in Anmeldeinformationen mit Namen ein, um Endpunkte oder Anmeldeinformationen mit harter Codierung in der Aktionsdefinition zu vermeiden.
- Legen Sie für alle externen Callouts explizite Callout-Timeouts fest. Ein Callout, der ohne Zeitüberschreitung angehängt wird, blockiert den Überlegungenzyklus des Agenten, bis die Sitzungsobergrenze erreicht ist. Geben Sie bei Überschreitung der Zeitüberschreitung einen schwerwiegenden Fehler mit einer aussagekräftigen Fehlermeldung zurück. Alle externen Callouts weisen eine konfigurierbare Zeitüberschreitung von bis zu 120 Sekunden auf. Außerdem unterliegen sie den Obergrenzen für synchrone Apex-Transaktionen. Daher sollten Sie das Risiko minimieren, dass mehr als 50 Transaktionen instanziiert werden, die jeweils länger als fünf Sekunden ausgeführt werden.
Fehlerbehandlung und -behebung
- Der Agent bewertet jeden Schritt anhand des expliziten Erfolgs des Vorgängers des Schritts. Aktionen müssen ein strukturiertes Ergebnis zurückgeben, das einen eindeutigen Erfolgs- oder Fehlerindikator enthält. Der Agent kann allein aus einer fehlenden oder Nullantwort nicht zuverlässig auf einen Fehler schließen.
- Wenn eine Aktion fehlschlägt, verwendet der Agent die von der Aktion zurückgegebene Fehlermeldung, um den nächsten Schritt zu bestimmen: Fordern Sie den Benutzer zur korrigierten Eingabe auf, versuchen Sie eine Selbstheilung mit angepassten Parametern oder halten Sie die Kette an und protokollieren Sie den Fehler zur menschlichen Überprüfung. Daher müssen Fehlermeldungen spezifisch und handlungsrelevant sein: “Ungültiger Datumsbereich: endDate kann startDate nicht vorangehen” verwendet werden, 400 Statuscode allein nicht.
- Bei Ketten, bei denen die Teilvervollständigung zu einem inkonsistenten Zustand führt (beispielsweise wurde der Abrechnungsaccount erstellt, der CRM-Datensatz jedoch nicht aktualisiert), ruft der Agent eine Entschädigungsaktion auf, um den Teilstatus zurückzusetzen oder zu kennzeichnen, bevor der Fehler angezeigt wird. Entwerfen Sie Kompensationspfade als benannte Aktionen neben dem Vorwärtspfad.
- Wenn eine Schreibaktion potenziell erfolgreich war, jedoch eine mehrdeutige Antwort zurückgegeben hat (Netzwerk-Timeout, keine Bestätigung), muss für den Wiederholungsversuch derselbe Identitätsschlüssel oder dieselbe externe Referenz-ID wie für den ursprünglichen Aufruf verwendet werden. Stellen Sie niemals einen nicht aktivierten Wiederholungsversuch für einen nicht idempotenten Schreibvorgang aus.
Sicherheitsüberlegungen
- Wickeln Sie alle externen Callouts in Anmeldeinformationen mit Namen ein. Hartcodieren Sie niemals Endpunkte oder Anmeldeinformationen in Apex Code- oder Flow-Konfigurationen. Diese müssen über den sicheren Anmeldeinformationenspeicher der Plattform verwaltet und ohne Codeänderungen rotiert werden.
- Wenden Sie das Prinzip der geringsten Berechtigung auf den Integrationsbenutzer oder die verbundene Anwendung an, die von den einzelnen Aktionen verwendet werden. Eine Aktion, die nur Auftragsdaten liest, sollte nicht über Schreibberechtigungen für das Abrechnungssystem verfügen. Scope-Anmeldeinformationen für die minimalen Vorgänge, die für die Aktion erforderlich sind.
- Protokollieren Sie den Aufruf jeder Aktion in der Kette mit der zugehörigen Sitzungs-ID, den Eingabeparametern (die von sensiblen Werten bereinigt wurden) und dem Ergebnis. Wenn das Ergebnis bestritten wird, ist dieser Überprüfungsprotokoll der primäre Mechanismus, um zu rekonstruieren, warum der Agent eine bestimmte Sequenz von Aktionen ausgeführt hat.
- Bereinigen Sie alle Eingabeparameter, die aus vom Benutzer bereitgestelltem Text stammen, bevor Sie sie an externe Systeme übergeben. Die über den Agenten an einen externen API-Callout weitergegebene Benutzereingabe ist ein potenzieller Injektionsvektor. Validieren Sie Typ, Format und Bereich an der Aktionsgrenze, bevor der Callout erfolgt.
Beispiel
Ein Kundendienstagent, der eine Rückerstattungsanforderung bearbeitet, führt eine sequenzielle Kette aus vier Schritten aus:
GetOrderDetails(Apex-Aktion) ruft den Auftragsdatensatz mithilfe der vom Benutzer angegebenen Auftrags-ID aus dem Auftragsverwaltungssystem ab. Er gibt den Auftragsstatus, Belegposten, Kaufdatum und Zahlungsweise zurück. Der Agent wertet aus, ob sich der Auftrag in einem erstattungsfähigen Zustand befindet, bevor er fortfährt.ValidateRefundEligibility(Automatisch gestarteter Flow) wendet die Geschäftsregeln für den Rückerstattungsanspruch an, einschließlich Rückgabefenster, Produktkategorieeinschränkungen und vorheriger Rückerstattungsverläufe. Es wird ein boolescher Wert für “berechtigt” zurückgegeben und, falls nicht zulässig, ein eindeutiger Grund, aus dem der Agent dem Benutzer angezeigt werden kann.InitiateRefund(Apex Action) ruft die externe Zahlungs-Gateway-API mit der Auftrags-ID und dem Rückerstattungsbetrag auf. Gibt bei Erfolg eine “refundTransactionId” zurück. Diese Aktion ist idempotent. Wird er ein zweites Mal mit derselben Auftrags-ID aufgerufen, wird die vorhandene Transaktions-ID zurückgegeben, statt eine doppelte Rückerstattung zu erstellen.UpdateCaseStatus(Automatisch gestarteter Flow) aktualisiert den CRM-Kundenvorgangsdatensatz mit der Rückerstattungstransaktions-ID, legt den Kundenvorgangsstatus auf “Gelöste Rückerstattung ausgestellt” fest und erstellt eine Folgeaufgabe für den Accountinhaber. Dieser Schritt wird erst ausgeführt, nachdem “InitiateRefund” eine bestätigte Transaktions-ID zurückgegeben hat.
Wenn bei der InitiateRefund eine Zeitüberschreitung auftritt oder ein Fehler zurückgegeben wird, hält der Agent die Kette an, ruft keine UpdateCaseStatus auf und zeigt dem Benutzer eine handlungsrelevante Meldung an. Der Kundenvorgang bleibt offen und ungelöst, wobei der genaue Status im CRM beibehalten wird.
Kontext
Sequenzielle Aktionsketten sind effizient, wenn Ausführungsschritte voneinander abhängig sind. Ein Schritt führt zum nächsten. Viele Workflows enthalten jedoch eine Reihe von Schritten, die keine gegenseitigen Abhängigkeiten aufweisen. Beispielsweise können Schritte, die das Abrufen von Produktinventar, das Abrufen von Kundenansprüchen und das Überprüfen einer Versandschätzung umfassen, alle gleichzeitig ausgeführt werden, da für die Eingabe eines Schritts keine Ausgabe eines anderen erforderlich ist. Durch die sequenzielle Ausführung dieser Schritte wird Zeit verschwendet, die proportional zur Anzahl der Schritte ist.
In einem parallelen Aufrufmuster identifiziert der Agent, dass eine Reihe von Aktionen unabhängig sind, und ruft sie gleichzeitig und nicht nacheinander auf. Die gesamte Workflow-Zeit ist an die langsamste Einzelaktion und nicht an die Summe aller Aktionszeiten gebunden. Sobald alle Ergebnisse zurückgegeben wurden, aggregiert der Agent sie zu einer einzigen kohärenten Antwort oder verwendet sie zusammen als Eingaben für die nächste Phase der Argumentation.
Die wichtigste architektonische Herausforderung ist nicht der parallele Aufruf selbst. Sie verwaltet die Fan-Out-Erfahrung innerhalb von Plattformgleichzeitigkeitseinschränkungen und stellt sicher, dass der Aggregationsschritt Teilfehler ordnungsgemäß verarbeitet, ohne die erfolgreichen Ergebnisse zu verwerfen.
Probleme
Wie orchestriert ein Agent effizient die gleichzeitige Ausführung mehrerer unabhängiger Funktionen und aggregiert die einzelnen Ergebnisse zu einer einzigen, zusammenhängenden Antwort für den Benutzer oder nachfolgende Schritte?
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Welche Überlegungen gelten für Aktionen zur Thread-Sicherheit und zur Freigabe des stummgeschalteten Zustands?
- Wie kann die Lösung Salesforce-Obergrenzen für parallele Apex Callouts innerhalb einer einzelnen Transaktion verwalten und vermeiden?
- Müssen asynchrone Muster (wie warteschlangenfähiges Apex oder Plattformereignisse) verwendet werden, um Obergrenzen zu vermeiden?
- Ist eine synchrone Aggregation der Ergebnisse erforderlich, bevor der Agent fortfahren kann?
Anwendung für Salesforce-Muster
| Lösung | Passend | Kommentare |
|---|---|---|
| Middleware-Ansatz | Bestens geeignet für hohe Lüfterauslastungen (> 5 Endpunkte) und plattformübergreifende Aggregation | Sie benötigen eine Middleware-Ebene. Der Agent sendet einen Callout an die Middleware. Anschließend aggregiert die Middleware die Daten und sendet eine einzelne Antwort an den Agenten zurück. Dies ist bevorzugt, wenn der Agent viele heterogene externe Systeme aufrufen muss. Die Middleware absorbiert die Komplexität von Fanouts und gibt eine einzelne aggregierte Antwort zurück. |
| Warteschlangenfähiger Apex | Optimal für interne Salesforce-Parallelität | Sie müssen mehrere warteschlangenfähige Aufträge auslösen. Während Salesforce die Warteschlange verwaltet, können diese gleichzeitig ausgeführt werden, wenn Sie über genügend “Zeitfenster” in Ihrer Gleichzeitigkeitsobergrenze verfügen. Wird verwendet, wenn sich parallele Vorgänge in der Salesforce-Organisation befinden und Gleichzeitigkeitszeitfenster verfügbar sind. Dies ist nicht geeignet, wenn eine sofortige aggregierte Antwort erforderlich ist. |
| Plattformereignisse | Optimal für die Konsistenz von Feuervergessenheit oder -ereignissen | Die Ergebnisse müssen nicht synchron aggregiert werden. Jedes Ereignis löst eine isolierte Transaktion aus, wodurch der Durchsatz maximiert wird, jedoch eine nachgelagerte Schlichtung erforderlich ist. Verwenden Sie diesen Mechanismus, wenn die endgültige Konsistenz akzeptabel ist und der Durchsatz wichtiger ist als die Antwortlatenz. |
Skizze
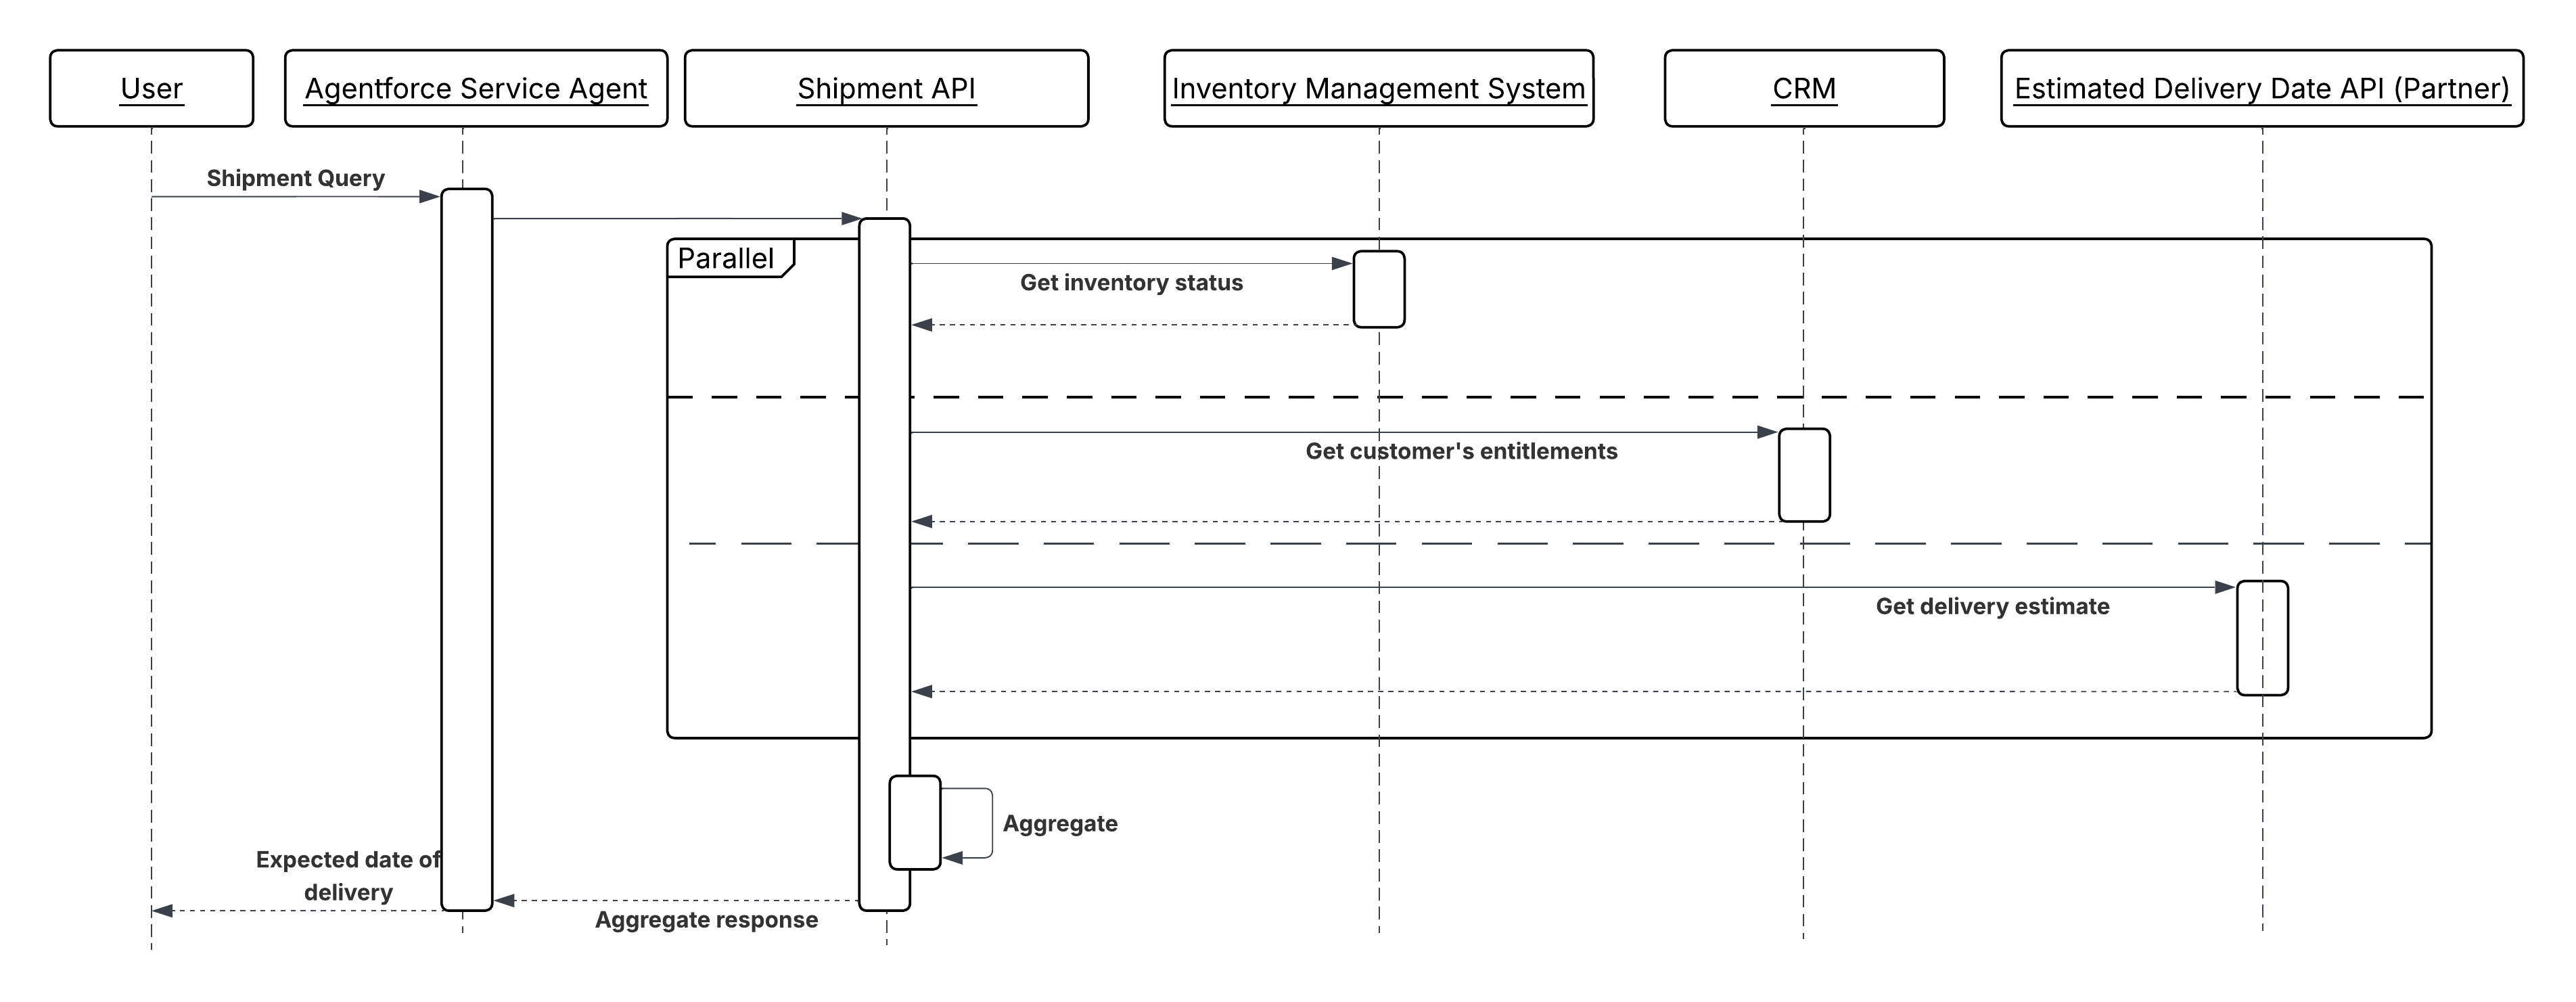
Sequenzdiagramm für parallelen Aktionsaufruf
Ergebnisse
Wenn unabhängige Aktionen parallel ausgeführt werden, ist die durchgängige Workflow-Zeit an die langsamste Einzelaktion und nicht an die Summe aller Aktionen gebunden. Bei einem Workflow mit drei unabhängigen Callouts mit einer durchschnittlichen Dauer von je 300 ms wird die parallele Ausführung in etwa 300 ms abgeschlossen. Die sequenzielle Ausführung dauert etwa 900 ms. Im richtigen Maßstab wird dieser Unterschied für jede gleichzeitig ausgeführte Agentensitzung addiert.
Überlegungen zum Design
Plattformunabhängige Anleitung
- Bestätigen Sie die Unabhängigkeit vor dem Parallelisieren. Aktionen können nur dann sicher parallel ausgeführt werden, wenn keine der Aktionen den von der anderen Aktion geschriebenen Status liest und keiner der beiden Fehler die andere Aktion abbrechen sollte. Wenn eine Abhängigkeit vorhanden ist, auch eine weiche, verwenden Sie stattdessen die sequenzielle Verkettung.
- Entwerfen Sie den Aggregationsschritt explizit. Definieren Sie im Voraus, wie eine vollständige Ergebnismenge aussieht, was eine Teilergebnismenge für die nachgelagerte Argumentation bedeutet und ob der Agent auf alle Ergebnisse warten oder fortfahren soll, sobald ein Schwellenwert (beispielsweise fünf von sieben Gesamtaufrufen) zurückgegeben wurde.
- Alle parallelen Schreibvorgänge müssen idempotent sein. Jeder Vorgang wird isoliert ohne gemeinsame Transaktionsgrenze ausgeführt, sodass beim erneuten Versuch einer einzelnen Verzweigung keine doppelten Nebenwirkungen auftreten können.
Salesforce-Implementierungshinweise
- Für warteschlangenfähigen Apex: Senden Sie alle Aufträge innerhalb einer einzelnen Transaktion, um die Wahrscheinlichkeit einer gleichzeitigen Ausführung zu maximieren. Beachten Sie, dass verfügbare Gleichzeitigkeitszeitfenster in der gesamten Organisation freigegeben sind. Entwerfen Sie Zeitfenster mit der Annahme, dass sie möglicherweise nicht immer verfügbar sind, und erstellen Sie einen Rückfall in die sequenzielle Ausführung, wenn dies nicht der Fall ist.
- Für Plattformereignisse: Schreiben Sie das Ergebnis jedes Vorgangs in einen dedizierten Staging-Datensatz (verschlüsselt durch eine freigegebene Korrelations-ID), statt den Zieldatensatz direkt zu aktualisieren. Ein endgültiger Aggregations-Flow oder Apex-Auslöser liest alle Staging-Datensätze, sobald die erwartete Anzahl erreicht ist, und wendet dann die konsolidierte Aktualisierung atomar an.
- Für Middleware-Fanout: Legen Sie eine explizite Zeitüberschreitung für den einzelnen Callout fest, die länger ist als die erwartete Worst-Case-Antwortzeit des langsamsten Backends, sich jedoch noch innerhalb der Salesforce-Callout-Zeitüberschreitungsobergrenze befindet. Die Middleware gibt Teilergebnisse mit einer eindeutigen Angabe der fehlgeschlagenen Backends zurück, statt die gesamte Antwort zeitlich zu verzögern.
Fehlerbehandlung und -behebung
- Behandeln Sie Teilerfolg als erstklassiges Ergebnis. Wenn drei oder vier parallele Vorgänge erfolgreich sind, verwendet der Agent die drei erfolgreichen Ergebnisse und verarbeitet den Fehler explizit, indem er ihn dem Benutzer anzeigt, ihn für den erneuten Versuch protokolliert oder eine Ausgleichsaktion aufruft, statt alle Ergebnisse zu verwerfen oder so vorzugehen, als wäre der Fehler nicht aufgetreten.
- Verwenden Sie für Muster vom Typ “Warteschlangenfähig” und “Plattformereignis” eine Korrelations-ID (wird zum Zeitpunkt der Fan-Out-Erfassung generiert), um alle parallelen Verzweigungen wieder mit der ursprünglichen Agentensitzung zu verknüpfen. Diese ID ist erforderlich, um Ergebnisse erneut zusammenzustellen und Fehler in Protokollen bis zur Quelle zurückzuverfolgen.
- Wenn eine parallele Verzweigung fehlschlägt und der Vorgang sicher wiederholt werden kann, stellen Sie nur die fehlgeschlagene Verzweigung erneut in die Warteschlange, indem Sie die ursprüngliche Korrelations-ID und den Identitätsschlüssel verwenden. Rufen Sie nicht alle Zweige erneut auf.
- Definieren Sie einen Zeitüberschreitungsschwellenwert für den Aggregationsschritt. Wenn nicht alle Ergebnisse innerhalb des Schwellenwerts eintreffen, fahren Sie mit den verfügbaren Ergebnissen fort und kennzeichnen Sie den unvollständigen Satz, statt unbegrenzt zu warten.
Sicherheitsüberlegungen
- Jeder Kontext der parallelen Ausführung, unabhängig davon, ob es sich um einen warteschlangenfähigen Auftrag, einen Plattformereignisauslöser oder einen Middleware-Callout handelt, muss dieselben Zugriffssteuerungen anwenden wie ein sequenzieller Callout. Parallelität lockert die Datenzugriffsregeln nicht. Jede Verzweigung muss dieselben Anmeldeinformationen mit den geringsten Berechtigungen aufweisen, die sie bei einem Aufruf allein hätte.
- Bei Middleware-Fanouts speichert oder protokolliert die Middleware-Ebene keine Antwortnutzlasten aus einzelnen Backends über das Aggregationsfenster hinaus. Die Antwort jedes Backends kann sensible Daten enthalten, die nicht außerhalb des Umfangs des sofortigen Vorgangs verbleiben sollten.
- Stellen Sie sicher, dass die für die Plattformereignisaggregation verwendeten Staging-Datensätze für den Endbenutzer des Agenten nicht lesbar sind. Diese Datensätze können Zwischendaten enthalten, die teilweise noch nicht verwendet werden können.
Beispiel
Ein Serviceagent beantwortet eine komplexe Abwicklungsfrage: “Können Sie mir diese Bestellung bis Freitag senden?” Für die Antwort sind Daten aus allen unabhängigen Systemen gleichzeitig erforderlich, wie im Folgenden erläutert:
- Der Agent identifiziert drei unabhängige Datenanforderungen: die aktuelle Inventarstufe, die aktiven Ansprüche des Kunden und das geschätzte Zustellungsfenster des Anbieters für den Standort des Kunden.
- Drei Aktionen werden parallel aufgerufen:
GetInventoryStatus(aus dem externen Inventarsystem über Middleware),GetCustomerEntitlements(aus Salesforce CRM) undGetDeliveryEstimate(aus der Carrier-API über Middleware). - Jede Aktion wird unabhängig zurückgegeben. Der Agent wartet, bis alle drei Antworten eingegangen sind (oder die Aggregationszeitüberschreitung erreicht ist).
- Wenn alle drei Ergebnisse verfügbar sind, begründet der Agent die kombinierten Daten und bewertet, ob das Inventar ausreicht, deckt der Anspruch des Kunden den Expressversand ab und der Anbieter bestätigt, dass die Zustellung am Freitag für die Postleitzahl des Kunden möglich ist.
- Der Agent gibt dem Benutzer eine einzelne fundierte Antwort zurück, die aus drei Systemen stammt, und zwar in der Zeit, in der die Antwort den langsamsten der drei Anrufe erforderte.
Kontext
Einige vom Agenten initiierte Vorgänge führen nicht zu einem Ergebnis, das der Agent benötigt, um seinen aktuellen Argumentationszyklus fortzusetzen. Das Senden einer Benachrichtigung, das Auslösen eines nachgelagerten Batch-Prozesses, das Veröffentlichen eines Ereignisses in einer Nachrichtenwarteschlange oder das Senden eines langfristigen Auftrags sind alle Vorgänge, bei denen die Verpflichtung des Agenten beim Versand endet. Das nachgelagerte System übernimmt die Inhaberschaft und führt die Arbeit unabhängig aus.
In der traditionellen Automatisierung werden diese als Callouts mit Feuer und Vergessen oder Plattformereignisveröffentlichungen modelliert. In einem Agentensystem entscheidet der Agent bei der Überlegung, dass der Vorgang nicht blockiert wird, disponiert ihn, zeichnet die Versandbestätigung auf und setzt den Vorgang fort oder schließt ihn ab, ohne auf das nachgelagerte Ergebnis zu warten.
Dieses Muster ist das agentische Gegenstück zu Remote Process Invocation – Fire and Forget (Prozessaufruf aus der Ferne – Feuer und Vergessen) im Leitfaden zu Integrationsmustern. Das Agentenmuster erweitert es, indem die Dispositionsentscheidung Teil der Überlegungen des Agenten wird und sichergestellt wird, dass die Disposition auch dann verfolgt werden kann, wenn keine Antwort an den Agenten zurückgegeben wird.
Probleme
Wenn ein Agent einen nachgelagerten Vorgang initiieren muss, der über den Sitzungs- oder Argumentationszyklus des Agenten hinausgeht, müssen drei Herausforderungen angegangen werden:
- Nicht blockierender Aufruf: Der Agent muss den Vorgang starten und die Zustellung bestätigen, ohne den Überlegungenzyklus geöffnet zu lassen und auf ein Ergebnis zu warten.
- Zustellungsbestätigung: Der Agent muss zwischen einer erfolgreichen Disposition (die Nachricht wurde akzeptiert) und einem erfolgreichen Ergebnis (der nachgelagerte Prozess wurde abgeschlossen) unterscheiden. Sie kann nur Ersteres behaupten.
- Verfolgbarkeit: Da der Agent kein Ergebnis erhält, muss der Vorgang über Protokolle, Ereignisdatensätze oder die Plattformüberwachung unabhängig von der Agentensitzung beobachtet werden können.
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
-
Benötigt der Agent das Ergebnis dieses Vorgangs, um seinen aktuellen Zug abzuschließen? Falls ja, ist dies nicht das richtige Muster. Verwenden Sie stattdessen Aufruf der sequenziellen Aktion.
-
Ist das nachgelagerte System in der Lage, die disponierte Nachricht oder das disponierte Ereignis ohne synchrone Bestätigung zu empfangen und zuverlässig zu verarbeiten? Das Zielsystem muss langlebig sein. Die Nachricht darf nicht verloren gehen, wenn sie vorübergehend nicht verfügbar ist.
-
Ist der Vorgang idempotent oder muss der doppelte Versand bewacht werden? Wiederholungen auf Netzwerkebene und Wiederholungen von Agentenüberlegungen können dazu führen, dass dieselbe Disposition mehrmals versucht wird. Wenn der nachgelagerte Vorgang nicht idempotent ist, muss die Aktion einen Deduplizierungsschlüssel enthalten.
-
Muss der Benutzer oder ein nachgelagerter Prozess wissen, wann der Vorgang abgeschlossen ist? Der Agent kann nur den Versand bestätigen. Wenn der Abschlussstatus erforderlich ist, entwerfen Sie einen separaten Benachrichtigungs- oder Folgemechanismus. Ein Plattformereignis, eine Kundenvorgangsaktualisierung oder eine Rückmeldung, die sich außerhalb dieses Überlegungszyklus befindet.
Anwendung für Salesforce-Muster
| Lösung | Passend | Kommentare |
|---|---|---|
| Pub/Sub-API | Bestens geeignet für Streaming bei hohem Durchsatz oder externen Ereignissen | Der Agent ruft eine Apex-Aktion auf, die ein Ereignis über gRPC in der Salesforce Pub/Sub-API veröffentlicht. Die Aktion gibt dem Agenten eine PublishResult replayId als Versandbestätigung zurück. Wird verwendet, wenn es sich bei den nachgelagerten Verbrauchern um externe Systeme handelt, die über die Pub/Sub-API und nicht über Salesforce-native Flow- oder Apex-Auslöser abonnieren, oder wenn das Streaming von Ereignissen mit hohem Durchsatz erforderlich ist. |
| Plattformereignisse (Apex-Aktion) | Optimal für die asynchrone Disposition innerhalb Salesforce | Der Agent ruft eine Apex-Aktion auf, die ein Plattformereignis veröffentlicht. Das Ereignis wird allen Abonnenten asynchron zugestellt. Die Aktion gibt eine Veröffentlichungsbestätigung an den Agenten zurück. Sie gibt kein Verarbeitungsergebnis zurück. Wird verwendet, wenn sich der nachgelagerte Verbraucher innerhalb der Salesforce Platform befindet. Der Agent ruft eine Apex Aktion auf, die EventBus.publish() aufruft. Die Aktion gibt eine SaveResult zurück, die die Annahme bestätigt. |
| Apex Queueable / Batch (Apex-Aktion) | Optimal für die langfristige Hintergrundverarbeitung | Der Agent ruft eine Apex-Aktion auf, die einen Queueable- oder Batchauftrag in die Warteschlange stellt. Der Auftrag wird außerhalb der Transaktion des Agenten ausgeführt. Die Aktion gibt eine Auftrags-ID zurück, die der Agent dem Benutzer als Referenz anzeigen kann. Wird verwendet, wenn es sich bei der nachgelagerten Arbeit um eine langfristige Salesforce-Vorgangsdatenverarbeitung, Aktualisierungen von mehreren Objekten oder externe Callouts handelt, die synchrone Obergrenzen überschreiten. System.enqueueJob() gibt eine Auftrags-ID der Agentendatensätze als Referenz zurück. |
| Asynchroner MuleSoft-Flow | Bestens geeignet für den Versand von Warteschlangen für externe Nachrichten | Der Agent ruft eine MuleSoft-exponierte Aktion auf, die eine Nachricht in eine externe Warteschlange (Kafka, JMS, SQS) stellt. MuleSoft übernimmt die Protokollübersetzung und die Zustellungsbestätigung. Der Agent erhält die Bestätigung, dass die Nachricht von MuleSoft akzeptiert wurde, nicht, dass sie nachgelagert verarbeitet wurde. |
| Externer REST-Endpunkt (Apex-Aktion) | Am besten für die Einreichung von Ereignissen externer Systeme | Das Zielsystem stellt einen Endpunkt bereit, der eine Einreichung akzeptiert, und gibt sofort eine Bestätigungs-ID zurück, wodurch die Verarbeitung asynchron abgeschlossen wird. Der Agent erhält die Bestätigungs-ID und zeichnet sie auf. |
Skizze
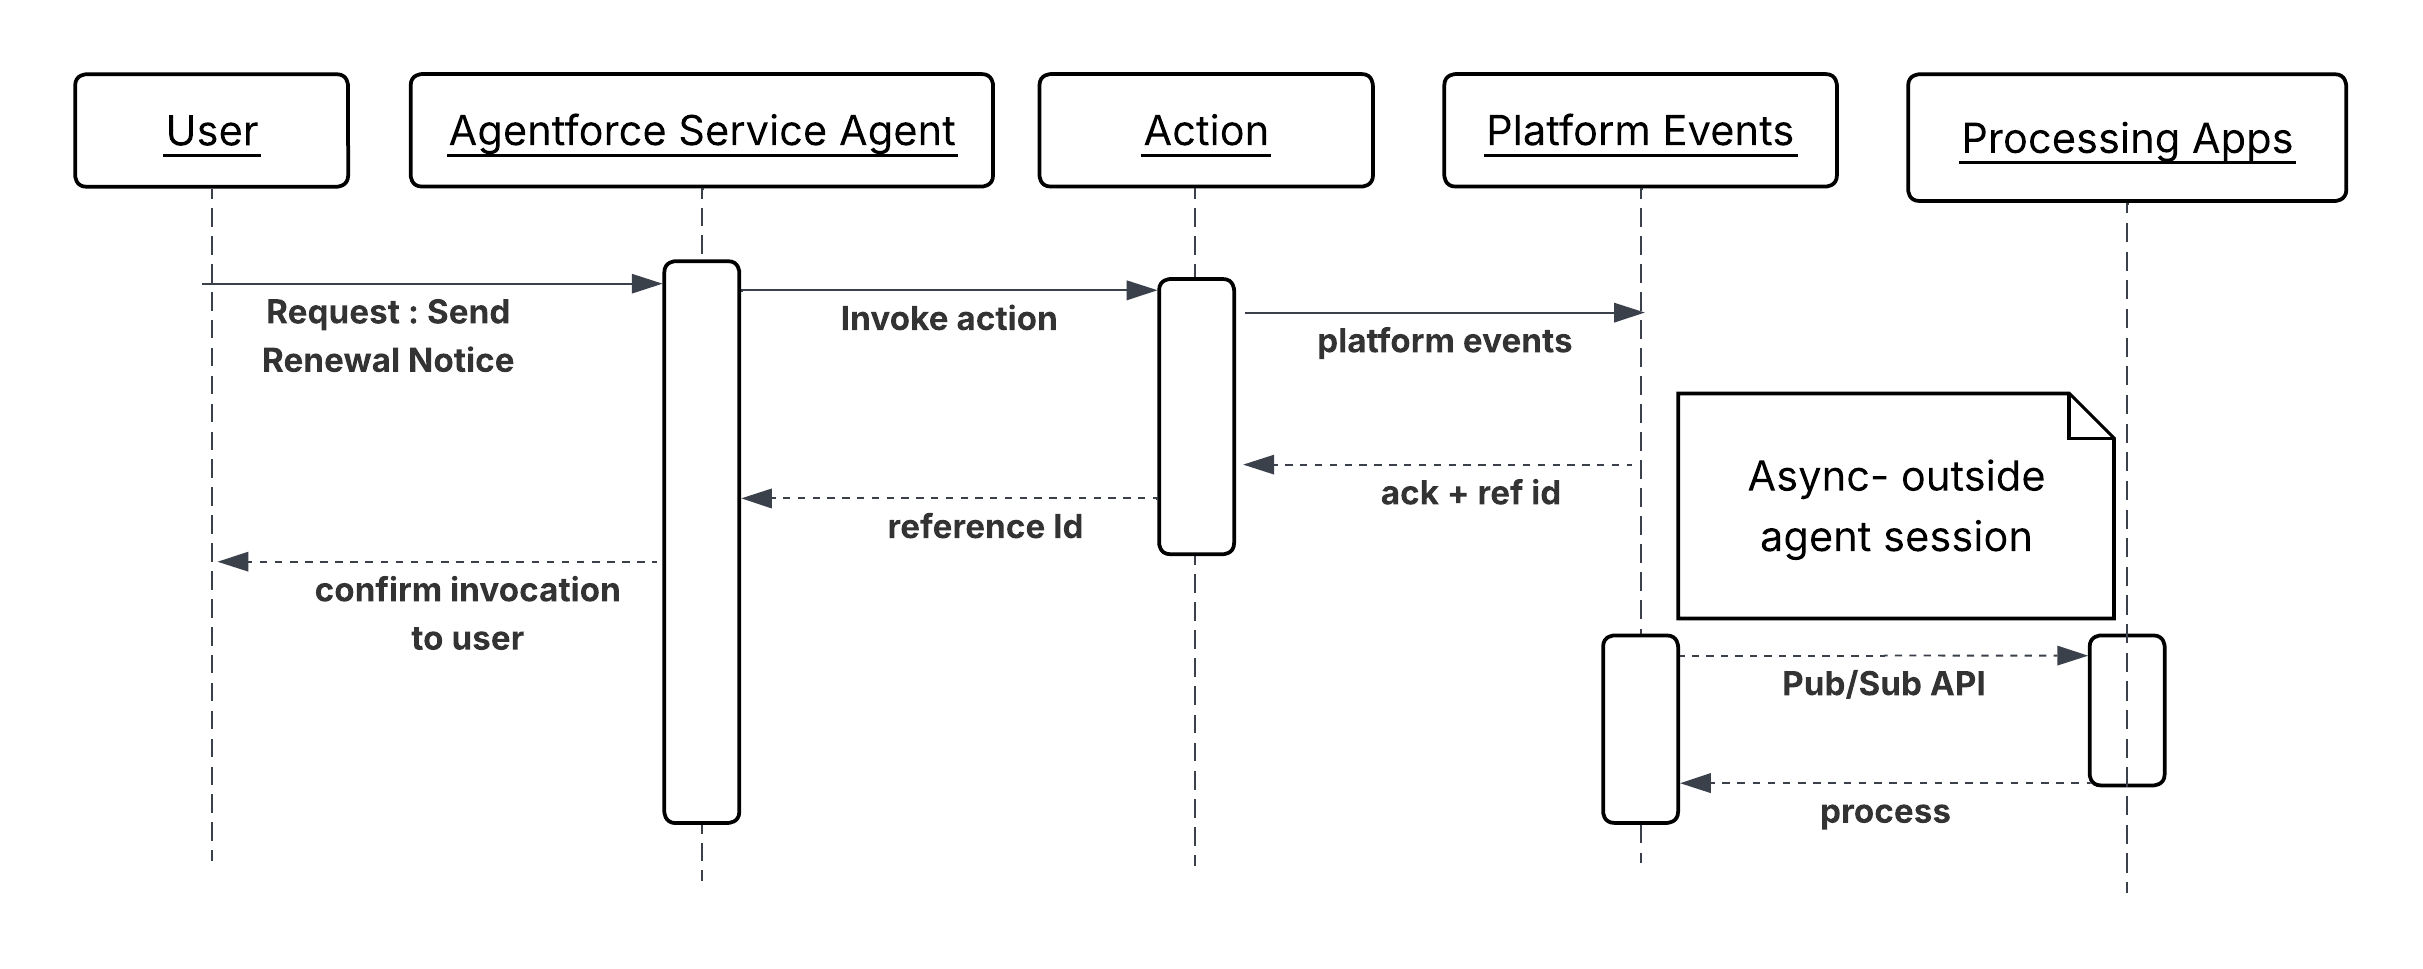
Sequenzdiagramm für Aufruf asynchroner Aktionen
Ergebnisse
Der Agent ruft einen nachgelagerten Vorgang auf, ohne seinen Argumentationszyklus für das Ergebnis zu blockieren. Der Vorgang wird mit der Bestätigung abgeschlossen, dass der Vorgang akzeptiert wurde, nicht dass er abgeschlossen wurde. Das nachgelagerte System übernimmt die vollständige Inhaberschaft der Ausführung. Der disponierte Vorgang kann über Plattformereignisabonnenten, Auftrags-IDs oder externe Warteschlangenbestätigungs-IDs verfolgt werden, die zum Dispositionszeitpunkt im CRM aufgezeichnet werden. Wenn der nachgelagerte Vorgang fehlschlägt, wird dieser Fehler durch die eigene Überwachung des nachgelagerten Systems und nicht durch die Agentensitzung, die ihn initiiert hat, festgestellt.
Überlegungen zum Design
Plattformunabhängige Anleitung
- Schreiben Sie Aktionsbeschreibungen in Intent-basierter Sprache. Beispielsweise ist “Sendet eine Verlängerungsbenachrichtigung an die Messaging-Warteschlange und gibt eine Disponentenverweis-ID zurück” für den Agenten nützlicher als “ruft den Benachrichtigungsendpunkt auf”.
- Beschreiben Sie eine Dispositionsaktion niemals als “sendet und bestätigt die Zustellung von”. Der Agent kann nur die Annahme bestätigen. Die nachgelagerte Zustellung und Verarbeitung liegt außerhalb der Beobachtbarkeit des Agenten.
Salesforce-Implementierungshinweise
- Geben Sie eine Referenz-ID aus jeder Aufrufaktion zurück, beispielsweise eine Plattformereignis-
ReplayId, eine warteschlangenfähige Auftrags-ID, eine Pub/Sub-API-PublishResultreplayId oder ein externes Bestätigungstoken. Zeichnen Sie sie zum Zeitpunkt des Aufrufs in einem CRM-Datensatz auf. Dies ist der einzige Audit-Trail, den die Agentensitzung erstellt. - Bei der Pub/Sub-API ruft der Agent eine Apex-Aktion auf, die einen gRPC-Callout an den Pub/Sub-API-Endpunkt “/Publish” sendet. Die Aktion muss den Schemaregistrierungsschritt verarbeiten. Ereignisse müssen im Avro-Format mit dem registrierten Schema serialisiert werden. Geben Sie die
PublishResult ‘replayId’als Disponentenreferenz an den Agenten zurück. - Rufen Sie für Plattformereignisse
EventBus.publish()innerhalb der Apex Aktion auf und überprüfen Sie das SaveResult auf Fehler, bevor Sie dem Agenten eine Erfolgsanzeige zurückgeben. Gehen Sie nicht von einem Veröffentlichungserfolg aus, sondern validieren Sie ihn. - Implementieren Sie für warteschlangenfähige Aufträge die Schnittstelle “Warteschlange” und rufen Sie System.enqueueJob() innerhalb der Aktion auf. Geben Sie die resultierende AsyncApexJob-ID an den Agenten zurück.
- Bei externen asynchronen Endpunkten muss der Zielendpunkt sofort eine Bestätigung (HTTP 202 Accepted) mit einer Referenz-ID zurückgeben. Wenn der Endpunkt blockiert wird, bis die Verarbeitung abgeschlossen ist, ist er synchron und dieses Muster trifft nicht zu.
Fehlerbehandlung und -behebung
- Bei einer Aufrufaktion muss zwischen einem Dispositionsfehler (die Nachricht wurde nicht akzeptiert) und einem Verarbeitungsfehler (die Nachricht wurde akzeptiert, der nachgelagerte Vorgang ist später fehlgeschlagen) unterschieden werden. Der Agent kann nur Ersteres verarbeiten.
- Wenn der Aufruf fehlschlägt, muss die Aktion einen strukturierten Fehler mit einem eindeutigen Grund zurückgeben. Der Agent kann die Disposition wiederholen, zu einer Person eskalieren oder einen fehlgeschlagenen Disponentendatensatz protokollieren, einen nachgelagerten Verarbeitungsfehler jedoch nicht innerhalb derselben Sitzung beheben.
- Entwerfen Sie für Vorgänge, bei denen ein nachgelagerter Fehler schließlich festgestellt werden muss, eine separate Feedbackschleife, beispielsweise ein vom nachgelagerten Prozess veröffentlichtes Plattformereignis, einen geplanten Flow, der den Auftragsstatus überprüft, oder einen Folgevorgang, der sich außerhalb der Agentensitzung befindet.
Sicherheitsüberlegungen
- Wickeln Sie alle externen asynchronen Callouts in Anmeldeinformationen mit Namen ein. Die Aufrufaktion bettet keine Endpunkt-URLs oder Anmeldeinformationen in Code ein.
- Validieren und bereinigen Sie alle an die Aufrufaktion übergebenen Parameter, bevor sie in die Ereignisnutzlast oder den Nachrichtentext eingebettet werden. Der vom Benutzer bereitgestellte Text, der in eine asynchrone Nachricht übergeben wird, ist ein potenzieller Injektionsvektor im nachgelagerten Verbraucher.
- Protokollieren Sie jede Disposition mit Sitzungs-ID, Referenz-ID und bereinigter Nutzlast zum Zeitpunkt der Disposition. Da dem Agenten keine Antwort zurückgegeben wird, ist dieses Protokoll der primäre Mechanismus zum Rekonstruieren dessen, was der Agent initiiert hat.
- Wenden Sie die geringsten Berechtigungen auf den Integrationsbenutzer oder die verbundene Anwendung an. Eine Disponentenaktion, die in einer Benachrichtigungswarteschlange veröffentlicht wird, sollte keine Anmeldeinformationen enthalten, die Lese- oder Schreibzugriff auf nicht verwandten Systemen zulassen.
Beispiel
Ein Verlängerungsverwaltungsagent, der einen Vertrag bearbeitet, der kurz vor dem Ablauf steht, bestimmt, dass der Kunde für eine Benachrichtigung über die automatische Verlängerung qualifiziert ist. Der Agent benötigt vor Abschluss des Vorgangs keine Bestätigung, dass die E-Mail zugestellt wurde.
CheckRenewalEligibility(Automatisch gestarteter Flow) wertet Vertragsbedingungen, Kundenstufe und Abmeldestatus aus. Gibt einen “geeigneten” booleschen Wert und den bevorzugten Benachrichtigungskanal zurück.DispatchRenewalNotification(Apex Action) veröffentlicht einRenewalNotification\_\_e-Plattformereignis, das die Vertrags-ID, die Kunden-ID, den Benachrichtigungskanal und einen generierten Identitätsschlüssel enthält. Gibt eine ReplayId zurück, die bestätigt, dass das Ereignis von der Plattform akzeptiert wurde.UpdateContractRecord(Automatisch gestarteter Flow) schreibt denReplayId- und Dispositionszeitstempel in den Vertragsdatensatz und legt die Statuskennzeichnung “Benachrichtigung versendet” fest.
Kontext
Externe Anwendungen wie Kundenportale, mobile Anwendungen, SaaS-Drittanbieterplattformen und Partnersysteme müssen Agenten programmgesteuert aufrufen, um Serviceanforderungen zu bearbeiten, Workflows zu initiieren oder AI-gestützte Antworten auf ihren eigenen Oberflächen anzuzeigen. Der Agent fungiert als intelligenter Backend-Service. Das externe System stellt Kontext bereit, der Agent gründet und handelt und der Anrufer verwendet die Antwort.
Zunehmend ist der Anrufer selbst ein AI-Agent oder -Orchestrator und keine Anwendung mit menschlichem Gesicht. In diesen AI-zu-AI-Mustern delegiert ein Orchestrierungsagent einen Argumentationsschritt, einen CRM-Nachschlagevorgang oder eine Aktion als separaten Tool-Aufruf an Agentforce. Zur Unterstützung dieses Musters muss ein MCP-Server (Model Context Protocol) bereitgestellt werden.
Probleme
Wenn ein externes System oder AI-Agent die Funktionen eines Agentforce-Agenten bei Bedarf nutzen muss, wie authentifiziert er sich, erstellt eine Agentensitzung, übergibt die erforderlichen Unterhaltungs- und Kontextdaten und erhält zuverlässig die strukturierte Antwort des Agenten, um seine eigene nachgelagerte Logik zu steuern?
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Erwartet der externe Anrufer eine synchrone Antwort mit geringer Latenz oder ist eine asynchrone Rückmeldung akzeptabel?
- Wie wird die Identität des Anrufers hergestellt und in den Ausführungskontext des Agenten für den Datenzugriff und die Personalisierung übernommen?
- Wie hoch ist das erwartete Volumen gleichzeitiger durch die API ausgelöster Sitzungen und wie interagiert dies mit den Salesforce-API-Raten- und -Gleichzeitigkeitsobergrenzen?
- Muss das externe System die Sitzungskontinuität über mehrere Runden hinweg aufrechterhalten (Multiturn-Unterhaltung) oder ist jede Anforderung statuslos?
- Wie sollte die Antwort des Agenten strukturiert sein, damit das aufrufende System sie analysieren und programmgesteuert darauf reagieren kann?
- Handelt es sich bei dem Aufrufer um eine Anwendung, die direkt in den REST integriert werden muss, oder um einen AI-Agenten oder -Orchestrierer, der Agentforce über ein Standardprotokoll wie MCP als Tool aufrufen kann?
Anwendung für Salesforce-Muster
| Lösung | Passend | Kommentare |
|---|---|---|
| Agentforce Agent API – Single Turn (Synchron) (Einzel-Turn (synchron)) | Bestens geeignet für Integrationen ohne Status in Anforderungen und Antworten | Das Anrufsystem erfordert eine sofortige strukturierte Antwort und es wird erwartet, dass die Argumentation des Agenten innerhalb der Zeitüberschreitungstoleranz des Anrufers abgeschlossen ist. Das aufrufende System verwaltet die vollständigen Phasen des Sitzungslebenszyklus – Erstellung, Wendungen und Beendigung. Das externe System authentifiziert sich, erstellt eine Sitzung mit Kontextvariablen, sendet eine einzelne Nachricht, empfängt die Antwort des Agenten und schließt die Sitzung. Diese Agentforce API ist die primäre REST-Schnittstelle, über die externe Systeme Sitzungen erstellen, Nachrichten austauschen und Sitzungen programmgesteuert schließen können. Der gesamte Austausch wird innerhalb eines HTTP-Anforderungs-Antwort-Zyklus abgeschlossen. Antworten umfassen die Ausgabe in natürlicher Sprache des Agenten und alle strukturierten Ausgabevariablen, die durch Aktionen generiert werden, die der Agent während der Überlegungen aufgerufen hat. |
| Agentforce Agent API – Multi-Turn (Sitzungskontinuität) | Bestens geeignet für Unterhaltungsintegrationen, bei denen ein Zustand über mehrere Runden hinweg erforderlich ist | Die externe Oberfläche ist konversativ (z. B. ein Chat-Widget oder eine Sprachschnittstelle) und die Interaktion erfordert mehrere Austausche, um eine Lösung zu erreichen. Das externe System erstellt einmal eine Sitzung und verwendet die Sitzungs-ID über mehrere Nachrichtenaustausche hinweg wieder. Der Agent behält den Unterhaltungskontext zwischen Runden bei, beispielsweise vorherige Fragen, abgerufene Daten oder Entscheidungen, die getroffen wurden, ohne dass der Anrufer sie erneut angibt. |
| Asynchron mit Abstimmung oder Webhook-Rückmeldung | Bestens geeignet für Workflows für Argumentation mit hoher Latenz oder zeitkritische Benutzeroberflächen | Die Verarbeitungszeit des Agenten ist nicht trivial und das Halten einer offenen HTTP-Verbindung würde die Benutzererfahrung des Anrufers beeinträchtigen oder vorgelagerte Zeitüberschreitungen auslösen. Das externe System sendet die Anforderung und erhält sofort eine Bestätigung mit einer Auftrags- oder Sitzungs-ID. Anschließend fragt es einen Statusendpunkt ab oder registriert einen Webhook, um die Antwort des Agenten nach Abschluss der Überlegungen zu erhalten. Derzeit kann dieses Muster mit einer Wrapper-API implementiert werden, die auf einer Middleware wie MuleSoft gehostet wird. Externer Verbraucher ruft diese Wrapper-API auf und registriert den Webhook-Endpunkt. Nach dem Aufruf von Agentforce Agent sendet die Wrapper-API die Bestätigung zurück an das externe System. Diese Wrapper-API behält auch die Agentforce Agentensitzung bei und gibt die Antwort mithilfe des registrierten Webhook-Endpunkts an das externe System zurück, sobald der Agent antwortet. |
| Agentforce über MCP (Salesforce Headless 360) | Bestens geeignet für AI-zu-AI-Aufrufe, bei denen der Anrufer ein MCP-kompatibler Client ist | Der aufrufende MCP-Client ruft Agentforce über den vorkonfigurierten MCP-Server von Salesforce Headless 360 als Tool auf. Der Sitzungslebenszyklus wird transparent vom MCP-Server verwaltet und der aufrufende Agent interagiert über standardmäßigen Tool-Aufruf, ohne eine benutzerdefinierte REST-Integration zu erstellen. Verwenden Sie diese Lösung, wenn es sich bei dem Anrufer um einen MCP-Client handelt, der Argumentation, CRM-Kontextabruf oder Aktionsausführung als separaten Schritt in einem umfassenderen Agenten-Workflow an Agentforce delegieren muss. |
Skizze
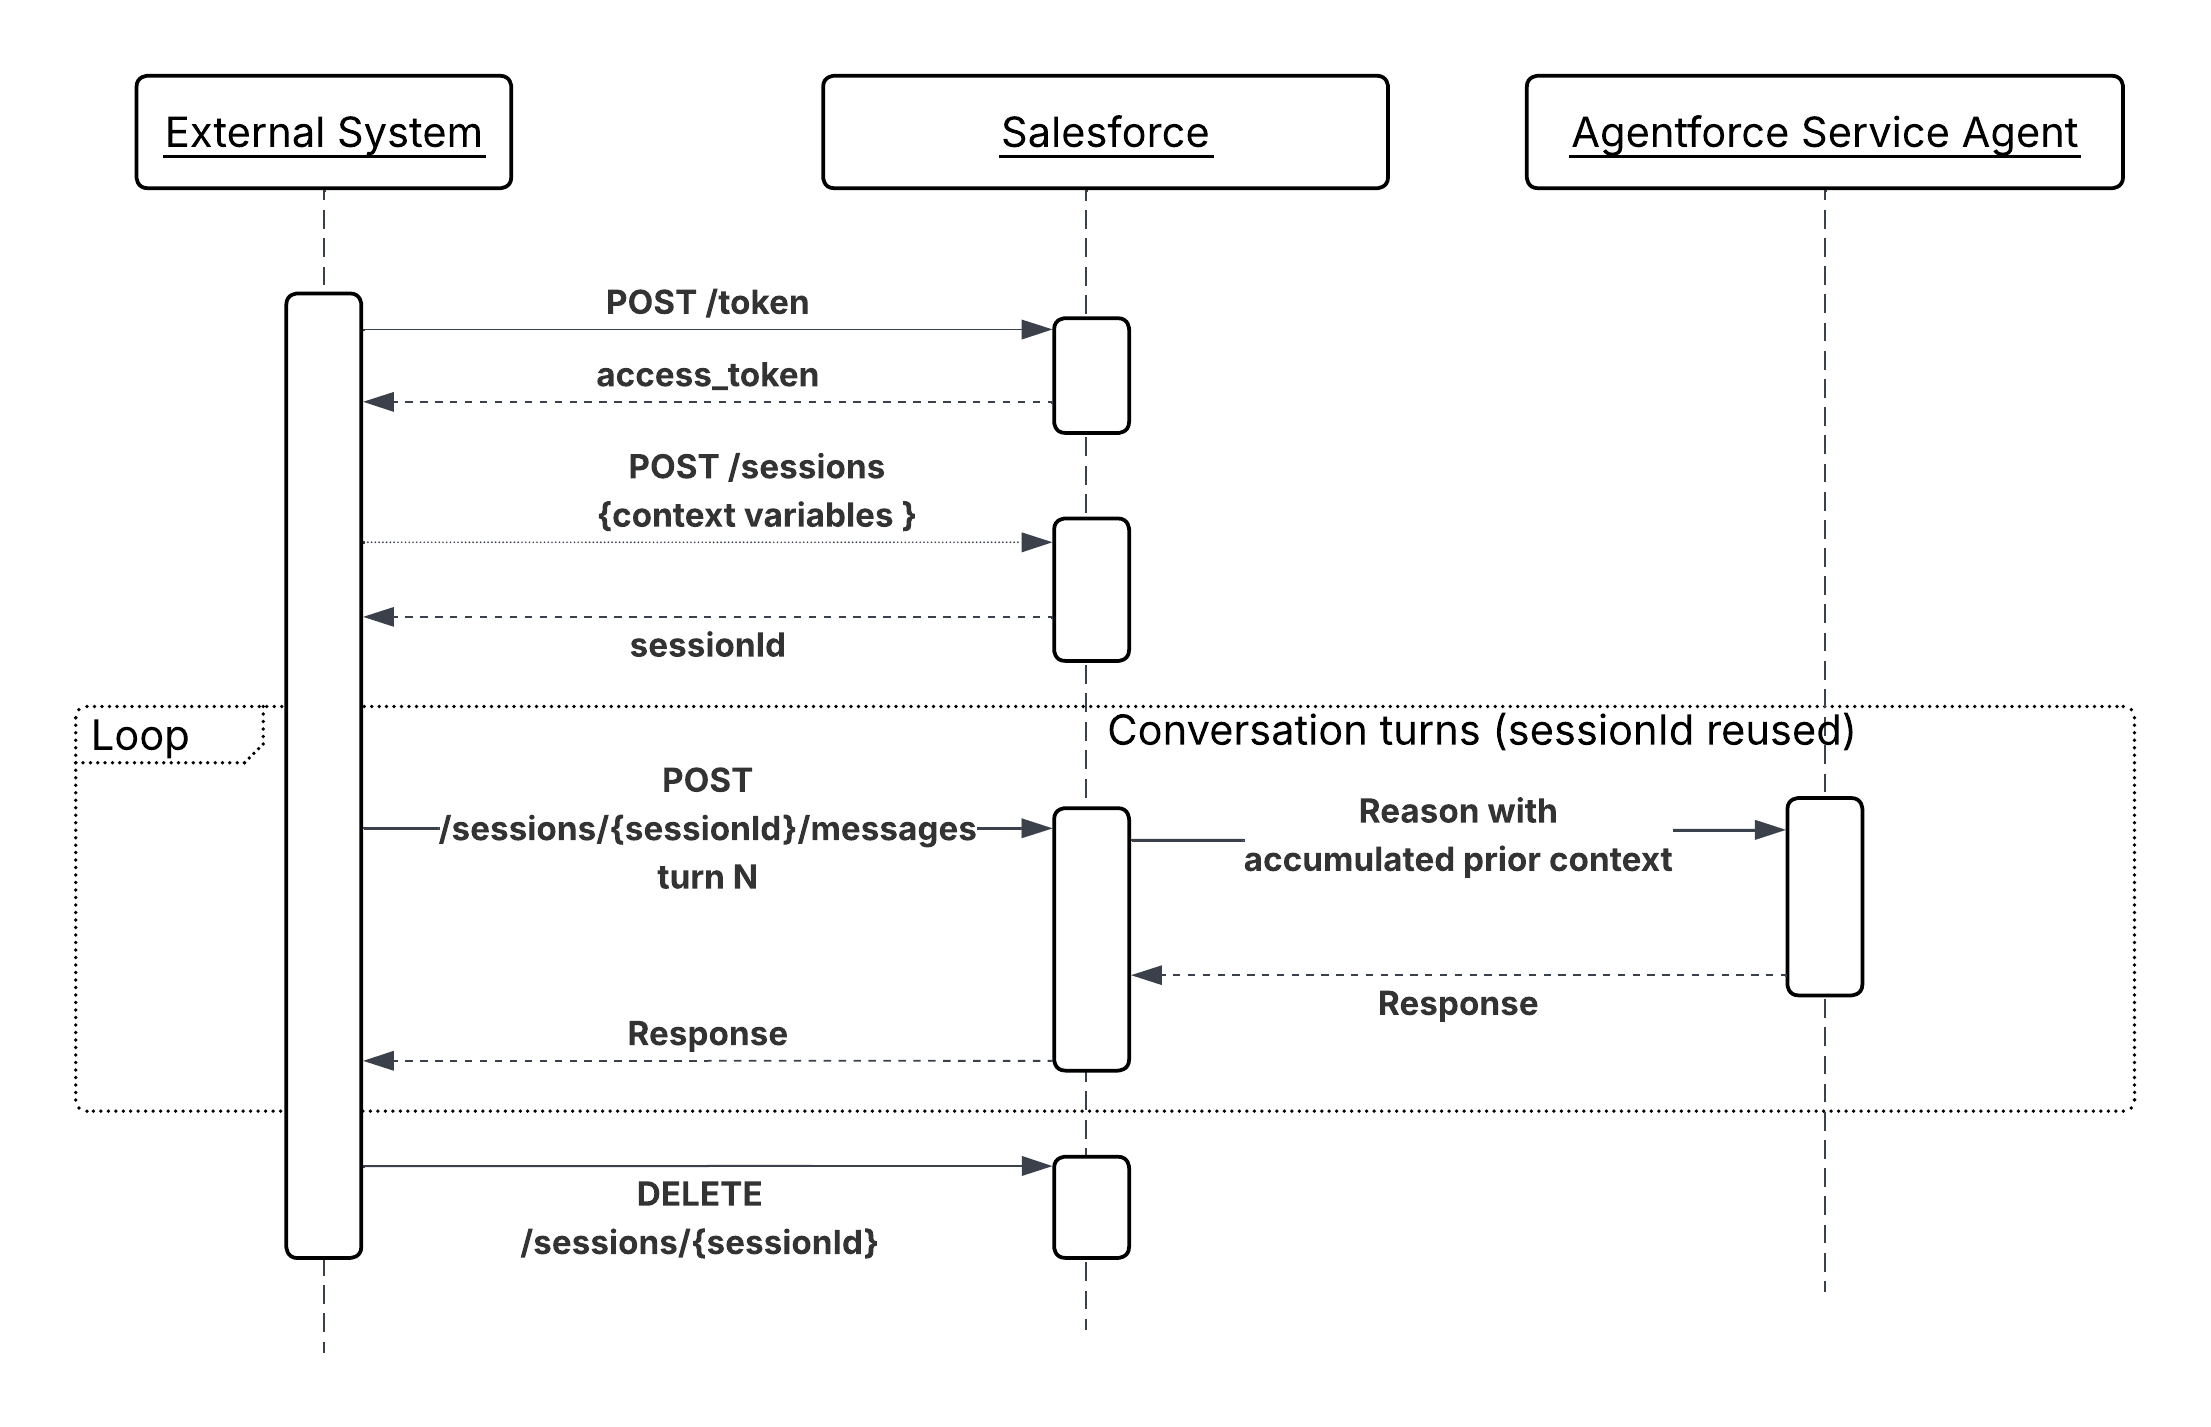
Sequenzdiagramm für den Agentenaufruf bei Bedarf
Ergebnisse
Durch dieses Muster wird Agentforce als aufrufbarer AI-Service dargestellt. Externe Systeme erhalten Zugriff auf die Argumentation, die Tools und den CRM-Kontext des Agenten, ohne diese Logik zu reproduzieren. Der Anrufer bleibt für die Sitzungslebenszyklus-Verwaltung und das Rendern der Antwort verantwortlich. Der Agent bleibt für alle Argumente, die Toolauswahl und die Antwortsynthese verantwortlich.
Wenn es sich bei dem Anrufer um einen AI-Agenten oder -Orchestrierer handelt, ist durch den MCP-Mechanismus von Agentforce (vorkonfiguriert über Salesforce Headless 360 verfügbar) keine benutzerdefinierte REST-Integration mehr erforderlich. Der MCP-Server verarbeitet den Sitzungslebenszyklus im Namen des aufrufenden Agenten, wodurch Agentforce ohne zusätzliche Installation als erstklassiges Tool an Workflows mit mehreren Agenten teilnehmen kann.
Überlegungen zum Design
Plattformunabhängige Anleitung
- Vermeiden Sie es, den externen API-Aufruf synchron zu gestalten und in zeitkritischen Benutzeroberflächen-Flows zu blockieren. Verwenden Sie ein Abfrage- oder Webhook-Rückmeldungsmuster, bei dem die Antwortzeiten des Agenten nicht trivial sind, um die Benutzererfahrung von der Verarbeitungszeit des Agenten zu entkoppeln.
- Wählen Sie den Anrufmechanismus anhand der Art des Anrufers und nicht anhand der Verfügbarkeit aus. Für menschenorientierte Anwendungen und Systemintegrationen sollte die Agenten-API direkt verwendet werden. Tools, die MCPs unterstützen, sollten den Agentforce MCP-Server verwenden. Die Kombination von Mechanismen für denselben Anrufertyp erhöht unnötige Komplexität ohne architektonischen Nutzen.
Salesforce-Implementierungshinweise
- Fügen Sie Sitzungskontext in die POST-Anforderung für die Sitzungserstellung ein, nicht in die erste Benutzernachricht. Wenn das externe System die Sitzung erstellt, hat es die Möglichkeit, strukturierte Kontextvariablen (Account-ID, Anspruchsdaten, vorherige Interaktionszusammenfassung) direkt als Sitzungsparameter mit Namen weiterzugeben. Diese Variablen stehen dem Agenten zur Verfügung, bevor er einen einzelnen Zug verarbeitet. Daher beginnt er mit der Argumentation, ohne Nachschlageaufrufe zu senden, um festzustellen, wer der Kunde ist oder worauf er Anspruch hat. Wenn der Agent stattdessen dieselben Daten innerhalb des Nachrichtentexts weitergibt, muss er unstrukturierten Text analysieren, um Fakten zu extrahieren, die er als eingegebene Variablen erhalten haben könnte. Dies erhöht die Latenz, führt zu Extraktionsfehlern und verbraucht Argumentationsschritte, die keinen geschäftlichen Mehrwert bieten.
- Gestalten Sie Agentenantworten so, dass sie strukturiert und maschinenlesbar sind. Verwenden Sie Ausgabevariablenkonventionen und Aufforderungsanweisungen, die den Agenten anleiten, JSON-freundliche oder klar abgegrenzte Antworten zurückzugeben, wenn der Aufrufer ein System und kein Mensch ist.
- Sitzungslebenszyklus explizit verwalten. Beenden Sie Sitzungen sofort nach der Verwendung von
DELETE /einstein/ai-agent/v1/sessions/{sessionId}, um Gleichzeitigkeitszeitfenster freizugeben und zu vermeiden, dass veralteter Kontext über nicht zugehörige Interaktionen hinweg bestehen bleibt. - Berücksichtigen Sie die Obergrenzen für gleichzeitige Salesforce-Sitzungen. Implementieren Sie für Szenarien mit hohem Durchsatz einen Sitzungspool oder eine Warteschlangenebene im aufrufenden System, um die Ablehnung von Anforderungen während der Spitzenlast zu verhindern.
- Wenn Sie Agentforce über MCP aufrufen, übergeben Sie Kontext als Eingabeparameter und nicht als Sitzungsvariablen. Der MCP-Server verwaltet den Sitzungslebenszyklus transparent. Daher kann der aufrufende Agent keine Sitzungsparameter mit Namen direkt zum Zeitpunkt der Erstellung festlegen. Stellen Sie sicher, dass der gesamte erforderliche Kontext (Datensatz-IDs, Benutzeridentität, Anspruchsdaten) in der Tool-Aufrufnutzlast enthalten ist, damit der Agent von einem fundierten Status aus mit der Argumentation beginnt.
- Behandeln Sie die transparente Sitzungsverwaltung des MCP-Servers als Bequemlichkeit und nicht als Gleichzeitigkeitsumgehung. Jeder Tool-Aufruf verbraucht weiterhin ein Sitzungsfenster für Salesforce-Agenten. Hochfrequente Orchestrierer, die Agentforce im großen Maßstab über MCP aufrufen, müssen dieselben Obergrenzen für gleichzeitige Sitzungen berücksichtigen, die für direkte Agenten-API-Aufrufer gelten.
Fehlerbehandlung und -behebung
- Die Agenten-API gibt standardmäßige HTTP-Fehlercodes zurück. Das aufrufende System muss “429 zu viele Anforderungen” (Ratenobergrenze) mit exponentieller Absicherung und “503-Service nicht verfügbar” mit Wiederholungslogik verarbeiten.
- Wenn der Agent selbst auf einen nicht behebbaren Toolfehler stößt, wird ein Fehler in natürlicher Sprache im Antworttext zurückgegeben. Das aufrufende System erkennt diese Sentinel-Antworten (z. B. Überprüfung auf das Statusfeld “Fehler” in der Antwort) und leitet sie entsprechend weiter, indem es entweder versucht, es mit zusätzlichem Kontext zu wiederholen, eine Ausweicherfahrung darzustellen oder eskaliert.
- Beim Aufruf über MCP werden Fehler auf zwei unterschiedlichen Ebenen angezeigt: MCP-Transportfehler (fehlgeformte Tool-Aufrufe, Server-Nichtverfügbarkeit) und Agentforce-Ursachungsfehler (Fehler bei der Tool-Ausführung, nicht behebbare Aktionen). Der Orchestrierungsagent muss beide Ebenen unabhängig voneinander verarbeiten. MCP-Transportfehler sollten Wiederholungsversuche auf Protokollebene auslösen. In der Tool-Antwort zurückgegebene Agentforce-Begründungsfehler sollten durch die eigene Ausweich- oder Eskalationslogik des Orchestrators behoben werden.
Sicherheitsüberlegungen
- Verwenden Sie möglichst enge OAuth-Geltungsbereiche für die externe Client-Anwendung. Eine Integration, die nur einen Agenten aufrufen muss, sollte keine Umfänge für den Datenzugriff enthalten, die über die Anforderungen des Agenten selbst hinausgehen.
- Validieren und bereinigen Sie alle Eingaben aus dem externen System, bevor Sie sie als Sitzungsvariablen injizieren. Externe Eingaben sind eine Angriffsfläche für die Eingabeaufforderung. Beispielsweise kann ein bösartiger Anrufer ein Feld “customerQuery” erstellen, das Agentenanweisungen überschreiben soll.
- Wenden Sie die IP-Zulassungsliste auf die externe Client-Anwendung an, um einzuschränken, welche externen Systeme die Agenten-API authentifizieren und aufrufen können.
- Protokollieren Sie alle durch die eingehende API ausgelösten Sitzungen mit Anruferidentität, Sitzungs-ID und Anforderungs-/Antwort-Metadaten zu Überwachungs- und Sicherheitszwecken.
- Wenn Agentforce über MCP aufgerufen wird, authentifiziert sich der MCP-Server im Namen des aufrufenden Benutzers bei Salesforce. Stellen Sie sicher, dass die Anmeldeinformationen der verbundenen Anwendung des MCP-Servers auf die erforderlichen Mindestberechtigungen beschränkt sind und dass die Identität des Endbenutzers (mit MCP-Tools wie Claude) explizit über Toolsingabeparameter in den Sitzungskontext übernommen wird.
Beispiel
Ein Finanzdienstleistungsportal löst aus, dass ein Agentforce eine Hypothekenanfrage bearbeitet.
- Das Portal authentifiziert sich mithilfe des OAuth-Flows für Client-Anmeldeinformationen und ruft ein Bearer-Token ab.
- Er ruft “POST /Einstein/ai-agent/v1/sessions” mit Sitzungsvariablen auf: ”{ “accountId”: “001xx…”, “productType”: “mortgage”, “loanAmount”: 450000 }”.
- Der Benutzer sendet seine Frage: “Welche Dokumente benötige ich, um meine Bewerbung auszufüllen?”
- Das Portal ruft “POST /Einstein/ai-agent/v1/sessions/{sessionId}/messages” mit dem Text des Benutzers auf.
- Der Agentforce ruft die Flow-Aktion “GetDocumentChecklist” auf, ruft die darlehenstypspezifischen Anforderungen ab und gibt eine strukturierte Liste zurück.
- Das Portal stellt die Antwort des Agenten inline dar und schließt die Sitzung beim Beenden des Benutzers.
Kontext
Nicht alle Agenten-Workflows stammen aus einer menschlichen Anforderung. Geschäftskritische Signale wie ein plötzlicher Rückgang der Produktnutzungskennzahlen, ein Verlassen des Einkaufswagens mit hohem Wert oder ein Zahlungsausfall beim Überschreiten eines Risikoschwellenwerts treten häufig in Betriebsdaten auf. Wenn diese Signale intelligente Antworten aus mehreren Schritten erfordern, führt das Warten darauf, dass ein Mensch es bemerkt und handelt, zu einer Latenz, die sich zu den realen Geschäftskosten addiert.
Dieses Muster beschreibt, wie Echtzeitereignisse als autonome Eintrittspunkte für Agenten dienen. Der Agent wird durch eine Datenbedingung und nicht durch einen Benutzer aufgerufen, er hat Gründe für den Ereigniskontext und führt einen Antwort-Workflow aus – alles ohne menschliche Initiierung.
Probleme
Wenn ein Geschäftsereignis in Echtzeit in Data 360 oder auf der Salesforce Platform auftritt, wie kann dieses Ereignis eine Agentensitzung autonom instanziieren, die Ereignisnutzlast als Kontext bereitstellen und einen Workflow für nicht unterhaltungsbasierte Aktionen zum Abschluss bringen, ohne dass eine Person die Interaktion initiiert oder leitet?
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Ist eine Antwort sofort zu dem Zeitpunkt erforderlich, zu dem das Ereignis ausgelöst wird, oder ist eine Verarbeitung nahezu in Echtzeit (Sekunden bis Minuten) akzeptabel?
- Enthält die Ereignisnutzlast genügend Kontext, um den Agenten zu erden, oder muss der Agent zusätzliche Nachschlagevorgänge ausführen, bevor er effektiv argumentieren kann?
- Wie hoch sind das erwartete Ereignisvolumen und die erwartete Häufigkeit? Ereignisströme mit hohem Durchsatz erfordern eine Ratenverwaltung, um Obergrenzen für die gleichzeitige Nutzung von Agenten zu vermeiden.
- Kann dasselbe Ereignis mehrmals für dieselbe Geschäftseinheit ausgelöst werden (mindestens einmal Zustellung)? Ist dies der Fall, müssen Aktionen idempotent sein.
- Gibt es einen menschlichen Eskalationspfad, wenn der Agent das Ereignis nicht autonom lösen kann?
- Wie sollte die fehlerhafte Ereignisverarbeitung angezeigt werden? Mit einer Warteschlange mit totem Brief, einer Benachrichtigung oder einer Kundenvorgangserstellung?
Anwendung für Salesforce-Muster
| Lösung | Passend | Kommentare |
|---|---|---|
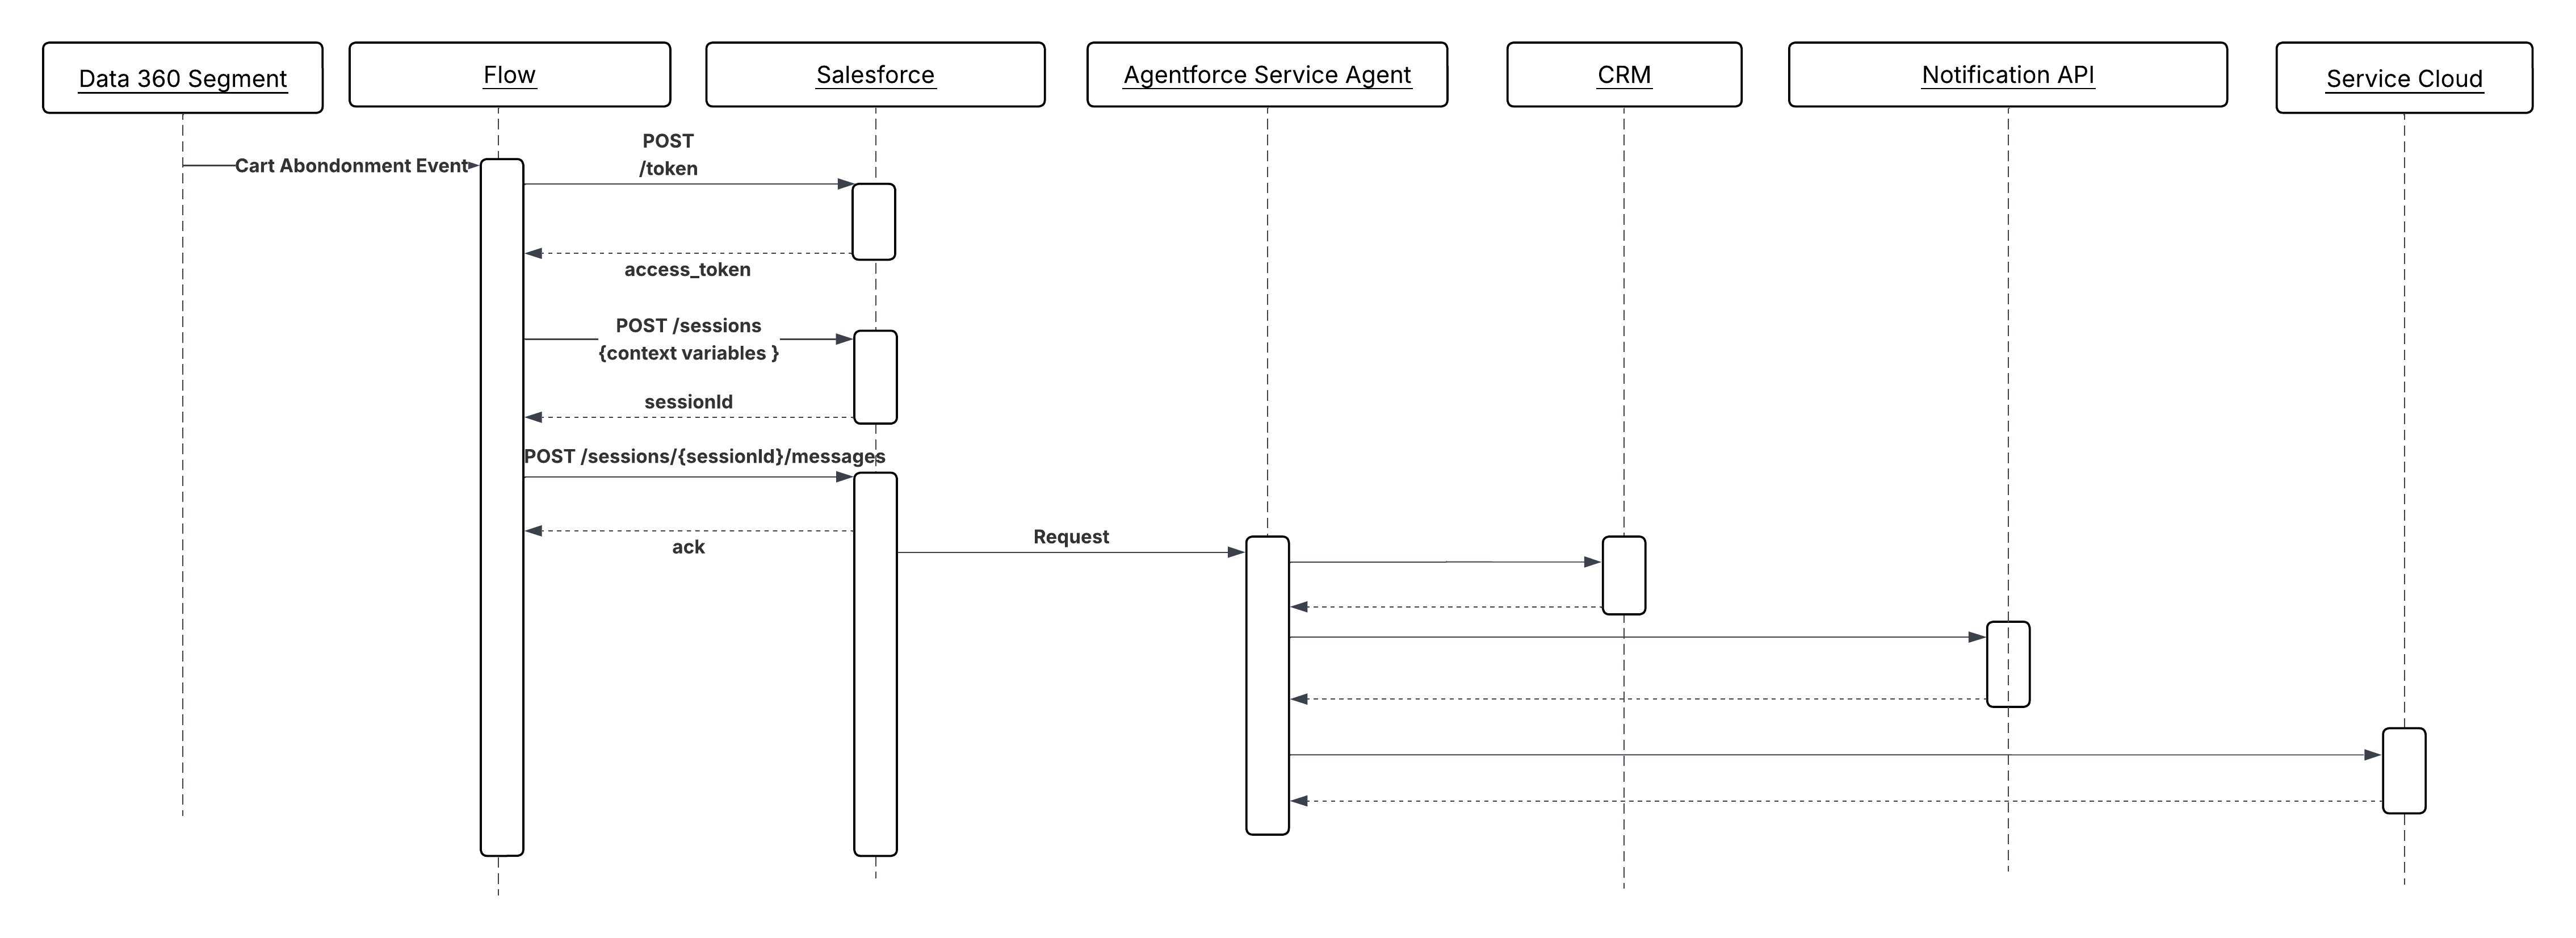
| Durch Data 360 ausgelöste Flows | Bestens geeignet für verhaltensbasierte und kennzahlbasierte Signale | Dies ist am besten geeignet, wenn die Auslöserbedingung als Änderung der Data 360-Segmentmitgliedschaft oder als Schwellenwert für Kennzahlen definiert ist. Data 360 erkennt den Geschäftszustand (z. B. Verlassen des Einkaufswagens, Rückgang der Nutzung) und löst einen ausgelösten Flow aus. Der Flow ordnet Agentensitzungsvariablen Ereignisnutzlastattribute zu und erstellt die Agentforce-Sitzung. |
| Plattformereignisse + Automatisch gestarteter Flow oder Apex | Bestens geeignet für plattforminterne und systemübergreifende Ereignisse | Verwenden Sie diese Lösung, wenn sich die Ereignisquelle innerhalb der Salesforce Platform befindet oder wenn eine Middleware-Ebene das Ereignis veröffentlicht, nachdem die Bedingung in einem externen System erkannt wurde. Ein von einem beliebigen Salesforce-Prozess oder externen System veröffentlichtes Plattformereignis löst einen Apex-Auslöser oder automatisch gestarteten Flow aus, der die Agentensitzung mit der Ereignisnutzlast als Kontext erstellt. |
Skizze
Sequenzdiagramm für die ereignisgesteuerte Agentenausführung
Ergebnisse
Agenten werden zu reaktiven Teilnehmern an Echtzeitgeschäften und nicht zu passiven Antworten auf menschliche Anfragen. Durch Ereignisse ausgelöste Agenten können Wiederherstellungs-, Triage- und Eskalations-Workflows mit Datengeschwindigkeit statt mit menschlicher Aufmerksamkeit ausführen.
Das auslösende System (Data 360 oder Plattformereignisse) bleibt für die Ereigniserkennung und die Nutzlastbildung verantwortlich. Der Agent bleibt für die Argumentation über diese Nutzlast und die Auswahl der richtigen Aktionskette verantwortlich. Es ist keine Unterhaltung erforderlich. Die Ereignisnutzlast ist die vollständige Eingabe.
Überlegungen zum Design
Plattformunabhängige Anleitung
- Entwerfen Sie alle Aktionen für den Aufruf ohne Unterhaltung. Es gibt keinen Benutzerwechsel. Der Agent muss eine Lösung nur aus dem anfänglichen Kontext der Kontextbildung erreichen. Aktionen sollten strukturierte, deterministische Ausgaben zurückgeben, statt sie zur Klarstellung aufzufordern.
- Stellen Sie sicher, dass die Ereignisnutzlast genügend Kontext enthält, bevor die Agentensitzung erstellt wird. Eine schlanke Nutzlast, die den Agenten zwingt, mehrere Nachschlageaufrufe zu tätigen, bevor er die Ursache dafür finden kann, erhöht die Latenz und den Gleichzeitigkeitsverbrauch.
- Legen Sie alle Schreibvorgänge, die durch ereignisgesteuerte Agenten ausgelöst werden, als idempotent fest. Ereigniszustellungssysteme bieten in der Regel mindestens einmal Garantien. Die Verarbeitung doppelter Ereignisse kann keine doppelten Nebenwirkungen verursachen.
Salesforce-Implementierungshinweise
- Ordnen Sie in durch Data 360 ausgelöste Flows Ereignisnutzlastattribute (z. B. “accountId”, “eventType”, “metricValue”, “productIds”) direkt benannten Sitzungsvariablen zum Zeitpunkt der Sitzungserstellung zu. Dadurch wird der Agent ab dem ersten Argumentationsschritt konsolidiert, ohne dass eine Abrufaktion erforderlich ist.
- Verwenden Sie für Plattformereignisauslöser einen automatisch gestarteten Flow anstelle eines Bildschirm-Flows. Bildschirm-Flows werden in autonomen Kontexten ohne Unterhaltung nicht unterstützt.
- Legen Sie eine explizite Sitzungs-Timeout für durch Ereignisse ausgelöste Sitzungen fest. Im Gegensatz zu Unterhaltungssitzungen gibt es keinen Benutzer, der die Interaktion erweitern kann. Eine Sitzung, die bei einer fehlgeschlagenen Aktion ins Stocken gerät, sollte nicht unbegrenzt Zeitfenster enthalten.
- Verwenden Sie Flow-Fehlerpfade, um Fehler bei der Erstellung von Agentensitzungen zu beheben. Wenn die Sitzung nicht erstellt werden kann, sollte der Fehlerpfad ein kompensierendes Ereignis veröffentlichen oder einen Kundenvorgang für die menschliche Weiterverfolgung erstellen, statt das Ereignis stillschweigend zu verwerfen.
Fehlerbehandlung und -behebung
- Ereignisse, die aufgrund von Gleichzeitigkeitsobergrenzen, Fehlern bei der Sitzungserstellung oder Fehlern bei der Nutzlastvalidierung keine Agentensitzung erfolgreich auslösen können, sollten an einen Fehlerpfad weitergeleitet werden, der einen Kundenvorgang erstellt, eine Benachrichtigung auslöst oder das Ereignis zur erneuten Verarbeitung in einer Warteschlange mit auslaufendem Brief veröffentlicht.
- Agentenfehler während der Ausführung (z. B. Zeitüberschreitung einer erforderlichen Aktion) sollten mit der ursprünglichen Ereignis-ID protokolliert werden. Da die Auslösung asynchron ist und kein wartender Anrufer vorhanden ist, basiert die Fehleroberfläche vollständig auf der Beobachtbarkeit: Protokolle, Dashboards und Benachrichtigungsschwellenwerte.
- Implementieren Sie eine Obergrenze für Wiederholungen. Wenn ein Ereignis zuverlässig zu einem Agentenausfall führt, werden die Obergrenzen für die Gleichzeitigkeit durch nicht begrenzte Wiederholungen ausgeschöpft. Leiten Sie das Ereignis nach einer konfigurierbaren maximalen Anzahl von Versuchen an eine Warteschlange für menschliche Überprüfungen weiter, wobei der vollständige Kontext angehängt ist.
- Verfolgen Sie die Ereignis-ID durch den gesamten Lebenszyklus der Agentensitzung. Durch diese Verfolgung wird eine Korrelation zwischen dem ursprünglichen Datensignal und allen nachgelagerten Aktionen für die Überprüfung und das Debuggen ermöglicht.
Sicherheitsüberlegungen
- Validieren und bereinigen Sie alle Ereignisnutzlastattribute, bevor Sie sie als Agentensitzungsvariablen injizieren. Ereignisnutzlasten aus Data 360 oder externen Publishern sind eine Angriffsfläche für die Eingabeaufforderung. Beispielsweise kann ein gestaltetes Nutzlastfeld so konzipiert sein, dass Agentenanweisungen überschrieben werden.
- Führen Sie durch Ereignisse ausgelöste Agentensitzungen unter einem dedizierten Integrationsbenutzer mit den geringsten Berechtigungen und nicht unter einer Administratoridentität mit hohen Berechtigungen aus. Der Agent verfügt nur über die Berechtigungen, die zum Ausführen seines definierten Aktionssatzes erforderlich sind.
- Protokollieren Sie alle durch Ereignisse ausgelösten Sitzungen mit der ursprünglichen Ereignis-ID, dem Ereignistyp und den bei der Erstellung eingefügten Sitzungsvariablen. Dieser Prüfpfad ist erforderlich, um zu rekonstruieren, warum der Agent eine bestimmte Aktion ausgeführt hat, wenn das Ergebnis umstritten ist.
Beispiel
Ein Einzelhandelsunternehmen verwendet Data 360, um das Einkaufswagenverhalten in Echtzeit zu verfolgen. Wenn ein Einkaufswagen mit einem Wert über einem definierten Schwellenwert verlassen wird:
- Data 360 erkennt das Verlassenssignal und löst einen ausgelösten Flow mit der Ereignisnutzlast: “customerId”, “cartValue”, “productIds” und “abandonmentTimestamp”.
- Der Flow ordnet diese Attribute Agentforce-Sitzungsvariablen zu und erstellt eine neue Agentensitzung. Es ist keine Benutzerinteraktion erforderlich.
- Der Agent wertet den Kaufverlauf, die aktuellen Ansprüche und die Einkaufswagenzusammensetzung des Kunden mithilfe der verfügbaren Abrufaktionen aus.
- Der Agent ruft eine
SelectRecoveryOfferauf, die die entsprechende Rabattklasse basierend auf dem Kundensegment anwendet, und eineSendProactiveNotification, um das Angebot über den bevorzugten Kanal des Kunden bereitzustellen. - Der Agent ruft
CreateFollowUpTaskauf, um die Interaktion im CRM für die Sichtbarkeit des Accountinhabers zu protokollieren. - Die Sitzung wird nach Abschluss der Aktionskette automatisch geschlossen. Die ursprüngliche Ereignis-ID wird zur Rückverfolgbarkeit im Sitzungsprotokoll beibehalten.
Kontext
LLMs werden anhand öffentlicher Daten trainiert. Sie haben keine Knowledge über die Produkte, Richtlinien, den Kundenvorgangsverlauf oder die Verträge Ihrer Organisation, es sei denn, diese Informationen werden explizit zum Zeitpunkt der Überlegungen bereitgestellt. Ohne Kontextbildung wird ein Agent nach dem Serviceanspruch eines Kunden oder den Bedingungen eines bestimmten Vertrags gefragt, um eine Antwort zu halluzinieren oder zuzugeben, dass er es nicht weiß. Keines der Ergebnisse ist in einem Unternehmenskontext akzeptabel.
Die Abruf-Augmented Generation (RAG) löst dies, indem sie relevante Dokumente aus einem Knowledge Store für Unternehmen abruft und sie in das Kontextfenster des Agenten einfügt, bevor eine Antwort generiert wird. Der Agent hat Gründe für abgerufene Inhalte, beispielsweise einen Knowledge-Artikel, eine Lösung für Kundenvorgänge in der Vergangenheit oder eine Produktspezifikation, als hätte er diese Informationen direkt erhalten. Der LLM liefert die Überlegungen, die Abrufebene die Fakten.
Ein Serviceagent, der einen komplexen Garantieanspruch bearbeitet, muss beispielsweise keine Gewährleistungsbedingungen in seine Anweisungen eingebettet haben. Wenn der Kunde sein Problem beschreibt, führt der Agent stattdessen eine semantische Suche oder eine hybride Suche (Stichwortsuche + semantische Suche) anhand eines Vektorindex der Garantiedokumentation aus, ruft die entsprechenden Bedingungen ab und verwendet sie, um die Berechtigung und die nächsten Schritte zu bestimmen. Die Antwort basiert auf dem aktuellen, maßgeblichen Richtliniendokument und nicht auf den Trainingsdaten des Modells.
Probleme
Ein Agent muss eine Frage beantworten oder eine Entscheidung treffen, die von proprietärem Knowledge wie Richtlinien, Verträgen, Produktdokumentationen oder historischen Kundenvorgangsdaten abhängt, die nicht Teil der Schulungsdaten des LLM waren. Wie ruft der Agent die relevantesten Inhalte zum Zeitpunkt der Überlegungen ab, stellt sicher, dass die abgerufenen Inhalte aktuell und verbindlich sind, und fügt sie mit ausreichender Genauigkeit in den Kontext ein, um Störungen zu vermeiden?
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Ist der Knowledge Inhalt statisch und wird selten aktualisiert (z. B. Produkthandbücher) oder ändert er sich kontinuierlich (z. B. Kundenvorgangslösungen, Bestandsbeschreibungen)? Die Aktualisierungshäufigkeit bestimmt das Design der Aufnahme-Pipeline.
- Wie groß ist der Inhalt? Eine kleine Knowledge Base kann vollständig abgerufen werden. Eine große Knowledge Base erfordert eine Aufteilung, Einbettung und semantische Indizierung, um nur die relevantesten Passagen zurückzugeben.
- Profitiert die Abfrage von einem einzelnen fokussierten Abruf oder würde die Kombination von Ergebnissen aus mehreren Knowledge Quellen (z. B. Dokumentation und vergangenen Kundenvorgängen) zu einer fundierteren Antwort führen? Letzteres erfordert einen Ensembleabruf.
- Müssen abgerufene Inhalte vor der semantischen Rangfolge nach Metadaten gefiltert werden, um beispielsweise die Ergebnisse auf Dokumente zu beschränken, die für die Produktklasse oder die geografische Lage des Kunden relevant sind?
- Wie sensibel sind die Knowledge Inhalte? Abgerufener Inhalt wird in das LLM-Kontextfenster eingefügt und beeinflusst die Antwort des Agenten. Inhalte, die bestimmten Benutzern nicht angezeigt werden sollen, müssen auf der Abrufebene gesteuert werden und dürfen nicht nach LLM gefiltert werden.
Anwendung für Salesforce-Muster
| Lösung | Passend | Kommentare |
|---|---|---|
| Abruf-erweiterte Generierung (RAG) mit Data 360 | Bestens geeignet für Enterprise-Anwendungsfälle | Der Agent führt eine semantische Suche anhand von Data 360-Vektorindizes durch, bevor er eine Antwort generiert. Die abgerufenen Inhalte wie Knowledge-Artikel, vergangene Kundenvorgänge und Produktdokumentation werden als Kontextbildung in den LLM-Kontext eingefügt. Dies kann mit Abrufaktionen, Flow oder benutzerdefiniertem Apex aufgerufen werden. Beachten Sie, dass Data 360 eine integrierte Pipeline vom Rohinhalt bis zum für Agenten geeigneten Kontext unterstützt, nicht nur einen Vektorspeicher:
Alle diese Funktionen werden schlüsselfertig und vollständig konfigurierbar angeboten. Es gibt zwei Abruftypen für Data360: Individueller Abrufer: Eine konfigurierte Salesforce Retriever-Aktion führt eine semantische Suche anhand eines einzelnen definierten Suchindex aus und gibt die relevantesten Inhaltsblöcke zurück. Ergebnisse werden direkt in die LLM-Eingabeaufforderung als Kontext eingefügt. Verwenden Sie die Aktion “Einzelpersonenabruf”, wenn die Abfrage am besten von einer einzelnen fokussierten Knowledge Quelle bereitgestellt wird. Ensemble-Abrufer: Eine Ensemble-Abrufaktion kombiniert die Ergebnisse mehrerer einzelner Abrufer, beispielsweise einen Produktdokumentationsindex und einen Index für gelöste Kundenvorgänge. Ensembleabrufer kombinieren keine Relevanzbewertungen einzelner Abrufer, da diese Bewertungen nicht über heterogene Indizes hinweg vergleichbar sind. Stattdessen werden alle abgerufenen Blöcke durch ein codiererübergreifendes Reranker-Modell geleitet, das jedes Paar (Abfrage, Blöcke) unabhängig bewertet und eine einheitliche Rangfolge ergibt. Dies ist architektonisch bedeutsam: Dies bedeutet, dass die Qualität der quellenübergreifenden Rangfolge mit dem Reranker-Modell verbessert wird, nicht mit der manuellen Bewertungskalibrierung. Nachdem sie neu eingestuft wurden, wird das zusammengeführte Ergebnis LLM-Aufforderungen als Kontext für die Kontextbildung zur Verfügung gestellt. Verwenden Sie Ensemble Retriever Action (Ensemble-Abrufaktion), wenn für eine vollständigere Antwort Nachweise aus mehreren Knowledge Domänen erforderlich sind. |
| RAG mit Vektordatenbanken von Drittanbietern | Geeignet für die Arbeit innerhalb vorhandener Infrastruktureinschränkungen | Bei diesem Ansatz werden Vektorspeicher von Drittanbietern integriert, die möglicherweise bereits in Ihrer Infrastruktur vorhanden sind, um proprietäre Dateneinbettungen zu indizieren und sie für die semantische Echtzeitsuche und den Inhaltsabruf zu nutzen. Dies kann mit Flow oder benutzerdefiniertem Apex implementiert werden. |
Skizze
Sequenzdiagramm für Knowledge Grounding aus Unternehmensinhalten
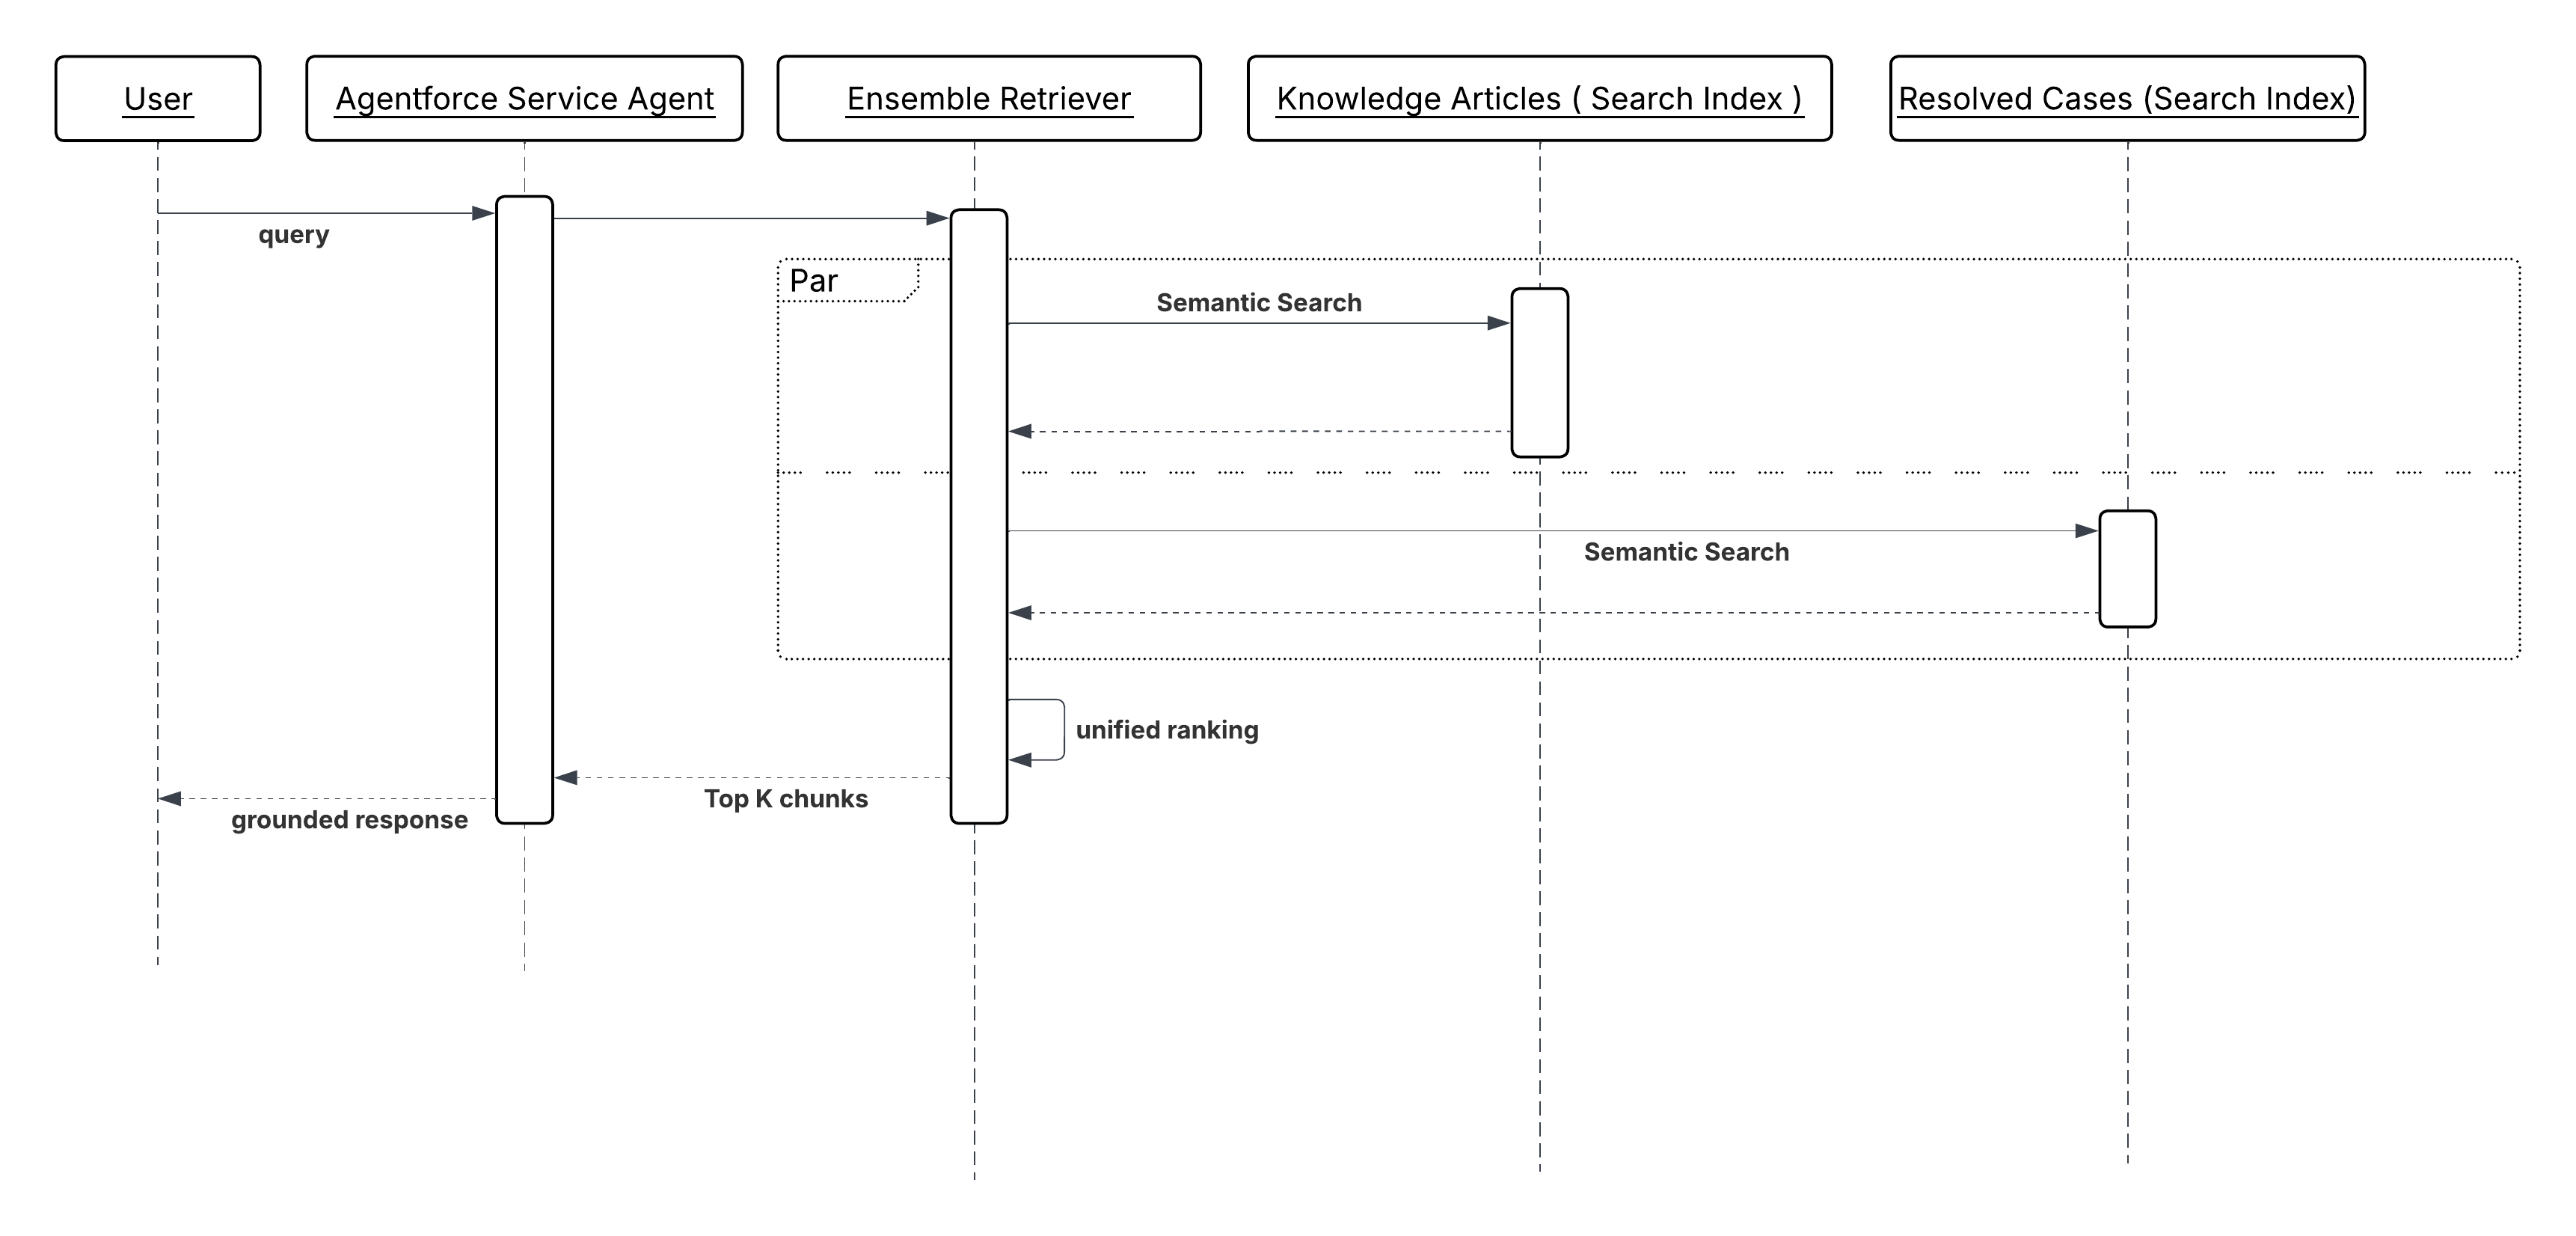
Ergebnisse
Die Antworten des Agenten basieren auf dem aktuellen, maßgeblichen Knowledge der Organisation und nicht auf den Trainingsdaten des LLM. Das Halluzinationsrisiko bei faktischen Fragen wie Policenbedingungen, Produktspezifikationen und Anspruchsdetails wird reduziert, da das Modell über abgerufene Nachweise sinniert und nicht aus dem Speicher generiert wird.
Die Knowledge Inhalte bleiben unabhängig voneinander verwaltbar. Das Aktualisieren eines Richtliniendokuments oder das Hinzufügen einer neuen Kundenvorgangslösung zum Index wird sofort für alle nachfolgenden Agenteninteraktionen wirksam, ohne das Modell neu zu trainieren oder bereitzustellen.
Der Abruf bietet auch einen impliziten Prüfpfad. Da die Antwort des Agenten aus bestimmten abgerufenen Dokumenten abgeleitet wird, kann der Quellinhalt zusammen mit der Antwort protokolliert werden, wodurch verfolgt werden kann, warum der Agent eine bestimmte Antwort gegeben hat.
Überlegungen zum Design
Plattformunabhängige Anleitung
- Verteilen und betten Sie Knowledge Content in der richtigen Granularität ein. Zu große Blöcke verwässern die Relevanz. Bei zu kleinen Blöcken geht der Kontext verloren, den das LLM benötigt, um richtig zu argumentieren. Bei den meisten Unternehmensdokumenttypen sorgt die Aufteilung auf Absatzebene mit sich überschneidenden Kontextfenstern für die beste Abrufqualität.
- Behandeln Sie die Abrufgenauigkeit als erstklassiges Designanliegen. Das Einfügen von Inhalten mit geringer Relevanz in das Kontextfenster des Agenten ist nicht neutral. Es führt zu Rauschen, das die Antwortqualität beeinträchtigt. Optimieren Sie Abrufschwellenwerte und Obergrenzen, um den Abruf mit der Genauigkeit für jede Knowledge Domäne abzugleichen.
- Die Aufnahmelatenz ist eine operative SLA. Wenn ein Policendokument aktualisiert wird, der Vektorindex jedoch nicht aktualisiert wurde, ruft der Agent veraltete Informationen ab und reagiert darauf. Definieren Sie für jeden Inhaltstyp eine zulässige Toleranz für veraltete Inhalte und entwerfen Sie die Aufnahmepipelines entsprechend.
Salesforce-Implementierungshinweise
- Füllen Sie Data 360-Vektorindizes über die entsprechende Aufnahme-Pipeline für die Inhaltsaktualisierungshäufigkeit aus. Verwenden Sie die Batch-Aufnahme für statische Dokumente und die Streaming- oder Change Datenerfassung (CDC) für Datensätze, die sich kontinuierlich ändern.
- Konfigurieren Sie für Ensemble Retrievers die Relevanzranggewichtungen pro Quelle. Ein Index für gelöste Kundenvorgänge benötigt möglicherweise eine Aktualitätsverzerrung, ein Richtliniendokumentationsindex hingegen nicht. Stimmen Sie die Gewichtungen anhand der Abfragetypen ab, die der Agent verarbeiten soll.
- Verwenden Sie Metadatenfilter in benutzerdefiniertem Apex oder Flow Retriever, um den Abruf vor der Ausführung der semantischen Suche zu begrenzen. Das Filtern nach Produktlinie, Region oder Dokumenttyp vor dem Rang reduziert das Rauschen und verbessert die Genauigkeit der in den Kontext eingefügten Elemente.
- Fügen Sie nicht das vollständige abgerufene Dokument in den LLM-Kontext ein. Geben Sie nur die relevanten Blöcke oder Auszüge weiter. Große Kontextinjektionen verbrauchen das Token-Budget, erhöhen die Latenz und reduzieren den Anteil des Kontextfensters, der für die Argumentation des Agenten verfügbar ist.
Fehlerbehandlung und -behebung
- Wenn beim Abruf keine Ergebnisse zurückgegeben werden, geben Sie den expliziten Status “Keine Ergebnisse gefunden” zurück, statt ohne Grundlage fortzufahren. Anschließend kann der Agent die Abfrage erweitern, den Benutzer um Klarstellung bitten oder zu einer Person eskalieren.
- Jeder von den Abrufern zurückgegebene Block enthält eine Relevanzbewertung. Abhängig vom Anwendungsfall sollte ein bestimmter Konfidenz-/Relevanzschwellenwert konfiguriert werden, oberhalb dessen der Agent den Abruf als sicher behandeln sollte, andernfalls sollte er auf eine Klarstellung oder Eskalation zurückgreifen.
- Wenn der Vektorindex oder Abrufservice vorübergehend nicht verfügbar ist, sollte die Abrufaktion oder der Apex Callout einen strukturierten Fehler mit einem aussagekräftigen Grund zurückgeben. Protokollieren Sie den Fehler mit der Sitzungs-ID und der Abfrage, damit Abruflücken identifiziert und der Index oder Service auf Verfügbarkeit überwacht werden kann.
- Implementieren Sie für zeitkritische Knowledge Domänen eine Aktualisierungsprüfung als Teil der Abrufantwort. Wenn das letzte übereinstimmende Dokument zuletzt über einen definierten Schwellenwert für die Pattsituation hinaus aktualisiert wurde, kennzeichnen Sie dies dem Agenten, damit er seine Antwort oder Aufforderung zur Überprüfung qualifizieren kann.
Sicherheitsüberlegungen
- Beim Abruf müssen die Datenzugriffsberechtigungen des Benutzers berücksichtigt werden, in dessen Namen der Agent handelt. Eine Agentensitzung, die im Kontext einer kundenorientierten Interaktion ausgeführt wird, darf keine internen Betriebsdokumente, Preisstrategiehinweise oder Datensätze abrufen, auf die der Endbenutzer andernfalls keinen Zugriff hätte. Wenden Sie die Feldebenen- und Datensatzebenensicherheit auf der Abrufebene an. Verlassen Sie sich nicht darauf, dass die LLM vertrauliche abgerufene Inhalte zurückhält.
- Abgerufener Inhalt wird in das LLM-Kontextfenster eingefügt und kann die Antwort des Agenten beeinflussen oder in ihr angezeigt werden. Behandeln Sie jedes Dokument im Abrufinhalt als potenziell für den Endbenutzer sichtbar und regeln Sie die Inhaltsmitgliedschaft entsprechend.
- Protokollieren Sie alle Abrufabfragen und die Dokumentkennzeichner der abgerufenen Blöcke zusammen mit der Sitzungs-ID. Dieser Prüfpfad ermöglicht die Rekonstruktion der Nachweise, die der Agent beim Antworten verwendet hat, was für Compliance-, Streitbeilegungs- oder Erklärbarkeitsverpflichtungen erforderlich sein kann.
Beispiel
Ein Finanzdienstleistungsagent verarbeitet eine Kundenanfrage zu Strafen für vorzeitige Rückzahlungen für ein Sparprodukt mit fester Laufzeit:
- Der Kunde fragt: “Welche Strafe würde ich verhängen, wenn ich mein Geld sechs Monate früher abheben würde?”
- Der Agent ruft eine Aktion vom Typ “Einzelpersonenabrufer” auf, die für einen Vektorindex der Produktbedingungen konfiguriert ist.
- Der Abrufer führt eine semantische Suche anhand des Abfragekontexts wie Produkttyp und Kundenaccount und der spezifischen Frage aus und gibt die drei relevantesten Dokumentblöcke zurück – die Klausel zur vorzeitigen Einlösung, die Tabelle zur Strafberechnung und die für Härtefälle geltenden Ausnahmen.
- Die abgerufenen Blöcke werden zusammen mit der Frage des Kunden in das Kontextfenster des Agenten eingefügt.
- Der Agent begründet die abgerufenen Bedingungen, identifiziert den anwendbaren Strafsatz für die Produktklasse und die Einlösungszeitachse des Kunden und gibt eine präzise, richtlinienbasierte Antwort unter Angabe des Datums des Inkrafttretens der verwendeten Bedingungen zurück.
- Die Dokumentkennzeichner der abgerufenen Blöcke werden mit dem Sitzungsdatensatz protokolliert, um die Überprüfbarkeit zu gewährleisten.
Kontext
LLMs sind von Natur aus probabilistisch. Wenn sie gefragt werden, ob sie über einen bestimmten Kunden nachdenken möchten, folgern, schätzen oder halluzinieren sie Fakten, die ihnen nicht explizit genannt wurden. Ein Agent, der eine Preisaktion aufruft, ohne zu wissen, dass der Kunde ein Unternehmensaccount mit hohem Wert in einer bevorzugten Klasse ist, wendet möglicherweise die falsche Rabattlogik an. Ein Agent, der einen Supportvorgang eskaliert, ohne die Abwanderungsrisikobewertung des Kunden zu kennen, kann einen Account, der Tage von der Abwanderung entfernt ist, entpriorisieren.
Die verifizierte Kundenkontextinjektion behebt dies, indem vorab Aktionseingabeparameter mit überprüften strukturierten Attributen aus dem zusammengeführten Profil ausgefüllt werden, bevor der Agent eine Aktion aufruft. Der Agent schließt nicht auf den Trend des Kundensegments, den Lebenszeitwert oder die Kundenzufriedenheit. Sie erhält diese Fakten als Kontexteingaben und Gründe dafür. Dieses Muster reduziert das Halluzinationsrisiko bei kundenspezifischen Entscheidungen und eliminiert redundante Nachschlageaufrufe während des Argumentationszyklus.
Bevor ein Preisagent beispielsweise eine Aktion vom Typ “GenerateQuote” aufruft, fügt die Unteragentenkonfiguration automatisch das Segment, die Klasse und den Lebenszeitwert des Kunden aus seinem zusammengeführten Profil ein. Die Aktion erhält überprüfte Fakten anstelle von abgeleiteten Näherungen mit LLM und das Angebot ist mit der tatsächlichen Geschäftsbeziehung des Kunden verknüpft.
Dies ist keine Alternative zum Muster “Knowledge Grounding from Enterprise Content”. Ein gut konzipierter Agent kann beides verwenden: “Knowledge Grounding from Enterprise Content” (Knowledge-Kontextbildung aus Unternehmensinhalt) bietet dokumentenbasiertes Knowledge, während “Verified Customer Context Injection” (Verifizierte Kundenkontextinjektion) die Identität des Kunden festlegt.
Probleme
Wie können Sie sicherstellen, dass ein Agent über genaue, kundenspezifische Fakten wie Segment, Stufe, Lebenszeitwert, Abwanderungsrisiko oder andere Profilattribute verfügt, bevor er eine Aktion ausführt, statt diese Fakten selbst zu erraten?
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Welche Aktionseingabeparameter stellen kundenspezifische Fakten dar, die bei Rückschluss und nicht bei Quellenangaben zu falschen oder inkonsistenten Ergebnissen führen würden?
- Sind die erforderlichen Profilattribute als standardmäßige vereinheitlichte Data 360-Profilfelder verfügbar oder erfordern sie berechnete Statistiken, die aus rohen Verhaltens- und Transaktionsdaten abgeleitet werden?
- Wie häufig ändern sich die relevanten Profilattribute? Attribute wie die Abwanderungsrisikobewertung oder der CSAT-Trend erfordern eine Aktualisierungsgarantie; veraltete Profildaten führen zu denselben falschen Ergebnissen wie halluzinierte Daten.
- Sollen Profilattribute zum Zeitpunkt der Sitzungserstellung (konstant für die Dauer der Sitzung) injiziert oder zum Zeitpunkt des Aktionsaufrufs neu abgerufen werden (um Statusänderungen während der Sitzung widerzuspiegeln)?
- Muss der Agent direkt über die Profilattribute nachdenken oder werden sie nur von der Aktion verbraucht und sind für die Argumentationsschleife des Agenten opak?
Anwendung für Salesforce-Muster
| Lösung | Passend | Kommentare |
|---|---|---|
| Subagentkonfiguration – Profilattributzuordnung | Bestens geeignet für statisches Grounding auf Sitzungsebene | Am besten geeignet, wenn die Profilattribute innerhalb einer einzelnen Interaktion stabil sind. Ordnen Sie die Attribute des zusammengeführten Data 360-Profils (z. B. “customerSegment”, “tier”, “lifetimeValue”) direkt den Eingabeparametern für Aktionen in der Konfiguration der Agentforce-Unteragenten zu. Attribute werden bei der Sitzungserstellung aufgelöst und für die Dauer der Sitzung konstant gehalten. |
| Verbundene Data 360-Flows | Bestens geeignet für dynamische Aktualisierungen oder Sitzungsaktualisierungen | Wird verwendet, wenn sich Profilattribute häufig ändern oder wenn für die Aktion der aktuellste Status erforderlich ist. Verwenden Sie einen verbundenen Data 360-Flow als Aktionsschritt, um den neuesten Profilstatus zum Zeitpunkt des Aufrufs anzuzeigen.Der Flow fragt das zusammengeführte Profil ab, wendet die erforderliche Transformation an und gibt die Attribute als Ausgabevariablen zurück, die von der nächsten Aktion in der Kette verbraucht werden. |
| Berechnete Statistiken als Aktionseingaben | Bestens geeignet für komplexe abgeleitete Kennzahlen | Wird verwendet, wenn Agenten über berechnete Geschäftskennzahlen (Abwanderungsrisikobewertung, CSAT-Trends, Produktakzeptanzindex) nachdenken müssen, statt Rohdaten zu interpretieren. Definiert in Data 360 als abgeleitete Kennzahlen, die über Verhaltens-, Transaktions- und Interaktionsdaten berechnet werden. Berechnete Statistiken werden als abfragbare Profilattribute angezeigt und können über die Themenkonfiguration oder einen verbundenen Flow Aktionseingaben zugeordnet werden. |
Skizze
Sequenzdiagramm für die überprüfte Kundenkontextinjektion
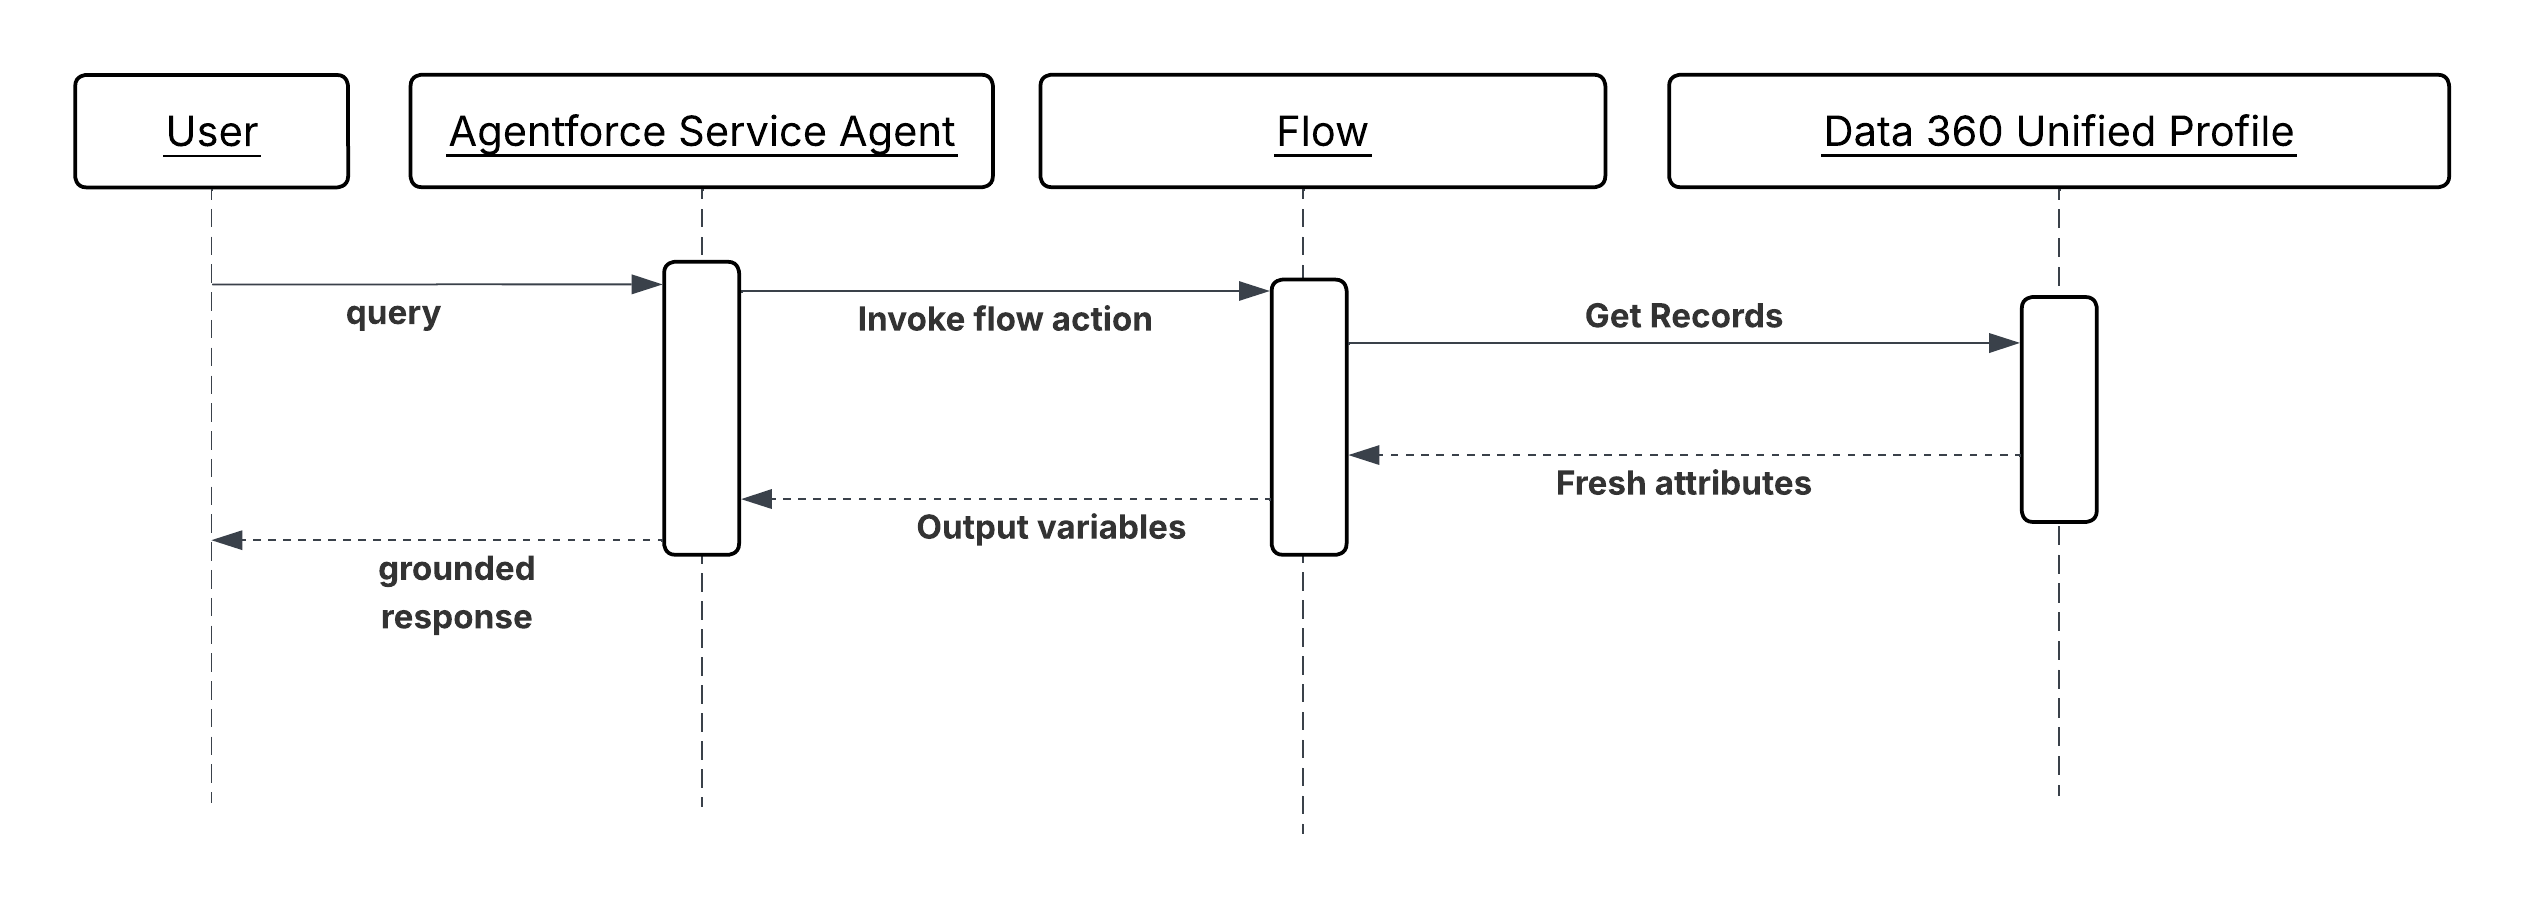
Ergebnisse
Aktionen erhalten überprüfte, strukturierte Kundenfakten anstelle von abgeleiteten LLM-Annäherungen. Die Überlegungen des Agenten sind auf den tatsächlichen Profilstatus des Kunden ausgerichtet und reduzieren das Halluzinationsrisiko bei Entscheidungen, bei denen die faktische Genauigkeit die Ergebnisqualität bestimmt, beispielsweise Preise, Anspruchsprüfungen, Eskalationsweiterleitung und Aufbewahrungsangebote.
Die Profilbildung reduziert zudem die Argumentationslatenz. Wenn der Agent keine Nachschlageaufrufe ausführen muss, um einen grundlegenden Kundenkontext herzustellen, ist der Überlegungszyklus kürzer und die Gleichzeitigkeit wird für weniger Runden verbraucht.
Das zusammengeführte Data 360-Profil bleibt die maßgebliche Quelle für Kundenfakten. Die Subagentenkonfiguration oder der verbundene Flow ist die Integrationsnaht. Der Agent ist für die Argumentation dieser Fakten und die Auswahl von Aktionen verantwortlich, nicht für die Beschaffung der Fakten selbst.
Überlegungen zum Design
Plattformunabhängige Anleitung
- Identifizieren Sie alle Aktionseingaben, die ein Halluzinationsrisiko bergen – wobei die LLM-Rückschlussfolgerung zu einem falschen Ergebnis anstelle eines überprüften Werts führen könnte. Eingaben mit Halluzinationsrisiko sind Kandidaten für die Profilbildung. Nicht jede Eingabe erfordert eine Kontextbildung. Wenn Profildaten überschrieben werden, wird das Kontextfenster des Agenten verzerrt.
- Behandeln Sie die Profilfrische als Designentscheidung und nicht als nachträglichen Gedanken. Definieren Sie die zulässige Toleranz für die Pattalität für jedes begründete Attribut und wählen Sie den Injektionsmechanismus entsprechend aus: Zuordnung auf Sitzungsebene für stabile Attribute, Flow-basierte Aktualisierung für volatile Attribute.
- Berechnete Statistiken sollten Geschäftslogik und keine Rohkennzahlen codieren. Eine Agentenüberlegungen zu einem “churnRiskScore” von 0,87 ist effektiver als eine Agentenüberlegungen zu 14 unverarbeiteten Verhaltenssignalen. Berechnen Sie die Interpretation in Data 360 und übergeben Sie das Ergebnis an den Agenten.
Salesforce-Implementierungshinweise
- Die Profilbildung ist nur so vertrauenswürdig wie die Vereinheitlichung dahinter. Beispielsweise hängt der Wert des zusammengeführten Profils vollständig von der Qualität der Identitätsbestimmung im Vorfeld ab. Wenn ein Kunde über fragmentierte Identitäten in Quellsystemen verfügt, die nicht zusammengeführt wurden, sind die Profilattribute, die der Agent erhält, unvollständig oder stellen nur eine Teilansicht dar (z. B. “Lebenswert”, der mit Daten aus einem Kanal berechnet wird, aber nicht aus einem anderen).
- Verwenden Sie für verbundene Data 360-Flows das Element “Datensätze abrufen” mit einem Filter für die “recordId” oder “accountId” der aktuellen Sitzung, um nur den entsprechenden Profildatensatz abzurufen. Geben Sie nur die Attribute zurück, die für die nachgelagerte Aktion erforderlich sind. Geben Sie nicht das vollständige Profilobjekt zurück.
- Berechnete Statistiken müssen über Data 360-Aufnahmepipelines auf dem aktuellen Stand gehalten werden. Richten Sie Streaming oder Aktualisierungen nahezu in Echtzeit für Statistiken ein, die bei zeitkritischen Entscheidungen verwendet werden (z. B. Abwanderungsrisiko in einem Aufbewahrungs-Workflow). Batch-aktualisierte Statistiken sind für langsamere Attribute (z. B. die Vertragswertklasse pro Jahr) akzeptabel.
- Überprüfen Sie vor dem Aktionsaufruf, ob die zugeordneten Profilattribute ungleich null sind. Eine an eine Preisaktion übergebene Null “customerTier” ist so schädlich wie ein halluzinierter Wert. Verwenden Sie Flow-Entscheidungselemente, um fehlende Profildaten zu erkennen und an ein Ausweichobjekt weiterzuleiten, das entweder eine Standardeinstellung abruft oder zur Klarstellung auffordert.
- Ordnen Sie in der Unteragentenkonfiguration Profilattribute mithilfe aussagekräftiger, semantisch eindeutiger Variablennamen (z. B. “customerTier”, “lifetimeValueUSD”, “churnRiskScore”) Aktionseingabeparametern zu. Der LLM liest diese Namen beim Auswählen und Verfassen von Aktionen. Mehrdeutige Namen beeinträchtigen die Genauigkeit der Auswahl.
Fehlerbehandlung und -behebung
- Wenn ein erforderliches Profilattribut zum Zeitpunkt des Aktionsaufrufs null oder nicht verfügbar ist, sollte der Agent nicht mit einer möglicherweise falschen Standardeinstellung fortfahren. Die Aktion sollte einen strukturierten Fehler zurückgeben, der das fehlende Attribut angibt, und der Agent sollte den Benutzer entweder zur Klarstellung auffordern oder zu einer Person eskalieren, wenn er nicht unterhaltungsbasiert arbeitet.
- Wenn ein mit Data 360 verbundener Flow keine Profildaten abrufen kann (beispielsweise aufgrund einer Unterbrechung des Data 360-Service), sollte der Fehlerpfad des Flows einen strukturierten Fehler an den Agenten mit der spezifischen Fehlerursache zurückgeben. Der Agent kann dann entscheiden, ob er es erneut versuchen, mit einer verschlechterten Erfahrung fortfahren oder den Fehler dem Benutzer anzeigen möchte.
- Protokollieren Sie alle Profilattributwerte, die bei der Sitzungserstellung oder beim Aktionsaufruf eingegeben wurden, zusammen mit der Sitzungs-ID. Auf diese Weise wird sichergestellt, dass jede strittige Agentenentscheidung mit genau den Kundendaten rekonstruiert werden kann, die dem Agenten zu dem Zeitpunkt gegeben wurden.
Sicherheitsüberlegungen
- In den Agentenkontext eingefügte Profilattribute unterliegen denselben Datenzugriffssteuerungen wie alle CRM-Datensätze. Stellen Sie sicher, dass der Integrationsbenutzer oder die verbundene Anwendung, der bzw. die zum Auflösen von Profilattributen verwendet wird, nur über die für die anzuzeigenden Attribute erforderlichen Feldebenenberechtigungen verfügt und nicht über einen umfassenderen Profillesezugriff.
- Berechnete Statistiken, die sensible abgeleitete Kennzahlen codieren (z. B. prognostizierte Gesundheitsbewertung, finanzielle Risikostufe), sollten als sensible Felder behandelt werden und durch dieselben Zugriffssteuerungen wie die zugrunde liegenden Daten gesteuert werden. Wenn Sie einem Agenten, der in einem kundenorientierten Kontext arbeitet, eine hohe Abwanderungsrisikobewertung bereitstellen möchten, müssen Sie sorgfältig überlegen, was der Agent kommunizieren kann.
- Zeigen Sie keine Profilattribute an, die für die Aktion nicht erforderlich sind. Jedes zusätzliche Attribut im Kontextfenster des Agenten ist ein zusätzliches Datenelement, das in der Antwort des Agenten reproduziert werden könnte. Wenden Sie ein minimal erforderliches Prinzip auf die Profilbildung an.
- Überprüfen Sie alle Sitzungen, in denen berechnete Statistiken oder sensible Profilattribute als Eingaben eingefügt wurden. Diese Sitzungen stellen Entscheidungen dar, die auf der Grundlage abgeleiteter Kundenintelligenz getroffen werden, und unterliegen in bestimmten Branchen möglicherweise Erklärbarkeits- oder behördlichen Anforderungen.
Beispiel
Ein Telekommunikationsunternehmen verwendet Agentforce, um Aufbewahrungsunterhaltungen mit Kunden zu verarbeiten, die eine Stornierungsanforderung initiiert haben.
- Wenn ein Stornierungsvorgang geöffnet wird, wird die Agentensitzung mit der “accountId” des Kunden als Kontext erstellt.
- Die Konfiguration des Unteragenten ordnet Sitzungsvariablen zum Zeitpunkt der Erstellung drei Attribute des zusammengeführten Data 360-Profils zu: “customerTier” (Unternehmen), “lifetimeValueUSD” (42.000) und “contractRenewalDate” (60 Tage).
- Eine berechnete Statistik wie “churnRiskScore” (0,91, berechnet aus Nutzungsrückgang, Support-Ticket-Häufigkeit und NPS-Trend) wird als zusätzliche Sitzungsvariable über einen verbundenen Data 360-Flow zugeordnet, der als erster Aktionsschritt aufgerufen wird.
- Der Agent, der nun auf überprüften Kundenfakten basiert, ruft die Aktion “SelectRetentionOffer” auf. Da die Eingaben “customerTier = Enterprise”, “lifetimeValueUSD = 42000” und “churnRiskScore = 0,91” enthalten, gibt die Aktion das maximale Aufbewahrungsangebot und nicht ein Standardangebot zurück.
- Der Agent ruft “PresentOffer” auf, um das Angebot in der Unterhaltung bereitzustellen, und “LogRetentionAttempt”, um die Interaktion im CRM aufzuzeichnen, wobei alle grundierten Attribute für die Überprüfbarkeit beibehalten werden.
Kontext
Unternehmensdaten sind fragmentiert. Ein Agent, der nur auf das reagieren kann, was sich in der Salesforce Platform befindet, ist auf einen Bruchteil der Informationen beschränkt, die er für eine effektive Argumentation benötigt. Zum Beantworten einer Servicefrage muss möglicherweise das offene Ticket eines Kunden in Service Cloud gelesen werden. Zum Vorbereiten eines Vorschlags muss möglicherweise eine Datei aus Google Drive abgerufen werden. Zum Analysieren der Produktnutzung muss möglicherweise ein Data Warehouse abgefragt werden. Jedes dieser Systeme verfügt über seine eigenen APIs, sein eigenes Authentifizierungsmodell und sein eigenes Datenschema. Die Kosten für das Schreiben von maßgeschneidertem Integrationscode für jedes einzelne System haben die Verbindung zwischen Agenten in der Vergangenheit teuer und anfällig gemacht.
MCP ist ein offener Standard, der dies direkt angeht. Sie definiert eine einheitliche Oberfläche, über die ein Agent Tools finden und aufrufen kann, die von einem MCP-kompatiblen Server bereitgestellt werden, unabhängig vom zugrunde liegenden System. Jeder MCP-Server fungiert als Adapter: Sie umschließt die nativen Schnittstellen eines Zielsystems in einer standardisierten, toolorientierten Oberfläche, die der Agent abfragen, aufrufen und verfassen kann, ohne etwas über die spezifischen Protokolle oder Schemas des Systems zu wissen.
Aus Sicht des Agenten sehen die Verbindungen mit Slack, einer Datenbank mit strukturierter Abfragesprache (SQL) und einem Dokumentverwaltungssystem identisch aus. Dabei handelt es sich um drei MCP-Server, die jeweils eine Reihe beschriebener aufrufbarer Tools bereitstellen. Der Agent wählt sie anhand ihrer semantischen Beschreibungen und des Ziels, das er erreichen möchte, aus und sequenziert sie.
Probleme
Wenn ein Agent Informationen abrufen oder Aktionen über mehrere externe Systeme hinweg auslösen muss – jedes mit unterschiedlichen APIs, Authentifizierungen und Schemas –, wie kann er dann seine Funktionen ohne angepassten Integrationscode pro System oder enge Kopplung mit einer beliebigen Systemimplementierung erkennen, aufrufen und zusammenstellen?
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Muss der Agent Systeme außerhalb der Salesforce Platform erreichen, beispielsweise Dokumentspeicher, Tools für die Zusammenarbeit, Datenbanken oder SaaS-Drittanbieter, deren APIs nicht nativ als Agentforce-Aktionen dargestellt werden?
- Ist die Erkennung dynamischer Tools erforderlich, bei denen der Agent den richtigen Integrationsendpunkt zum Zeitpunkt der Überlegungen anhand der aktuellen Anforderung identifiziert, statt Integrationen in seiner Konfiguration hartcodiert zu haben?
- Ändert sich die Integrationslandschaft häufig; neue Systeme wurden hinzugefügt, bestehende aktualisiert und andere Änderungen können es erfordern, dass ein maßgeschneiderter Ansatz pro System zu einem nicht nachhaltigen Wartungsaufwand führt?
- Muss die Argumentationsebene des Agenten von den Implementierungsdetails der nachgelagerten Systeme getrennt werden, damit eine Änderung an der API eines Zielsystems keine Änderungen an den Anweisungen oder der Konfiguration des Unteragenten erfordert?
- Gehören die Zielsysteme unterschiedlichen Teams oder Anbietern, die jeweils für die Offenlegung ihrer eigenen Funktionen verantwortlich sind, wodurch ein anbieterseitiges MCP-Server-Modell praktischer wird als eine verbraucherseitige Integration pro Agent?
Anwendung für Salesforce-Muster
| Lösung | Passend | Kommentare |
|---|---|---|
| Salesforce MCP-Server | Optimal für Salesforce-Ökosystemziele | Wird verwendet, wenn sich das Zielsystem im Salesforce-Ökosystem befindet und ein MCP-Server des Erstanbieters verfügbar ist. Salesforce Headless 360 stellt MCP-Server für seine eigenen Plattformfunktionen bereit und stellt CRM-Daten, -Flows und -Plattformaktionen als MCP-kompatible Tools bereit. Reduziert den Implementierungsaufwand auf die Konfiguration und nicht auf die Entwicklung. Notiz: Derzeit unterstützen Salesforce MCP-Server nur Endbenutzeranmeldeinformationen für die Authentifizierung und Autorisierung. |
| Benutzerdefinierte MuleSoft-MCP-Server | Am besten, wenn kein Erstanbieter-MCP-Server vorhanden ist | Die Verwendung für ältere Systeme, proprietäre interne Anwendungen oder SaaS-Plattformen von Drittanbietern ist vor dem MCP-Standard. Wenn ein Zielsystem keinen eigenen MCP-Server bereitstellt, kann eine MuleSoft-Integrationsebene in einen benutzerdefinierten MCP-Server eingeschlossen werden, der die Funktionen des Systems als Tools bereitstellt. Sie kann auch mit Salesforce-APIs verwendet werden, wenn MCPs erforderlich sind, damit Agenten nur mit Systembenutzeranmeldeinformationen verwendet werden können. MuleSoft übernimmt die Protokollübersetzung, -authentifizierung und -datentransformation. Die MCP-Ebene macht das Ergebnis für Agenten erkennbar. |
| Drittanbieter-MCP-Server | Bestens geeignet für Rohstoffsysteme mit aktiven MCP-Ökosystemen | Für Ihre Plattform (GitHub, Google Workspace) ist ein vom Anbieter verwalteter MCP-Server vorhanden, der die Sicherheits- und Wartungsanforderungen erfüllt. Immer mehr Unternehmensplattformen wie GitHub, Google Workspace und andere veröffentlichen ihre eigenen MCP-Server. Wenn ein produktionsbereiter, vom Anbieter verwalteter Server vorhanden ist, ziehen Sie ihn dem Erstellen eines benutzerdefinierten Servers vor. Bewerten Sie den Sicherheitsstatus und das Wartungsengagement vor der Übernahme. |
Skizze
Sequenzdiagramm für die überprüfte Kundenkontextinjektion
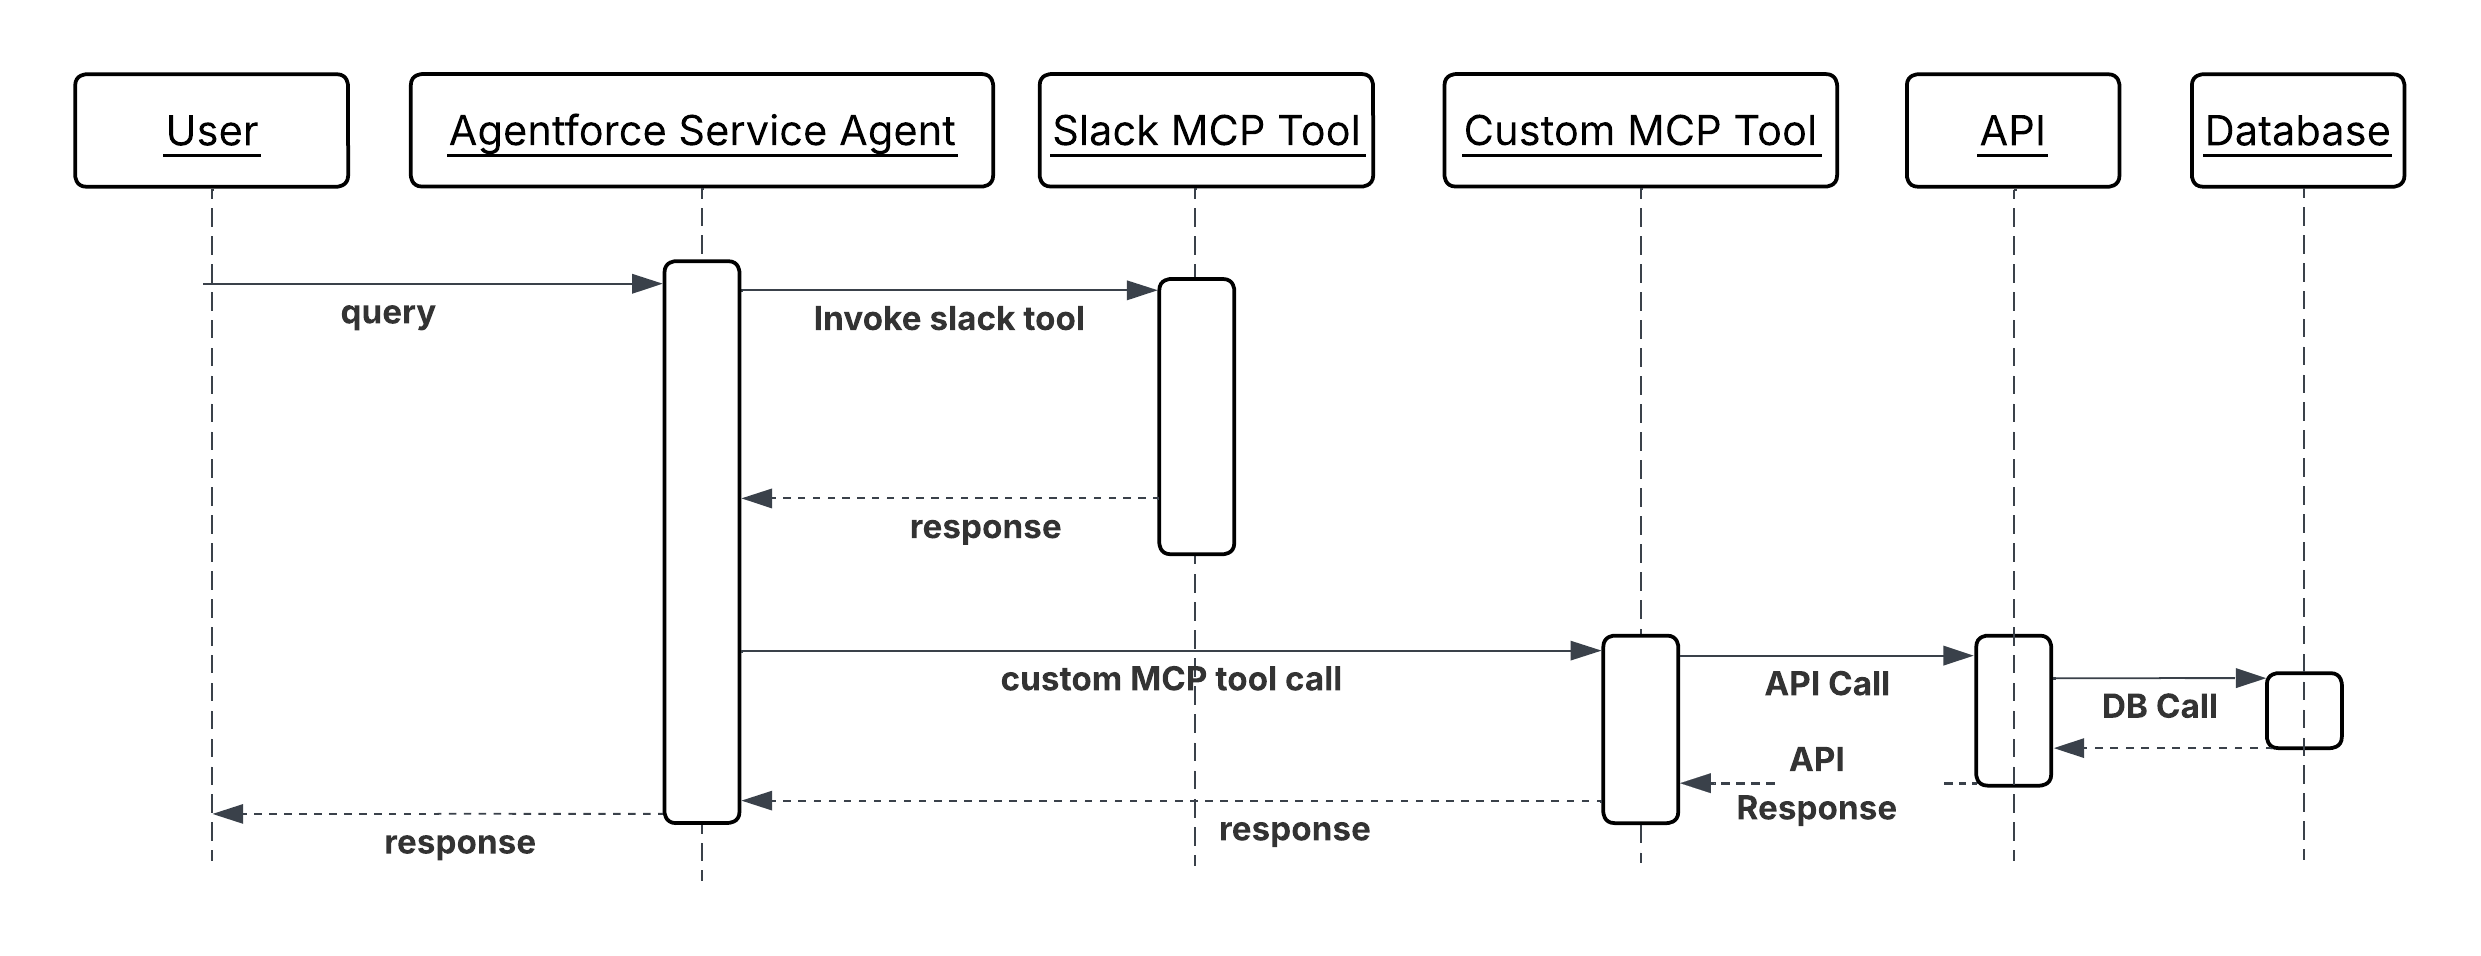
Ergebnisse
Die erreichbare Oberfläche des Agenten wird erweitert, ohne die Integrationskomplexität zu erhöhen. Wenn Sie ein neues externes System hinzufügen, müssen Sie dafür einen MCP-Server bereitstellen oder konfigurieren und keine maßgeschneiderten Apex Callouts oder Flow-Integrationen pro Agent schreiben. Die Argumentationsebene des Agenten bleibt unverändert. Sie erkennt die neuen Tools und ruft sie allein anhand ihrer semantischen Beschreibungen auf.
Der MCP-Standard erstellt auch eine saubere Trennung der Inhaberschaft: Das für ein System verantwortliche Team stellt seine Funktionen als MCP-Server bereit. Das Agententeam nutzt diese Funktionen, ohne die internen Funktionen des Systems verstehen zu müssen. Diese Grenze reduziert den Koordinationsaufwand mit zunehmender Anzahl integrierter Systeme.
Die Zusammensetzbarkeit von Tools ist ein direktes Ergebnis. Da alle Tools dieselbe Aufrufoberfläche verwenden, kann der Agent Tools aus unterschiedlichen Systemen verketten, eine Datei aus Google Drive abrufen, Daten daraus extrahieren und das Ergebnis in einen CRM-Datensatz schreiben, so natürlich wie Verkettungsaktionen innerhalb eines Systems.
Überlegungen zum Design
Plattformunabhängige Anleitung
- Toolbeschreibungen sind die einzige Grundlage für den Agenten, um zu entscheiden, ob und wie ein Tool aufgerufen werden soll. Schreiben Sie Beschreibungen in einer klaren, intent-basierten Sprache, in der angegeben ist, was das Tool tut, wann es angewendet wird und was es zurückgibt. Eine Beschreibung, in der es heißt “fragt die CRM-Datenbank ab”, ist weniger nützlich als “ruft die offenen Kundenvorgänge des Accounts nach Priorität sortiert für eine bestimmte Account-ID ab”. Schlechte Beschreibungen führen zu einer schlechten Toolauswahl.
- Begrenzen Sie jedes MCP-Tool auf eine einzelne atomare Funktion. Ein Tool, das ein Dokument abruft und auch eine Zusammenfassung in das Quellsystem zurückschreibt, ist für den Agenten schwieriger zu überlegen, bei Fehlern schwerer zu wiederholen und schwerer zu schützen als zwei separate Tools. Ein Werkzeug, eine Verantwortung.
- Entwerfen Sie Tools so, dass Ausgaben zusammengesetzte Eingaben sind. Das Ergebnis eines Abruftools sollte so strukturiert sein, dass es auf natürliche Weise den Eingabeparametern der Aktionstools zugeordnet wird, die in der Regel darauf folgen, wodurch die Transformationsarbeit reduziert wird, die der Agent zwischen den Schritten ausführen muss.
- Remote-Host-MCP-Server. Lokale Binärinstallationen verursachen eine Bereitstellungs- und Versionierungskomplexität, die mit der Anzahl der Agentenumgebungen wächst. Ein remote gehosteter Server kann unabhängig von den Agenten aktualisiert werden, die ihn verwenden.
Salesforce-Implementierungshinweise
- Wenn Sie eine konsistente MCP-Authentifizierung, eine Ratenobergrenze und Nutzlastvalidierungen für alle ausgehenden MCP-Aufrufe wünschen, verwenden Sie das AI-Gateway wie MuleSoft Omni Gateway, das MCP-Server unterstützt, und konfigurieren Sie es, bevor Sie Agenten einen MCP-Server bereitstellen.
- Verwenden Sie OAuth 2.0-Anmeldeinformationen für alle für MCP-Server-Verbindungen erforderlichen Anmeldeinformationen. Anmeldeinformationen dürfen nicht in Toolparametern, Aktionskonfigurationen oder Apex Code angezeigt werden.
- Einige MCP-Tools benötigen möglicherweise Endbenutzeranmeldeinformationen, um je nach Geschäftsanwendungsfall (z. B. Mittelübertragung) einige Aktionen ausführen zu können. Verwenden Sie zum Übertragen von Endbenutzer-Identitätstoken die Richtlinie OAuth 2.0 Im Namen der Injektion von Anmeldeinformationen, die derzeit von MuleSoft Omni Gateway unterstützt wird.
- Für benutzerdefinierte MuleSoft-MCP-Server: Definieren Sie das MCP-Toolschema in der API-Spezifikation von MuleSoft und registrieren Sie den Endpunkt des Servers im Agentforce Toolkatalog. Testen Sie Toolbeschreibungen anhand von repräsentativen Agentenabfragen, um sicherzustellen, dass der Agent das richtige Tool für die richtige Aufgabe auswählt, bevor er sie in der Produktion bereitstellt.
Fehlerbehandlung und -behebung
- Wenn ein MCP-Tool-Aufruf einen Fehler zurückgibt, überprüft der Agent den maschinenlesbaren Fehlercode, um die entsprechende Wiederherstellungsaktion zu ermitteln: Anfordern fehlender Parameter vom Benutzer, erneuter Versuch mit korrigierter Eingabe oder Eskalation zu einem Menschen. Sie verwendet niemals stillschweigend Fehler oder führt die Argumentation fort, als ob der Tool-Aufruf erfolgreich war.
- Der Agent implementiert die Wiederholungslogik für vorübergehende Fehler direkt.
- Protokollieren Sie jeden Aufruf des MCP-Tools auf Client-Seite mit dem Toolnamen, den bereinigten Eingabeparametern und dem Ergebnis. Diese clientseitige Verfolgung in Kombination mit serverseitigen Protokollen ist der primäre Mechanismus zur Diagnose, warum ein Agent einen bestimmten Aktionspfad eingeschlagen hat, wenn ein Workflow nicht das erwartete Ergebnis liefert.
Sicherheitsüberlegungen
- Alle ausgehenden MCP-Serververbindungen werden über das Gateway geleitet. Das Gateway erzwingt die Überprüfung der Authentifizierung, die Ratenbegrenzung, um Werkzeugmissbrauch zu verhindern, und die Nutzlastüberprüfung, um Eingabeversuche in Werkzeugparametern zu erkennen. Direkte, nicht vermittelte Verbindungen von Agenten zu MCP-Servern umgehen diese Steuerelemente und sind nicht zulässig.
- Grenzen Sie die MCP-Serververbindungen jedes Agenten nur auf die Server ein, deren Tools der Agent tatsächlich benötigt. Ein Agent, der mit Zugriff auf alle verfügbaren MCP-Server konfiguriert ist, verfügt über eine größere Angriffsfläche als ein Agent, der nur mit den Tools verbunden ist, die seine definierten Aufgaben erfordern.
- Validieren und bereinigen Sie die Eingabeparameter des Tools, bevor Sie sie an das Tool übergeben, insbesondere wenn Parameterwerte aus vom Benutzer bereitgestelltem Text oder LLM-generiertem Inhalt stammen. Übergeben Sie nicht validierte LLM-Ausgaben nicht direkt als Tool-Parameter. Ein Angreifer, der die Argumentation des Agenten beeinflussen kann, kann diesen Pfad verwenden, um schädliche Werte in nachgelagerte Systemaufrufe einzuschleusen.
- Behandeln Sie die Liste der verbundenen MCP-Server und deren Tool-Inventare als sensible Konfiguration. Ein Angreifer, der weiß, welche Tools einem Agenten zur Verfügung stehen und welche Parameter er akzeptiert, verfügt über eine Zuordnung zum Erstellen von Eingabeaufforderungs-Nutzlasten, mit denen diese Tools missbraucht werden sollen.
Beispiel
Ein Vertriebsagent bereitet eine umfassende Accountbesprechung vor, bevor ein Kundenanruf von hohem Wert erfolgt:
- Der Agent erhält die folgende Anforderung: “Bereiten Sie eine Besprechung über Acme Corp. vor, bevor morgen über die Verlängerung diskutiert wird.”
- Der Agent fragt den MCP-Toolkatalog ab und identifiziert drei relevante Tools auf zwei MCP-Servern:
GetRecentEmails,GetOpenOpportunitiesundGetSupportTicketSummary. - Der Agent ruft alle drei Tools parallel auf. Jeder MCP-Server übersetzt den Aufruf in die native API seines Zielsystems, ruft die relevanten Daten ab und gibt ein strukturiertes Ergebnis zurück.
- Der Agent erhält die drei Ergebnisse. Aktuelle E-Mail-Threads, die offene Verlängerungs-Opportunity mit Geschäftsvolumen und -phase sowie eine Zusammenfassung der offenen Support-Tickets nach Priorität und fasst sie zu einer strukturierten Account-Briefing zusammen.
- Der Agent ruft
CreateAccountNoteauf, um die Einweisung im Accountdatensatz zu speichern, und gibt dem anfordernden Benutzer eine Zusammenfassung zurück. - Alle vier Aufrufe von MCP-Tools werden vom Gateway mit Toolnamen, Serveridentitäten und Ergebnissen für den Sitzungsüberprüfungsdatensatz protokolliert.
Kontext
Das ausgehende MCP-Muster beschreibt einen Agentforce-Agenten, der Tools von externen MCP-Servern verwendet. Das eingehende Muster kehrt dies um. Salesforce Platform-Funktionen wie CRM-Datensätze, Flows, Apex-Logik und Data 360-Statistiken werden als MCP-Tools angezeigt, die externe Agenten in einem beliebigen LLM-Framework entdecken und aufrufen können.
Dieses Muster ist wichtig, da Enterprise AI-Bereitstellungen selten aus einem Guss bestehen. Der auf einem anderen Framework basierende Agent eines Partners muss möglicherweise den Accountstatus eines Kunden in Salesforce nachschlagen. Ein internes Data Science-Team, das einen Python-basierten Agenten ausführt, muss möglicherweise einen Salesforce-Flow auslösen, um einen Genehmigungsprozess zu starten. Ohne standardisierten Belichtungsmechanismus benötigt jeder externe Verbraucher eine maßgeschneiderte Integration. Durch die Bereitstellung von Salesforce-Funktionen als MCP-Server erhält jeder MCP-kompatible Agent eine einheitliche, auffindbare Oberfläche für die Tools der Plattform, unabhängig davon, wie der aufrufende Agent erstellt ist.
Beispielsweise muss der Beschaffungsagent eines Partners, der auf einem Drittanbieter-Framework basiert, den Vertragsstatus eines Lieferanten in Salesforce überprüfen, bevor er einen Auftrag genehmigt. Statt eine direkte REST-Integration zu erstellen, wird ein GetContractStatus auf dem Salesforce MCP-Server aufgerufen. Das Tool erzwingt dieselben Zugriffssteuerungen wie alle nativen Salesforce-Vorgänge. Dem aufrufenden Agenten wird nur das Ergebnis angezeigt.
Probleme
Wenn ein externer Agent, der auf einem anderen Framework basiert, einem Partner gehört oder anderweitig außerhalb der Salesforce Platform ausgeführt wird, Salesforce-Funktionen als Teil seines eigenen Workflows aufrufen muss, wie können diese Funktionen auf standardisierte, auffindbare und sicher gesteuerte Weise verfügbar gemacht werden, die keine maßgeschneiderte Integration pro externem Verbraucher erfordern?
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Basieren die externen Agenten, die Salesforce-Funktionen nutzen müssen, auf Frameworks, die den MCP-Standard unterstützen? Andernfalls ist eine REST-API oder ein Webhook-Ansatz möglicherweise besser geeignet als MCP.
- Welche Salesforce-Funktionen müssen verfügbar gemacht werden – schreibgeschützter Datenabruf, Schreibvorgänge, Flow-Aufrufe oder eine Kombination? Der Umfang der Exposition bestimmt direkt den Sicherheitsbereich, der geregelt werden muss.
- Wie sollte die Identität des externen Anrufagenten überprüft werden und unter welchen Salesforce-Berechtigungen sollten seine Aufrufe ausgeführt werden? Für Anrufe zwischen Agenten und Plattformen dürfen keine umfassenderen Berechtigungen übernommen werden, als für den jeweiligen Vorgang erforderlich.
- Ist der Salesforce MCP-Server für interne Verbraucher (Agenten anderer Teams innerhalb derselben Organisation) oder externe Verbraucher (Partner- und Kundenagenten) vorgesehen? Das Trust Model und die Authentifizierungsanforderungen unterscheiden sich erheblich zwischen diesen Zielgruppen.
- Wie wird sich der Satz an verfügbaren Tools im Laufe der Zeit entwickeln? Neue Salesforce-Funktionen, die dem MCP-Server hinzugefügt wurden, können sofort von allen verbundenen Agenten erkannt werden. Die Offenlegung nicht beabsichtigter Tools muss durch einen bewussten Veröffentlichungsprozess gesteuert werden.
Anwendung für Salesforce-Muster
| Lösung | Passend | Kommentare |
|---|---|---|
| Salesforce als MCP-Server (nativ) | Bestens geeignet für die Bereitstellung von Salesforce-Funktionen von Erstanbietern | Wird verwendet, wenn die anzuzeigenden Tools direkt vorhandenen Salesforce Platform-Vorgängen zugeordnet werden und die aufrufenden Agenten MCP-kompatibel sind. Mit der nativen MCP-Serverfunktion von Salesforce Headless 360 können Plattformvorgänge wie Datensatzabfragen, Flow-Aufrufe und Apex-Aktionen als MCP-Tools deklariert und allen mit MCP kompatiblen externen Agenten zur Verfügung gestellt werden. Der Zugriff wird durch das Salesforce-Berechtigungsmodell gesteuert. Beachten Sie, dass derzeit nur mit Endbenutzeranmeldeinformationen auf diese Headless 360-MCP-Server zugegriffen werden kann. |
| MuleSoft als MCP-Server-Fassade | Am besten, wenn Transformation oder Multi-System-Aggregation erforderlich ist | Wird verwendet, wenn der anrufende Agent eine Funktion benötigt, die Daten aus mehr als einem Salesforce-Objekt, eine Transformation vor der Zustellung oder die Zusammensetzung mit Daten aus anderen Systemen erfordert. Die MCP-Schnittstelle bleibt übersichtlich und einfach. Die Komplexität wird von MuleSoft absorbiert. Eine MuleSoft-MCP-Ebene befindet sich vor Salesforce und stellt das aggregierte Ergebnis mehrerer Plattformvorgänge als einzelnes MCP-Tool bereit. Diese Lösung kann auch von Agenten verwendet werden, bei denen die Endbenutzeridentität nicht für die Salesforce-Authentifizierung und -Autorisierung übernommen werden kann. Wenn Agentforce Agenten beispielsweise MCP-Server mit Systemanmeldeinformationen benötigen, müssen wir uns auf benutzerdefinierte MCP-Server verlassen, beispielsweise auf einen mit MuleSoft erstellten und gehosteten. |
Skizze
Sequenzdiagramm für Geschäftsfunktionen als aufrufbares Tool
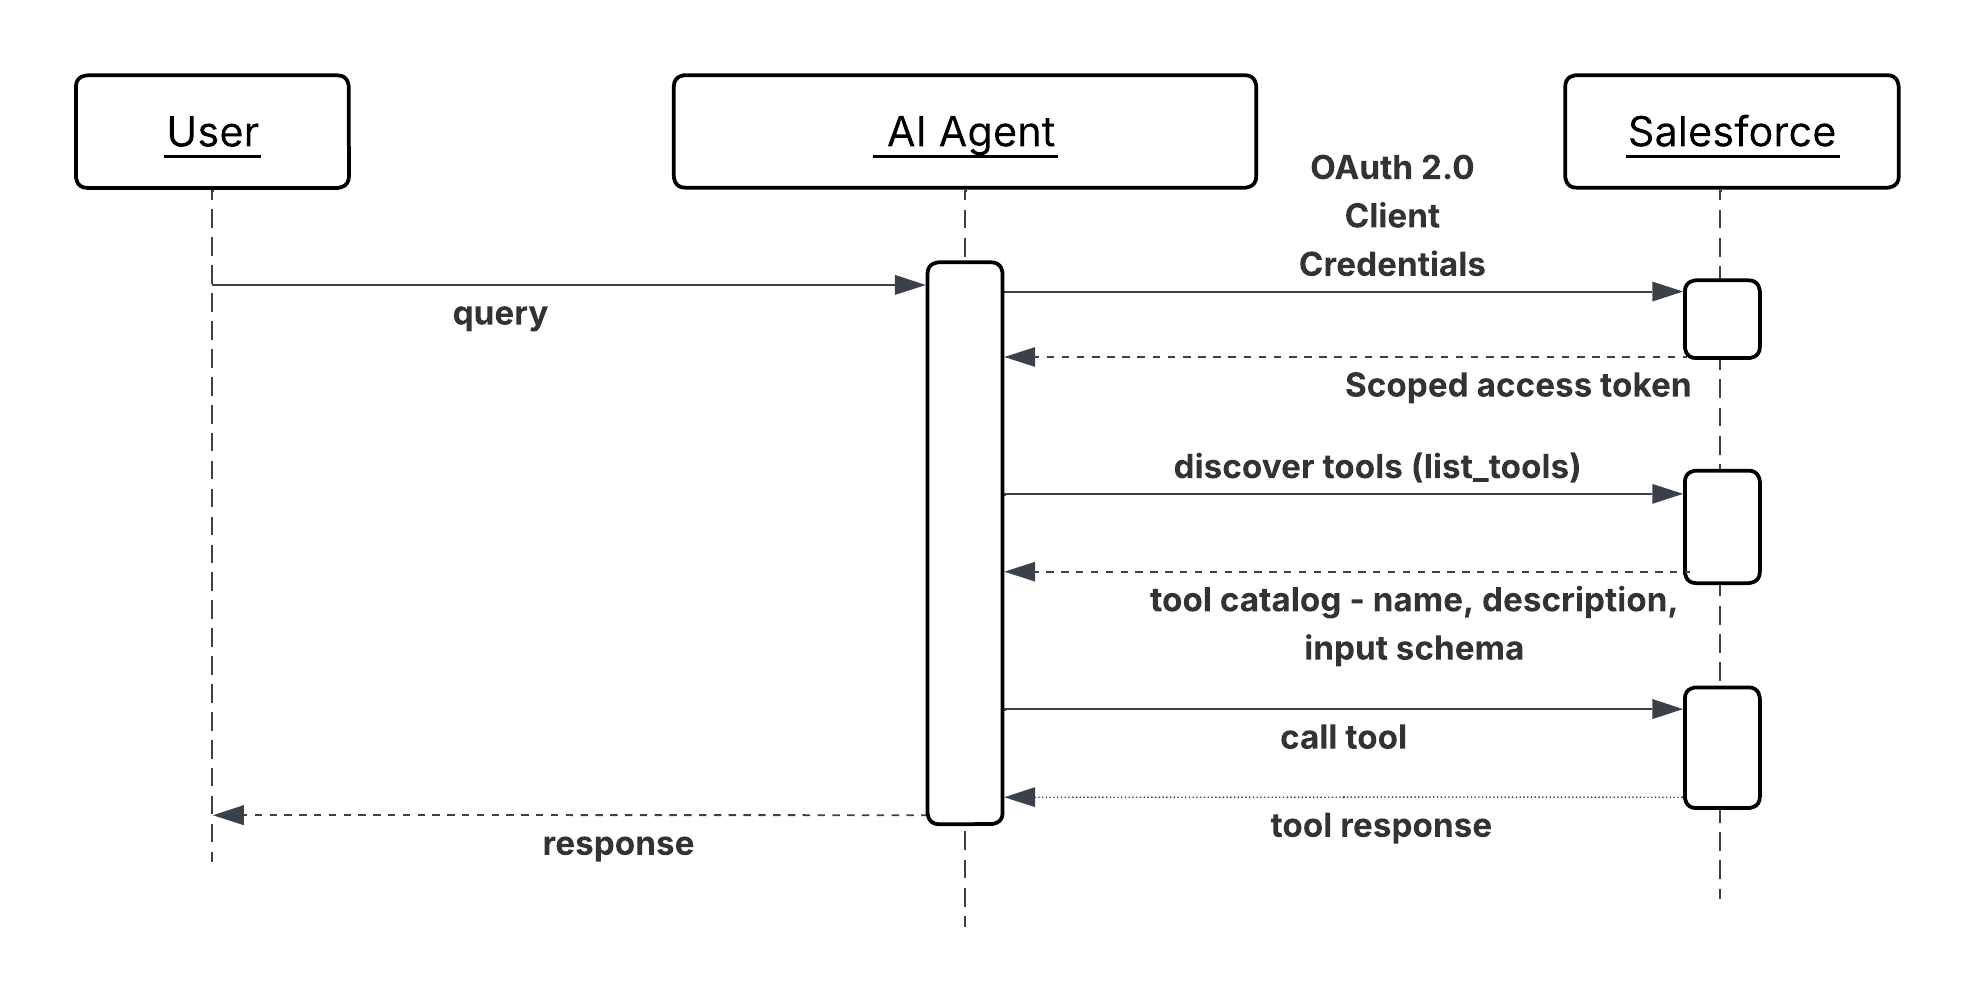
Ergebnisse
Salesforce wird ein erstklassiger Teilnehmer an Ökosystemen für mehrere Anbieter. Externe Agenten können Plattformfunktionen entdecken und nutzen, ohne dass eine benutzerdefinierte REST-Integration pro Verbraucher oder Anwendungsfall erforderlich ist. Die Anzahl der Verbraucher kann wachsen, ohne dass der Aufwand für die Integrationswartung proportional steigt.
Bei Headless 360 regelt das Salesforce-Berechtigungsmodell jeden eingehenden Tool-Aufruf. Externe MCP-Clients umgehen vorhandene Datenzugriffssteuerungen nicht. Sie funktionieren innerhalb dieser. Das bedeutet, dass die Sicherheitsposition der Bereitstellung von Funktionen über MCP der Offenlegung über eine andere authentifizierte API-Oberfläche entspricht.
Die Auffindbarkeit von Werkzeugen ist ein zusammengesetzter Vorteil. Wenn dem Toolkatalog des MCP-Servers neue Salesforce-Funktionen hinzugefügt werden, stehen sie sofort allen verbundenen externen Agenten zur Verfügung, ohne dass diese Agenten ihre Konfigurationen aktualisieren müssen.
Überlegungen zum Design
Plattformunabhängige Anleitung
- Veröffentlichen Sie nur das, was externe Agenten benötigen. Jedes Tool, das dem Katalog des MCP-Servers hinzugefügt wird, erweitert die Angriffsfläche und den Verwaltungsaufwand. Überprüfen Sie den Werkzeugbestand bewusst. Definieren Sie, welche Funktionen für die externe Nutzung genehmigt werden, und behandeln Sie die nicht genehmigte Offenlegung als Konfigurationslücke und nicht als Standard.
- Schreiben Sie Toolbeschreibungen für externe Verbraucher. Der Operator eines externen Agenten hat keine Knowledge über Ihr internes Datenmodell oder Ihre Benennungskonventionen. Halten Sie Beschreibungen in sich: was das Tool macht, was die einzelnen Parameter bedeuten, was das Ergebnis darstellt und welche Einschränkungen oder Voraussetzungen der Aufrufer erfüllen muss.
- Versionstools explizit, wenn sich ihre Eingabe- oder Ausgabeschemas ändern. Ein externer Agent, der vom aktuellen Schema eines Tools abhängt, wird stillschweigend beschädigt, wenn sich das Schema ohne vorherige Ankündigung ändert. Behandeln Sie fehlerhafte Änderungen an der Oberfläche eines MCP-Tools mit derselben Disziplin wie fehlerhafte Änderungen an einer öffentlichen REST-API.
Salesforce-Implementierungshinweise
- Führen Sie jeden eingehenden Aufruf des MCP-Tools (Headless 360) von Salesforce Out-of-the-Box (OOTB) unter einem Endbenutzer aus, dessen Berechtigungen nur auf die Vorgänge beschränkt sind, die für die angezeigten Tools erforderlich sind. Führen Sie keine eingehenden Agentenaufrufe unter einer Administratoridentität mit hohen Berechtigungen aus.
- Verwenden Sie das AI-Gateway wie MuleSoft Omni Gateway, um die Authentifizierung, die Ratenbegrenzung, die Schemavalidierung und die Erkennung personenbezogener Daten (Personally Identifiable Information, PII) konsistent auf alle MCP-Tools anzuwenden.
- Definieren Sie für MuleSoft-MCP-Fassaden das MCP-Toolschema in MuleSoft unabhängig vom zugrunde liegenden Salesforce-API-Schema. Die MCP-Schnittstelle sollte die konzeptionellen Anforderungen des aufrufenden Agenten widerspiegeln und nicht die Form des Salesforce-Objekts, das sie unterstützt. Durch diese Entkopplung kann sich die Salesforce-Implementierung weiterentwickeln, ohne den Vertrag für externe Tools zu verletzen.
Fehlerbehandlung und -behebung
- Fehler beim Toolaufruf müssen strukturierte MCP-Fehlerantworten mit einem maschinenlesbaren Code und einer Beschreibung in einfacher Sprache zurückgeben. Der aufrufende externe Agent hat keinen Einblick in die internen Daten der Salesforce Platform, da Fehlermeldungen in sich geschlossen und handlungsrelevant sein müssen, ohne dass Knowledge über Salesforce-spezifische Fehlercodes oder Objektmodelle erforderlich ist.
- Ratenobergrenzenfehler und Authentifizierungsfehler müssen umgehend mit genügend Informationen zurückgegeben werden, damit der Operator des externen Agenten diagnostizieren und beheben kann, welche Ratenobergrenze erreicht wurde oder welche Anmeldeinformationen abgelehnt wurden, ohne interne Konfigurationsdetails offenzulegen.
- Protokollieren Sie alle eingehenden MCP-Tool-Aufrufe im Omni-Gateway mit der Identität des aufrufenden Agenten, dem aufgerufenen Tool, den Eingabeparametern (mit Bereinigung vertraulicher Werte) und dem Ergebnis. Dieses Protokoll ist der primäre Nachweis für die Diagnose von Fehlern, die von externen Verbrauchern gemeldet wurden, und für die Überprüfung, auf welche externen Agenten zugegriffen wurde.
Sicherheitsüberlegungen
- Jede eingehende MCP-Verbindung muss sich authentifizieren, bevor ein Tool erreichbar ist. Lassen Sie keine nicht authentifizierte Entdeckung des Toolkatalogs zu. Die Liste der bereitgestellten Funktionen enthält selbst vertrauliche Informationen.
- Wenden Sie zusätzlich zur Authentifizierung auf Verbindungsebene die Autorisierung auf Werkzeugebene an. Ein registrierter externer Agent sollte nur die spezifischen Tools aufrufen können, auf die er explizit Zugriff erhalten hat, nicht den vollständigen Katalog. Erzwingen Sie dies am Gateway, nicht auf der Anwendungsebene.
- Validieren und bereinigen Sie alle eingehenden Tool-Parameter, bevor Sie sie an Salesforce Platform-Vorgänge übergeben. Parameter von externen Agenten sind eine nicht vertrauenswürdige Eingabeoberfläche. Ein in böser Absicht erstellter Parameter könnte versuchen, Abfragefilter zu überschreiben, SOQL-Fragmente (Salesforce Object Query Language) einzufügen oder Flow-Variablen zu beeinflussen. Validieren Sie Typ, Format und Bereich an der MCP-Server- oder Fassadengrenze.
- Führen Sie eine regelmäßige Zugriffsüberprüfung registrierter externer Verbraucher durch. Widerrufen Sie die Anmeldeinformationen für Agenten, die nicht mehr aktiv sind oder deren Zugriffsumfang geändert wurde. Eine ruhende, aber gültige Anmeldeinformation für eine außer Betrieb genommene Partnerintegration ist ein unnötiges Dauerrisiko.
- Schützen Sie sich vor Verstößen gegen Plattformobergrenzen, indem Sie eingehende MCP-Nachrichten im Gateway auf Raten begrenzen. Begrenzen Sie den Datenverkehr von nicht kritischen Agenten unter Last mithilfe von SLA-basierten Stufenrichtlinien.
Beispiel
Ein von einem Logistikpartner betriebener Beschaffungsagent muss den Vertrags- und Kreditstatus eines Lieferanten überprüfen, bevor er einen Auftrag mit hohem Wert genehmigt:
- Der Agent des Partners authentifiziert sich beim Gateway mit seinen registrierten OAuth 2.0-Client-Anmeldeinformationen und erhält ein Zugriffstoken mit Umfang.
- Der Agent fragt den Toolkatalog des Salesforce MCP-Servers ab und identifiziert zwei relevante Tools:
GetSupplierContractStatusundGetAccountCreditSummary. - Der Agent ruft
GetSupplierContractStatusmit der Kennung des Lieferanten auf. Der MCP-Server übersetzt dies in eine Salesforce-Datensatzabfrage, wendet die Feldebenensicherheit des Integrationsbenutzers an und gibt den aktuellen Status des Vertrags, das Ablaufdatum und alle gekennzeichneten Compliance-Vorgaben zurück. - Der Agent ruft
GetAccountCreditSummaryauf, das über die MuleSoft-MCP-Fassade weitergeleitet wird. Die Fassade aggregiert den ausstehenden Rechnungssaldo und den Zahlungsverlauf des Lieferanten aus zwei Salesforce-Objekten und gibt eine einzelne zusammengesetzte Gutschriftszusammenfassung zurück. - Mit beiden Ergebnissen bestimmt der Agent des Partners, ob der Vertrag aktiv ist und die Gutschriftsposition innerhalb akzeptabler Grenzen liegt, und genehmigt den Auftrag in seinem eigenen System.
- Beide Tool-Aufrufe werden vom Gateway mit der Identität des Partneragenten, den aufgerufenen Tools und den Ergebnissen protokolliert, wodurch ein überprüfbarer Datensatz darüber erstellt wird, welcher externe Zugriff gewährt wurde und welche Daten zurückgegeben wurden.
Kontext
Enterprise-Systeme basieren nun auf der Bearbeitung von gemeinschaftlichen Agenten oder Netzwerken, in denen komplexe Anforderungen zerlegt und an spezialisierte Agenten über verschiedene Domänen oder Anbieterplattformen hinweg delegiert werden. Diese Agenten, die jeweils über ihre eigene Rolle, Funktionen und Tools verfügen, benötigen eine standardisierte, sichere Kommunikationsmethode, um sich auf gemeinsame Ziele zu koordinieren, ohne dass bei jedem Schritt ein menschliches Eingreifen erforderlich ist.
Probleme
Wie kann ein aufrufender AI-Agent komplexe oder domänenspezifische Aufgaben dynamisch erkennen, sicher damit interagieren und an einen Remote-Peer-Agenten delegieren, der auf einem anderen Framework basieren oder von einem anderen Anbieter betrieben wird und strukturierte Ergebnisse erhält, um einen größeren Unternehmens-Workflow abzuschließen?
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Wie interagieren Agenten, die mit verschiedenen Frameworks entwickelt wurden oder über isolierte Anwendungsbereiche hinweg arbeiten?
- Wie können Agenten zusammenarbeiten und Aufgaben delegieren, ohne ihre interne Logik, ihren Arbeitsspeicher oder ihre proprietären Tools offenzulegen?
- Wie unterstützen Agenten komplexe, langfristige Aufgaben und bieten gleichzeitig Echtzeit-Statusaktualisierungen, Streaming und Push-Benachrichtigungen?
- Wie erzwingen Agenten die Sicherheit auf Unternehmensebene (Authentifizierung, Autorisierung) und die Richtlinieneinhaltung für die agentenübergreifende Kommunikation?
- Wie handhaben Agenten strukturierte Aufgaben-Workflows (Initiierung, Fortschritt, Abschluss), die über einfache API-Aufrufe hinausgehen?
Anwendung für Salesforce-Muster
Das A2A-Protokoll ist ein offener Standard, mit dem Agenten andere Agenten als gleichrangige Personen entdecken, delegieren und mit ihnen zusammenarbeiten können. Sie bietet Agenten eine gemeinsame Sprache, um Informationen sicher auszutauschen und Aktionen zwischen verschiedenen Plattformen und Anbietern zu koordinieren. A2A konzentriert sich auf die Peer-to-Peer-Kommunikation und ergänzt MCP, das sich auf die Verbindung von Agenten mit Tools und APIs konzentriert.
| Lösung | Passend | Kommentare |
|---|---|---|
| Multi-Agent-Orchestrierung (SOMA) für einzelne Organisationen | Am besten, wenn alle Domänenagenten in einer Organisation leben und keine anbieterübergreifende Weiterleitung erforderlich ist | Ein Superagent (Orchestrator) zerlegt Anforderungen und leitet sie mithilfe der LLM-basierten Weiterleitung (Atlas Reasoning Engine liest Unteragentenbeschreibungen) oder der deterministischen Weiterleitung (Agentenskript) an bis zu 7 verbundene Unteragenten weiter. Dies ist das standardmäßig empfohlene Muster, bevor Sie nach A2A greifen. Unterstützte Kombinationen: Agentforce Serviceagent→Agentforce Serviceagent Agentforce Mitarbeiteragent→ Agentforce Mitarbeiteragent Agentforce Mitarbeiteragent→Agentforce Serviceagent Nur der Orchestrierer kann zu einem Menschen eskalieren, Unteragenten nicht. |
| Delegation mehrerer Agenten unter Leitung des Orchestrators | Bestens geeignet für komplexe Workflows, die mehrere spezialisierte Agenten erfordern | Wird verwendet, wenn sich der Workflow über mehrere Domänen erstreckt, beispielsweise Beschaffung, Überprüfung und Genehmigung, die jeweils einem anderen Agenten gehören. Ein Orchestriereragent zerlegt die Anforderung der obersten Ebene und delegiert Teilaufgaben nacheinander oder parallel an zwei oder mehr gleichrangige Agenten. Jeder Peer-Agent führt seine spezialisierte Domänenfunktion aus und gibt ein Artefakt zurück. Der Orchestrierer aggregiert die Ergebnisse und führt den nächsten Schritt aus. |
Skizze
Die Architektur besteht darin, dass ein aufrufender Agent die Kommunikation initiiert, was durch einen Agentenkatalog/eine Agentenregistrierung zur Erkennung erleichtert wird:
Sequenzdiagramm für die agentenübergreifende Delegation
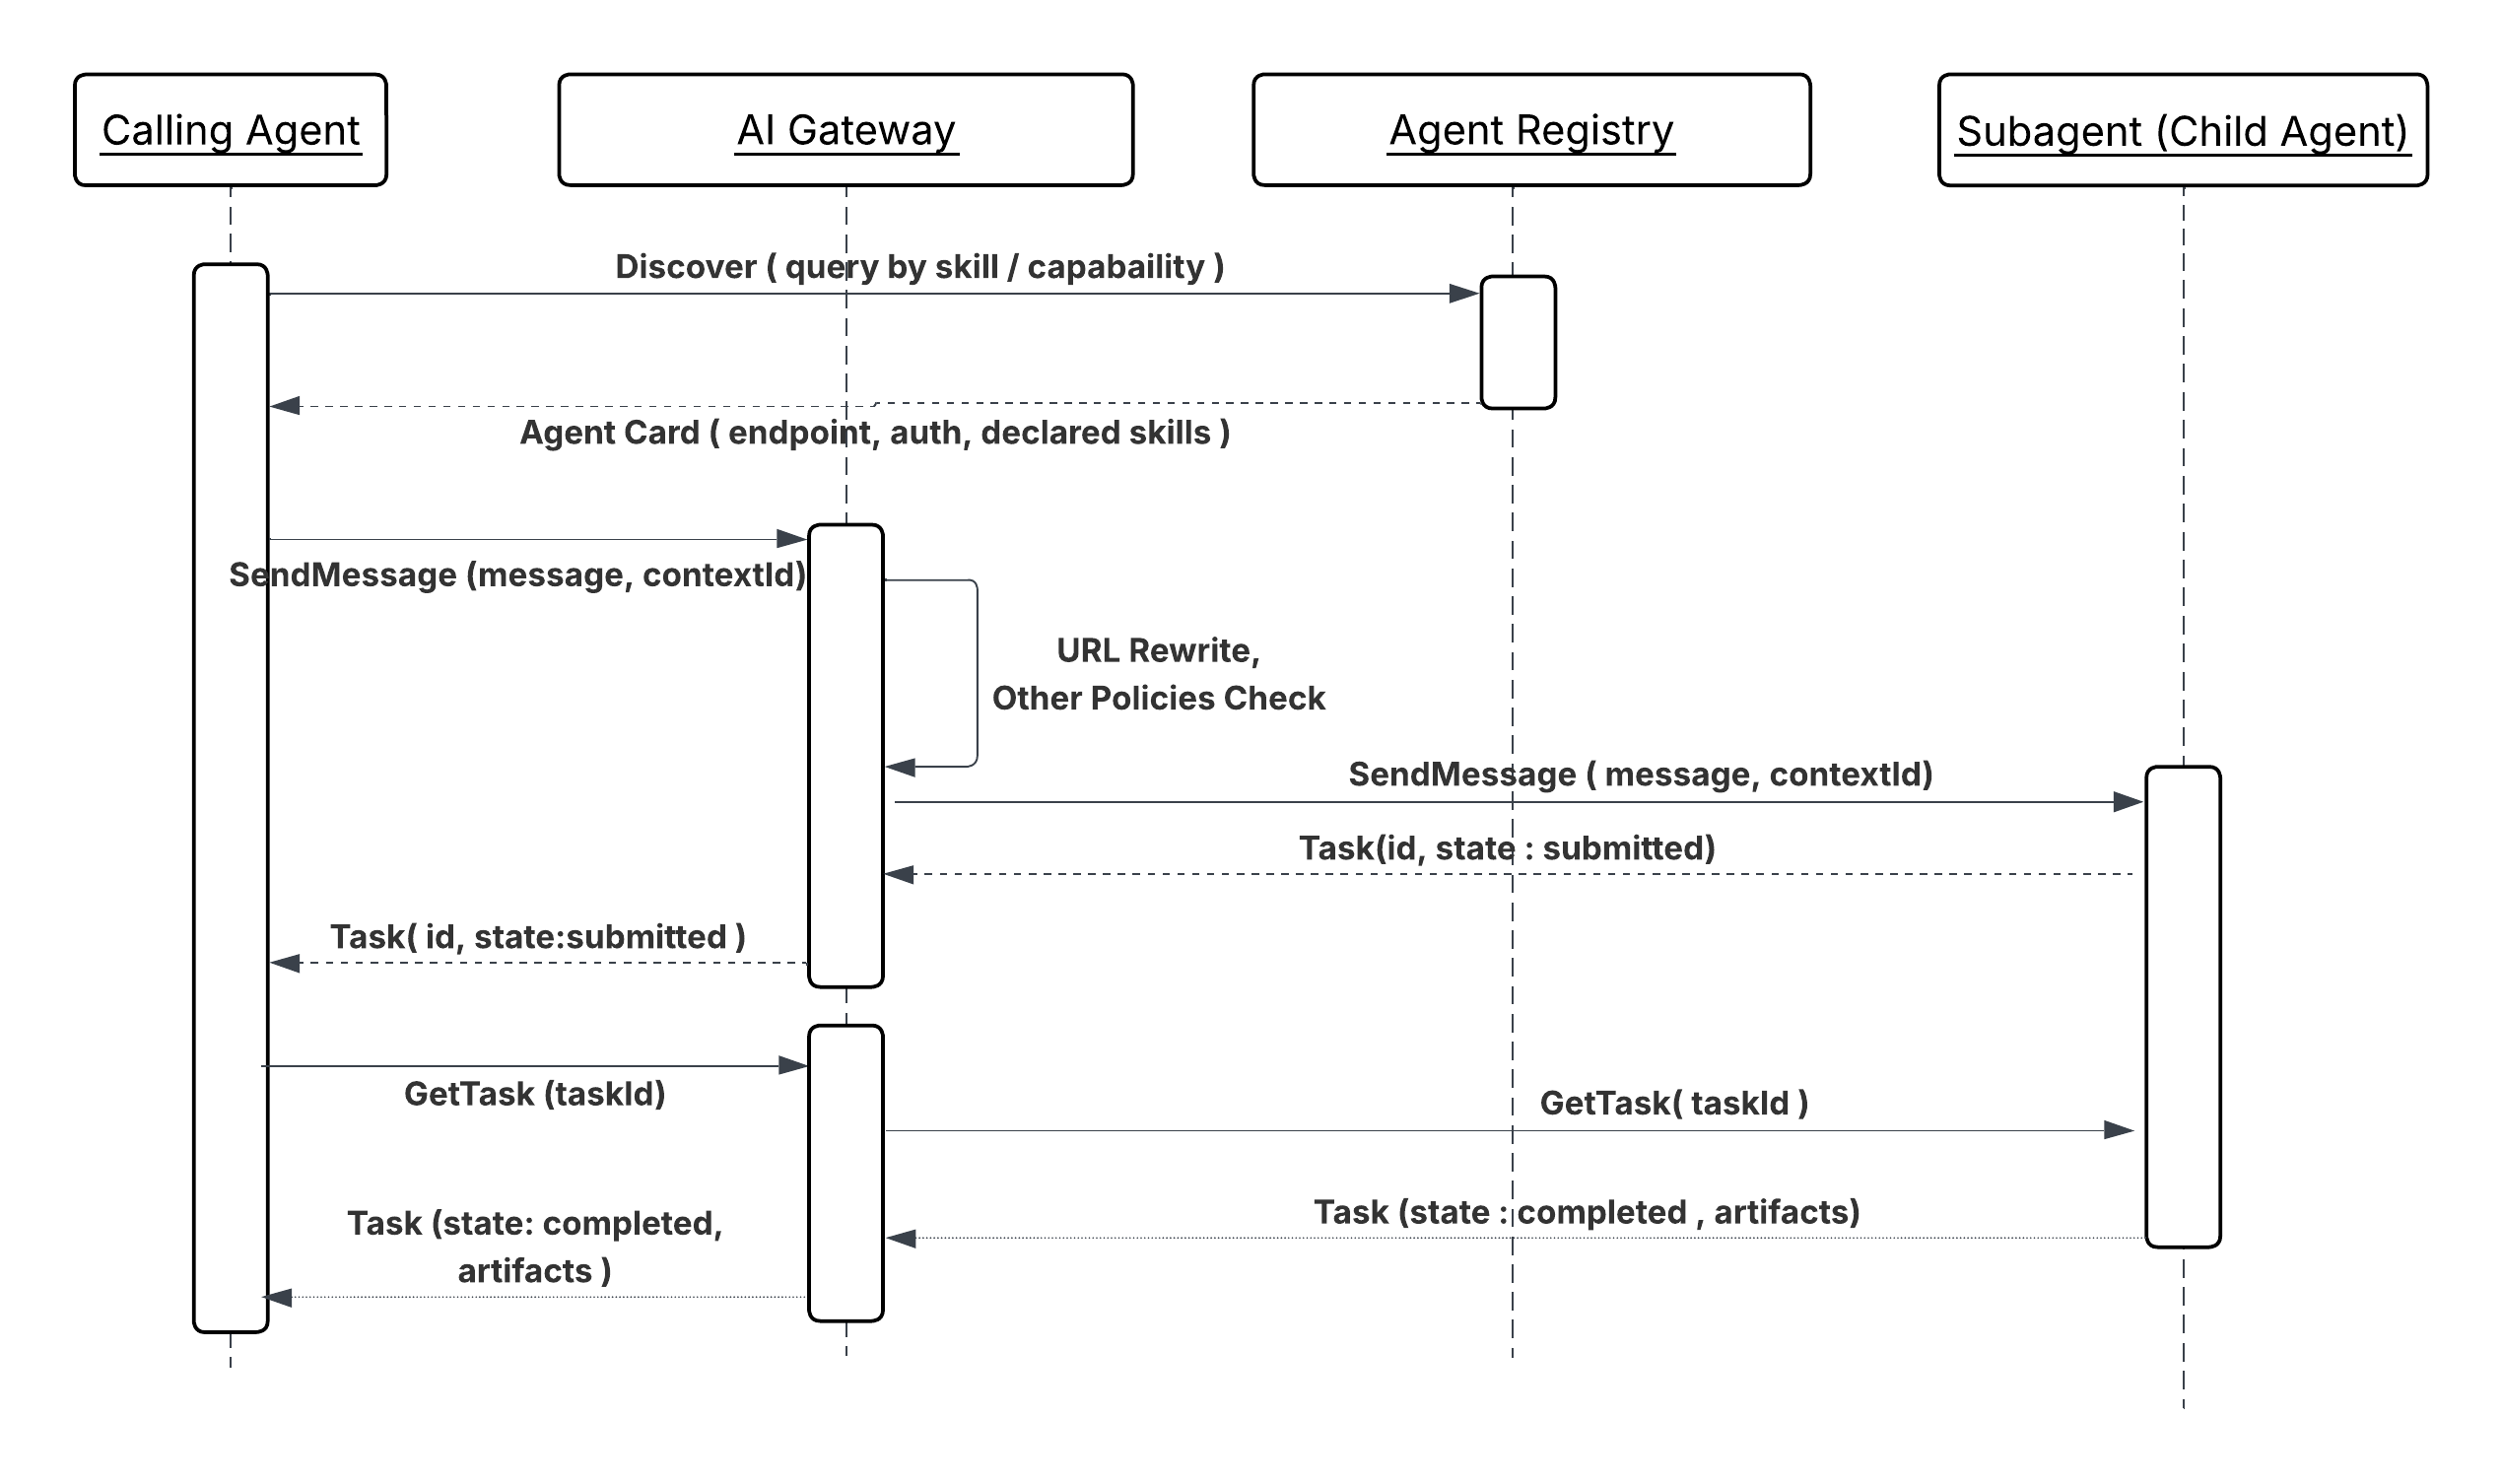
Der Peer-Agent verarbeitet die Anforderung mithilfe seiner domänenspezifischen Logik, seines Arbeitsspeichers und seiner Tools und gibt dann strukturierte Ergebnisse an den aufrufenden Agenten zurück.
Ergebnisse
Die A2A-Delegierung trennt die Domäneninhaberschaft von der Workflow-Orchestrierung. Der aufrufende Agent muss nicht wissen, wie der Peer-Agent aufgebaut ist, auf welcher Plattform er ausgeführt wird oder welche Tools er intern verwendet. Er delegiert eine Aufgabe und erhält ein strukturiertes Artefakt. Diese Grenze bedeutet, dass ein spezialisierter Agent (Hintergrundüberprüfung, finanzielle Risikobewertung, Logistikweiterleitung) unabhängig von den aufrufenden Workflows entwickelt, bereitgestellt und verbessert werden kann.
Das Aufgabenlebenszyklus-Modell des Protokolls (gesendet, funktioniert, abgeschlossen, fehlgeschlagen) unterstützt
langfristige Vorgänge nativ. Der aufrufende Agent kann sich für Statusaktualisierungen registrieren.
Halten einer blockierenden Verbindung, d. h., A2A-Aufgaben können Minuten oder Stunden umfassen
ohne dass der Orchestrierungsagent durchgehend aktiv bleiben muss.
Überlegungen zum Design
Plattformunabhängige Anleitung
- In komplexen Szenarien kann ein Agentenmakler als intelligenter Weiterleitungsservice oder “intelligente Vermittlungsstelle” fungieren, um die Aufgabendelegation zwischen spezialisierten Agenten zu koordinieren und Prozesse in mehreren Schritten zu verwalten.
- Da A2A langfristige Aufgaben unterstützt, muss die Kommunikation auf den Abschluss von Aufgaben ausgerichtet sein, einen Lebenszyklus für das Aufgabenobjekt definieren und Echtzeit-Statusaktualisierungen und -benachrichtigungen bereitstellen.
- Das Protokoll unterstützt verschiedene Inhaltstypen, einschließlich Text, Dateien, strukturierter Daten, Audio und Video-Streaming.
- Die Beziehungen und Abhängigkeiten zwischen Agenten und ihren Funktionen werden in einer Konfigurationsdatei (z. B. “agent-network.yaml”) deklarativ definiert und in der Agentenregistrierung veröffentlicht.
Salesforce-Implementierungshinweise
- Halten Sie verbundene Unteragenten unter 7 für eine effektive SOMA-Orchestrierung, um die Weiterleitungsqualität beizubehalten.
- Derzeit wird nur die einzelne Delegationsebene unterstützt (Superagent → Unteragent). Tiefere Ketten übertragen die Latenz auf eine “nicht deaktivierbare Rate”. Derzeit können Unteragenten nicht an andere verbundene Unteragenten delegieren.
- Die menschliche Übergabe wird nur auf Orchestriererebene unterstützt. Unteragenten können nicht eskalieren.
- Verwenden Sie in SOMA das Agentenskript, wenn die LLM-basierte Weiterleitung bei mehrdeutigen Eingaben für die deterministische Weiterleitung zu einer falschen Weiterleitung führt. Das Agentenskript aktiviert den zusammengestellten freigegebenen Kontext zwischen Agenten.
Fehlerbehandlung und -behebung
Das A2A-Protokoll definiert umfassende Fehlercodes, um das zuverlässige Debugging und die Fehlerverwaltung zu erleichtern.
- Wiederherstellungslogik: Agenten sollten Richtlinien für Wiederholungen (Wiederholungen), Failover-Logik für alternative fähige Agenten und explizite Zeitüberschreitungen integrieren.
- Aufgabenstatusverfolgung: Der Aufgabenverwaltungs-Workflow stellt sicher, dass Agenten mit dem neuesten Status einer Aufgabe synchron bleiben können, was die Wiederherstellung im Falle einer Unterbrechung erleichtert.
- Beobachtbarkeit: Die Protokollierung von Interaktionsdetails wie Latenz, Erfolgsraten und Fehlerhäufigkeiten ist entscheidend für die Überwachung der Qualität und Fehlerbehebung.
Sicherheitsüberlegungen
- Unternehmensauthentifizierung: A2A wurde entwickelt, um mit Authentifizierungs- und Autorisierungsstandards auf Unternehmensebene wie OAuth 2.0 und JWT abzustimmen, die oft von externen Plattformen wie Okta verwaltet werden.
- Gateway zum Schützen von A2A: Ein Gateway (z. B. MuleSoft Omni Gateway) ist wichtig, um Richtlinien für alle A2A-Kommunikationen zu erzwingen, und fungiert sowohl als Eingangs- als auch als Ausgangs-Gateway, um Agenten zu schützen und den ausgehenden Datenverkehr an externe Agenten und Services zu steuern.
- Policenerzwingung: “Agent Card Rewrite” (Agentenkartenumschreibung), “Schemavalidierung”, “Spike Control” (Speichensteuerung), “PII Detector” (personenbezogene Daten) und andere Richtlinien sollten für A2A-Server und Datenschutz angewendet werden.
Beispiel
Workflow für die Kandidatenbeschaffung
Ein Einstellungsmanager beauftragt seinen zentralen Orchestriereragenten, Kandidaten zu finden, die mit einer Stellenanzeige und einer Fertigkeit übereinstimmen.
- Entdeckung: Der Orchestriereragent fragt die Agentenregistrierung ab und erkennt einen spezialisierten Anwerbungsagenten und einen Agenten mit Hintergrundüberprüfung (beide gleichrangige Agenten).
- Delegierung (A2A): Der Orchestriereragent sendet eine strukturierte Aufgabenanforderung (A2A-Nachricht) an den Anwerbungsagenten, um Kandidaten zu quellen.
- Peer Processing (Verarbeitung durch gleichrangige Personen): Der Anwerbungsagent führt seinen eigenen Workflow aus (z. B. Aufrufen eines externen LinkedIn-Tools über MCP).
- Artefaktrückgabe (A2A): Der Anwerbungsagent gibt eine Liste der vorgeschlagenen Kandidaten (das Artefakt) zurück.
- Sequenzielle Delegation: Anschließend delegiert der Orchestriereragent eine weitere Aufgabe (A2A) an den Agenten für die Hintergrundüberprüfung des wichtigsten Kandidaten. Dieser Agent führt die Überprüfung durch und gibt das Ergebnis zurück, wodurch die Gesamtaufgabe abgeschlossen wird.
Kontext
Für komplexe Unternehmens-Workflows sind häufig spezialisierte Agenten erforderlich, die auf externen Plattformen oder Partnersystemen gehostet werden, um Aufgaben zu initiieren, Anfragen zu delegieren oder interne Agenten (z. B. auf der Salesforce Platform) zu aktualisieren. Mit diesem Muster wird festgelegt, wie ein interner Agentforce-Agent Anforderungen von einem Remote-Agenten mit Peer-Funktion sicher und zuverlässig empfängt und verarbeitet.
Probleme
Wie kann ein interner spezialisierter AI-Agent (z. B. ein Agent mit Hintergrundüberprüfung in Agentforce) seine domänenspezifischen Funktionen sicher externen Peer-Agenten bereitstellen, eine eingehende strukturierte A2A-Anforderung verarbeiten und den Aufgabenlebenszyklus (einschließlich Echtzeit-Statusaktualisierungen) verwalten, um strukturierte Artefakte an den Remote-Anrufagenten zurückzugeben?
Kräfte
Beantworten Sie beim Anwenden dieses Musters die folgenden Fragen:
- Wie können Sie die Funktionen interner Agenten externen Agenten sicher zur Verfügung stellen, ohne interne Logik oder Tools zu beeinträchtigen?
- Wie erzwingen Sie Sicherheitsrichtlinien auf Unternehmensebene, um die Identität und die delegierte Autorität des Anrufagenten vor der Verarbeitung von Anforderungen zu überprüfen?
- Wie handhaben Sie langfristige eingehende Aufgaben und stellen strukturierte, asynchrone Statusaktualisierungen bereit?
- Wie können Sie eine nahtlose Interaktion mit Agenten sicherstellen, die auf verschiedenen externen Frameworks basieren?
Anwendung für Salesforce-Muster
Das A2A-Protokoll bietet den offenen Standard für eine sichere, gleichrangige Delegation und Zusammenarbeit. Der interne Agent fungiert als gleichrangiger Agent, bewirbt seine Funktionen über einen Agentenkatalog/eine Registrierung und verwendet A2A über sichere Kanäle (HTTPS/SSE), um strukturierte Anforderungen zu empfangen und zu beantworten.
| Lösung | Passend | Kommentare |
|---|---|---|
| Verbundener Agentforce-Unteragent (SOMA) | Am besten, wenn der anrufende Agent ein anderer Agentforce Agent in derselben Organisation ist | Wird verwendet, wenn beide Agenten in derselben Salesforce-Organisation leben und der Anrufer ein Agentforce Orchestrator ist. Der Agent wird über Agentforce Builder als Unteragent verbunden und dem Orchestrierer über seine Beschreibung und seine deklarierten Aktionen angezeigt. Der Orchestrierer leitet Aufgaben mithilfe der LLM-basierten Weiterleitung (Atlas Reasoning Engine) oder der deterministischen Weiterleitung (Agentenskript) weiter. Es ist kein A2A-Protokoll, Gateway oder externe Registrierung erforderlich. Unterstützte Kombinationen: Agentforce Serviceagent→Agentforce Serviceagent Agentforce Mitarbeiteragent→ Agentforce Mitarbeiteragent Agentforce Mitarbeiteragent→Agentforce Serviceagent Nur der Orchestrierer kann zu einem Menschen eskalieren, Unteragenten nicht. |
| Agent Broker Routing (Eingehend) | Am besten, wenn die Organisation mehrere Agentforce Agenten mit komplementären Funktionen hostet und der aufrufende Agent kein bestimmtes Ziel auswählen kann oder sollte | Wird verwendet, wenn der anrufende Agent außerhalb von Salesforce oder einer anderen Salesforce-Organisation ist und nicht wissen muss, welcher bestimmte interne Agent (Agentforce oder andere Anbieteragenten) seine Anforderung bearbeitet. Zwischen dem MuleSoft Omni Gateway und dem Pool der internen Agentforce Agenten befindet sich ein MuleSoft Agent Broker. Sie empfängt die eingehende A2A-Aufgabe, wertet die angegebenen Funktionen der verfügbaren internen Agenten anhand der Anforderungen der Aufgabe aus und leitet die Anforderung an den am besten geeigneten Agenten weiter. Der Makler verarbeitet auch das Failover, wenn der primäre Zielagent nicht verfügbar ist oder einen Fehler zurückgibt. Der Makler leitet eine Weiterleitung an einen entsprechenden Agenten aus, ohne den Versuch an den externen Anrufer weiterzuleiten. Der externe Anrufer ist sich nie der internen Weiterleitungsentscheidungen oder Wiederholungen bewusst. |
Skizze
Sequenzdiagramm für Agenten als aufrufbare Services
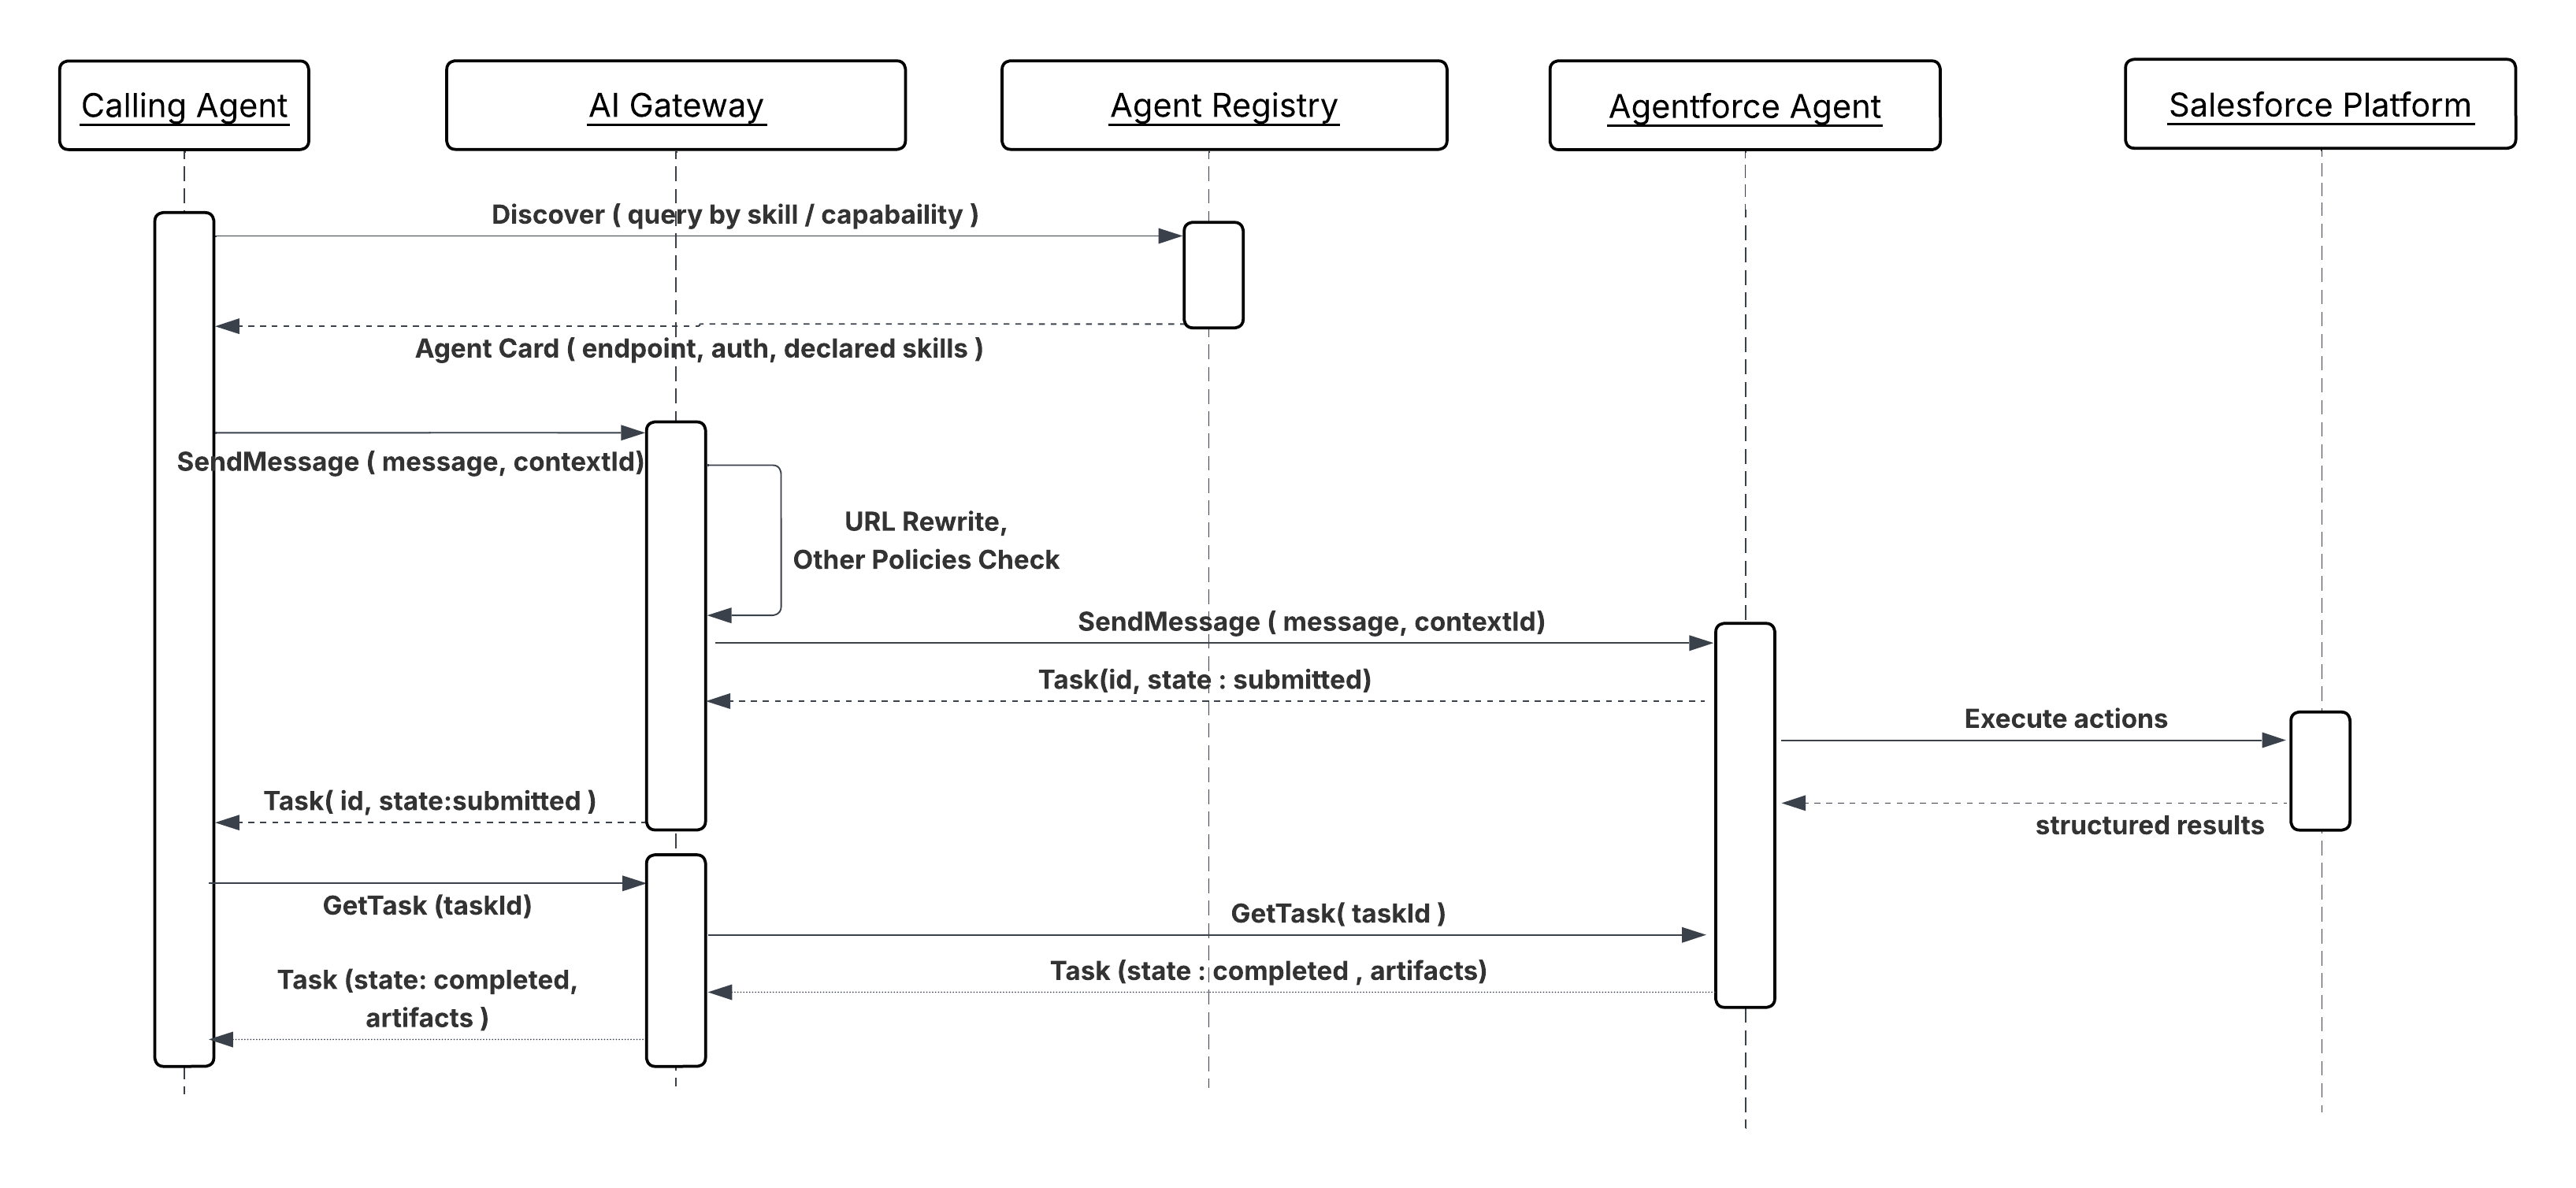
Ergebnisse
Durch dieses Muster werden interne Agenten als spezialisierte Services in einem Netzwerk mit mehreren Agenten angezeigt. Externe Agenten können Aufgaben sicher an interne Funktionen delegieren, während die Organisation die Kontrolle, Überprüfbarkeit und Durchsetzung von Richtlinien behält.
Überlegungen zum Design
Plattformunabhängige Anleitung
- Ein Gateway (z. B. MuleSoft Omni Gateway) muss als Eingangspunkt positioniert sein, um Richtlinien, einschließlich Ratenbegrenzung, Authentifizierung und Nutzlastvalidierung, für alle eingehenden A2A-Anforderungen zu erzwingen.
- Interne Agenten müssen den Status des Aufgabenobjekts von der externen Initiierung bis zum Abschluss verwalten, um sicherzustellen, dass der Remote-Anrufagent konsistente, überprüfbare Statusaktualisierungen erhält.
- Stellen Sie sicher, dass die veröffentlichten Funktionen des Agenten auf der Agentenkarte klar und intentbasiert sind und die erforderlichen Sicherheitsumfänge für die Delegierung enthalten.
Fehlerbehandlung und -behebung
- Strukturierte Fehlercodes: Bei einem Fehler muss der interne Agent A2A-konforme strukturierte Fehlermeldungen an den aufrufenden Agenten zurückgeben, um Remote-Wiederholungslogik oder alternative Failover-Mechanismen zu aktivieren.
- Idempotenz: Der Agent muss überprüfen, ob alle Nebenwirkungen, die durch eine erneute A2A-Anforderung eines externen Agenten (aufgrund einer Netzwerkunterbrechung oder -wiederherstellung) ausgelöst werden, idempotent sind.
Sicherheitsüberlegungen
- Erzwingung eingehender Policen: Das Gateway muss Richtlinien für die Zulassung/Blockierung externer Agenten und die Validierung von JWT/OAuth 2.0-Token erzwingen, um die Identität und die delegierte Autorität des anrufenden Agenten zu überprüfen.
- Eingangsbereinigung: Validieren und bereinigen Sie alle eingehenden Anforderungsnutzlasten, um potenzielle Eingabeaufforderungen oder Angriffe mit bösartigen Daten zu vermeiden.
- Identitätsübernahme: Ordnen Sie die Identität des externen Agenten und seine delegierte Autorität Kontexten der internen Sicherheit (z. B. Salesforce-Benutzerprofilen) sicher zu, bevor Sie Aktionen gegen interne Systeme ausführen.
Beispiel
Externe Systemanfrage
- Anforderung: Ein Anwerbungsagent in einem Partnersystem sendet eine A2A-Aufgabenanforderung an einen internen Mitarbeiterüberprüfungsagenten (Peer Agent) in Agentforce, um den Beschäftigungsstatus eines neuen Kandidaten zu bestätigen.
- Verarbeitung: Der Mitarbeiterüberprüfungsagent empfängt die Anforderung über das Gateway, überprüft die Anmeldeinformationen des Partneragenten, führt seinen internen Workflow aus (beispielsweise durch Aufrufen eines internen HR-Systems) und formatiert die Antwort.
- Antwort: Der Peer-Agent gibt ein strukturiertes A2A-Artefakt (z. B. Startdatum der Beschäftigung und Stellenbezeichnung) an den Remote-Anwerbungsagenten zurück, der dann mit seinem externen Workflow fortfährt.
-
Gateway zum Schutz von MCPs, A2As und APIs
Für den gesamten Datenverkehr zwischen Agenten und Systemen ist ein Gateway als zentraler Erzwingungspunkt erforderlich.
-
Gesicherte Verbindungen: Ein Gateway stellt sicher, dass nur authentifizierte und autorisierte Agenten mit MCP-, A2A- und API-Endpunkten interagieren, indem der Zugriff eingeschränkt wird.
-
Erzwungene SLAs: Ein Gateway kann Ratenobergrenzen erzwingen, wodurch Organisationen die Leistungsanforderungen erfüllen und eine Überlastung von MCP- und A2A-Servern verhindert wird.
-
Vereinfachte Unternehmensführung: Ein Gateway bietet zentralisierte Transparenz und Kontrolle über alle Serverinteraktionen und vereinfacht so die Verwaltung und Überwachung der Agentenaktivität.
-
Datenkonsistenz und -schutz: Richtlinien wie die Schemavalidierung, die Erzwingung der Datenkonsistenz und die Erkennung personenbezogener Daten können sensible Informationen schützen.
MueleSoft Omni Gateway
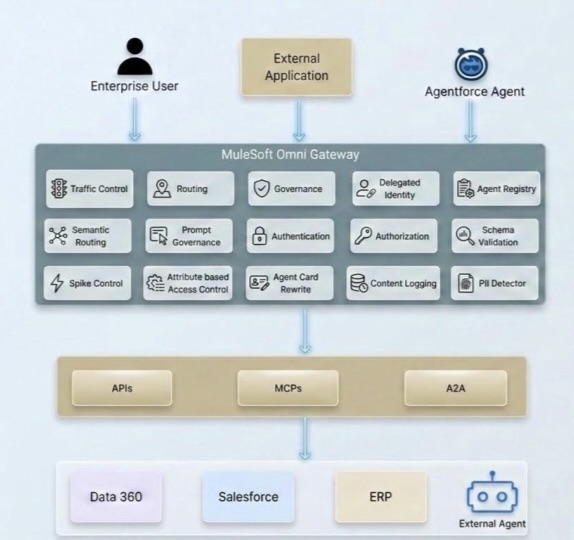
- Identitätsübernahmekette
Da Unternehmen das Agentenparadigma akzeptieren, stellt sich eine neue Sicherheitsherausforderung: Wie durchläuft die Endbenutzeridentität ein Netzwerk autonomer AI-Agenten? In traditionellen API-Architekturen authentifiziert sich ein Benutzer einmal und die Anwendung ruft Backend-Services im Namen des Benutzers auf. Die Identitätskette ist kurz, gut verstanden und wird in der Regel in einer einzelnen Trust Domäne verwaltet.
Agentenarchitekturen weisen jedoch wesentlich längere Ketten auf, in denen eine einzelne Anforderung über verschiedene Agenten, Services und MCP-Server verteilt ist, wobei jeder potenziell Servicegrenzen, Trust Domänen und sogar Organisationsgrenzen überschreitet. Ohne eine bewusste Strategie zur Identitätsübermittlung stehen Unternehmen vor der Wahl zwischen Sicherheit und Funktionalität – ein Dilemma, das kein Architekt angehen muss.
MuleSoft behebt die Komplexität der Identitätsübertragung mit der Funktion “Identität des vertrauenswürdigen Agenten”. Diese Lösung verwendet eine richtlinienbasierte, Gateway-verwaltete Strategie, um sicherzustellen, dass die Endbenutzeridentität über verschiedene Interaktionstypen hinweg beibehalten wird, einschließlich A2A-Protokollen, MCP-Toolaufrufen und REST-API-Anforderungen. Durch die Zentralisierung der Identitätsverwaltung auf Omni-Gateway-Ebene durch ausgehende Authentifizierungsrichtlinien können Unternehmen ihr gesamtes Agentennetzwerk schützen, ohne Backend-Services oder Agenten zu ändern. Weitere Details finden Sie unter Trusted Agent Identity for the Agentic Enterprise.
- RAG-Sicherheit in Data 360
Data 360 unterstützt die attributbasierte Zugriffssteuerung (ABAC) auf Objekt-, Feld- und Zeilenebene über die Einstellungen der Datenverwaltungsrichtlinie. Dies ist die primäre Möglichkeit, zu steuern, welche Daten für wen sichtbar sind, auch in RAG-Suchindizes. Bei strukturierten Daten werden Benutzerzugriffsbedingungen mithilfe von Benutzerattributen und Berechtigungssätzen implementiert. Bei unstrukturierten Daten kann die Metadatenfilterung (Vorfilterung für Suchindizes) einschränken, was abgerufen wird.
Die Kommunikation mit dem LLM erfolgt über die Einstein Trust Layer, die vertrauliche/personenbezogene Daten maskiert, bevor sie das Modell zum Schutz des Datenschutzes nicht nur während der Suche, sondern auch vor der Generierung erreichen.
Stellen Sie zum Schutz vor RAG-Vergiftungen sicher, dass strenge Datenverwaltungs- und Validierungsregeln angewendet werden, bevor Daten für die Vektorsuche verfügbar werden. Die Einstein Trust Layer kann auch die sofortige Maskierung/Toxizitätsprüfung erzwingen. Sie können strenge Berechtigungssätze auf das Profil “Agentenbenutzer” anwenden.
- Neues Anmeldeinformationsmodell mit Namen Salesforce hat seine Authentifizierungsarchitektur umgestaltet, indem es ein zweistufiges Modell für Anmeldeinformationen mit Namen eingeführt hat, das die Bedenken zwischen Konnektivität und Identität klar voneinander trennt. Verwenden Sie dies, wenn Sie Callouts über Apex vornehmen, und vermeiden Sie die Erstellung Ihres eigenen Authentifizierungsprotokolls. Dieses Modell bietet zudem Erweiterbarkeit und erhöhte Sicherheit. Externe Anmeldeinformationen bilden die Grundlage dieses Modells. Sie speichern die tatsächlichen Authentifizierungsdetails und unterstützen einen umfangreichen Satz an Protokollen, einschließlich OAuth 2.0-Client-Anmeldeinformationen, JWT-Bearer und AWS Signature V4, während sie auch definieren, wie Prinzipale zugeordnet werden: entweder als einzelner benannter Prinzipal (für alle Benutzer freigegeben) oder als benutzerbasierter Prinzipal (wobei sich jeder Benutzer mit seiner eigenen Identität authentifiziert). Anmeldeinformationen mit Namen fungieren wiederum als Endpunktebene. Sie definieren den Callout-URL und verweisen auf externe Anmeldeinformationen, um den Authentifizierungs-Handshake zu verarbeiten und die Endpunktkonfiguration sauber von der Anmeldeinformationenverwaltung zu trennen. Zum Aktivieren von Flows zur Authentifizierung pro Benutzer ordnen Administratoren Berechtigungssätze dem entsprechenden Prinzipal für externe Anmeldeinformationen zu, sodass nur Benutzer mit der richtigen Berechtigungssatzzuweisung Callouts unter ihrer eigenen Identität aufrufen können. Dieses zweistufige Design vereinfacht nicht nur die sichere Callout-Konfiguration, sondern bietet Architekten auch viel mehr Flexibilität und Kontrolle darüber, wie Integrationen in Salesforce-verbundenen Systemen authentifiziert werden. Weitere Details finden Sie in der Dokumentation zu Anmeldeinformationen mit Namen.
In diesem Abschnitt werden die Datenverarbeitungsmuster der Architektur den Compliance-Verpflichtungen zugeordnet, die bei regulierten Unternehmensbereitstellungen am häufigsten auftreten.
Zugriffssteuerung: Das in den Integrationsmustern beschriebene Benutzermodell für die Integration mit den geringsten Berechtigungen (Named Credentials, OAuth 2.0-Geltungsbereiche pro Agent, Gateway-Zulassungslisten) wird direkt logischen Zugriffssteuerungen zugeordnet. Behalten Sie den Nachweis bei, dass der Umfang der Anmeldeinformationen jedes Agenten überprüft und genehmigt wurde.
Aktivierungsprotokollierung: Die Anforderungen an die Protokollierung pro Muster (Sitzungs-ID, Toolaufrufe, Eingabeparameter, die durch sensible Werte bereinigt wurden, Ergebnisse) erfüllen die Überwachungs- und Protokollierungssteuerungen. Stellen Sie sicher, dass Protokolle manipulationssicher sind, für den erforderlichen Zeitraum aufbewahrt werden und für das Sicherheitsteam zugänglich sind, ohne dass Zugriff auf Produktionssysteme erforderlich ist.
Änderungsverwaltung: Änderungen am MCP-Tool-Schema und A2A-Agentenkartenaktualisierungen, die sich auf Verbraucher auswirken, stellen Schnittstellenänderungen dar und sollten Änderungsverwaltungssteuerungen unterliegen. Versionstools explizit (im eingehenden Muster für MCP erwähnt) und behandeln fehlerhafte Änderungen als Konfigurationsereignisse, die genehmigt werden müssen.
Verfügbarkeit: Obergrenzen für die Agentengleichzeitigkeit, Obergrenzen für Wiederholungen bei durch Ereignisse ausgelösten Mustern und die Weiterleitung von toten Briefen bei fehlgeschlagenen Ereignissen stellen Verfügbarkeitskontrollen dar. Dokumentieren Sie die erwartete Durchsatzhülle und das Fehlerverhalten für jedes bereitgestellte Muster als Teil des Verfügbarkeitsnachweispakets.
Notiz: Diese Liste stellt keine vollständige Anleitung zur Gewährleistung der Konformität Ihrer Agentenlösungen dar. Alle geltenden regulatorischen Anforderungen müssen erfüllt sein.
- Erste Schritte mit der Agenten-API
- Aktivieren von vertrauenswürdigen Agenten mit Data 360
- MuleSoft Omni Gateway – Übersicht
- Richtlinie zur Injektion von Anmeldeinformationen im Namen von OAuth 2.0
- Identität des vertrauenswürdigen Agenten für das Agentenunternehmen
Gulal Kumar ist Software-Entwickler bei Salesforce und verfügt über mehr als 20 Jahre Erfahrung. Seine Expertise erstreckt sich auf AI, Integration, APIs und Unternehmensarchitektur, wobei er sich darauf konzentriert, die Geschäftstransformation durch sichere, belastbare und innovative AI-Lösungen voranzutreiben. Verbinden Sie sich mit ihm über LinkedIn.