Data 360-Interoperabilität
Unternehmen speichern Daten häufig in Salesforce und anderen externen Data Lakes (z. B. Snowflake, Google BigQuery, Databricks, Redshift oder Objektspeicher wie Amazon S3). Die Isolierung von Daten über mehrere Systeme hinweg stellt Unternehmen vor eine Herausforderung, die den vollen Wert ihrer Daten nutzen möchten, um AI-gestützte Erfahrungen zu ermöglichen. Salesforce Data 360 ist die grundlegende Intelligence-Ebene, die jeder Agentforce AI Agent verwendet, um zum richtigen Zeitpunkt auf den richtigen Kontext zuzugreifen.
Architekten, die daran arbeiten, Daten über mehrere Data Lakes hinweg zusammenzuführen, stehen vor wichtigen architektonischen Entscheidungen hinsichtlich der besten Integration dieser Daten. Data 360 bietet mehrere Optionen für die Datenintegration, die jeweils verschiedene Vor- und Nachteile bieten.
Dieser Leitfaden bietet ein Framework, um zu bewerten, welches Muster Ihren Anforderungen an Latenz, Kosten, Skalierbarkeit, Governance und Komplexität bei der Integration von Daten am besten entspricht. So können Sie auswählen, wann die Datenaufnahme, die Zero Copy-Datenverbundorganisation oder ein hybrider Ansatz verwendet werden soll. Der Leitfaden hilft Ihnen auch bei der Auswahl zwischen verschiedenen Methoden der Datenaufnahme und der Datenzuordnung, von denen jede einen anderen Bedarf erfüllt.
Die Integration externer Data-Lake-Häuser in Data 360 erfordert eine sorgfältige Abwägung der Kompromisse zwischen Datenaktualisierung, Governance und Pipeline-Effizienz. Wenn Sie beispielsweise Live-Abfragen des Datenverbunds Zero Copy verwenden, wird die Aktualität der Daten maximiert, die Pipeline-Effizienz kann jedoch reduziert werden, wenn mehr Daten über das Netzwerk fließen. Für die meisten realen Implementierungen ist die Kombination von Aufnahme und Verbund in einem Ökosystem mit mehreren Cloud-Seehäusern der optimale Weg. Dieser hybride Ansatz gewährleistet eine skalierbare, gesteuerte und interoperable Architektur, die operative Arbeitslasten mit geringer Latenz (z. B. Echtzeitpersonalisierung und Betrugserkennung) und analytische Arbeitslasten (z. B. behördliche Berichte und Analysen historischer Trends) unterstützt. In diesem Leitfaden können Sie bestimmen, wie Sie mit einer geeigneten Strategie durch diese Kompromisse navigieren.
- Die Datenaufnahme kopiert Daten in Salesforce Data 360 und erstellt geregelte, kanonische Datenmodelle. Dies ist ideal für folgende Fälle:
- Erstellen Sie eine umfassende Customer 360. Auf diese Weise können Sie unterschiedliche Quellen vereinheitlichen und in ein einzelnes, vertrauenswürdiges Profil umwandeln.
- Erfüllen Sie die strenge Einhaltung gesetzlicher Vorschriften. Auf diese Weise können Sie eine überprüfbare, zentralisierte Kopie erstellen, sodass der Datenzugriff und die Herkunft genau gesteuert werden können.
- Die Zero Copy Federation fragt externe Quellen in Echtzeit ohne Duplikate ab, wodurch die Echtzeitpersonalisierung, Live-Dashboards und die schnelle Einarbeitung von Quellen ermöglicht werden. Dieser Ansatz bietet zwei primäre Optionen, es gibt jedoch Kompromisse, die ausgeglichen werden müssen:
- Live-Abfrage: Verwenden Sie dies für interaktive Analysen und Echtzeit-Daten-Dashboards, die auf externen Datenplattformen (z. B. Snowflake, BigQuery, Redshift oder Databricks) vorhanden sind. Dadurch können Sie langsame, kostspielige Datenduplikate vermeiden, indem Sie die Abfrageverarbeitung an das Quellsystem übertragen und nur die erforderlichen Ergebnisse zurückgeben. Dieser Ansatz ist für seltene oder Ad-hoc-Abfragen optimiert, bei denen die Aktualität entscheidend ist. Sie eignet sich für geringe Arbeitslasten mit Abfrage pro Sekunde (Abfragekosten können bei hoher QPS deutlich ansteigen).
- Zwischenspeicherung (beschleunigte Abfrage): Verwenden Sie dies für häufige Datenabfragen, die sich nicht oft ändern. Bei beschleunigten Abfragen wird ein lokaler Cache beibehalten, der in konfigurierbaren Abständen (15 Minuten bis 7 Tage) aktualisiert wird, wodurch wiederholte Quelltreffer reduziert werden. Dieser Ansatz gleicht die Dashboard-Leistung und die Kosten, die Segmentierung und die BI-Arbeitslasten aus, wenn leicht veraltete Ergebnisse akzeptabel sind. Dies eignet sich nicht für die Entscheidungsfindung im Sekundenbereich.
- Dateiverbund: Verwenden Sie dies für die Batch-Verarbeitung im großen Umfang und für die AI-Modellschulung für Daten im Data Lake Ihrer Cloud (z. B. S3 oder ADLS). Dieser Ansatz vermeidet eine langsame und kostspielige Aufnahme, da Dateien direkt in offenen Tabellenformaten abgefragt werden, wodurch massive ETL-Datensets und Data Science-Arbeitslasten freigesetzt werden.
- Hybridmodelle kombinieren die Aufnahme für vereinheitlichte Profile mit Verbund für die Aktualisierung, wodurch Omnikanal-Engagement, Agentforce-gesteuerte Aktionen und AI/ML-Training unterstützt werden.
- Verwenden Sie eine Hybridarchitektur. Die Kombination von Datenaufnahme und Verbund ist häufig erforderlich.
- Verwenden Sie die Datenaufnahme für wichtige Daten für kanonische Datenmodelle und die Kernverwaltung.
- Verwenden Sie Nullkopie für alle anderen Datenverbünde, um die Aktualität aufrechtzuerhalten und den operativen Aufwand beim Erstellen und Verwalten von Datenaufnahmepipelines zu minimieren.
- Die Datenaufnahmehäufigkeit ist wichtig. Wählen Sie die Häufigkeit basierend auf Geschäftswert, Latenzanforderungen und betrieblicher Komplexität aus.
- Verwenden Sie Echtzeit für zeitkritische Workflows (z. B. Personalisierung, Live-Dashboards und Agentforce-Aktionen).
- Verwenden Sie nahezu in Echtzeit für mäßig dringende Prozesse (z. B. Kampagnen und Betriebsberichte).
- Verwenden Sie die Batch-Erstellung für historische oder Low-Velocity-Datensets.
- Vergleichen Sie Verbundmuster mit Latenz und Leistung. Wählen Sie die Option aus, die Ihren Zugriffsmustern und Anforderungen an Aktualität, Leistung und Kosten am besten entspricht.
- Verwenden Sie die Live-Abfrage für betriebliche Dashboards und Echtzeitpersonalisierungen, bei denen eine geringe Latenz entscheidend ist.
- Verwenden Sie Caching (Beschleunigte Abfrage), wenn Abfragen häufig sind und leicht veraltete Ergebnisse akzeptabel sind, was zu einem ausgewogenen Verhältnis zwischen Leistung und Kosten beiträgt.
- Verwenden Sie den Dateiverbund für umfangreiche Analysen oder Batch-Arbeitslasten, die sich ideal für historische oder weniger zeitkritische Datensets eignen.
- Anpassen der Unternehmensführung an die Anforderungen an die Datenresidenz.
- Verwenden Sie die Aufnahme, wenn die zentrale Verwaltung wichtig ist.
- Verwenden Sie den Verbund, wenn die dezentrale Verwaltung zulässig ist, und erzwingen Sie gleichzeitig eine strenge Verwaltung an der externen Quelle.
- Verwenden Sie Nullkopie in Bezug auf Richtlinien auf Quellebene (z. B. Sicherheit auf Zeilenebene und Datenmaskierung).
- Priorisieren Sie die Aufnahme für hochwertige Workflows. Wenden Sie die Aufnahme selektiv auf wichtige Prozesse an (z. B. Identitätsbestimmung, behördliche Berichte und operative Aktivierung).
- Kosten und Komplexität treiben Entscheidungen voran. Die Aufnahme in Echtzeit kann teuer und komplex sein. Daher ist es für Architekten wichtig, die Kosten für die Einarbeitung, Speicherung und Umwandlung von Daten mit den Kosten für die direkte Abfrage über Nullkopie abzuwägen.
Die Auswahl des richtigen Integrationsmusters – Datenaufnahme, Nullkopie oder Hybridansatz – wirkt sich direkt auf Latenz, Governance, betriebliche Effizienz und Kosten auf mehreren Cloud-Plattformen aus. Diese Entscheidung bestimmt, wie Echtzeitstatistiken, AI-gestützte Aktivierung und personalisiertes Engagement zuverlässig und skalierbar bereitgestellt werden.
In dieser Tabelle werden die Muster für die Datenaufnahme und Nullkopie in Salesforce Data 360 verglichen, wobei der Fokus auf Funktionen, Kompromissen und Vorteilen sowie Anwendungsfällen und Ergebnissen für Unternehmen liegt. Verwenden Sie dies als Referenz für die Entwicklung hybrider Multi-Cloud-Datenplattformen, die Leistung, Kosten und Compliance in Einklang bringen.
| Mustertyp | Modus/Tool | Vorteile | Überlegungen | Ergebnisse |
|---|---|---|---|---|
| Datenaufnahme |
Echtzeit:
|
|
|
Agentforce:
|
Streaming:
|
|
|
Agentforce:
|
|
Batch:
|
|
|
Agentforce:
|
|
| Zero Copy |
Live-Abfrage:
|
|
|
Agentforce:
|
Beschleunigte Abfrage (Zwischenspeicherung):
|
|
|
Agentforce:
|
|
Dateiverbund:
|
|
|
Agentforce:
|
Es gibt drei primäre Integrationsmuster für Data 360: die Datenaufnahme, die Zero-Copy-Datenzuordnung und einen hybriden Ansatz.
Bei der Datenaufnahme werden Daten physisch in Data 360 kopiert und vollständig verwaltet, im Gegensatz zu Nullkopie, bei der die Daten an der Quelle verbleiben. Anders ausgedrückt: Die Berechnung von Transformationen erfolgt in Data 360, das eine zentralisierte Verwaltung und Überwachung bietet.
Verwenden Sie die Datenaufnahme, um kanonische, geregelte Datensets in Salesforce Data 360 zu speichern und die Compliance und die betriebliche Kontrolle zu gewährleisten. Verwenden Sie die Aufnahme, wenn vollständige Kontrolle, Überprüfung und Rückverfolgbarkeit erforderlich sind. Die Datenaufnahme ist ideal für regulierte oder hochwertige Workflows, bei denen die zentrale Berechnung und Verwaltung entscheidend sind.
Die Aufnahme eignet sich zum Aufbau einer vertrauenswürdigen Grundlage für die Identitätsbestimmung, behördliche Berichte und geschäftskritische AI-gestützte Workflows und Kundenengagement.

Die Methoden zur Datenaufnahme können variieren, je nachdem, welchen Konnektor Sie zur Aufnahme Ihrer Daten verwenden. Einige Konnektoren bieten eine Vielzahl von Aufnahmemethoden, während andere nur im Batch- oder Streaming-Modus arbeiten. Eine vollständige Liste der _Data 360-_Konnektoren und verfügbaren Methoden finden Sie unter Data 360: Integrationen und Konnektoren.
- Echtzeit:
- Ermöglicht die Aufnahme im Sekundenbereich mithilfe der Datenerfassung (CDC)
- Geeignet für zeitkritische Workflows (z. B. Betrugserkennung, Personalisierung und betriebliche Dashboards)
- Verfügt über Push-Transformationen und Aggregationen in Data 360, wodurch die nachgelagerten Ein- und Ausgänge reduziert und die Berechnungsnutzung optimiert wird
- Unterstützt die Verwendung von inkrementeller CDC zum Minimieren der Datenvermischung
- Streaming:
- Bietet Aufnahme alle 1–3 Minuten in kleinen Schritten
- Wägt Frische und Kosten ab
- Geeignet für die Kampagnenorchestrierung, die Interaktion beinahe live und für operative Berichte
- Unterstützt die Verwendung von Micro-Batchs zum Steuern von E/A-Spitzen
- Aggregiert Daten an der Quelle (sofern möglich), um Übertragungsvolumen zu reduzieren und den Speicher zu optimieren
- Batch (Geplante Lasten):
- Stellt die regelmäßige Aufnahme großer Datensets bereit (z. B. stündlich, täglich und wöchentlich)
- Bietet Kosteneffizienz und Zuverlässigkeit für historische Datensets, behördliche Berichte und Compliance-Anwendungsfälle
- Stellt sicher, dass sich das Gebietsschema in derselben Region wie der Quellspeicher befindet, um die Leistung zu steigern und die Kosten zu optimieren
- Anwendungsfälle für die Datenaufnahme:
- Generieren von zusammengeführten Customer 360-Profilen. Erstellen Sie eine einzige Datenquelle für Kundenidentitäten und -attribute.
- Verwalten Sie Datensets zur Einhaltung gesetzlicher Vorschriften. Erzwingen Sie die Verwaltung, Abstammung und Überprüfbarkeit für sensible Daten.
- Kampagnenorchestrierung zentralisieren. Stellen Sie sicher, dass Marketing, Vertrieb und Service alle über konsistente, vertrauenswürdige Datensets funktionieren.
- Gestaltungspraxis:
- Passen Sie die Batch-Aufnahme für historische oder latenzarme Anforderungen an (z. B. Archivberichte oder regelmäßige Snapshots).
- Verwenden Sie CDC- oder Streaming-APIs, um die Aktualität für Betriebs- und Personalisierungs-Workflows aufrechtzuerhalten und Aktualisierungen nahezu in Echtzeit sicherzustellen.
- Steuern Sie das Speicher- und Berechnungswachstum, indem Sie inkrementelle Lasten anwenden, um Kosten und Effizienz zu optimieren (anstatt ganze Datensets neu zu laden).
- Passen Sie Aufnahme-Pipelines an die Rechenlokalität und die inkrementelle Verarbeitung an, um die Netzwerk-I/O zu reduzieren.
- Wenden Sie Transformationen in Data 360 an, um unnötige Verschiebungen von Rohdaten zu vermeiden.
- Überlegungen zu Kosten:
- Die Echtzeitaufnahme weist die höchsten Rechen- und Pipeline-Kosten auf, was für hochwertige, zeitkritische Workflows (z. B. Personalisierung, operative Dashboards oder Agentforce-gesteuerte Aktionen) gerechtfertigt sein kann.
- Die Streaming-Aufnahme weist moderate Rechen- und Speicherkosten auf, die für häufige Aktualisierungen geeignet sein können, die leichte Verzögerungen vertragen (z. B. Kampagnenorchestrierung oder Betriebsberichte).
- Die Batch-Aufnahme hat geringere Rechenkosten und einen vorhersehbaren Speicherplatz, der für historische Datensets oder Aktualisierungen mit geringer Häufigkeit geeignet ist. Die Aufnahme von Batch-Daten aus Salesforce-Organisationen mit bestimmten Konnektoren ist kostenlos.
- Aktualisierungsmodus Ermöglicht Ihnen die Auswahl des Modus “Inkrementelle Aktualisierung”, der die Gesamtaufnahme- und Berechnungskosten reduziert. Bei Salesforce wird empfohlen, nach Möglichkeit eine inkrementelle Aktualisierung zu verwenden, um die Effizienz über alle Aufnahmetypen hinweg zu optimieren.
- Die Kosten werden auch durch das E/A-Volumen von der Quelle zu Data 360 beeinflusst. Die Optimierung von Batchgrößen, Partitionen und regionaler Ausrichtung reduziert die Übertragungskosten und verbessert die Leistung.
- Branchenszenarien:
- Finanzen: Aufnahme-Datensets sind erforderlich, um Ihren Kunden zu kennen, Geldwäsche zu bekämpfen und Betrug zu erkennen, wenn Überprüfbarkeit und Compliance nicht verhandelbar sind.
- Gesundheitswesen: Verwenden Sie die Aufnahme für die Patientenidentitätsbestimmung und HIPAA-konforme Datensätze, wodurch sichere, vereinheitlichte Ansichten ermöglicht werden.
- Einzelhandel: Konsolidieren Sie POS-, E-Commerce- und Treueprogrammdaten in vereinheitlichten Profilen für die Segmentierung und Personalisierung.
- Telecom: Unterstützen Sie Abwanderungsprävention und Nutzungsanalysen mit kanonischen, geregelten Abonnentendaten.
| Funktion | Echtzeitaufnahme | Streaming-Aufnahme | Batchaufnahme |
|---|---|---|---|
| Latenz und Frische | Enthält die Aufnahme von Latenzzeiten im Sekundenbereich über Aufnahme-APIs mit Unterstützung der Datenerfassung (CDC). Bietet kontinuierliche Streaming-Pipelines. Geeignet für operative Anwendungsfälle mit geringer Latenz. | Enthält die Aufnahme von Micro-Batch alle 1–3 Minuten über native Konnektoren. Unterstützt inkrementelle Aktualisierungen. Es wird eine leichte Latenz erwartet. | Es wird eine Datenlatenz erwartet. Lässt geplante Ladevorgänge mit großem Volumen zu. Bietet regelmäßige Aufnahme (stündlich, täglich und wöchentlich). Nicht für zeitkritische Vorgänge geeignet. |
| Primäre Anwendungsfälle | Ideal für Anwendungsfälle mit geringer Latenz und Personalisierung. Wird für zeitkritische Workflows verwendet. Unterstützt ereignisgesteuerte Workflows. Wird für Echtzeitbetrugswarnungen und operative Warnungen verwendet. | Geeignet für mäßig dringende Prozesse. Wird für die Kampagnenorchestrierung, die Interaktion beinahe live und für operative Berichte verwendet. Wird für zeitnahe Kampagnenauslöser verwendet. | Kosteneffizient für massive Datensets. Zuverlässig für historische Analysen. Wird für historische Aggregations- oder regulierte Berichts-Workflows verwendet. Geeignet für historische oder Low-Velocity-Datensets. |
| Architekturkomplexität und I/O | Enthält hohe Kosten und komplexe Architektur. Erfordert Quellsysteme mit geringer Latenz. I/O-intensiv. Quellen mit hohem Volumen können zu gesättigten Pipelines führen. | Verfügt über eine einfachere Architektur als in Echtzeit. I/O ist moderat. Geeignet für vorhersehbare, wiederholte Aktualisierungsmuster. Die Batchgröße wirkt sich auf den Speicher und die Berechnung aus. | Einfach zu implementieren. I/O-intensiv bei Lastfenstern. Der Netzwerkdurchsatz kann bei großen Batches zu einem Engpass werden. |
| Überlegungen zu Kosten | Enthält die höchsten Rechen- und Pipeline-Kosten. Nur für hochwertige zeitkritische Workflows geeignet. | Enthält moderate Berechnungs- und Speicherkosten. Bietet einen ausgewogenen Ansatz für Kosten und Frische. Geeignet für häufige Aktualisierungen, die leichte Verzögerungen vertragen. | Niedrigere Rechenkosten und vorhersehbarer Speicher. Empfohlen für historische Datensets oder Aktualisierungen mit geringer Häufigkeit. Die Aufnahme über interne Salesforce-Pipelines ist kostenlos. |
| Designpraktiken | Verwenden Sie die inkrementelle CDC, um die Datenvermischung zu minimieren. Filtern und verwenden Sie selektive Felder, um den Overhead zu reduzieren. | Verwenden Sie Micro-Batchs zum Steuern von E/A-Spitzen. Ziehen Sie die Aggregation mit Fenstern in Betracht, um die Verarbeitungslast zu reduzieren. | Wird für Archivberichte oder regelmäßige Snapshots verwendet. Stellen Sie zur Kostenoptimierung sicher, dass sich die Berechnungslokalität in derselben Region wie der Quellspeicher befindet. |
Verwenden Sie Nullkopie für Echtzeitabfragen externer Systeme ohne Datenduplizierung, um Agilität, Aktualität und skalierbaren Zugriff auf große oder vorübergehende Datensets zu ermöglichen. Sie eignet sich für Live-Dashboards, explorative Analysen, AI/ML-Modellschulungen und Echtzeit-Kundenengagement direkt über Salesforce Data 360.
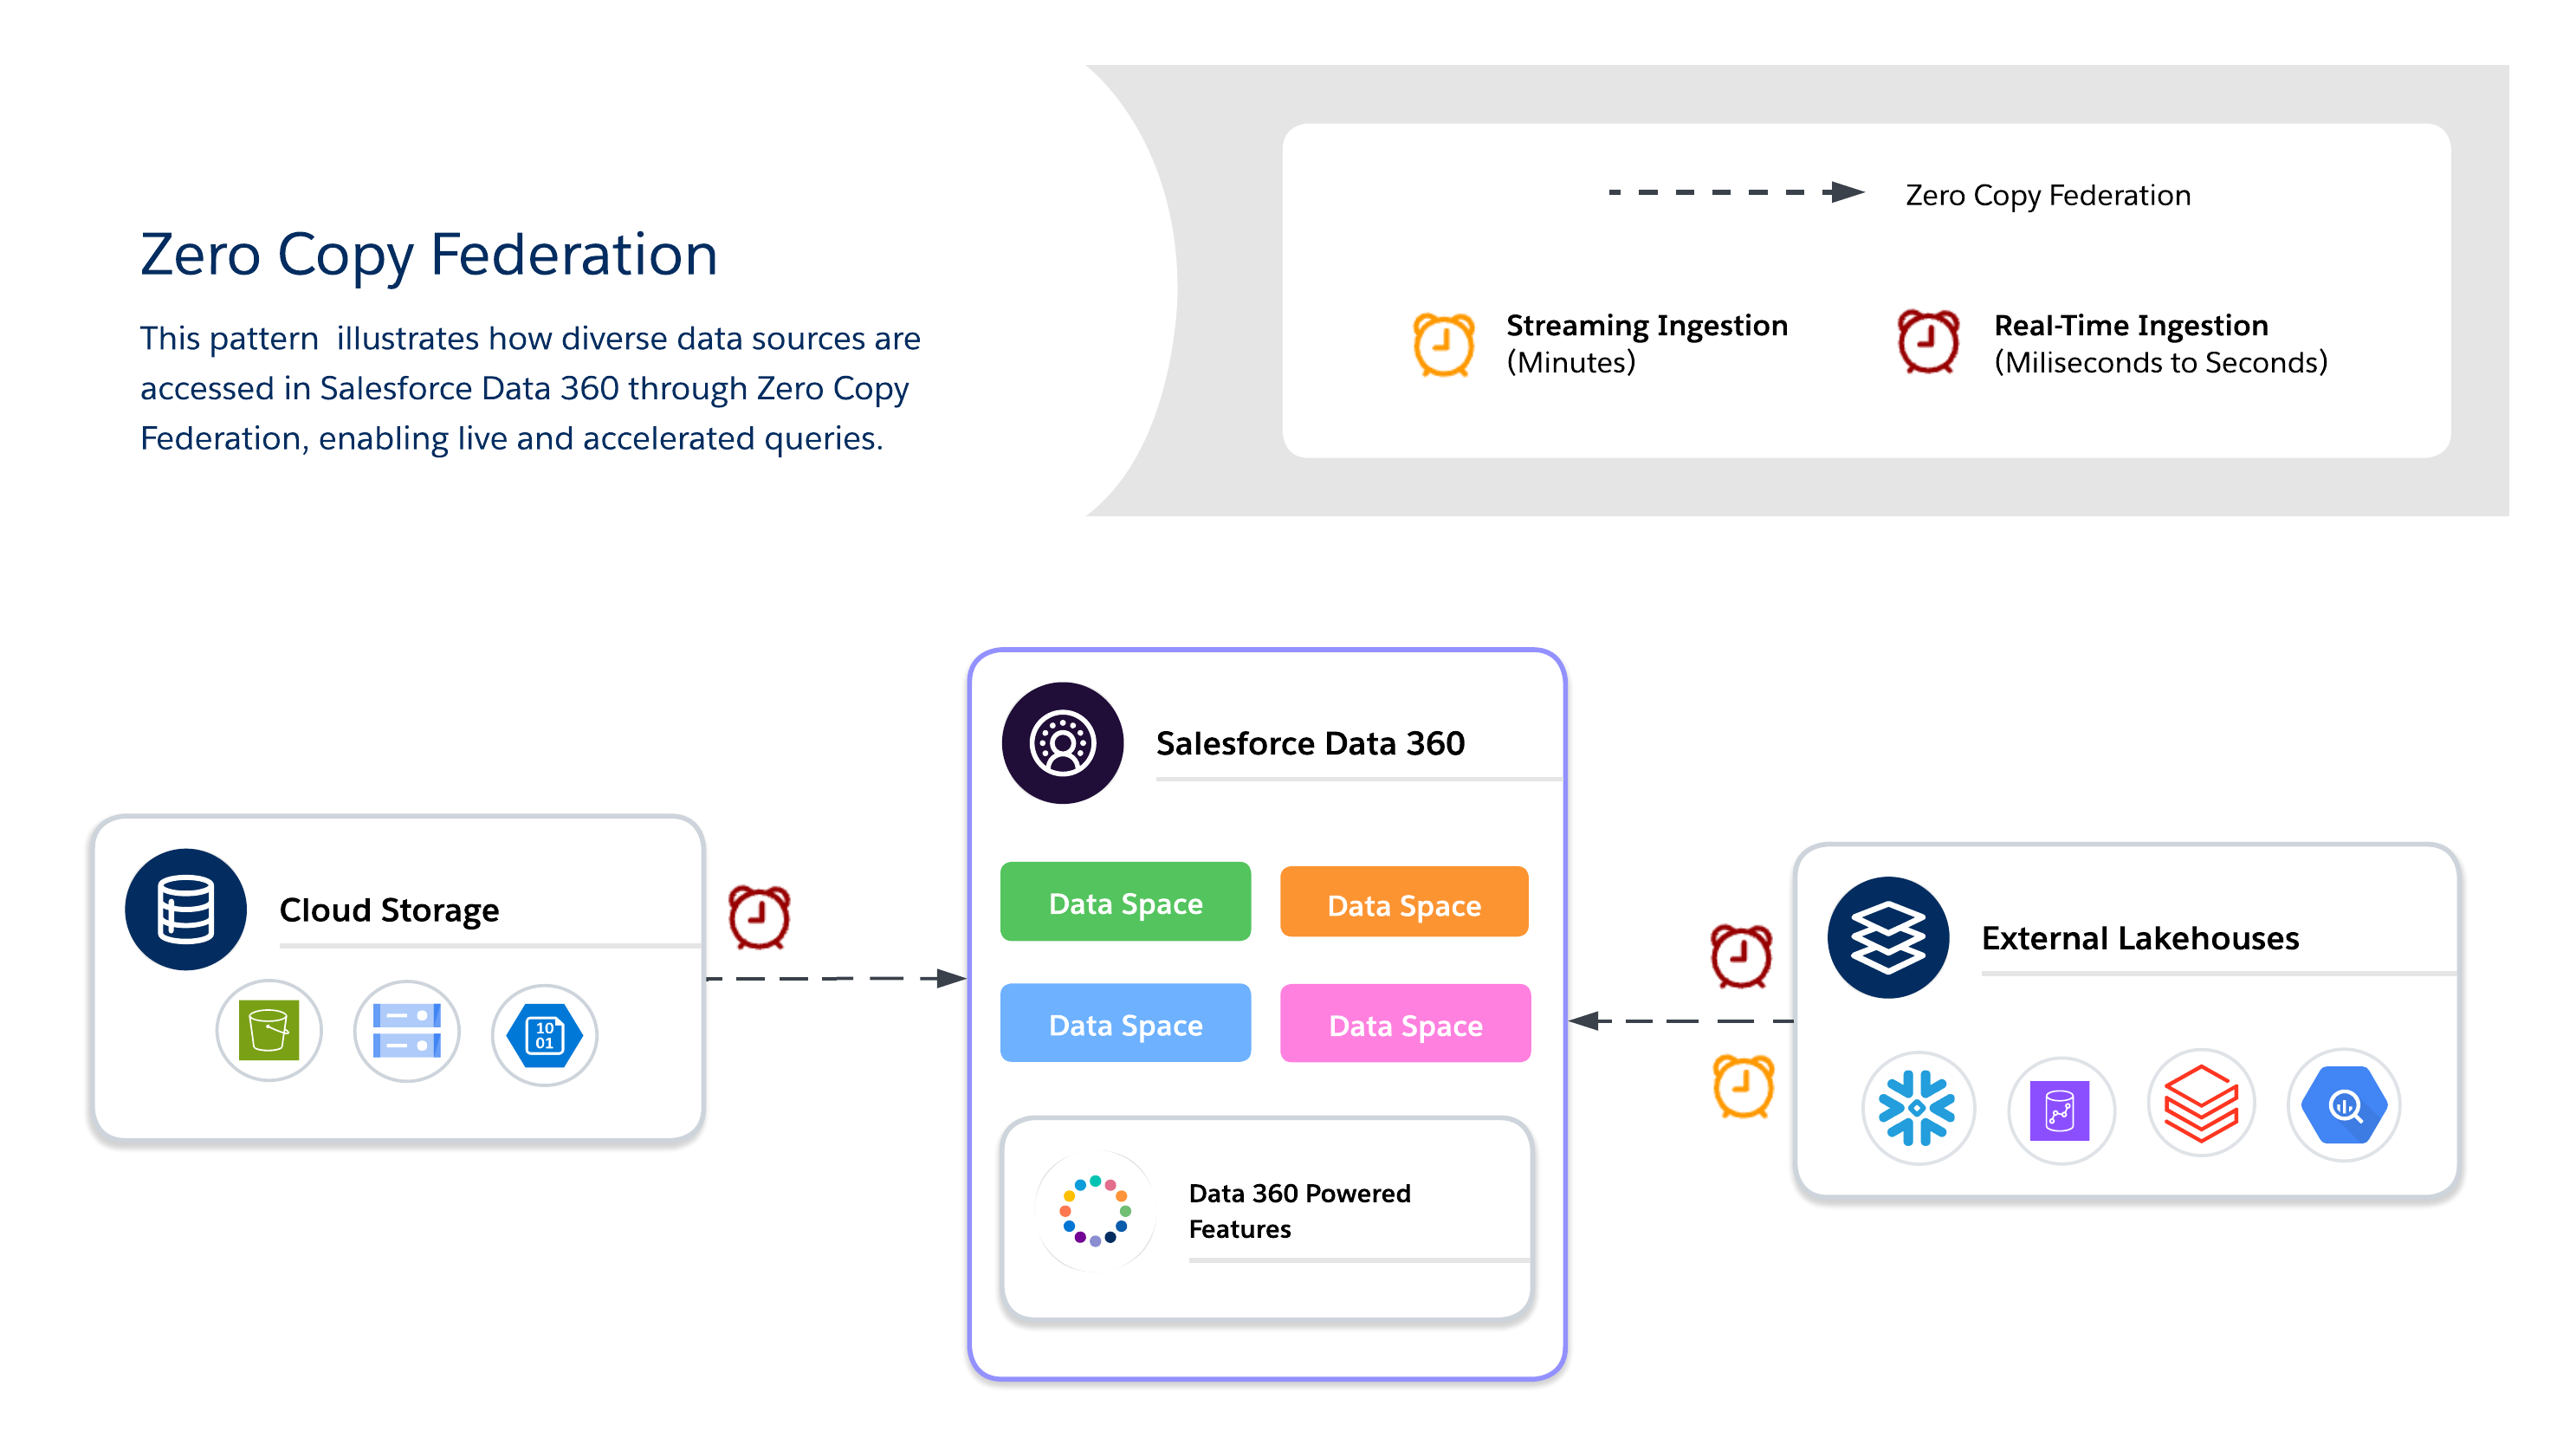
Bei Verwendung von Nullkopie müssen Architekten zwischen drei verfügbaren Datenverbundmethoden wählen, von denen jede ihre eigenen Kompromisse zwischen Aktualität, Leistung und Kosten bietet.
- Live-Abfrage
- Führt Abfragen direkt gegen externe Systeme (z. B. Snowflake, Google BigQuery, Redshift, Databricks usw.) ohne Datenduplizierung aus.
- Minimiert die Datenbewegung über das Netzwerk und reduziert die Ein- und Ausgänge bei der Salesforce Data 360-Berechnung. Dies ist optimal, wenn Prädikate und Aggregationen nach unten verschoben werden können.
- Geeignet für Echtzeitstatistiken und betriebliche Dashboards mit geringer Latenz.
- Abhängig von der Leistung des externen Systems.
- Zwischenspeicherung (beschleunigte Abfrage)
- Speichert temporär zwischengespeicherte Kopien von Verbunddaten in Salesforce Data 360.
- Reduziert wiederholte Abfragekosten und Latenz für häufig aufgerufene Datensets mit konfigurierbarer Dauer (Minuten bis Tage).
- Die Daten werden nicht dauerhaft kopiert oder vollständig verwaltet. Daher wird die Aktualisierung über geplante Aktualisierungen aus der Quelle verwaltet.
- Die inkrementelle Aktualisierung unterstützt nur das Einfügen von Aktualisierungen. Gelöschte Datensätze werden nicht aus dem Cache entfernt.
- Führen Sie regelmäßig eine vollständige Aktualisierung aus, um sicherzustellen, dass der Cache mit der Quelle synchron bleibt.
- Hinweis: Der _Snowflake-_Konnektor unterstützt die Funktion Entladen, die die Beschleunigungsraten durch Verwendung eines von Snowflake initiierten Staging-Buckets erhöht. Dies ist standardmäßig aktiviert, kann jedoch durch Bearbeiten der Verbindung deaktiviert werden.
- Dateiverbund
- Bietet direkten schreibgeschützten Zugriff auf umfangreiche Datensets in Objektspeichern (z. B. S3 und GCS mit Iceberg).
- Geeignet für AI/ML-Arbeitslasten, historische Analysen und Berichte auf Petabyte-Skala, ohne Daten verschieben zu müssen.
- Die Abfrageleistung hängt stark vom Objektformat, der Partitionierung und der Netzwerk-I/O ab. Große Scans können erhebliche E/A-Werte generieren, wenn sie nicht optimiert sind.
- Anwendungsfälle
- Echtzeitpersonalisierung und adaptive Workflows bieten dynamische Angebote, Empfehlungen und Next-Best-Aktionen, wenn sich das Kundenverhalten ändert.
- Live-Dashboards und operative Analysen unterstützen geschäftskritische Dashboards und KPIs direkt aus externen Lagerhäusern.
- AI/ML-Modelltraining mit großen externen Datensets nutzt Daten im Petabyte-Bereich aus Data Lakes und Lagerhäusern, ohne sie per Dateiverbund zu verschieben.
- Branchenszenarien
- Einzelhandel/Medien: Aktivieren Sie personalisierte Empfehlungen und Kundenengagement in Echtzeit, indem Sie Clickstream- oder Inhaltsinteraktionsdaten verknüpfen.
- Finanzen: Führen Sie Betrugserkennung und Risikobewertung nahezu in Echtzeit aus, indem Sie externe Lagerhäuser abfragen, ohne sensible Daten zu duplizieren.
- Tech/Enterprise: Unterstützen Sie cloudübergreifende Berichte, IT-Service-Dashboards und betriebliche Analysen, wenn sich Datensets in mehreren Systemen befinden.
- Designpraktiken
- Live-Abfrage
- Wird für Abfragen mit hoher QPS und geringer Latenz verwendet, wenn die Aktualisierung wichtig ist.
- Übertragen Sie Prädikate und Aggregationen an das externe System, um die Datenverlagerung über das Netzwerk zu reduzieren.
- Vermeiden Sie Abfragen, die unnötig große Datenvolumen scannen.
- Ziehen Sie stattdessen den Partitionszuschnitt und Filter in Betracht.
- Dateiverbund
- Greifen Sie ohne Aufnahme auf Datensets im Petabyte-Bereich in Objektspeichern zu.
- Minimieren Sie Latenz- und Ausgangskosten, indem Sie den Objektspeicher in derselben Cloud-Region wie die Salesforce-Berechnung aufbewahren.
- Verwenden Sie partitionierte Spaltenformate (Parquet/ORC) und Pushdown-Filter, um die E/A- und Netzwerkübertragung zu reduzieren.
- Nutzen Sie den Pushdown für Abfragen und Prädikate, um Daten an der Quelle zu filtern und zu aggregieren, wodurch die Datenbewegung reduziert wird.
- Vermeiden Sie regionsübergreifenden Datenzugriff – es sei denn, er ist unbedingt erforderlich –, da er I/O, Latenz und Kosten erhöht.
- Zwischenspeicherung (beschleunigte Abfrage)
- Zwischenspeichern häufig aufgerufener Datensets, um Kosten und Leistung in Einklang zu bringen.
- Konfigurieren Sie Aktualisierungsintervalle, um die Frische im Vergleich zu den Abfragekosten auszugleichen.
- Compliance: Erzwingen Sie die Governance an der Quelle, indem Sie Richtlinien zur Sicherheit auf Zeilenebene und Maskierung direkt in Verbundsystemen nutzen.
- Im Folgenden finden Sie einige bewährte Vorgehensweisen für einheitliches RLS und Maskierung über Plattformen hinweg:
- Verwenden Sie eine zentralisierte Unternehmens-ID. Ordnen Sie Benutzer und Einheiten in Salesforce Data 360 einer eindeutigen, zentralisierten Unternehmenskennung zu, die Identitäten in externen Systemen entspricht.
- Angleichen von Sicherheitsrichtlinien. Stellen Sie sicher, dass die Richtlinien für die Sprachausgabe und Maskierung in Verbundsystemen basierend auf der zugeordneten Identität angewendet werden. Dadurch wird die Compliance beim Abfragen externer Daten beibehalten.
- Standardisieren Sie Identitätsschemas. Verwalten Sie konsistente Identitätsattribute (E-Mail, Benutzer-ID, Kunden-ID usw.) über alle Datenquellen hinweg, um Inkonsistenzen und Zugriffsverletzungen zu vermeiden.
- Im Folgenden finden Sie einige bewährte Vorgehensweisen für einheitliches RLS und Maskierung über Plattformen hinweg:
- Live-Abfrage
- Überlegungen zu Kosten
- Live-Abfrage: Im Pay-per-Query-Modell fallen bei der Berechnung des externen Lake House Kosten an, die zu Spitzen mit hohem QPS führen können. Dies eignet sich für frischigkeitskritische Anwendungsfälle, in denen der Wert größer als die Kostenvariabilität ist.
- Beschleunigte Abfrage (Zwischenspeicherung): Diese Methode senkt die Abfragekosten (im Vergleich zur Live-Abfrage), indem Treffer im Quellsystem reduziert werden. Sie erhöht jedoch die Kosten für die Aufnahme von Batch-Daten beim Füllen und Aktualisieren des Cache. Dies eignet sich für häufig aufgerufene Datensets.
- Dateiverbund: Dies ist die günstigste Speicheroption als Daten im Objektspeicher. Die Abfragekosten hängen jedoch von der Dateigröße, der Partitionierung und dem Zuschnitt ab. Dies eignet sich für historische oder Massendaten im Petabyte-Maßstab.
| Entscheidungspunkt | Live-Abfrage | Zwischenspeicherung (beschleunigte Abfrage) | Dateiverbund |
|---|---|---|---|
| Datenquellenstandort | Externe Data-Lake-Häuser (z. B. Snowflake, Google BigQuery, Redshift und Databricks) | Externe Data-Lake-Häuser (z. B. Snowflake, Google BigQuery, Redshift und Databricks) | Objektspeicher oder Cloud-Data-Lakes (z. B. S3, ADLS und GCS), die häufig Open-Table-Formate wie Iceberg verwenden. |
| Zweck/Anwendungsfall | Geeignet für interaktive Analysen und Echtzeit-Dashboards. Geeignet für Echtzeitpersonalisierung und dynamische Workflows. | Geeignet für häufige Abfragen, aber leicht veraltete Ergebnisse sind akzeptabel. Geeignet für BI-Dashboards und Segmentierung. | Geeignet für die Batchverarbeitung im großen Umfang und für AI/ML-Modellschulungen. Geeignet für historische Analysen und Berichte auf Petabyte-Skala. |
| Frisch/Latenz | Bietet maximale Aktualität Führt Abfragen direkt in Echtzeit aus. Unterstützt Entscheidungen innerhalb von Sekunden, wenn das Quellsystem für Abfragen mit geringer Latenz und effektivem Pushdown für Prädikate optimiert ist. | Wird verwendet, wenn leicht veraltete Ergebnisse akzeptabel sind. Die Aktualisierung hängt vom Cache-Intervall ab, das zwischen 15 Minuten und 7 Tagen konfiguriert werden kann. | Geeignet für chargenintensive, durchsatzintensive Aufträge. Nicht für Echtzeit-Dashboards geeignet. |
| Zugriffsmuster | Geeignet für seltene oder Ad-hoc-Abfragen, bei denen die Aktualität entscheidend ist und das Abfragevolumen gering ist. Die Kosten steigen bei hoher QPS erheblich an. Daher ist es wichtig, die Zwischenspeicherung (beschleunigte Abfrage) auszuwerten, wenn die Abfragehäufigkeit hoch ist. | Geeignet für Szenarien mit hoher Lesehäufigkeit. Verbessert die Leistung bei häufigen Zugriffsmustern. | Bietet nur Lesezugriff. Geeignet für Datensets im Petabyte-Bereich ohne Aufnahme. |
| Leistungstreiber | Stark von der Leistung des externen Quellsystems abhängig. Geeignet für den Fall, dass Prädikate und Aggregationen an die Quelle übertragen werden können. | Verringert die Latenz im Vergleich zu wiederholten Live-Abfragen. Die Leistung hängt von der Cache-Verwaltung und den Intervallen ab. | Die Leistung hängt stark vom Objektformat, der Partitionierung und dem externen Systemdurchsatz ab. Verwenden Sie partitionierte, spaltenförmige Formate (Parquet/ORC). |
| Kostenauswirkungen | Hierbei handelt es sich um ein Pay-per-Query-Modell. Daher fallen bei externen Lake House-Berechnungen Kosten an. Dies ist für seltene Abfragen kosteneffektiv, kann jedoch bei hohem QPS-Volumen zu hohen Ausgaben führen. | Die Kosten sind niedriger als bei wiederholten Live-Abfragen. Dadurch müssen die externen Quellen nicht mehr wiederholt abgefragt werden, es werden jedoch Cache-Speicher und Aktualisierungs-Overhead hinzugefügt. | Dies ist die günstigste Speicheroption. Bei AWS-Setups mit derselben Region (z. B. S3 in US-Ost-1 mit einem _Data Cloud-_Mandanten, der sich ebenfalls in US-Ost-1 befindet) werden die Gutschriften für die Zeilen, auf die zugegriffen wird, nicht verbraucht. Regions- oder Cloud-übergreifende Konfigurationen (z. B. Azurblau, GCS oder verschiedene _AWS-_Regionen) führen zu einem Gutschriftsverbrauch für die Zeilen, auf die zugegriffen wird. Die Abfragekosten hängen auch von der Dateigröße, der Partitionierung und der Optimierung des Prädikat-Pushdowns ab. |
| Wichtige Überlegungen | Vermeiden Sie ungefilterte Abfragen, die unnötig große Datenvolumen scannen. | Für diesen Ansatz ist eine Cache-Verwaltung erforderlich. Nicht für Entscheidungen im Sekundenbereich geeignet. | Die Abfrageleistung hängt stark von der Optimierung über Partitionierung und Pushdown-Prädikate ab. |
Mit hybriden Architekturen können Architekten wichtige Datensets in Data 360 verankern und gleichzeitig Verbundabfragen für Aktualität, reduzierte Duplikate und skalierbaren Zugriff auf große externe Datensets nutzen. Bei diesem Ansatz werden die Anforderungen an E/A, Berechnungslokalität, Kosten und Compliance abgewogen.
Verwenden Sie einen hybriden Ansatz für ausgewogene Verwaltung, Aktualität und betriebliche Effizienz, indem Sie Datenaufnahme und Nullkopie kombinieren, um handlungsrelevante Statistiken in Echtzeit bereitzustellen. Verwenden Sie die Aufnahme für hochwertige, regulierte Datensets, bei denen Rückverfolgbarkeit, RLS und Maskierung erforderlich sind, und die Zuordnung für vorübergehende Datensets oder Datensets mit hohem Volumen, bei denen Aktualität und Leistung entscheidend sind.
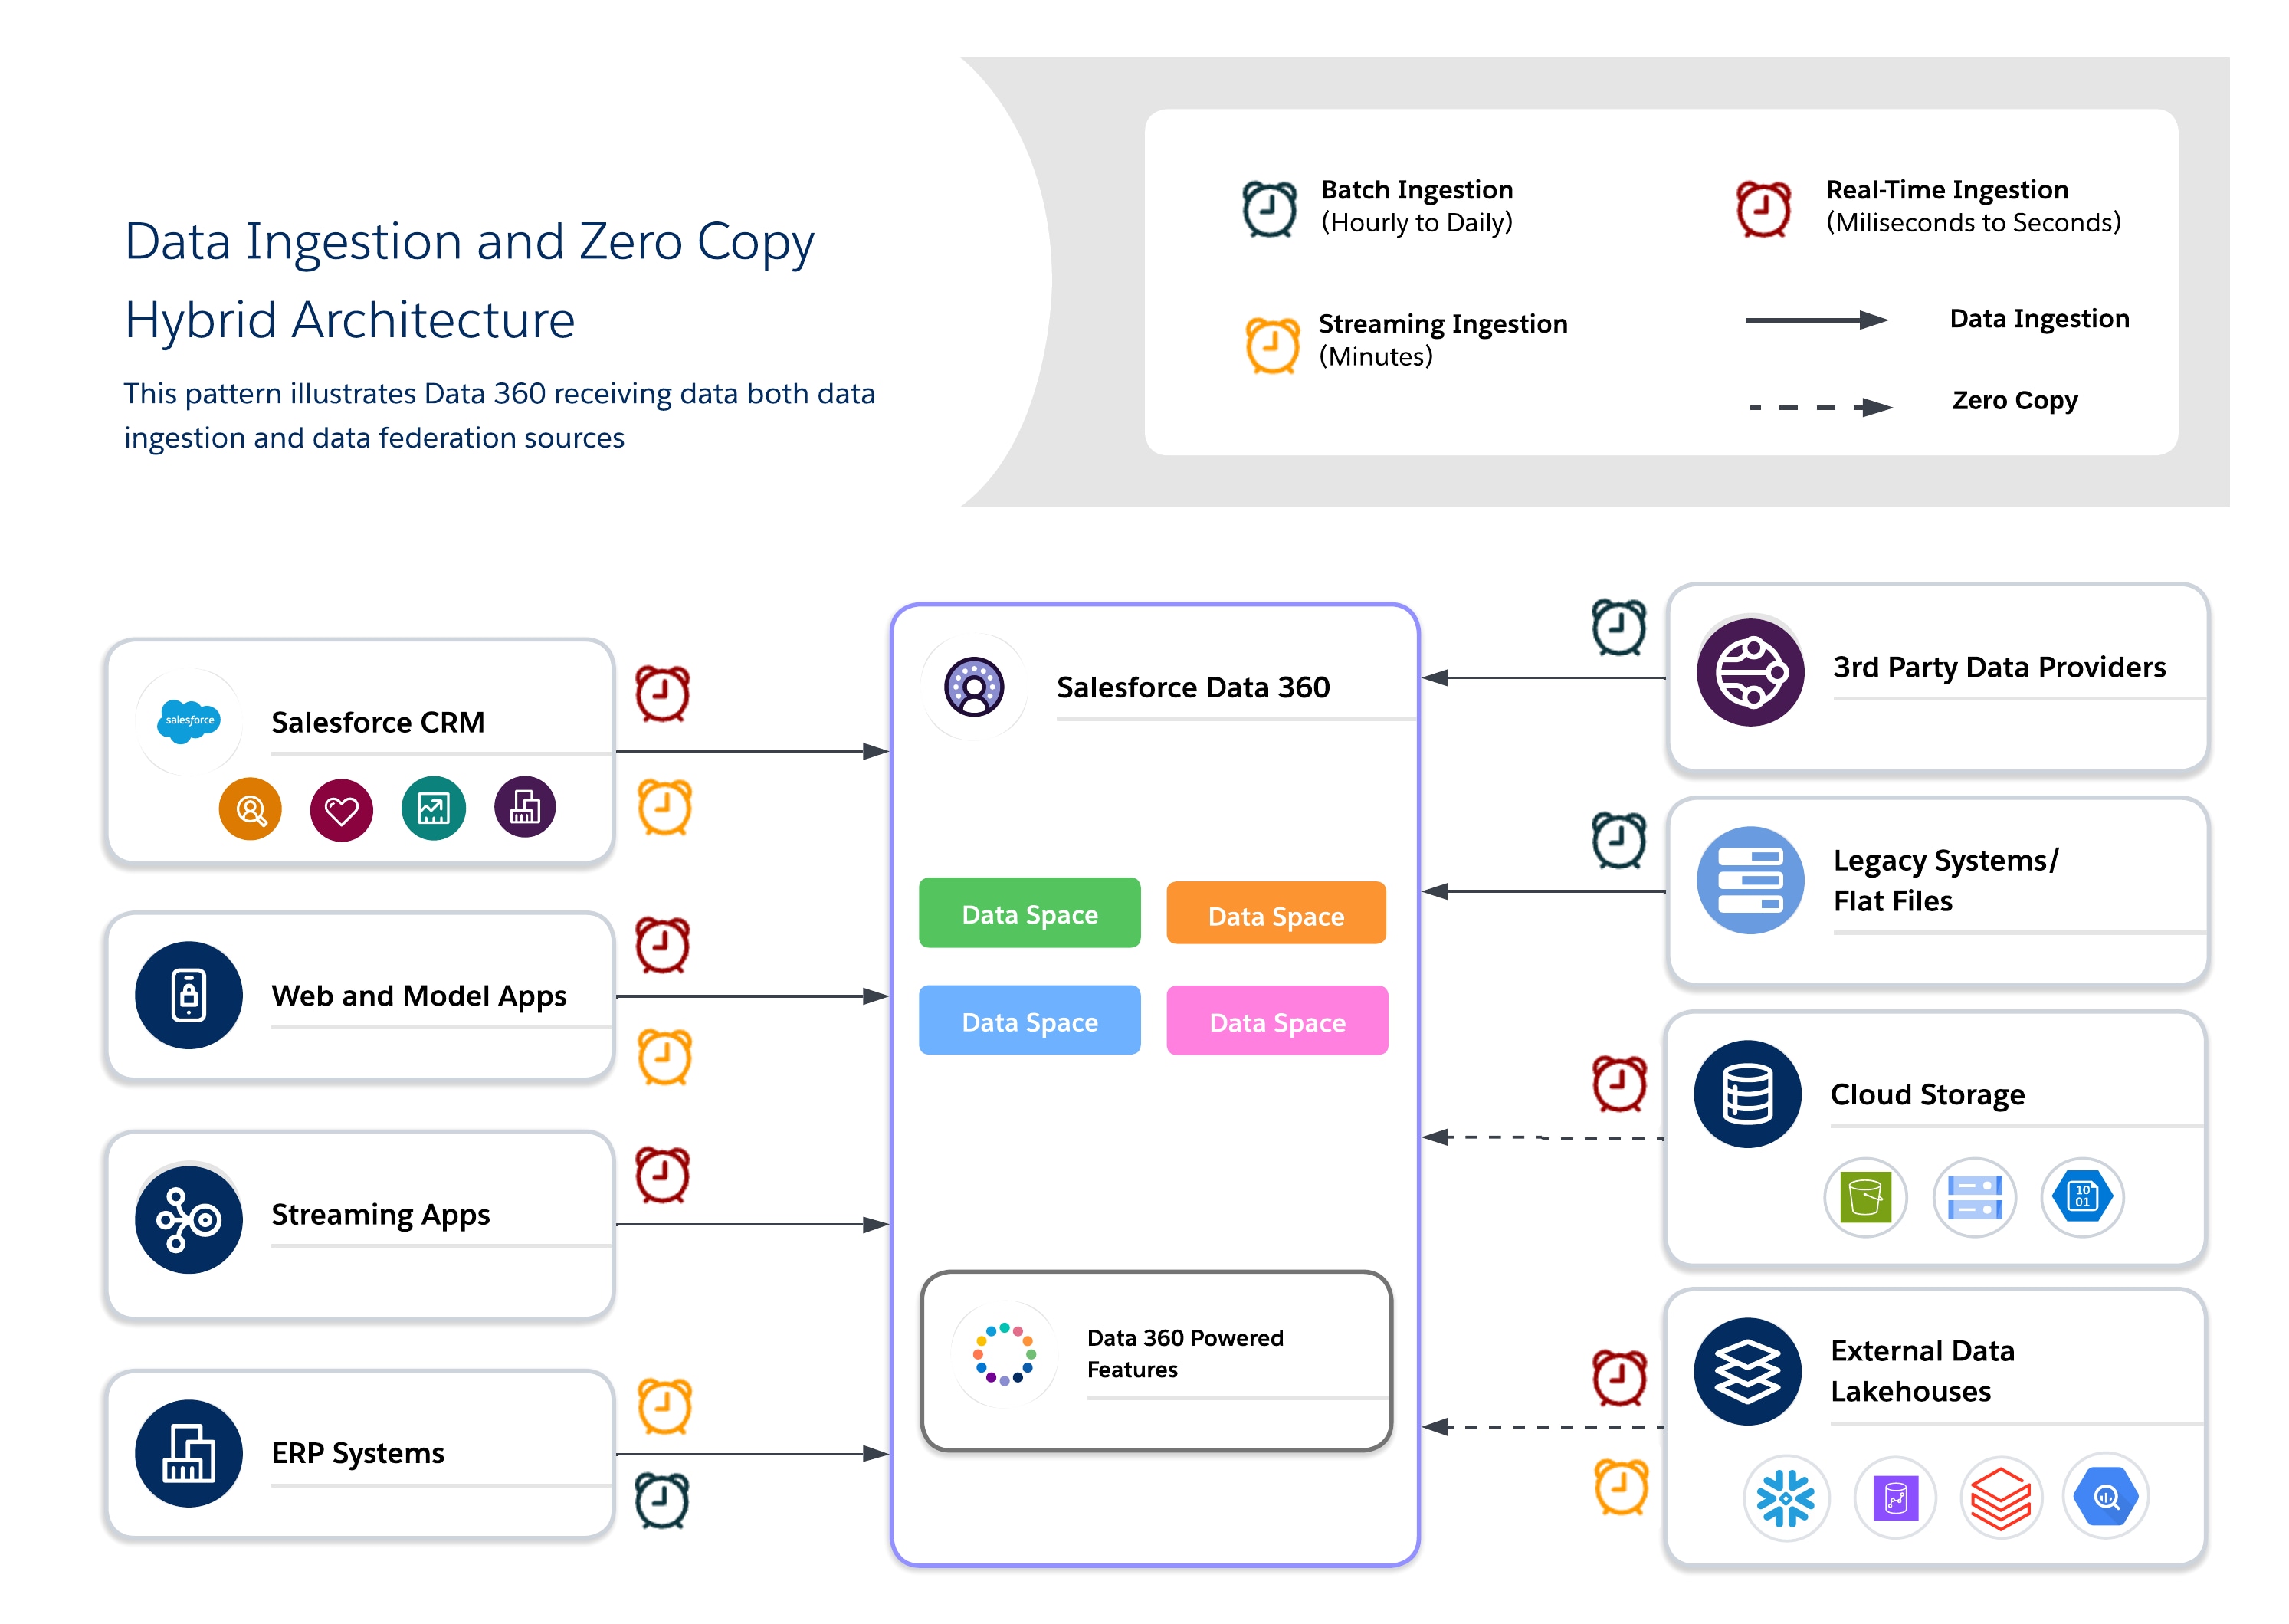
- Anwendungsfälle
- Omnikanal-Engagement: Kombinieren Sie historische Kundendaten mit Echtzeitverhalten, um konsistente, kontextbezogene Erfahrungen bereitzustellen.
- AI/ML-Pipelines: Trainieren Sie Modelle für zusammengestellte kanonische Datensets und reichern Sie sie mit Roh- oder Echtzeitsignalen aus externen Quellen an.
- Kombinierte Compliance- und Agilitätsanforderungen: Wenden Sie strenge Governance-Vorschriften für sensible Daten an und eine Verbundorganisation für betriebliche Agilität.
- Branchenszenarien
- Einzelhandel: Verwenden Sie die Integration für die Identitätsbestimmung und die Profilvereinheitlichung und die Zuordnung für Echtzeitangebote und Personalisierung.
- Gesundheitswesen: Verwalten Sie goldene Patientenakten per Integration, während Sie eine Verbundverbindung für IoT-Geräteströme und Sensordaten verwenden, um einen unmittelbaren Kontext zu erhalten.
- Financial Services: Nehmen Sie regulierte Daten in einen konformitätsgesteuerten See auf, während Sie den Verbund für externe Abfragen zur Betrugserkennung und Risikoüberwachung verwenden.
- Designpraktiken
- Anker-Governance mit Aufnahme: Nehmen Sie hochwertige oder regulierte Daten in kanonische Modelle auf, um Trust und Compliance zu gewährleisten.
- Verbund für Frische verwenden: Ermöglicht es externen Lake Houses, Datenzugriff in Echtzeit oder in großem Umfang ohne Duplikate bereitzustellen.
- Balance Cost vs Performance (Saldokosten im Vergleich zur Leistung): Profilarbeitslasten, um zu bestimmen, wann die Aufnahme im Vergleich zum Verbund verwendet werden soll, wodurch unnötige Speicher- und Abfragekosten minimiert werden.
- Anwenden der mehrschichtigen Unternehmensführung: Erzwingen Sie die zentralisierte Verwaltung für aufgenommene Daten und nutzen Sie gleichzeitig die Sicherheitssteuerungen für Verbundsysteme (z. B. RLS und Maskierung).
- Hinweis: Wenn Sie hybride Pipelines entwerfen, ist es wichtig, die inkrementelle Aufnahme historischer Datensets sicherzustellen und Aggregationen oder Filter an Verbundquellen zu übertragen, um die E/A- und Berechnungsnutzung zu optimieren.
- Überlegungen zu Kosten
- Wägen Sie die Gesamtkosten im Vergleich zur Leistung ab, indem Sie die Aufnahme für Compliance- oder wichtige Daten mit dem Verbund kombinieren, wenn eine Aktualisierung erforderlich ist.
- Berücksichtigen Sie die E/A- und Berechnungsverteilung beim Mischen von Aufnahme und Verbund. Verwenden Sie die Zwischenspeicherung (beschleunigte Abfrage) für Verbunddatensets mit hohem Lesezugriff, um die Rechenkosten für wiederholte Abfragen in Quellsystemen zu reduzieren.
- Verwenden Sie diese Regel, um die Entscheidung über die Aufnahme im Vergleich zum Verbund festzulegen: Wenn häufig auf Daten zugegriffen wird, sich diese jedoch selten ändern, ist die beschleunigte Abfrage in der Regel kostengünstiger. Wenn sich die Daten jedoch häufig ändern (bezogen auf die Zugriffshäufigkeit), ist die Live-Abfrage oder -Aufnahme besser geeignet. Hier einige Kostenbeispiele:
- Beschleunigungsgewinne: Ein Dashboard, das aus 1 Million Datensätzen erstellt und täglich mit etwa 10.000 Änderungen aktualisiert wird, wird 20 Mal pro Tag angezeigt. Die Beschleunigungskosten belaufen sich auf etwa 600 Gutschriften/Monat im Vergleich zu 4.200 Gutschriften/Monat für Live-Abfragen.
- Live-Abfrage gewinnt: Segmente, die 20 Mal pro Tag veröffentlicht werden und Daten verwenden, die sich alle 30 Minuten ändern. Live-Abfragen kosten etwa ~4.200 Credits/Monat im Vergleich zu ~28.800 Credits/Monat für die Beschleunigung bei dieser Aktualisierungshäufigkeit.
Sehen wir uns einige gängige Archetypen genauer an, die die Anwendung dieser Logik veranschaulichen.
- Der Archetyp “Single Source of Truth” (Einzelne Datenquelle): Zentralisieren und Verwalten
- Szenario: Sie müssen kompatible, vereinheitlichte Customer 360 Profile für Ihr gesamtes globales Unternehmen erstellen. Die Daten stammen aus einem Dutzend verschiedener Systeme, müssen strenge DSGVO- und _CCPA-_Vorschriften einhalten und dienen als Quelle der Wahrheit für alle Marketing- und Serviceinteraktionen.
- Empfohlenes Muster: Datenaufnahme. Hier stehen Governance, Trust und Kontrolle im Vordergrund. Die Aufnahme der Daten in Data 360 ist die einzige Möglichkeit, ein vollständig überprüfbares, kanonisches Profil zu erstellen, das von den Quellsystemen isoliert ist.
- Der Archetyp “Echtzeitstatistiken”: Analysieren ohne Verschieben
- Szenario: Ihr Data Science-Team muss Erkundungsabfragen für eine massive, ständig aktualisierte Transaktionstabelle in Snowflake ausführen. Gleichzeitig möchte Ihr Führungsteam ein Live-_BI-_Dashboard, das auf denselben Daten basiert. Das tägliche Verschieben von Petabyte Daten ist langsam und teuer.
- Empfohlenes Muster: Zero Copy Federation. Die Priorität liegt dabei auf Geschwindigkeit, Agilität und Kosteneffizienz im richtigen Maßstab. Mit Zero Copy können Sie die Leistungsfähigkeit Ihres vorhandenen Data Warehouse für Echtzeitabfragen nutzen, ohne den Aufwand und die Latenz der Datenduplizierung zu erhöhen.
- Der Archetyp “Hybridintelligenz”: Verwalten des Kerns, Zusammenführen des Kerns
- Szenario: Sie möchten Ihre verwalteten, aufgenommenen Kundenprofile mit Echtzeit-Verhaltenssignalen (z. B. Website-Klicks) aus einem Data Lake anreichern. Sie benötigen die Stabilität des Kernprofils, aber die Unmittelbarkeit der Live-Daten, um die sofortige Personalisierung zu unterstützen.
- Empfohlenes Muster: Ein hybrider Ansatz. Verwenden Sie die Datenaufnahme, um einen stabilen, geregelten Kern für Ihre Kundendaten zu erstellen. Verwenden Sie Nullkopie, um die volatilen Echtzeit-”Edge”-Daten zu verknüpfen und dann zur Abfragezeit miteinander zu verknüpfen, um eine vollständige, sekundengenaue Ansicht zu erhalten.
Bei der Unternehmensdatenstrategie geht es nicht mehr darum, ein einzelnes Integrationsmuster auszuwählen, sondern darum, kontrollierte Flexibilität in einem interoperablen Datenökosystem zu entwickeln. Der richtige Ansatz ordnet jedes Quellsystem dem Muster zu, das seinen Anforderungen an Aktualität, Verwaltung, Kosten und Zugriff am besten entspricht:
- Nehmen Sie geschäftskritische, regulierte Datensets in Salesforce Data Cloud auf, um Compliance, Identitätsbestimmung und betriebliche Workflows zu gewährleisten.
- Verbinden Sie Daten über Nullkopie für Live-, explorative und AI-gestützte Analysen, ohne Speicher zu duplizieren.
- Anwenden von Caching (beschleunigte Abfrage) zum Reduzieren der Quellsystemlast und des Guthabenverbrauchs bei hoher Abfragehäufigkeit und niedriger Datenänderungshäufigkeit
Salesforce Data 360 in Hyperforce bietet Widerstandsfähigkeit und Skalierbarkeit für mehrere Regionen. Das offene Lake House mit _Iceberg-_Tabellen ermöglicht die Berechnungstrennung und Interoperabilität mit Plattformen wie Snowflake, Databricks und S3 Iceberg, die das Rückgrat eines wirklich interoperablen Multi-Cloud-Datenökosystems bilden.
Während sich Datenökosysteme weiterentwickeln, müssen wir kontinuierlich zwischen Aktualität, Kosten, Leistung und Compliance abwägen, um die architektonische Agilität aufrechtzuerhalten. Daher ist es wichtig, Ihre Plattform zukunftssicher zu gestalten, indem erfasste, geregelte Daten mit Verbundzugriff vereinheitlicht werden. Dies ermöglicht Echtzeitintelligenz, AI-Aktivierung und Personalisierung im Unternehmensbereich über Clouds, Regionen und Geschäftsdomänen hinweg.
Beachten Sie, dass Lösungen für die einheitliche Größe für die meisten Unternehmen nicht geeignet sind. Die optimale Strategie ordnet das richtige Muster dem richtigen Geschäftstreiber zu.
Yugandhar Bora ist Software-Entwickler bei Salesforce und hat sich auf die Datenarchitektur innerhalb der Plattform für Daten- und Intelligenzanwendungen spezialisiert. Er leitet Initiativen des Enterprise Architecture Review Board (EARB), die sich auf Datenverwaltung und vereinheitlichte Datenmodelle konzentrieren und gleichzeitig zu automatisierten Plattformbereitstellungslösungen beitragen.
Jan Fernando ist Principal Architect im Office of the Chief Architect (OCA) bei Salesforce und seit 2012 bei Salesforce tätig. Vor seiner Tätigkeit beim OCA war er über ein Jahrzehnt in der Plattformorganisation tätig, wo er mehrere wichtige Technologietransformationen leitete.