Introduktion
Bemærk: “Emner” er blevet omdøbt til “underagenter” i hele artiklen i henhold til vores seneste produktnavngivningskonventioner.
Du kan opbygge en agent, der klarer sig godt i et testmiljø, kun for at få den til at følge helt forskellige ruter, når den behandler det samme arbejdsflow to gange. Denne grundlæggende begrænsning viser, hvordan den tidligere Agentforce håndterede kørsel: hver beslutning, fra hensigtsfortolkning til handlingsvalg, blev truffet i realtid af LLM, uden nogen garanteret sti gennem arbejdsflowet.
LLM’er kan oprette inkonsekvente resultater som reaktion på identiske input. Subtile variationer i kontekst, systemmeddelelser eller tokengenerering er nok til at sende en agent en anden rute. For mange interaktioner er denne variation acceptabel. Men for arbejdsflows med flere faser, der kræver revision, reproducerbarhed og sporbarhed, er det ikke. En lånegodkendelse, en lageroverførsel eller en patientproces kan ikke afhænge af, at en agent begrunder sin vej gennem trinene forskelligt hver gang.
Den nye Agentforce Builder og Agent Script håndterer dette problem ved at adskille deterministisk eksekvering fra LLM-argumentation. Agentforces hybridmodel sikrer, at agenten følger en præcist defineret struktur for hver arbejdsflowkørsel, mens han/hun stadig bruger LLM-argumentation, hvor der virkelig er brug for dømmekraft, forståelse af naturligt sprog eller kontekstmæssig fortolkning.
I den tidligere version af Agentforce fungerede en agent som en simpel reaktiv løkke. Hver beslutning, fra at fortolke hensigten til at vælge den næste handling, blev truffet i realtid af LLM baseret udelukkende på brugerens seneste input. Der var ingen garanteret kørselssti, ingen vedvarende tilstand og ingen mekanisme til at håndhæve en række trin.
Kørselsveje kunne ikke garanteres
Da hver beslutning afhænger af LLM’s realtidsarrangering, producerede mindre variationer i input, systemmeddelelse eller modelversion forskellige handlingsvalg på identiske anmodninger. Dette gjorde den foregående model vanskelig at teste grundigt: et arbejdsflow, der blev overført i faseinddeling, kunne optræde anderledes i produktion, og der findes ingen pålidelig måde til at gengive en specifik kørselssti til fejlfinding eller revisionsformål.
Hver interaktion betalte den fulde LLM omkostninger
Selv enkle samtalesscenarier krævede mindst tre LLM-cyklusser: Underagentvalg, handlingsvalg og endelig svargenerering. Opgaver med flere trin, der er udvidet til fem eller flere cyklusser. For arkitekter, der designer højvolumen eller forsinkelsessensitive arbejdsflows, var dette ikke kun et problem med ydeevne. Det betød, at du ikke kunne afkorte grundlæggende løkke for trin, der ikke krævede bedømmelse, fordi arkitekturen ikke havde nogen mekanisme til at skelne mellem de to.
Ikke-deterministisk udførelse skabte et revisionsmangel
I regulerede brancher betyder revisionsmulighed at kunne demonstrere, at en bestemt proces blev fulgt på en bestemt måde for en bestemt transaktion. En rent ikke-deterministisk model kan ikke give denne garanti. Hvis kørselsstien varierer mellem kørsler, varierer revisionssporet også, og “agenten besluttede” er ikke et svar, der kan forsvares i en overensstemmelsesgennemgang.
Staten overlevede ikke samtalen
Afhængighed af en enkelt drejningsbehandling betød, at agenten ikke havde nogen vedvarende hukommelse af tidligere trin. Hvis samtalen afviger en smule, kan agenten slippe tidligere registreret kontekst og tvinge brugeren til at genstarte. For transaktionelle arbejdsflows med flere trin oprettede dette en tillidstærskel: Jo flere trin i processen, desto større sandsynlighed for konteksttab før fuldførelse.
Fuldførte trin huskes ikke
Uden statsadministration havde agenter ingen registrering over, hvilke obligatoriske trin en bruger allerede havde fuldført. Dette producerede en uforudsigelig løkke, hvor en agent ville vende tilbage til et trin, som brugeren allerede havde fuldført. Udover brugeroplevelsespåvirkningen oprettede dette et dybere arkitektonisk problem: at designe et pålideligt sekventielt arbejdsflow var umuligt, da agenten ikke kunne håndhæve sekvensen.
Den nye Agentforce, GA siden februar 2026, skifter fra rent sandsynlighedsløsninger til en hybrid model. I stedet for at distribuere alle beslutninger gennem LLM, adskiller det deterministisk kørsel fra LLM-justering og lader hver håndtere kun det, det er egnet til. Til støtte heraf introducerede Agentforce to redigeringsværktøjer: Agent Script til kodebaseret udvikling og Agentforce Studio, et miljø uden kode.
Agentforce-konstruktør
Agentforce Builder er det anbefalede miljø til udvikling af nye agenter. Den hostes i Agentforce Studio og erstatter den ældre opsætningsoplevelse, som stadig er tilgængelig, men som ikke længere er den primære oprettelsesti. I konstruktøren arbejder du enten i en visuel lærredsvisning eller direkte i scriptvisning og redigerer det agentscript, der definerer din agents adfærd.
Agentscript
Agentsscript er et deklarativt domænespecifikt sprog (DSL), der definerer alt om, hvordan en agent optræder: dens konfiguration, forretningslogik og meddelelse. Det er struktureret som nøgle-værdi-par, der kan strække sig over flere linjer eller indeholde indlejrede underegenskaber, og det er designet til at være menneskelæsbart uden at kræve Knowledge af den underliggende grafarkitektur.
Agentsscript giver dig mulighed for at udtrykke to grundlæggende forskellige typer instruktioner i den samme agent: deterministiske logikinstruktioner og meddelelsesinstruktioner. Deterministiske logikinstruktioner definerer betingelser og handlingssekvenser, der køres som kode uden LLM-engagement. Meddelelsesinstruktioner definerer naturlig sprogvejledning, som LLM fortolker på kørselstidspunktet. Grænsen mellem de to er eksplicit og bevidst, og det er en af de grundlæggende designbeslutninger, du skal træffe, når du bygger med den nye Agentforce.
Deterministisk logik i praksis
Når instruktioner er deterministiske, følger agenten en defineret kørselssti, uanset hvordan brugeren udtrykker sit input. Eksemplet nedenfor viser en underagent, der indlæser et Kundeintelligens. Den kontrollerer for et kunde-id, henter profildata, bestillingshistorik og supportbilletter og beregner derefter kundelivsværdien og afgangsrisikoen. Ingen af disse trin kræver LLM-arrangering.
Denne logik kalder handlinger i en fast rækkefølge, hver gang bestemte betingelser opfyldes.
Prompt instruktioner og bevidst LLM afvisning
Hvor deterministisk logik håndterer betingelser og sekvenser, der kan udtrykkes som kode, håndterer meddelelsesinstruktioner alt, der kræver dom, fortolkning eller naturlig sproggenerering. Når Atlas Reasoning Engine støder på en node med meddelelsesinstruktioner, udløser det et LLM-kald. Når det ikke gør, udføres det deterministisk.
Eksemplet nedenfor viser en underagent for produkt og tjenester. Instruktionerne er en meddelelse på flere linjer, der fortæller LLM, hvordan de skal reagere, hvornår de skal slå oplysninger op, og hvordan de skal håndtere tvetydighed. Dette er det rigtige mønster, når området af mulige brugerinputs er for bredt til at forudsige med betinget logik, eller når kvaliteten af svaret afhænger af LLM’s evne til at fortolke kontekst og generere et naturligt svar.
Meddelelsesinstruktionerne på en node udløser LLM-kaldet. Det er ikke hændelsesmæssigt – det er den mekanisme, som agentscript gør LLM-grænsen eksplicit og håndhævbar, snarere end at lade den udledes på kørselstidspunktet.
Denne underagent viser deterministisk logik og LLM-håndtering i aktion.
Den tre-trins eksekvering pipeline
Agentforce Builder og Agent Script er oprettelseslaget, men Agent Graph og Atlas Reasoning Engine kører faktisk din agent. Ingen af disse komponenter er direkte tilgængelige for dig. Adskillelse af oprettelse og kørsel gør det muligt for platformen at håndhæve deterministisk adfærd, uanset hvordan scriptet blev skrevet.
Pipelinen gennemgår tre faser.
- Forfatteren er dit job. Agentscript er nemt at læse og kan redigeres i enten lærredsvisning eller scriptvisning i Agentforce. Dette er det eneste lag, du interagerer med direkte.
- Kompilering er det sted, hvor Salesforce-kompilatoren transformerer dit agentscript til et agentdiagram, en serialiseret kørselsplan, der er optimeret til maskinudførelse snarere end menneskelig læsbarhed. Du fejlfinder ikke på dette lag. Kompilation opretter en repræsentation, som kørselstiden kan gennemgå effektivt.
- Kørselsudførelse er det sted, hvor Atlas Reasoning Engine overtager. Den læser agentdiagrammet, gennemgår det baseret på den aktuelle sessionstilstand og beslutter ved hver node, om det skal udføres deterministisk eller kaldes LLM. Systemet håndhæver eksplicit vagtsætninger og betinget distribution her i stedet for at udlede.
Agentdiagram
Agentdiagram er den mellemliggende repræsentation, der findes mellem dit menneskelæste script og den faktiske kørsel på kørselstidspunktet. Dens struktur er optimeret til den statsmaskin, der forbruger den, ikke til den arkitekt, der oprettede scriptet. Forståelse af, at den findes, og hvad den repræsenterer, betyder noget, fordi det er den artefakt, som Årsagssystem bruger til at håndhæve den kørselsplan, dit script definerer.
Atlas Reasoning Engine
Atlas Reasoning Engine er en maskinudfører af stat. På hver tur gennemgår den agentdiagrammet baseret på sessionstilstand, eksekverer deterministiske noder som kode og udløser kun LLM-kald, hvor der findes meddelelsesinstruktioner. Den håndhæver også vagtsætninger og håndterer betinget distribution. Årsagssystemet er det sted, hvor hybridregnskabsmodellen faktisk implementeres. Scriptet definerer grænsen, og systemet respekterer den.
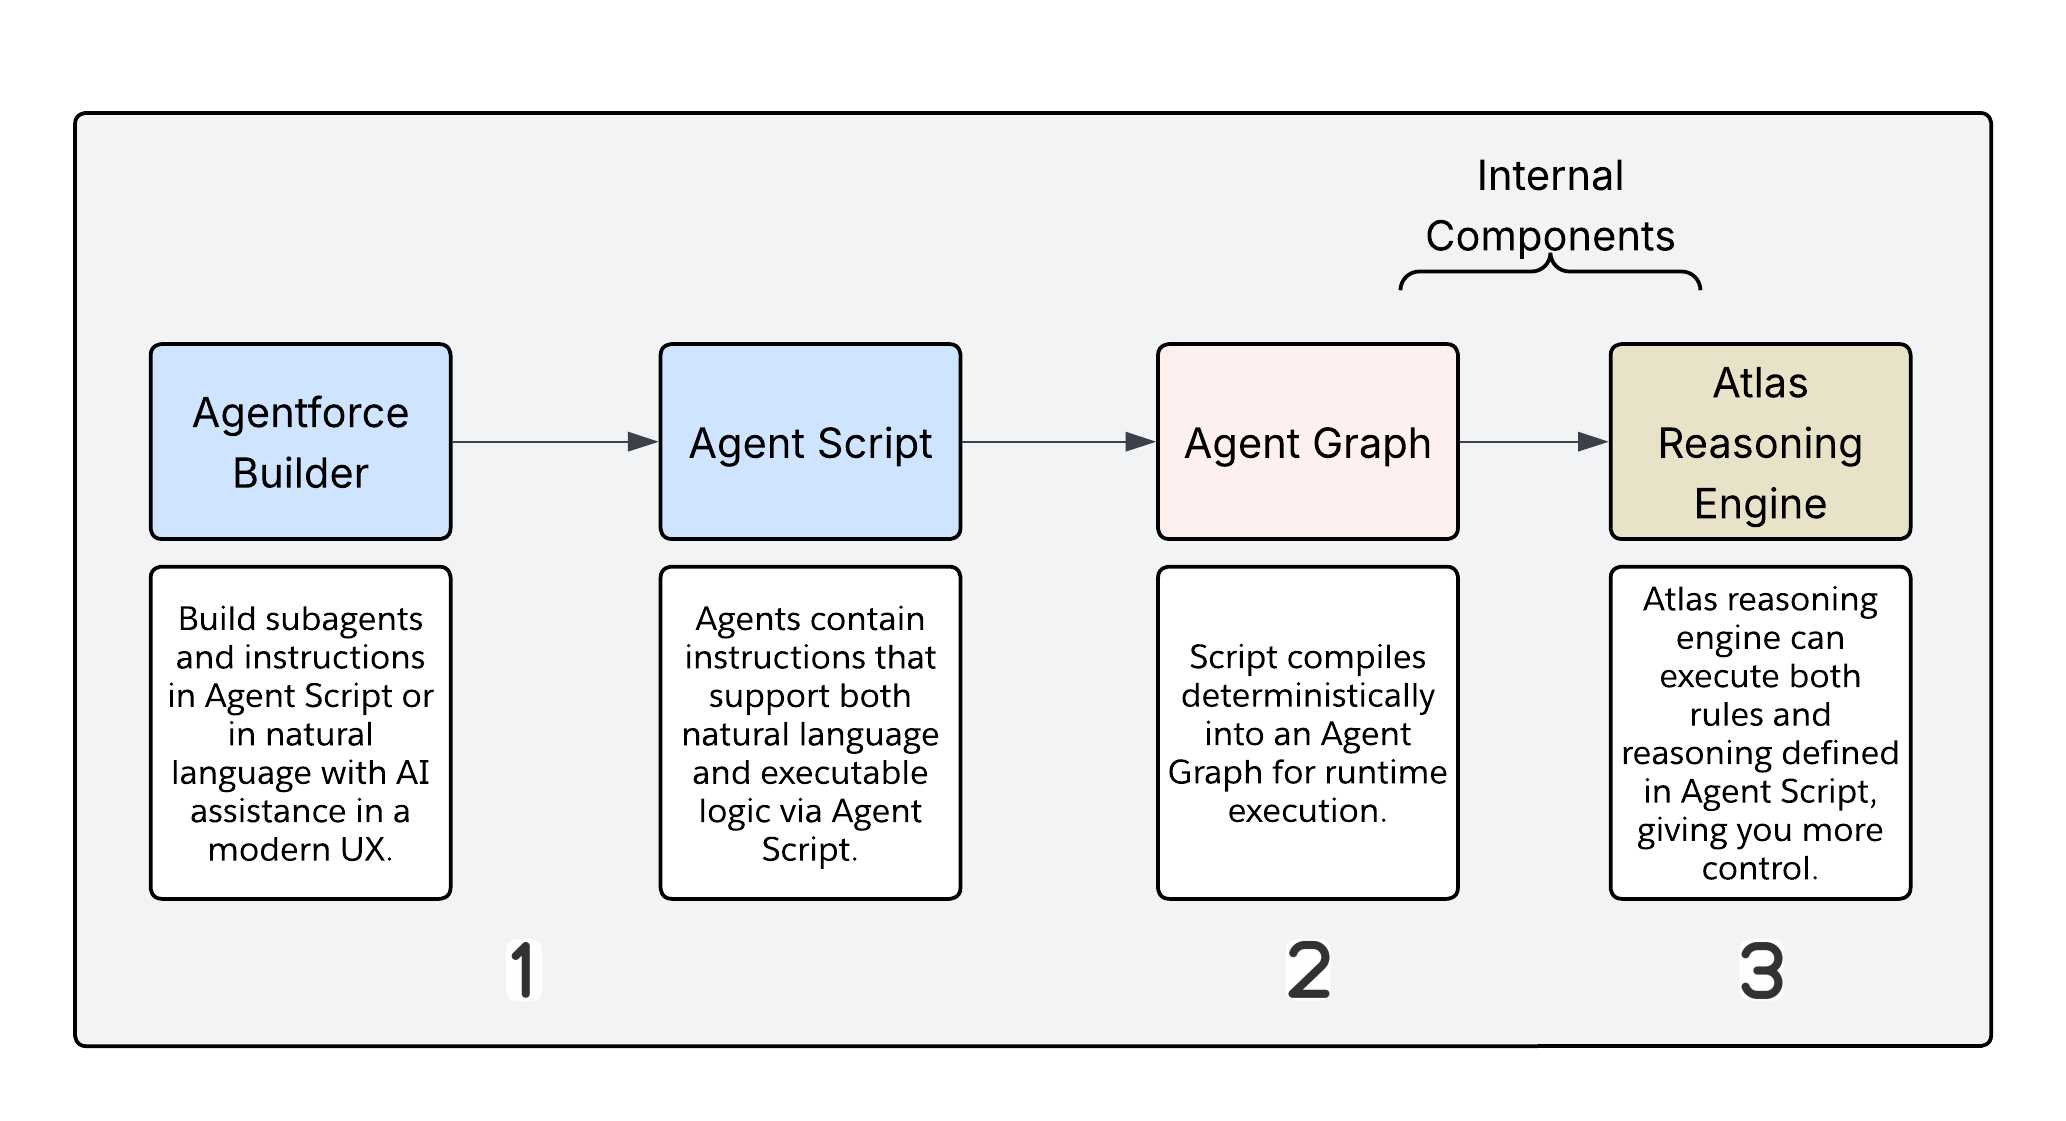
Agentdiagram er ikke en LLM-wrapper. Det er et hybridt argumentationssystem, der adskiller deterministisk kørsel fra sandsynlighedsmæssig argumentation. Styringsreglen er enkel: Hvis du kan udtrykke en beslutning som kode, skal den skrives som logik. Hvis beslutningen kræver dom, fortolkning eller naturlig sproggenerering, skal LLM håndtere det. Denne design beslutning er det vigtigste arkitektoniske valg i den nye Agentforce model. Hvor LLM-grænsen falder, påvirker direkte din løsnings omkostninger, forsinkelse, revisionsmulighed og pålidelighed.
Atlas Reasoning Engine evaluerer hver indgående bruger, der vender, og distribuerer den ned ad en af to stier.
Sti A: deterministisk eksekvering
Denne sti har ingen LLM-eksponering. Den fungerer som kompileret kode på kørselstidspunktet. Årsagssystemet klassificerer brugerens hensigt og bestemmer, at en logikinstruktion matcher og tilsidesætter LLM fuldstændigt. Det kompilerede agentscript kører top til bund med hvis-else-regler, der køres ubetinget ved hver drejning. Forløbs-, Apex eller API-handlinger kaldes med deterministiske parametre uden nogen meddelelsessammensætning eller modelkald involveret. Resultatet går tilbage gennem Trust lag med fuld revisions logføring.
Sti B: LLM argumentation
Årsagssystemet tager denne sti, når det ikke kan løse hensigter ved brug af logiske instruktioner alene. Den gennemgår agentdiagrammet og evaluerer hver node. Noder med meddelelsesinstruktioner udløser et LLM-kald. Noder uden dem udføres deterministisk. Tilstedeværelsen af en meddelelsesinstruktion er udløseren, og den er eksplicit i scriptet snarere end udledt på kørselstidspunktet.
Hvad udløser et LLM-opkald
Der er otte punkter i kørselslivscyklussen, hvor LLM kaldes. Underagentklassificering eller beslutning om, hvilken underagent der matcher brugerens anmodning, er en, selvom en kortslutningssti kan tilsidesætte det fulde LLM-kald, når klassificeringen er entydig. Agentarrangering, hvor agenten beslutter, hvilken handling der skal udføres som det næste, gennemgår altid LLM. Det samme gør svargenerering, hvor det endelige svar samles fra en hydreret meddelelse.
De resterende udløsere er mere driftsmæssige: basisvalidering bekræfter, at outputtet er baseret på hentede data. Handlingssimulering emulerer svar i eksempelvisnings- og simuleringsmiljøet i stedet for at køre live. Struktureret outputgenerering håndterer sager, hvor svaret skal overholde et defineret skema, og lokalisering og statusindikatorgenerering håndterer formatering og midlertidige meddelelser, hvor der ikke findes nogen forhåndsforfattet standard.
Hvad forbliver deterministisk
Grafisk gennemgang og statovergange involverer aldrig LLM. Livscyklusblokke for before_reasoning og after_reasoning udføres deterministisk, så længe de kun indeholder handlingsnoder uden nogen prompt-instruktioner. Matematik, hentning af data, validering og betinget logik hører alle til i kode. Enhver handling, der udfører forløb, Apex eller en REST API direkte, forbliver på den deterministiske sti. Enhver node uden meddelelsesinstruktioner udføres uden et LLM-kald.
Det betyder noget at være eksplicit om denne grænse med dit team. Hvert unødvendigt LLM-kald tilføjer forsinkelse, omkostninger og variation. Arkitekter bør som standard overføre deterministisk logik og reservere LLM til sager, hvor opgaven faktisk kræver dens begrundelsesfunktionalitet.
Design vejledning: push logik til kode som standard
Brug instruktioner i agentscriptlogik, når du skriver meddelelsesinstruktioner, der kan udtrykkes som en betingelse, en variabeltildeling eller et handlingsfilter. Hvert unødvendigt LLM-kald tilføjer forsinkelse, omkostninger og variation.
Standardpositionen skal være deterministisk. Isoler hver agentadfærd, der kan kodes som en regel, og flyt den til agentscript. De resterende opgaver, der kræver naturlig sprogsyntese, kontekstmæssig dom eller kompleks fortolkning, hører til meddelelsesnoder. Det er ikke en begrænsning. Det er grænsen, der fungerer som tiltænkt. LLM håndterer det, der er bedst egnet til, og alt andet kører som kode.
Den primære kørselsenhed i agentscript er ikke brugerens turn. Det er parsen: en enkelt fuldført cyklus gennem en underagent tre livscyklusblokke. Atlas Reasoning Engine starter en parse, hver gang en underagent har brug for at behandle noget, hvilket sker i tre situationer: ved første indtastning i underagenten, efter hvert værktøjsopkald, når en handling fuldføres og returnerer et resultat, og ved hver ny bruger, der skifter i den samme underagent.
Forståelse af parse-grænsen betyder noget, fordi den bestemmer, hvor mange gange hver blok køres, og derfor hvor du kan og ikke kan være afhængig af, at et givent stykke logik køres nøjagtigt én gang.
Hver underagent definerer tre kørselszoner:
| Bloker | Når den kører | LLM-engagement |
|---|---|---|
before_reasoning | Ved starten af hver parse, før LLM ser noget | Ingen |
reasoning | Under deterministisk løsning, før eventuelle LLM-kald | Blandet |
after_reasoning | Når argumentationen er fuldført, og LLM har besvaret | Ingen (med en kritisk begrænsning) |
Både before_reasoning og after_reasoning er fuldstændig deterministiske. De eksekverer handlinger, angiver variabler og anvender betinget logik uden at involvere LLM. Dette gør dem til pålidelige, billige blokke i scriptet.
Når skal du bruge before_reasoning
before_reasoning kører ved starten af hver parse uden undtagelse. Den udføres ved første indtastning i underagenten og igen efter hvert værktøjsopkald eller nye brugere, der vender ind i den pågældende underagent. En run @actions.X i before_reasoning er kode. I modsætning til en instruktion i en meddelelsesblok, som LLM kan eller ikke kan følge, udføres before_reasoning ubetinget.
Brug denne blok til sessionsinitialisering: hentning af kontekstregistreringer, indstilling af sessionsvariabler fra Apex eller Forløb. Det er også her, hvor godkendelses- og berettigelseskontroller hører til, fordi du ønsker, at disse skal bekræftes, før LLM ser nogen værktøjer. Konteksthydrering passer også her: kalde en hentningshandling, så LLM modtager forhåndsudfyldte variabler i stedet for at skulle anmode om dem. Enhver tællings- eller revisionsvariabel, der skal øges på hver parse, bør fastsættes her, fordi set i before_reasoning er garanteret på en måde, som en rørinstruktion ikke er.
Hvad der ikke hører til her er logik, der kun skal køre en gang pr. session, da before_reasoning kører på hver parse, ikke kun på den første post. Alt, der afhænger af brugerinput fra den aktuelle drejning, hører heller ikke til her, da dette input endnu ikke er blevet behandlet. Og overgange bør aldrig være i before_reasoning: en transition to instruktion her vil skyde ubetinget på hver parse og skabe løkker.
Hvis du har brug for initialisering en gang pr. session, skal du bevare den eksplicit:
En brugerskift kan udløse flere parser: en gang ved indtastning og derefter igen efter hvert værktøjsopkald. Denne funktionalitet har tre praktiske konsekvenser: initialiseringshandlinger i before_reasoning vil køre mere end en gang pr. bruger turn i multi-action-forløb, tællervariabler incrementeret her vil afspejle parse-antal, ikke turn-antal, og handlinger med bivirkninger, eksterne API-kald eller registreringsskrivninger, bør ikke leve i before_reasoning, medmindre genkørsel på hver parse er udtrykkeligt acceptabel.
before_reasoning er ikke en konstruktor. Det er en før-fly-kontrol, der kører med hver parse. Design den tilsvarende.
Når skal du bruge after_reasoning
after_reasoning køres, når argumenteringsløbet er afsluttet, når LLM har besvaret og handlingsresultater er registreret. Dette er det sted, hvor efterhandlingsdeterministiske kontroller hører til: evaluering af handlingsoutput og forgrening baseret på resultater. Deterministiske overgange eller flytning til den næste underagent baseret på variabeltilstand i stedet for LLM-dom, er placeret her. Så gør variabeloprydning før næste drejning og orkestreringssekvensering, når du har brug for at kæde underagenter i en forudsigelig rækkefølge uden en LLM-distributionsbeslutning.
Behandl after_reasoning som det beskyttende lag. Det er her, du håndhæver forretningsregler og statsadministration, når LLM har udført sit arbejde, hvilket sikrer, at vigtige procesforløb forbliver forudsigelige, uanset hvad LLM genererede.
Brug is_displayable: True klogt
Hver arkitekt, der designer orkestreringsforløb, skal forstå denne platformsfunktionsmåde. Når is_displayable: True er angivet på en handling, afslutter platformen argumenteringsløgnen, så snart LLM beslutter at vise dette output. Denne afgang sker øjeblikkeligt, hvilket betyder, at after_reasoning aldrig udføres.
Dette er en kendt platformsfunktionalitet, men den har en direkte konsekvens for orkestrering: logik, du har placeret i after_reasoning, ignoreres, når en handling, der kan vises, er en del af forløbet.
Svaret er nemt. Flyt logik, der skal eksekveres pålideligt ind i before_reasoning for den efterfølgende underagent i stedet for after_reasoning for den aktuelle.
Design vejledning: hvor du placerer initialiseringslogik
Beslutning om, hvor logikken skal placeres, er konsekvent, når du designer en underagent. Denne struktur dækker de mest almindelige scenarier:
| Scenarie | Hvor den skal placeres |
|---|---|
| Skal køres, før LLM ser enhver kontekst | before_reasoning |
| Kører hver parse, herunder genindtastning ved nye brugerskift | before_reasoning |
| Afhænger af handlingsoutput fra denne drejning | Betinget if i reasoning |
| Kræver deterministisk underagentovergang baseret på resultat | after_reasoning (men se is_displayable nedenfor) |
Kræver orkestreringslogik, når downstream-handling bruger is_displayable: True | before_reasoning af den næste underagent |
| Bruger logik, der kræver vurdering eller brugerkontekst | reasoning med meddelelsesinstruktioner |
Det underliggende princip er nemt. Når du skriver en meddelelsesinstruktion, der beder LLM om “altid at køre” en handling, er det et forslag. LLM kan eller kan ikke følge den afhængigt af konteksten. Når du placerer et run i before_reasoning, er det kode. Den udføres på hver parse uden undtagelse.
Betinget handlingstilgængelighed er den mekanisme, hvormed agentscript viser eller skjuler handlinger fra LLM baseret på kørselsvariabeltilstanden. Når available when-betingelsen evalueres til false, fjernes handlingen fuldstændigt fra den værktøjsliste, der præsenteres for LLM. Enhver falsk værdi, herunder None, False, 0 eller en tom streng, undertrykker handlingen.
Dette er ikke en meddelelsesinstruktion, der fortæller LLM “Kald det ikke endnu”, det er en gate på hard platformsniveau. LLM kan ikke kalde en handling, som den ikke har adgang til.
I dette eksempel er execute_transfer usynlig for LLM, før validation_passed evaluerer til true. Porten håndhæves af platformen, ikke af instruktion.
Design vejledning: Lad aldrig LLM angive gatevariablen
Giv hver variabel i en available when en deterministisk kodesti, der angiver variablen, før den tilknyttede handling udføres. Brug before_reasoning eller en deterministisk run og set blok i reasoning for at holde variablen i en kendt tilstand. Hvis du er afhængig af LLM til at angive gatevariablen, har du genintroduceret den variabilitet, som gate blev designet til at forhindre. Afhængig af samtalen kan LLM angive det eller ikke, hvilket betyder, at døren kan eller ikke kan åbnes.
Problemet med handlingsløbet
En handlingsløgne forekommer, når LLM kalder den samme handling gentagne gange uden nogensinde at nå en afslutningstilstand. Det sker, når to betingelser er sande samtidigt: available when betingelsen forbliver opfyldt efter handlingen er kørt, og begrundelsesinstruktionerne fortæller ikke eksplicit LLM at stoppe med at kalde den.
Platformen undertrykker ikke automatisk en handling, efter den er blevet kaldt. Hvis døren forbliver åben, og vejledningen er tvetydig, kalder LLM den samme handling på hver parse uendeligt.
Tag available when @variables.interest != "" som et eksempel. Hvis handlingen udføres, men interessevariablen ikke er tom, forbliver porten åben ved næste parse. LLM ser handlingen som tilgængelig, har ingen instruktion om at stoppe den og kalder den igen.
Der er to pålidelige måder, hvorpå du kan afbryde løkken. Den første er at indstille gatevariablen til en lukket tilstand som en del af handlingens efter-udførelseslogik, så available when evaluerer til false på den næste parse. Den anden er at bruge en separat boolesk has_run, der lukker porten efter første udførelse. Begge tilgange giver døren en deterministisk lukket tilstand, hvilket er den betingelse, som platformen har brug for for at undertrykke handlingen.
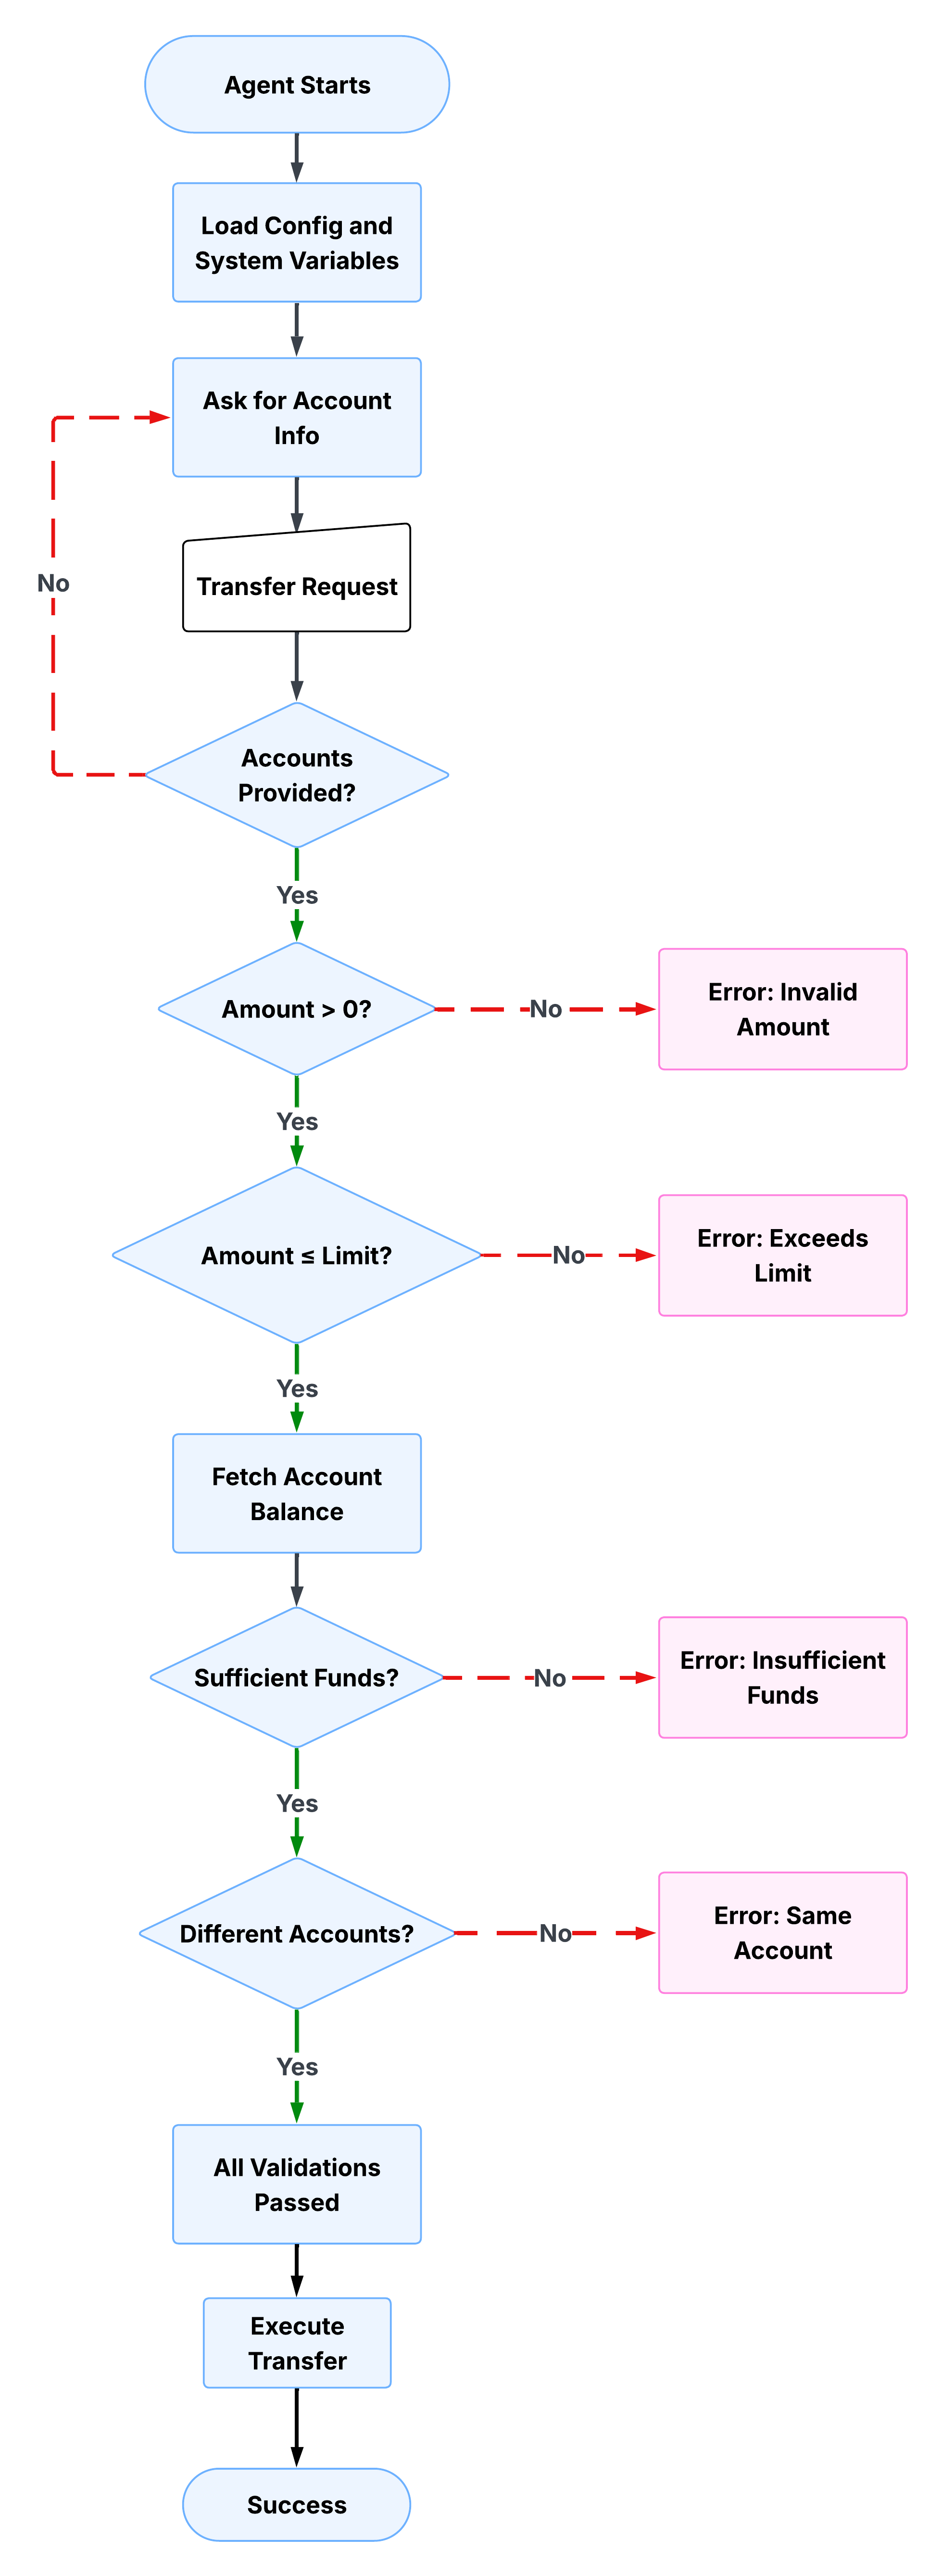
En bankoverførsel er en nyttig linse til at forstå, hvordan disse mønstre fungerer sammen i praksis. Arbejdsflowet ser enkelt ud udefra: flytte penge fra en konto til en anden. Implementeringen kræver flere komplekse trin. Før overførslen udføres, skal agenten indsamle kontodetaljer, validere beløbet, kontrollere overførselsgrænser, bekræfte den tilgængelige saldo og kun derefter vise overførselshandlingen. Hvert trin afhænger af de forrige trin. Ingen af dem bør overlades til LLM-dommen.
Saml og valider input
Den første underagent indsamler kildekontoen, destinationskontoen og overførselsbeløbet fra brugeren. Det fortsætter ikke, før alle tre er til stede og gyldige. Agentsscriptet kontrollerer hvert felt i rækkefølge: hvis kildekontoen mangler, bliver der spurgt. Hvis destinationen mangler, bliver der spurgt. Hvis beløbet er nul eller negativt, bliver der spurgt. validation_passed indstilles kun til true, når alle kontroller er klargjort.
Scriptet nedenfor viser dette i praksis. Bemærk, at validation_passed er udtrykkeligt indstillet til false på hvert fejlpunkt, og LLM instrueres i ikke at fortsætte. Deterministiske kontroller kører ubetinget, mens meddelelsesinstruktionerne håndterer det brugerorienterede svar.
Håndhæv forretningsregler
Når agenten har valideret input, kontrollerer den, om overførselsbeløbet overskrider den konfigurerede overførselsgrænse. Dette er stedet, hvor forretningsregler bliver til kode snarere end instruktioner. Grænsen er ikke noget, som LLM’s årsager vedrører. Det er en hård tærskel, der er defineret i scriptet og kontrolleret deterministisk på hver parse.
Hvis beløbet overskrider grænsen, indstilles validation_passed tilbage til false, og LLM giver brugeren tre muligheder: viderestille det maksimale tilladte beløb, opdele det i flere overførsler eller kontakte Support for at få højere grænser. Agenten kan ikke fortsætte, før brugeren løser undtagelsen. Bemærk, hvordan meddelelsesinstruktionen her gør præcis, hvad LLM-arrangering er egnet til: præsentation af indstillinger samtalt og håndtering af brugerens svar. Selve forretningsreglen er deterministisk, men samtalen omkring den er ikke det.
Scriptet nedenfor viser, hvordan grænsefrekvensen fungerer. Den deterministiske betingelse evaluerer overførselsbeløbet i forhold til grænsevariablen, indstiller validation_passed til false, hvis tærsklen overtrædes, og uddelegerer til en prompt-instruktion til at håndtere det brugerorienterede svar.
Anvend beskyttelsesklausuler
Når beløb og grænsekontroller er fuldført, henter agenten kildekontosaldoen og bekræfter, at der er tilstrækkelige midler tilgængelige. Beskyttelsessætninger forhindrer agenten i at forsøge handlinger, når forudsætningerne ikke opfyldes. I modsætning til en meddelelsesinstruktion, der beder LLM om at kontrollere saldoen, gør en vagtsætning i Agent Script kontrollen ubetinget. LLM bestemmer ikke, om det skal køres.
Hvis saldoen er utilstrækkelig, beregner agenten manglen og præsenterer brugeren for et konkret alternativ. validation_passed indstilles til false, indtil denne kontrol passerer, hvilket betyder, at overførselshandlingen forbliver låst.
Scriptet nedenfor viser et deterministisk handlingskald, der henter saldoen efterfulgt af en betinget kontrol, der evaluerer den. Hentningen køres kun, hvis saldoen ikke allerede er hentet, så du undgår overflødige API-kald på efterfølgende pars.
Overfladefejl tydeligt
Beskyttelsessætninger angiver tilstanden. Fejlmeddelelser kommunikerer det. Når validation_passed er false, skal agenten give brugeren nok oplysninger til at løse problemet uden at genstarte. Uigennemsigtige fejlmeddelelser skaber friktion. Strukturerede meddelelser lukker løkken hurtigere.
Scriptet nedenfor viser fejlmeddelelsen om utilstrækkelige midler i praksis. Det fortæller ikke blot brugeren, at overførslen mislykkedes. Den viser den tilgængelige saldo, det ønskede beløb, den beregnede mangel og tilbyder et konkret næste trin, alt sammen samlet fra sessionsvariabler i stedet for genereret af LLM.
Mangelberegningen sker i scriptet, ikke i LLM. Den foreslåede alternativ, der overfører den tilgængelige saldo, afledes deterministisk fra sessionstilstanden. LLM’ens rolle her er kun præsentativ: det leverer en meddelelse, som scriptet allerede har struktureret.
Gate overførselshandlingen
Hver valideringskontrol i de foregående trin angiver eller rydder den samme variabel: validation_passed. Denne variabel gør nu sit vigtigste job. Handlingen execute_transfer er betinget tilgængelig, hvilket betyder, at den kun vises på LLM’s værktøjsliste, når validation_passed er true. Indtil hver forudgående kontrol er gennemført og angivet denne variabel, findes handlingen ikke fra LLM’s perspektiv.
Dette er mønsteret fra det tidligere gateafsnit, der er anvendt på et produktionsarbejdsflow. Overførselshandlingen er ikke skjult af en meddelelsesinstruktion. Den er skjult af platformen. Ingen mængde konversationspres eller tvetydige udtryk kan medføre, at LLM kalder det, før forudsætningerne er opfyldt.
Scriptet nedenfor viser, hvordan porten er konfigureret. available when refererer direkte til validation_passed, og handlingsparametrene er bundet til de sessionsvariabler, der er indsamlet og valideret i de foregående trin.
Alle tre parametre, from_account, to_account og amount, overføres deterministisk fra sessionsvariabler. På det tidspunkt, denne handling bliver tilgængelig, er hver værdi blevet valideret. LLM samler ikke parametrene fra samtalekonteksten. Det læser dem fra tilstanden.
Spor tilstand gennem arbejdsflowet
Mønstrene i de foregående afsnit fungerer kun, fordi sessionstilstanden findes på tværs af hele arbejdsflowet. Kontonumre, der er registreret i det første trin, er tilgængelige i det fjerde trin. Valideringsresultater angives i en afkrydsningshandling i en anden. Samtalen kan afvige, brugeren kan stille opfølgningsspørgsmål, og agenten vil stadig vide nøjagtigt, hvor den er i processen.
Variabelblokken nedenfor viser den fulde sessionstilstand for dette arbejdsflow. Hver variabel har en defineret type, en standardværdi og en beskrivelse. To variabler håndterer det meste orkestreringsarbejde: validation_passed kontrollerer tilgængeligheden af handlinger ved hver gate, og validation_information indeholder menneskelæsbar kontekst om, hvorfor en kontrol mislykkedes, som LLM kan vise brugeren uden at skulle begrunde den underliggende tilstand.
Hver variabel starter i en kendt standardtilstand. Strenge som standard til tomme, tal til nul, og validation_passed boolesk til false. Dette betyder, at porten som standard er lukket. Arbejdsflowet skal aktivt opnå rettigheden til at fortsætte ved hvert trin i stedet for at starte med døren åben og afhængig af kontroller for at lukke den.
Eksemplet på bankoverførsel illustrerer, hvor deterministisk logik er det rigtige værktøj, men det er ikke altid det bedste valg. Forstå grænsen er lige så vigtigt som at forstå mønstrene.
Deterministisk logik er det rigtige valg, når arbejdsflowet kræver en garanteret kørselsrækkefølge, når fejl har væsentlige konsekvenser, når processen har brug for at oprette et revisionsspor, der kan reproduceres, eller når forretningsregler er veldefinerede nok til at blive udtrykt som betingelser og tærskler. Arbejdsflows for økonomi, sundhedspleje og forsikring falder generelt inden for denne kategori.
Rent LLM-regnskab uden strenge deterministiske begrænsninger giver mere mening, når værdien af interaktionen ligger i fleksibilitet snarere end præcision. Åben kundesupport, produkter i den tidlige fase, hvor forretningsprocesser stadig er under udvikling, og informative forespørgsler med lave satser er alle situationer, hvor variationen i LLM-arrangementer er en funktion, ikke et problem.
I praksis har de fleste produktionsagenter brug for begge. Beslutningen om, hvor grænsen falder, er ikke et binært valg mellem deterministisk og sandsynlighed. Det er en designbeslutning, du træffer på nodeniveau for hver del af din agents arbejdsflow.
| Brug deterministisk logik til | Brug LLM-arrangering til |
|---|---|
| Inputvalidering og sanitering | Naturlig sprogforståelse og hensigtsregistrering |
| Håndhævelse af forretningsregler | Generering af konverserende, empatiske svar |
| Sekventiel procesorkestrering | Håndtering af tvetydige eller uventede input |
| Statsstyring og kontekstbevarelse | Angivelse af forklaringer og klargørelser |
| Beskyttelsessætninger, der forhindrer ugyldige handlinger | Tilpasning af tone og meddelelser til brugerkontekst |
Grænsen er designbeslutningen
Eksemplet på bankoverførsel er en illustration af en designfilosofi: at grænsen mellem deterministisk kørsel og LLM-arrangering er den mest konsekvente arkitektoniske beslutning, du træffer, når du opbygger en produktionsagent.
Placer en grænse, der er for stiv, og du ender med at have en agent, der er stiv, dyr at vedligeholde og ude af stand til at håndtere den naturlige variation af virkelige samtaler. Hvis du får grænsen forkert i den anden retning, oprettes der en agent, der er fleksibel, men uforudsigelig, klarer sig godt i test, men optræder anderledes i produktion, og som ikke kan oprette et pålideligt revisionsspor eller være tillid til en transaktion med høje satser.
Den nye Agentforce giver dig værktøjerne til at placere denne grænse med vilje. Agentsscript giver dig mulighed for at udtrykke deterministisk logik og meddelelsesinstruktioner i den samme fil med en eksplicit syntaks til at gøre grænsen synlig. Atlas Reasoning Engine håndhæver logik og meddelelser på kørselstidspunktet. before_reasoning og after_reasoning blokke giver dig garanteret eksekvering zoner på begge sider af LLM opkald. Betinget handlingstilgængelighed sikrer, at LLM kun kan reagere, når forudsætningerne er opfyldt.
Ingen af disse funktioner er isoleret. De arbejder sammen om at skabe en sammenhængende arkitektur for at opbygge agenter, som virksomheder kan Trust med missionskritiske arbejdsflows. Hybridregnskabsmodellen anerkender, at deterministisme og fleksibilitet begge har roller i din arkitektur. Det er arkitektens job at beslutte præcist, hvor hver af dem gælder.
Agentforces agentdiagram: Mod guidet determinisme med hybrid ræsonnement
Gulal Kumar er Software Engineering Architect hos Salesforce med over 20 års erfaring. Hans ekspertise strækker sig over AI, integration, API’er og virksomhedsarkitektur med fokus på at fremme forretningstransformation gennem sikre, fleksible og innovative AI-løsninger. Kontakt ham på LinkedIn.
Miriam McCabe er Senior Director og leder af teamet Architect Evangelism. Hendes arbejde fokuserer på at gøre det globale Salesforce-arkitektsfællesskab i stand til at lede i agenttiden gennem dybt teknisk indhold, live programmering og fællesskabsengagement. Følg hende på LinkedIn.