Virksomheder håndterer en lang række dokumenttyper, herunder fakturaer, købsbestillinger, juridiske kontrakter og tekniske manualer. Manuel behandling er langsom, med en tendens til fejl og forbruger anslået 15-25 % af medarbejderens tid. Tidligere automatiseringsmetoder (f.eks. Robotic Process Automation (RPA), Optical Character Recognition (OCR) og arbejdsflowværktøjer) reducerede en del af byrden, men skabte stive pipelines, høje vedligeholdelsesomkostninger og isoleret indføring på tværs af individuelle forretningsteams.
Dokumenter indeholder avanceret strukturel kontekst (f.eks. tabelhierarkier, geografiske feltrelationer og krydsrefererede afsnit), som fladtekstbehandling ikke kan bevare. Hvis et dokument fjernes fra almindelig tekst, kasseres den forretningskontekst, der gør udtrækning nøjagtig og nyttig, hvilket nedsætter kvaliteten af downstream-analyser, artificiel intelligens (AI)-afledning og procesautomatisering.
For at være effektive skal _IDP-_systemer klassificere dokumenter efter type, udtrække strukturerede data nøjagtigt fra variabellayouts og levere disse data i en styret, forespørgselsform til downstream-systemer. IDP’er skal også håndtere dokumentvariation på skala uden at kræve pr. skabelon-konfiguration for hvert nyt dokumentformat, og de skal være centraliserede og tilgængelige på tværs af forretningsenheder. Denne udfordring forværres af den samlede mængde af nøgleproblemet: Ustrukturerede data udgør ca. 80% af alle virksomhedsdata, og størstedelen akkumuleres i dokumentform på tværs af filsystemer, Cloud-lagring og indholdslager, der er uden for rækkevidden af _CRM-_systemer, AI-agenter og analyseplatforme.
Data 360 Document AI er Salesforce-dokumentbehandlingsfunktionen i Data 360, som er designet til at løse dette hul. Det udtrækker, klassificerer og analyserer ustruktureret og semistruktureret dokumentindhold ved hjælp af Large Language Models (LLM’er), Optical Character Recognition (OCR), Natural Language Processing (NLP) og Machine Learning (ML). Outputtet er strukturerede, administrerede og forespurgte data, der integreres i Data 360-pipelinen, hvor Agentforce agenter, analyseværktøjer og automatiseringsarbejdsflows kan få adgang til dem via standardgrænseflader uden at kræve tilpassede udtræknings- eller transformationslag.
Virksomhedsdataplatforme behandler strukturerede tabeldata. Men størstedelen af virksomhedsdata ankommer som dokumenter og forbliver utilgængelige for CRM-, ERP-, AI-agenter og analyse-pipelines, indtil nogen udtrækker dem manuelt. Dette er et arkitektonisk hul, ikke et arbejdsflowproblem.
Tidligere tilgange kombinerer manuel gennøgling, regelbaserede OCR- og RPA-scripts. Disse metoder arbejdede på en lille skala, men de kunne ikke håndtere mængden, variationen og hastigheden af de typer dokumenter, som moderne virksomheder genererer. Regelbaserede værktøjer kræver eksplicitte skabeloner pr. layoutversion. Enhver formatændring afbryder udtrækning og kræver en udvikler, en ny skabelon og en implementeringscyklus.
På en skala opretter dette skrøbelige punktløsninger uden centraliseret styring, delt skema og sti til AI-parathed. Inkonsekvente udtrækningspipelines udbredes downstream. Med andre ord overtager analyser datauoverensstemmelser, AI-modeller producerer upålidelige output, og reguleret indhold som personlige helbredsoplysninger (PHI) og personligt identificerbare oplysninger (PII) mangler systematisk styring.
LLM’er udtrækker felter uden eksplicitte skabeloner. En enkelt skemakonfiguration styrer udtrækning på tværs af layoutvarianter, sprog og formater, hvilket tilpasser sig dokumentet i stedet for at kræve, at dokumentet overholder en fast struktur. Dette skifter dokumentbehandling fra en vedligeholdelsesmæssig, isoleret handling til en administreret, centraliseret funktionalitet.
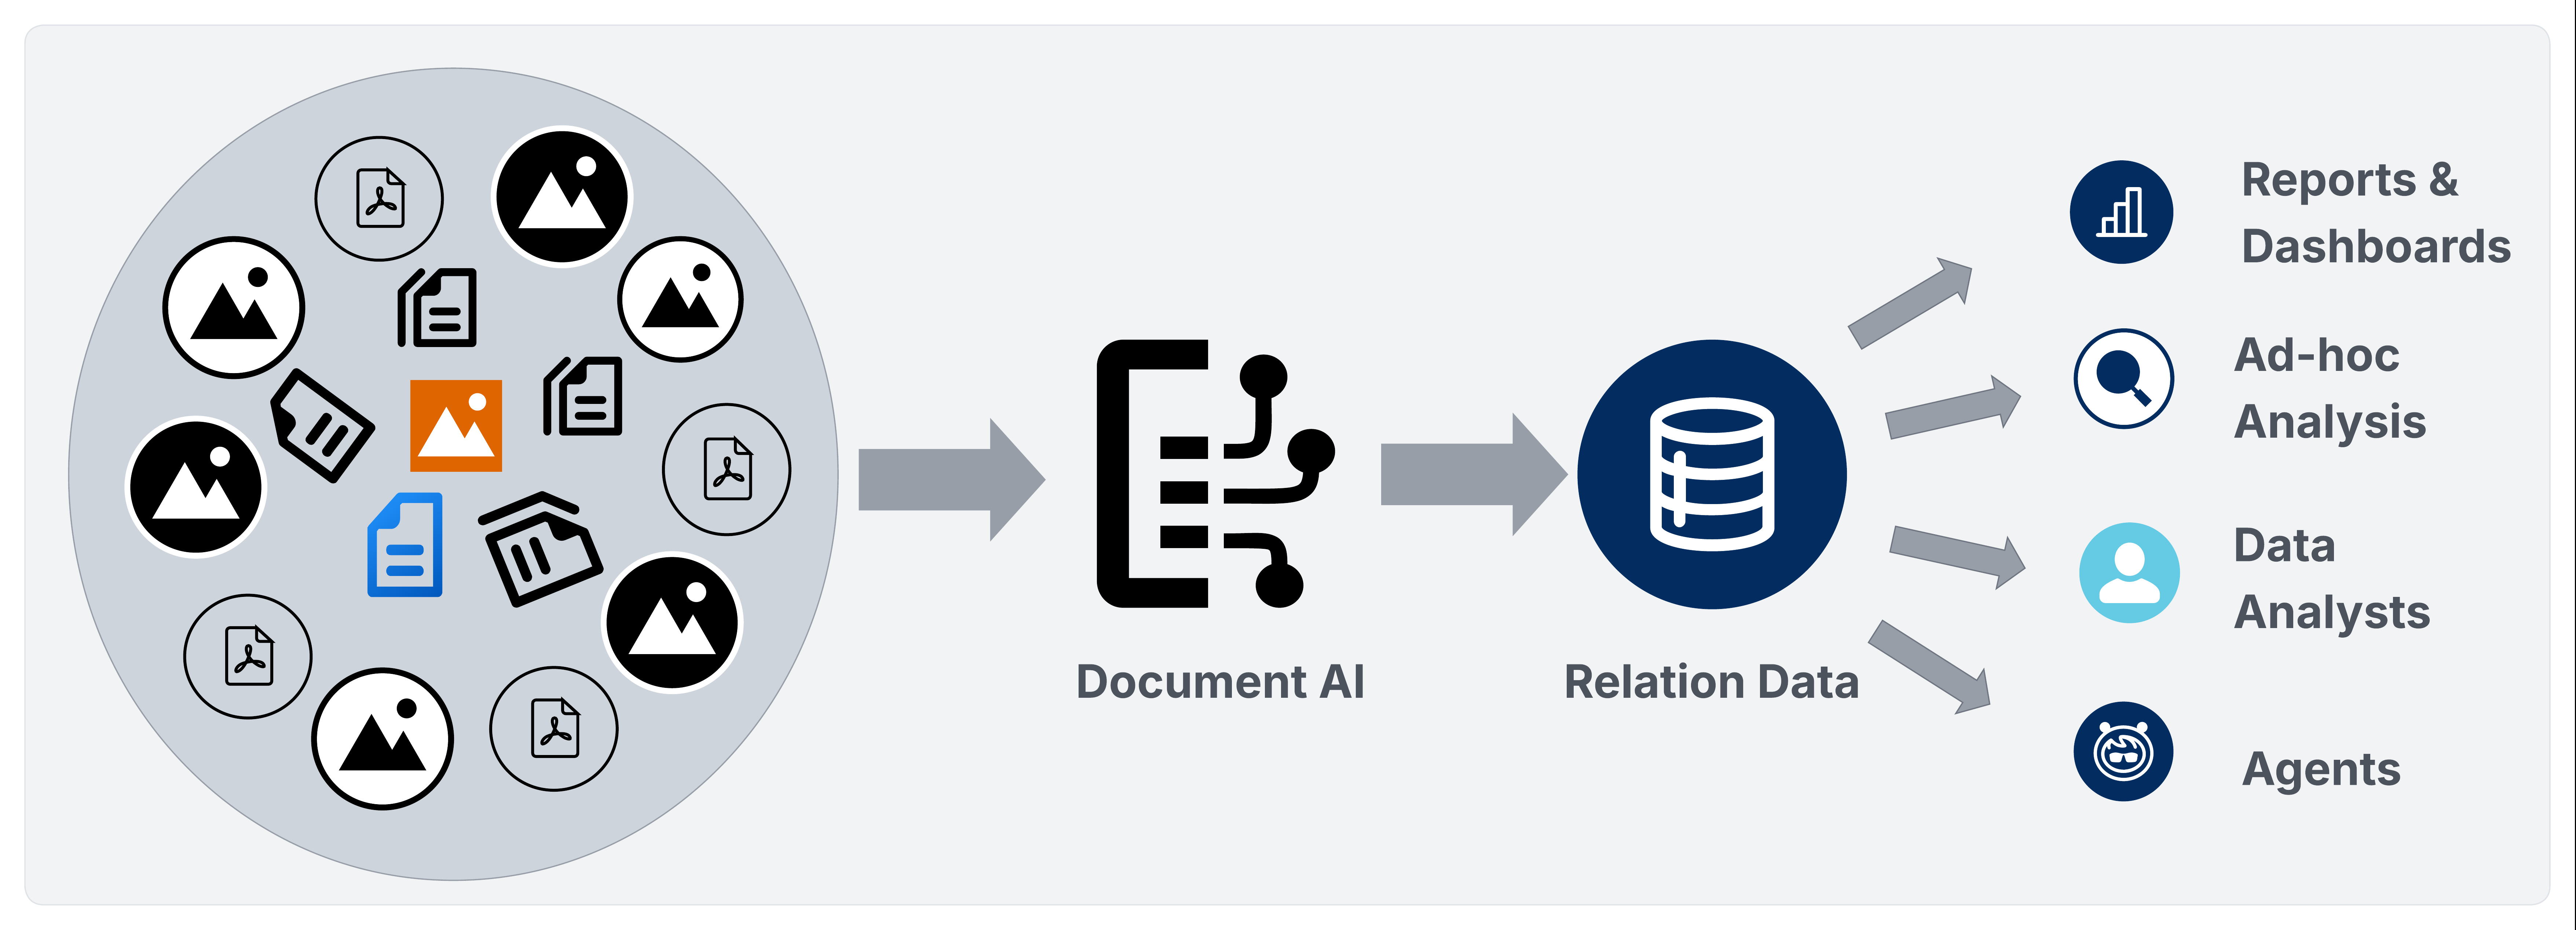
Data 360 Document AI operationaliserer dokumentbehandling i Data 360 platform via to pipelines.
- Batch Pipelinen distribuerer udtrukne data gennem overførsel, identitetsløsning, beregnede indsigter, aktiveringer, analyser og Agentforce-aktivering.
- Transaktionsbehandlingspipelinen viser en REST API, der returnerer struktureret JSON synkront, hvilket gør det muligt for arkitekter at distribuere dokumentafledte data til Salesforce-SO-objekter, Data 360 Data Lake Object/Data Model Object (DLO/DMO)-pipelinen eller eksterne databaser og lagerbygninger uden batchopsætning overhead.
I begge situationer opretter udtrukne data en administreret skemastyret model i stedet for et fragmenteret sæt punktværktøjer.
Data 360 Document AI er Salesforces indbyggede IDP-funktion i Data 360-platformen. Den konverterer ustruktureret og semistruktureret dokumentindhold til styrede data, der kan forespørges på, og som deltager fuldt ud i hele Data 360-livscyklussen.
Data 360 Document AI er Salesforces indbyggede IDP-funktion i Data 360. Den overfører ustrukturerede og semistrukturerede dokumenter, udtrækker strukturerede data ved hjælp af en deklarativ skemakonfiguration og leverer disse data til Data 360-pipelinen til harmonisering, identitetsløsning, analyse og Agentforce-aktivering.
Data 360-dokument-AI understøtter to behandlingsmetoder:
- Brug af batch: Behandler store dokumentsæt, der er defineret i ustrukturerede datamodelobjekter (UDMO’er) på begivenhedsstyret basis.
- Transaktionsbehandling: Behandler et enkelt dokument via REST API og returnerer en struktureret JSON-data synkront. Arkitekter kan derefter distribuere denne data til Data 360 DLO/DMO-pipelinen, Salesforce SObjects eller eksterne databaser og lagerbygninger via MuleSoft, Apex udkald eller Einstein Trust Layer (ETL)-pipelines. Målniveauet er en arkitektonisk beslutning, der er styret af forsinkelse, styring og krav til dataplacering.
Dokument-AI understøtter aktuelt PDF-filer, billedfiler (JPEG, PNG) og håndskrevne dokumenter.
Data 360 Document AI samler fire behandlingsteknologier i en enkelt styret pipeline. Hver komponent håndterer en særskilt fase af dokument-til-data-livscyklussen:
- Optisk tegngenkendelse (OCR): Konverterer scannede billeder, håndskrevet indhold og billedbaserede PDF’er til maskinlæsbar tekst før LLM-behandling. Et minimum på 150 DPI anbefales til pålidelig udtrækning.
- Stor sprogmodeller (LLM’er): Distribuer udtrækning gennem Einstein LLM-gatewayen ved brug af den brugervalgte model. LLM modtager OCR-output sammen med JSON-skemakonfigurationen og returnerer en struktureret udtrækningsdata. Gemini og yderligere modeller er planlagt til fremtidig implementering.
- Naturlig sprogbehandling (NLP): Udfører kontekstmæssig forståelse, enhedsgenkendelse, datoparsing og semantisk feltudtrækning direkte i LLM via struktureret meddelelsesteknik – den skemadefinerede meddelelse og OCR-output tjener som de eneste input. Alle LLM-interaktioner distribueres gennem ETL, som håndhæver nul datatilbageholdelse med modeludbydere og maskerer PII i tekstbaserede input, før de når modellen. Der anvendes ingen særskilt NLP-system.
- Multi-modal behandling: Behandler integrerede billeder i PDF’er som separate udtrækningsinputs, hvilket gør det muligt for LLM at udtrække data fra diagrammer, billedvendte tabeller og blandede indholdssider, som OCR alene ikke kan parse.
Ud over de fire behandlingsteknologier håndterer Document AI også:
- Einstein Trust Layer: Distribuerer alle LLM-interaktioner gennem ETL, som håndhæver nul databevarelse med modeludbydere og maskerer PII, før input når LLM med undtagelse af multimodale data (f.eks. vedhæftede dokumenter, der behandles via Dokument AI), hvor PII-maskering ikke aktuelt understøttes, og data sendes som-er til eksterne modeller. ETL styrer kun LLM-interaktionsstien. Udtrukne data, der er skrevet til Data Lake-objekter (DLO’er), gemmes som de er. Maskering på feltniveau, der er inaktive, skal håndteres gennem downstream-dataadministrationskontroller.
- Grænser for filstørrelse: Dokument-AI behandler filer på op til 10 MB pr. anmodning. Grænser for længde på LLM-kontekst kan yderligere begrænse behandling af tætte dokumenter med flere sider inden for denne grænse.
Virksomhedsarkitekter, der implementerer Data 360 Document AI, bør anvende disse principper, før de forpligter sig til et implementeringsdesign.
- Vælg pipelinen, før du designer skemaet. De batch- og transaktionelle behandlingspipelines er forskellige i overførselsmodel, skemabinding, målflexibilitet og forsinkelse. Det er vigtigt at bekræfte, hvilken pipeline hver anvendelsessituation kræver, før du definerer skemaet, da eftermontering tilføjer genarbejde, der kan undgås.
- Design skemaer på dokumenttypeniveau. Brug af et enkelt, veludarbejdet skema pr. dokumenttype er mere vedligeholdeligt end brug af konfigurationer pr. anvendelsessituation, og det er også den største håndtag for udtrækningskvalitet. Hvis du vil gøre dette korrekt, skal du bruge et forskelligt sæt dokumenter – herunder kantsager – i stedet for at designe fra et enkelt eksempel. Brug meddelelser gentagende på felt, tabel og skemaveniveau til at finde huller, og test og juster dem derefter mod flere dokumenteksempler, før du afslutter. Husk på, at et skema, der fungerer godt på et dokument, kan mangle på andre, så bredde og iteration er vigtige. Skemafleksibilitet – herunder fjernelse af kolonner, der ikke udtrækkes på en pålidelig måde på tværs af dokumenttyper – er lige så vigtig. Hvis du holder fast i felter, der introducerer støj eller uoverensstemmelse, undermineres den generelle udtrækningskvalitet, så det er vigtigt at behandle fjernelse af kolonner som en førsteklasses designbeslutning.
- Vælg det korrekte målniveau pr. feltgruppe. Felter, der kører CRM-arbejdsflows eller godkendelser, skriver til SObjects. Felter, der beriger den forenede profil eller feeding analyser hører til i pipelinen DLO/DMO. Felter, der betjener eksterne systemer, hører til RDBMS-niveauet. Husk på, at et enkelt skema kan vise flere niveauer samtidigt.
- Håndhæv styring, før du behandler reguleret indhold. Regulerede data har brug for beskyttelse på hvert lag. Derfor er det vigtigt at konfigurere PII-maskering, dataklassificeringstags og Attribute-Based Access Control (ABAC), når udtrukne data er lagret i output-Data Lake-objekter (DLO’er). Dette giver finjusteret håndhævelse og kontekstbevidst adgang, der er baseret på dataklassificering, brugerrolle og organisatorisk kontekst. Forvaltningen er opdelt på to veje: ELT styrer LLM-interaktionen, mens de udtrukne data, der er lagret i DLO’er, skal styres separat – direkte på DLO- og databaseniveau – gennem Data Space-konfigurationer, Tilladelsessæt og ABAC-politikker. Disse kontroller skal bevare ensartethed på lagerniveauet – ikke kun applikationslaget – så adgangsbegrænsninger forbliver intakte, uanset hvordan der opnås adgang til data efter overførsel. Husk på, at huller i ethvert lag kan vise regulerede data downstream, selvom andre er konfigureret korrekt.
- Design til fejltilstande før produktion. Håndter nulfeltshåndtering, OCR-kvalitetstærskler, forhåndsvalidering af filstørrelse, LLM-kontekstoverløb, RDBMS-skrivebeskyttelse og kreditbudgetgrænser før den første produktionsbatchkørsel. Disse er ikke kantsager – de er forudsigelige fejloverflader, der skal håndteres eksplicit i pipeline-design, ikke fundet under kørsel.
- Behandl konfidensscores som et førsteklasses distributionssignal, ikke som en diagnostisk eftertænkning. Udtrækningsresultater indeholder konfidensværdier på feltniveau, der er afledt fra logsandsynligheder (logprobs) for det underliggende modeloutput. For hvert udtrukket felt, tabel eller kolonne afspejler scoren modellens sikkerhed på token-niveau for den udtrukne værdi. Dette gør konfidensscores til et statistisk baseret signal, der er pålideligt nok til at fungere som den primære gate for eskaleringstærskler for Human-in-the-Loop (HITL). Brug konfidensscores til systematisk at identificere udtrækninger af lav kvalitet og starte HITL-kontrolpunkter for værdier med lav konfidens, tvetydige skemamatches eller gentagne pipelinefejl i stedet for at være afhængige af heuristik eller manuelle spotkontroller. Når automatiseret gendannelse ikke er mulig, sikrer HITL-backed confidence-scoring, at menneskelig vurdering anvendes præcis der, hvor det er nødvendigt.
- Designe aktiveringsstier parallelt med skemadesign. Værdien af Dokument AI kommer fra at kunne aktivere udtrukne data i Salesforce-arbejdsflows og -agenter. Det giver dig mulighed for at designe Agentforce handlinger, forløb og beregnede indsigter sammen med udtrækningsskema design, ikke efter.
Dokument AI fungerer inden for to pipelines:
- En batch pipeline til højvolumen UDMO-støttet behandling
- En transaktionel behandlingspipeline til API-drevet udtrækning i realtid
Begge pipelines deler den samme skemakonfigurationskontrakt og ETL-styring, men de er forskellige i, hvordan dokumenter kommer ind i systemet, og hvor udtrukne data lander.
Lad os se nærmere på hver pipeline.
Batterpipelinen behandler tilbagevendende dokumentsæt, der er defineret af et UDMO. Den passer til planlagte eller begivenhedsstyrede anvendelsessituationer, hvor dokumenter overføres fra virksomhedens lager, derefter gennemgås dokumentudtrækning og leveres til Data 360 DLO/DMO-pipelinen til harmonisering, identitetsløsning og aktivering.
Virkelighedsscenarie
Hver dag modtager et forsikringsselskab tusindvis af medicinske skadesdokumenter fra udbyderportaler, der uploades som PDF’er til Amazon S3. UDMO definerer dokumentet i anvendelsesområdet og sender alle skades-PDF’er til /claims/incoming/ inden for et døgnåben vindue.
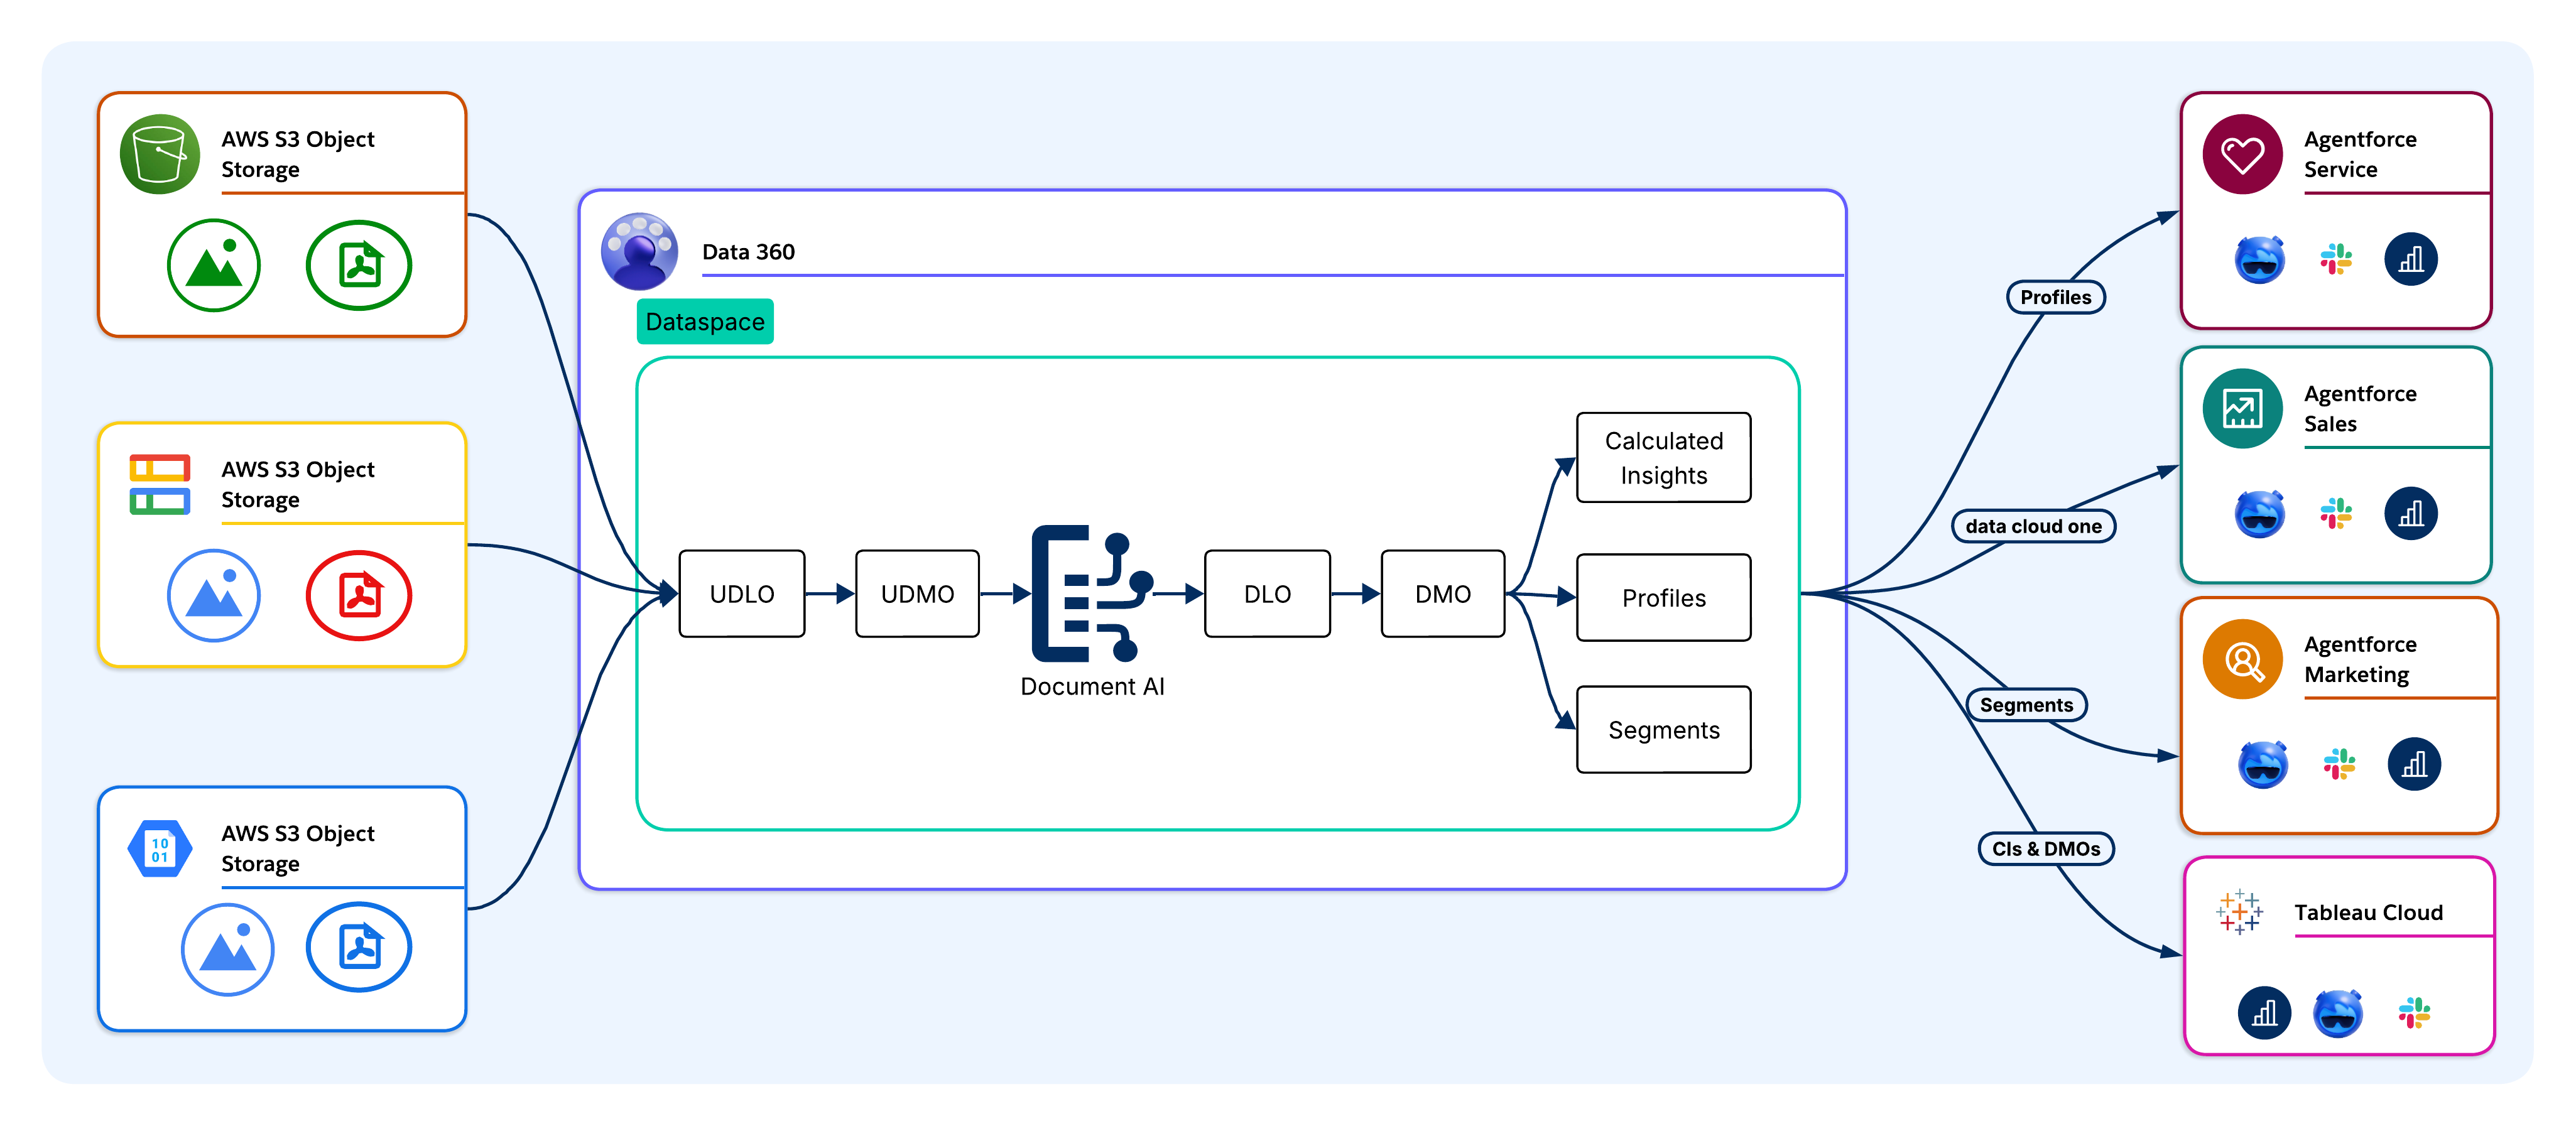
Dokumenter overføres til Data 360 fra virksomhedens kildesystemer uden fysisk duplikering. Understøttede kilder omfatter Amazon S3, Google Cloud Storage, Salesforce CRM-filobjekter, MuleSoft-orkesterede pipelines og direkte API-uploads. I Headless 360-implementeringer overføres dokumenter via cloud-lagringsforbindelser eller Overførsels-API’en, som tilsidesætter CRM-laget. Serveren Model Context Protocol (MCP) viser overførsel som et værktøj, der kan kaldes for eksterne AI-agenter og LLM-klienter.
Ved overførsel gemmes rå dokumenter som Ustrukturerede Data Lake-objekter (UDLO’er), der knyttes til den fysiske placering og metadata for hvert dokument uden at flytte eller transformere kildefilen.
Eksempel:
Skades-PDF’er overføres fra S3 til Data 360 via cloud-lagringsforbindelsen. Hvert dokument gemmes som et UDLO, der peger på S3-objektet. Der forekommer ingen fysisk duplikering.
Dokument-AI behandler hver UDLO op mod en skemakonfiguration, der definerer, hvilke felter der skal udtrækkes sammen med deres måldatatyper. UDMO definerer, hvilke dokumenter der er i omfanget. LLM (GPT-4o, Gemini eller Claude) læser hvert dokument og returnerer en struktureret udtrækningsdata.
Eksempel:
Dokument AI behandler hver UDLO op mod et skadesskema, der definerer felter som: ClaimID, PatientName, DiagnosisCode, BillingAmount og ServiceDate. LLM’er læser derefter hver enkelt PDF og returnerer en struktureret udtrækningsdata.
Når dataene er udtrukket, forbliver de i DLO’er, som er det rå lag af Data 360. DLO’er bevarer udtrukne felter uden at påtvinge forretningslogik, hvilket bevarer en nøjagtig fysisk repræsentation for downstream-transformation og sporbarhed. UDLO bevarer en reference til kildedokumentet for at aktivere afstamning på feltniveau på ethvert punkt i pipelinen.
Eksempel:
Alle udtrukne felter lander i en kravs-DLO, som bevarer en rå, nøjagtig repræsentation af hvert krav med fuld afstamning, der kan spores tilbage til kilde-PDF.
DLO-felter tilknyttes DMO’er, der er i overensstemmelse med standardmodellen Customer 360 Data Model. Dette er den grænse, hvor dokumentafledte data skifter fra rå udtrukne felter til forretningsmæssige enheder. Invoice DLO knyttes til et Invoice DMO, og felter som CustomerID og BillingAmount bliver forbindelsesnøgler og matchattributter i den forenede datamodel. Harmoniserede dokumentdata deltager i segmentering, beregnede indsigter og aktivering via de samme grænseflader, som bruges af CRM og transaktionsdata.
Eksempel:
Skades-DLO tilknyttes et Skades-DMO. PatientID- og PolicyNumber-felterne bliver forbindelsesnøgler, der linker fordringsregistreringer til forenede patientprofiler.
Harmoniserede DMO-data deltager i identitetsløsning. Udtrukne felter (f.eks. kundenavne, mailadresser eller kontonumre) fungerer som matchnøgler til at linke dokumentregistreringer til Unified Individuals (Golden Records), hvilket lukker hullet fra dokument til profil.
Eksempel:
Udtrækningsfelter (f.eks. PatientName, DateOfBirth og PolicyNumber) fungerer som matchnøgler til identitetsløsning, der linker kravregistreringer til den korrekte forenede person. Dette forekommer, selvom den samme patient vises under en lille smule forskellig navngivning på tværs af dokumenter.
Arkitekter definerer beregnede indsigter, som er aggregerede metrikker, der beregnes på tværs af harmoniserede dokumentdata (f.eks. den samlede udgift fra forskellige fakturalinjevarer, risikoscores for kontraktfornyelse og indekser for skades alvor).
Eksempel:
Beregnede indsigter beregner TotalClaimsPerPatient, AverageClaimAmount og HighRiskClaimScore på tværs af harmoniserede skadesdata for Agentforce-forespørgsler.
Harmoniserede, identitetsløsede data er tilgængelige for Agentforce-agenter, Tableau, marketingplatforme og Salesforce SObjects. Målniveauet er en arkitektonisk beslutning, der er styret af forsinkelse, styring og krav til dataplacering.
Eksempel:
En Agentforce Agent for skadesbeslutning forespørger på Data 360 DMO’er og CIs for at finde krav med høj risiko til prioriteret gennemgang. Tableau-dashboards viser skadesvolumen og afvigelsestendenser. Godkendte skadesregistreringer rulles tilbage til Skades-SObject for at starte betalingsarbejdsflows.
I Headless 360-arkitekturer distribueres aktivering direkte til eksterne systemer via aktiveringsmålene for Query API, Pub/Sub API eller Cloud-datalager. Derefter finder MCP-serveren harmoniserede dokumentdata og beregnede indsigter som værktøjer, der kan kaldes for eksterne AI-agenter.
Pipelinen for transaktionsbehandling håndterer udtrækning af enkelt dokument på kørselstidspunktet uden UDMO eller forhåndsoverførte UDLO, hvilket passer til begivenhedsstyrede anvendelsessituationer (f.eks. en kunde, der uploader en formular, en agent, der modtager en PDF, eller et eksternt system, der starter udtrækning i et transaktionsbehandlingshandlingsforløb). ETL-styring gælder for begge pipelines identisk.
Virkelighedsscenarie
Mens en bankkunde ansøger om et lån, uploader vedkommende en PDF-fil af vedkommendes regning via bankens mobilapp. Begivenheden starter udtrækning i realtid, hvilket betyder, at der ikke er nogen forhåndsoverførte UDLO eller UDMO involveret.
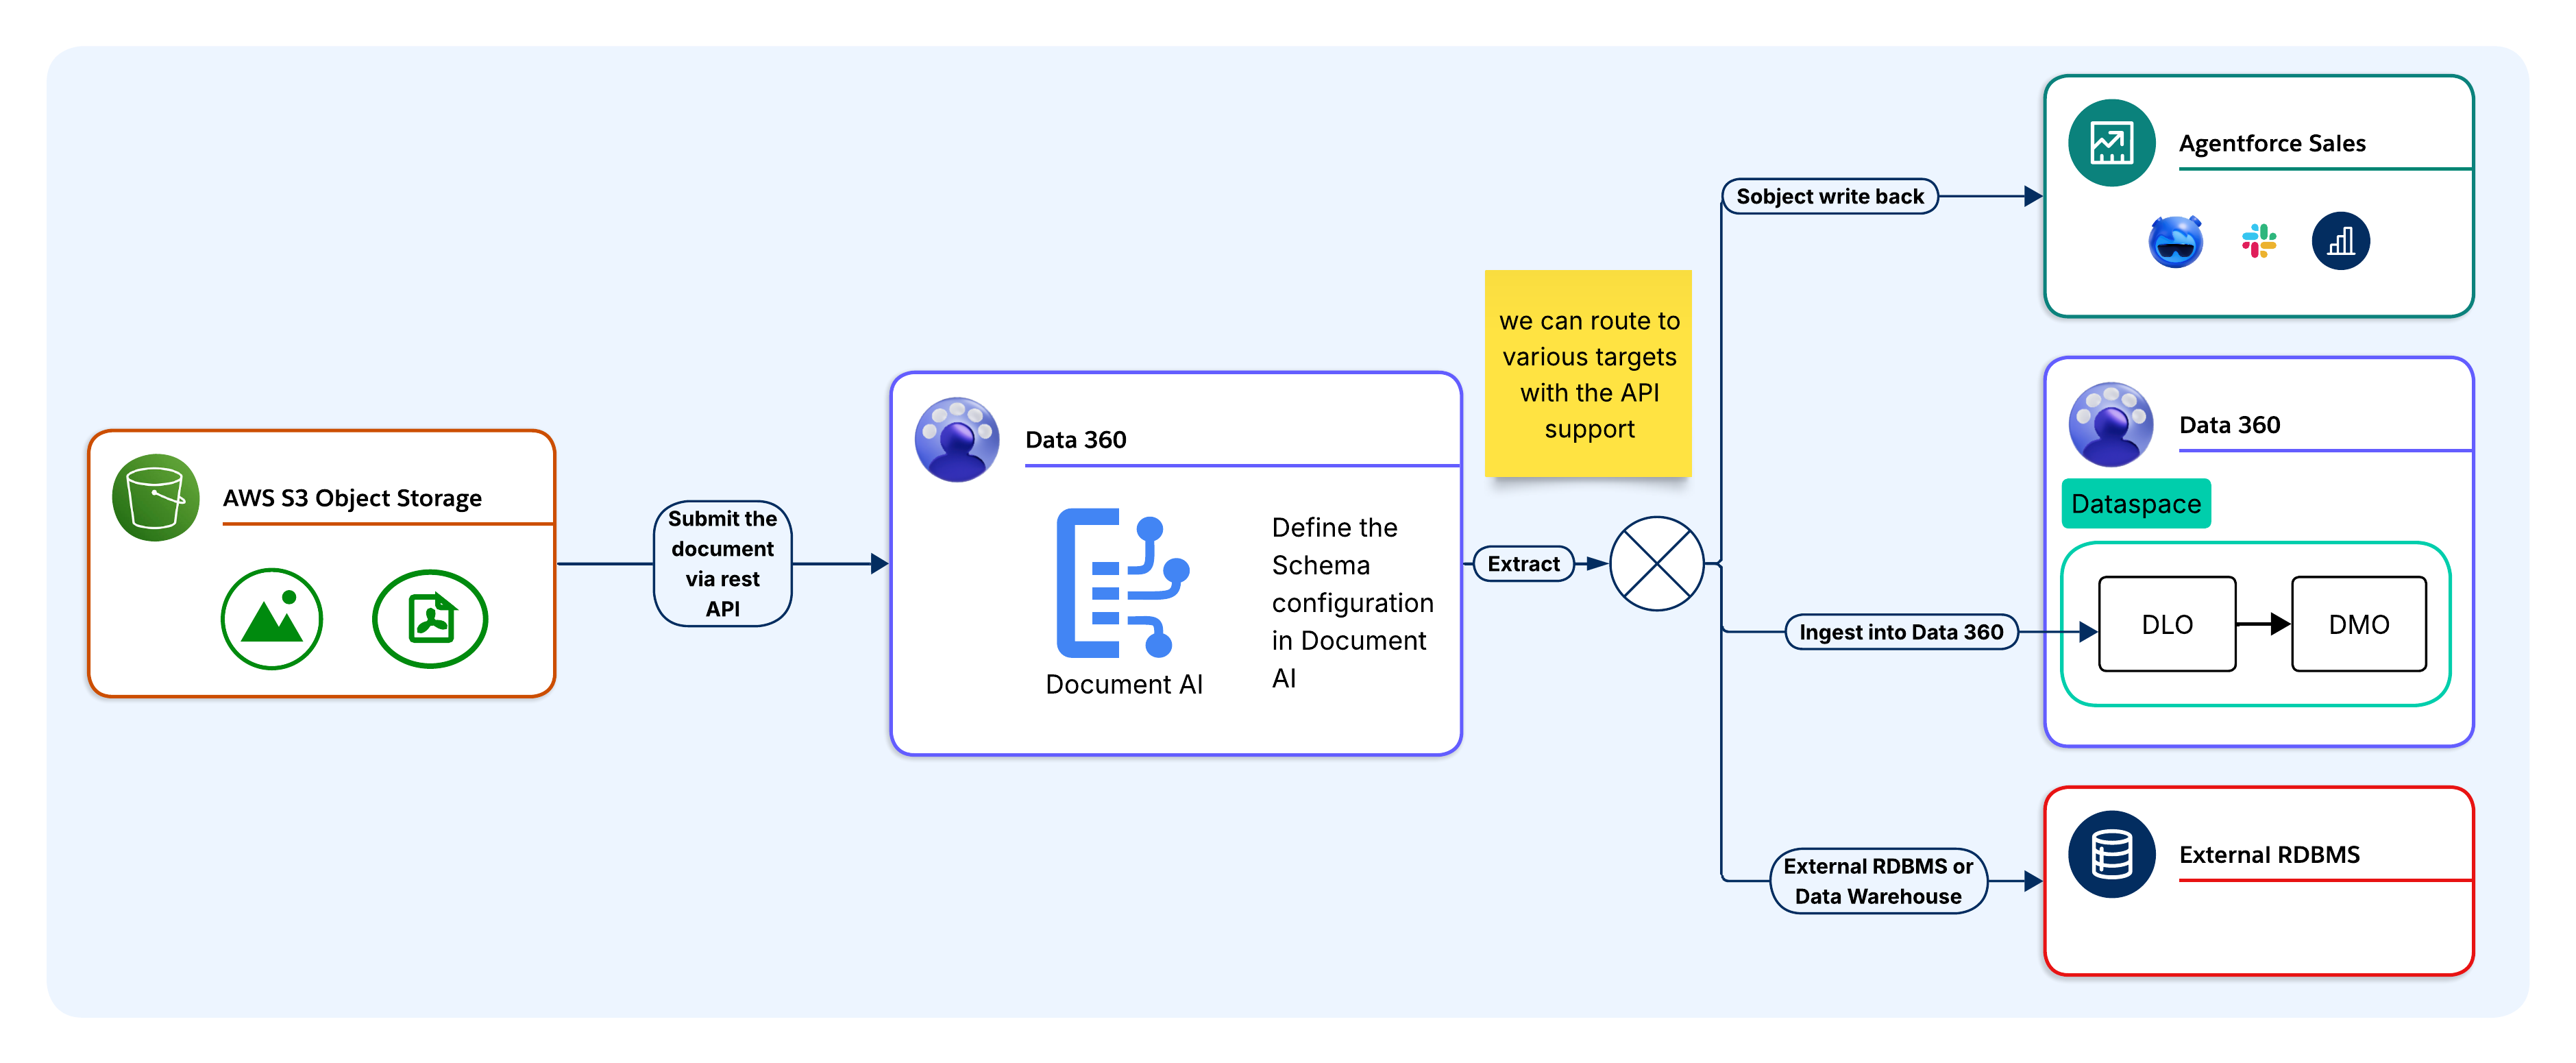
Før du kalder API, skal arkitekter definere og lagre et skema i Data 360, der angiver felterne, datatyper og udtrækningsinstruktioner i JSON-skema-format. Hvert skema tildeles et entydigt skema-id. På kørselstidspunktet henviser opkaldsapplikationen til skema-id’et for at holde udtrækningslogikken centraliseret i Data 360 i stedet for at integrere den i applikationskode.
Eksempel:
Bankens team har et foruddefineret ProofOfAddress i Data 360, som angiver felter som CustomerName, AddressLine1, City, PostCode og DocumentDate. Disse oplysninger gemmes som en versioneret konfiguration, der kan refereres til af et skema-id.
Opkaldsapplikationen indsender dokument- og skema-id’et i en enkelt REST API-anmodning som en base64-kodet dataindlæsning eller filreference. Der kræves ingen UDLO-overførsel. Dokument AI anvender dokumentudtrækningen og returnerer det strukturerede output baseret på det angivne skema.
Eksempel:
Mobilappen sender forsyningsregningen som en base64-kodet data sammen med ProofOfAddress skema-id’et i et enkelt REST API-kald. Denne proces kræver ikke et UDLO-overførselstrin.
LLM behandler OCR-outputtet op mod skemaet og returnerer en struktureret JSON-data synkront. Felter, der ikke findes i dokumentet, returneres som nul. Opkalderen ejer det fulde JSON-svar og fortsætter til distribution.
Eksempel:
Dokument-AI anvender OCR på PDF’en, og LLM returnerer en struktureret JSON-data med udtrukne adressefelter. Felter, der ikke findes (hvis f.eks. PostCode mangler i fakturaen), returneres som nul.
Når den er udtrukket, kan JSON-data distribueres til et eller flere målniveauer afhængigt af anvendelsessituationen:
- Salesforce SObject: Tilknytter direkte til SObject-felter via Apex eller Flow for CRM-arbejdsflows og -godkendelser.
- Data 360 DLO/DMO Pipeline: Ruter til en DLO til harmonisering, identitetsløsning, beregnede indsigter og Agentforce-landing.
- Eksternt RDBMS eller Data Warehouse: Distribuerer via MuleSoft, Apex-udkald, platformsbegivenheder eller ETL for systemer uden for Salesforce.
- Tilpasset integration: Returnerer strukturerede JSON-data til opkaldsapplikationen til lagring i ethvert eksternt system eller datalager.
- Downstream-forløb eller agent: Overfører det strukturerede JSON-output direkte til et downstream-forløb eller agent uden nogen vedholdenhed i et SObject. Dette er et almindeligt mønster for kunder, der bruger Document AI som et realtidsudtrækningstrin i en større automatisering eller agentisk arbejdsflow.
Husk på, at et enkelt skema kan vise flere niveauer samtidigt med forskellige feltgrupper, der distribuerer til forskellige mål fra det samme udtrækningspunkt.
Eksempel:
En ProofOfAddress kan udløse til tre niveauer på en gang (f.eks. CustomerName og AddressLine1 skrive til Contact SObject), hvilket initierer et adressebekræftelses forløb. Derefter distribueres den fulde nyttelast til en DLO til harmonisering og risikoscoring, og en kopi distribueres til bankens KYC-system via MuleSoft til overholdelseslogføring.
Når den er skrevet, aktiveres udtrukne data i målsystemet med det samme. For SObject-mål aktiveres udløsere, forløb og godkendelsesprocesser i den upsertede registrering. For DLO/DMO-mål indsættes data i harmonisering og identitetsløsning og i Agentforce-konteksten. For eksterne RDBMS-mål er data tilgængelige for downstream-forespørgsler, så snart skrivningen er fuldført.
Eksempel:
Address Verification Flow aktiveres straks i den opsatte Contact-registrering, hvilket flytter låneansøgningen til næste fase. Agentforces lånedirektør agent finder den bekræftede adresse fra Data 360, og KYC-systemet registrerer dokumentindsendelsen til revision.
Dokument-AI er bedst egnet til specifikke arkitektoniske forhold. Anvendelse uden for disse betingelser introducerer unødvendig kompleksitet og yderligere omkostninger.
Som arkitekter er det vigtigt at evaluere disse kriterier, før du forpligter dig til at bruge Dokument AI som udtrækningsmekanisme.
Brug Dokument-AI, når:
- Dokumenter er den primære datakilde. De krævede oplysninger findes kun i dokumentformular og er ikke tilgængelige fra en struktureret API eller database (f.eks. scannede kontrakter, laboratorierapporter, registreringsformularer eller forsikringskrav).
- Dokumentlayouts varierer på tværs af kilder. Den samme dokumenttype ankommer fra flere leverandører, partnere eller områder med forskellige feltpositioner og formater. Skemastyret LLM-udtrækning tilpasser sig uden pr. layout-vedligeholdelse.
- Udtrukne data skal forsyne Data 360 eller Agentforce. Udtrækning skal deltage i identitetsløsning, beregnede indsigter eller Agentforce-landing. Dokument-AI leveres direkte ind i DLO/DMO-pipelinen uden et separat ETL-lag.
- Volume retfærdiggør styret automatisering. Dokumentmængden overskrider, hvad manuel behandling kan håndtere uden målbare arbejdsudgifter eller datakvalitetsrisici.
- Dokumenter indeholder reguleret indhold. PHI, PII eller finansielle data skal distribueres gennem et nul-databevarelses-PII-maskeringslag, før de når et LLM. ETL opfylder dette som standard. Kunder, der ikke kræver, at noget udtrukket indhold bliver vedvarende på noget tidspunkt, bør også overveje det transaktive API-forløb, som returnerer struktureret output direkte til den kaldende applikation uden at skrive til noget SObject eller datalager.
- Anvendelsessituationen er begivenhedsstyret. Et dokument ankommer på kørselstidspunktet (f.eks. en kundeupload, en agent-PDF-vedhæftning eller en ekstern systemudløser). Pipelinen for transaktionsbehandling håndterer synkron udtrækning af enkelt dokument uden batchopsætning.
Brug ikke Dokument-AI, når:
- Kildedata er allerede struktureret. Hvis upstream-systemet viser en REST API, databasetabel eller struktureret fil (f.eks. CSV, JSON eller XML), skal du bruge en standardforbindelse til Data 360. Kørsel af strukturerede data gennem en LLM-udtrækningspipeline tilføjer forsinkelse og kreditomkostninger uden yderligere fordele.
- Dokumenter genereres maskinelt med et fast skema. Systemgenererede PDF’er fra en kendt ERP- eller faktureringsplatform med et stabilt layout er bedre egnede til en deterministisk parser. LLM-udtrækning er designet til variation, og anvendelse af den på dokumenter med fast skema mister kontekst og kreditter.
- Krav til nøjagtighed overskrider LLM-konfidenstærsklerne. Dokument-AI garanterer ikke 100 % udtrækningsnøjagtighed. Brug af sager, hvor en manglende eller ukorrekt feltværdi medfører væsentlig finansiel, juridisk eller klinisk risiko, kræver et HITL-valideringstrin. Brug ikke Dokument AI som det eneste udtrækningslag til beslutninger, der er af stor betydning, uden et valideringsarbejdsflow.
- Dokumenter overskrider platformsbegrænsninger. Den nuværende grænse på 10 MB filstørrelse og begrænsninger for længden af LLM-kontekst gør Document AI uegnet til store eller tætte dokumenter uden forbehandling for at opdele og samle dem uden for platformen.
- Bemærk: Hos Salesforce forbedrer vi aktivt disse accepteringsgardreils for at udvide understøttede filstørrelser, sideantal og filtyper. Begrænsninger vil fortsætte med at udvikle sig fremad.
Lad os se nærmere på flere scenarier, der bruger Document AI-batchpipelinen understøttet af et UDMO-kildeobjekt. I disse tilfælde, udtrukne data ruter gennem Data 360 DLO/DMO pipeline til harmonisering, identitetsløsning, beregnede indsigter og Agentforce aktivering. Hver anvendelsessituation er bedst egnet til planlagt eller begivenhedsstyret, højvolumen dokumentbehandling.
Agentforce Sales: Kontrakt- og fakturaoplysninger
_Kontrakt-_PDF’er overføres fra Cloud-lagring via batchpipelinen. Skemaet udtrækker ContractValue, RenewalDate, PaymentTerms og CounterpartyName og tilknytter dem derefter til konto- og _kontrakt-_DMO’er. Beregnede indsigter afleder fornyelsesrisikoscores. Agentforce advarer kontoansvarlige, før fornyelsesvinduer lukkes, hvilket eliminerer manuel kontraktgennemgang og manglende fornyelser.
Agentforce Service: Sagsafledning og Knowledge Grounding
_Undersøgelses-_PDF’er og sagsvedhæftninger overføres via batchpipelinen. Skemaet udtrækker sentimentindikatorer, emnekategorier og løsningsnotater og knytter dem derefter til DMO’er for sag og Knowledge-artikel. Agentforce forespørger på den harmoniserede Knowledge, når sagen åbnes og finder relevante fejlfindingstrin, hvilket reducerer agentsøgning overhead.
Agentforce Health: Behandling af kliniske dokumenter
Laboratorierapporter, indtagelses-PDF’er og håndskrevne kliniske formularer overføres via batchpipelinen. Skemaet udtrækker felter – herunder PatientID, DiagnosisCode, MedicationName og TestResult – og tilknytter dem derefter til Health Cloud DMO’er, som understøtter HIPAA-justeret behandlingskoordination og kliniske forskningsarbejdsflows.
Finansielle tjenester: Automatisering af lån og momsdokumenter
Låneansøgninger, momsdeklarationer og indtjeningsopgørelser overføres via batch-pipelinen. Skemaet udtrækker felter – herunder AnnualIncome, TaxYear og EmployerName – og tilknytter dem derefter til _Finansiel konto-_DMO’er. Beregnede indsigter kombinerer dokumentbaserede indtjeningsdata og CRM-data for at lette automatiseret kreditrisikoscoring. Agentforce finder de udtrukne lånoplysninger direkte under kundeinteraktioner. Dette mønster understøtter direkte anvendelsessituationen for Loan Prequalification Agent, der er udgivet på Salesforce Agentic Enterprise Solutions-udviklingscenteret.
HR: Arbejdsstyrke-dokumentbehandling
Introduktionsdokumenter, momsformularer og certificerings-PDF’er overføres via batchpipelinen. De udtrukne felter knyttes til _medarbejderregistrerings-_DMO’er og linkes derefter til profilen Forenet medarbejder. Specifikke forløb starter introduktionsopgaver og overensstemmelseskontrol baseret på de udtrukne data. Dette mønster understøtter anvendelsessituationen Automatisk genoptagelse af behandling Agenttic direkte. Dokumentet AI udtrækker færdigheder, beskæftigelseshistorik og kvalifikationer fra CV-PDF’er, som Agentforce derefter bruger til at matche kandidater med kriterier for åbne roller og dirigere dem til ansættelsesarbejdsflows.
Professionelle tjenester: Forslag og forskning
Forslag og forskningsrapporter overføres via batchpipelinen. Udtrukne strukturer, benchmarks og engagementssammendrag tilknyttes til tilpassede DMO’er og indekseres derefter for vektorsøgning. Agentforce henter kontekstrelevante anbefalinger på forespørgselstidspunktet, som er baseret på udtrukket dokumentindhold. Dette mønster udvider mønsteret Ground Agentforce på websiteindhold. Dokumenter indekseres via Dokument AI og fungerer på samme måde for agentsvar som websiteindhold, der indekseres via Data 360-forbindelser.
HIPAA-overensstemmelsesstatus:
De Health Cloud mønstre, der er beskrevet i dette indlæg, anvender ETL-kontrolelementer (f.eks. nuldatabevarelse og PHI-maskering) for tekstinput. Disse kontroller alene udgør ikke HIPAA-certificering. Arkitekter, der designer til regulerede kliniske miljøer, skal bekræfte den aktuelle HIPAA-certificeringsstatus hos Salesforce-overensstemmelsesteamet, før de forpligter sig til en Dokument AI-baseret arkitektur inden for disse kontekster.
Lad os se nærmere på flere scenarier, der kalder Document AI REST API med et skema, der ikke er bundet til et UDMO. Udtrukne JSON-data distribueres direkte til eksterne systemer synkront på kørselstidspunktet.
Supply Chain: Leverandør faktura behandling til ERP
Når en _leverandørfaktura-_PDF ankommer i en overvåget lagerinddeling eller mailgateway, kalder en begivenhedsudløser Document AI REST API med fakturaen og et foruddefineret skema-id. Skemaet udtrækker VendorID, InvoiceNumber, LineItems, TotalAmount, TaxAmount og DueDate. JSON-data distribueres via MuleSoft til ERP Accounts Payable modulet med nul feltvalidering og idempotent upsert logik, hvilket eliminerer skabelonvedligeholdelse for leverandørformatvariation.
Juridiske operationer: Kontraktgennemgang til CLM
Når en _kontrakt-_PDF uploades til den juridiske portal, kalder backend Document AI REST API synkront. Skemaet udtrækker GoverningLaw, IndemnityCapAmount, TerminationNoticePeriod, AutoRenewalClause og CounterpartySignatory. JSON-data distribueres via Apex udkald til systemet CLM (Contract Lifecycle Management). Alle felter, der ikke findes, returneres som nul, og CLM anvender standardforpligtelsesreglerne på de manglende værdier.
Forsikringsskader: Første meddelelse om tabsbehandling
Når en forsikringstager indsender en First Notice of Loss (FNOL) formular, kalder backendportalen Dokument AI REST API synkront. Skemaet udtrækker PolicyNumber, IncidentDate, IncidentLocation, DamageDescription, ClaimantName og ContactPhone. JSON-data distribueres til databasen for kravsstyring via Apex-udkald eller ETL, som opretter en forudfyldt skadesregistrering, som justeringsselskaberne kan gennemgå, før den formelle skades åbnes.
Før du flytter til produktion, skal du oprette designs for disse missscenarier.
- Nul felthåndtering: LLM returnerer nul for felter, det ikke kan finde eller udtrække med tillid. Valider nul-håndteringslogik ved skemadesign, og implementer standardværdi eller afvisningslogik i integrationslaget, før du skriver til mål med begrænsninger ikke nul eller påkrævede matchnøgler.
- OCR-kvalitetsforringelse: OCR-nøjagtighed nedsættes til under 150 DPI ved uregelmæssig håndskrift eller ved støjende scanninger. Forkertlæsninger udbredes til LLM-udtrækning som ødelagt input uden fejlsignaler. Håndhæv minimal scanningskvalitet ved overførsel, og implementer konfidensstærskelkontroller på numeriske og datofelter.
- Skemaversions uoverensstemmelse: Opdatering af en skemakonfiguration, efter et batchjob er planlagt, medfører, at flyvende dokumenter behandles i forhold til den tidligere version, hvilket producerer manglende eller omdøbte felter, der afbryder downstream-tilknytning. Versionsskemaer eksplicit og koordiner opdateringer med batchjobtidsplaner.
- Grænser for filstørrelse: Dokumenter, der overskrider 10 MB, afvises. Batch-pipelinefejl er tavse uden overvågning konfigureret, og transaktionsopkald modtager en 4xx fejl. Valider filstørrelser på forhånd ved overførsel, og implementer forhåndsbehandling for at opdele eller komprimere dokumenter, der regelmæssigt nærmer sig grænsen.
- LLM-kontekstoverløb: Tætte dokumenter eller dokumenter med flere sider kan overstige LLM-kontekstvinduet inden for grænsen på 10 MB. LLM fjerner i stilhed indhold, der overskrider konteksten. Implementer en segmenteringsstrategi, der opdeler dokumenter efter sideområde og samler de udtrukne felter igen, før du overfører dem til målet.
- Trust Layer Maskering påvirker udtrækning: ETL fungerer på meddelelsesniveauet – ikke på dokumentniveauet – så maskering gælder ikke for dokumentindhold, der passerer gennem Dokument AI. Skemafelter, der er afhængige af PII-værdier i dokumentet, påvirkes ikke af ETL-maskeringspolitikker.
- Ekstern RDBMS Write Idempotens: Den transaktionelle behandlings pipeline har ingen indbygget idempotens for eksterne RDBMS mål. Genforsøg med integrationslag opretter dubletrækker, medmindre skrivelogikken håndterer fjernelse af dubletter eksplicit. Implementer idempotente upserts ved brug af et dokumentfingeraftryk eller et eksternt id på alle eksterne skrivestier.
- Kreditudnyttelse midt i kørslen: Store batchkørsler kan opbruge Digital Wallet-kreditter, før alle dokumenter behandles, hvilket resulterer i ufuldstændige DLO-datasæt, som downstream-trin betragtes som fuldstændige. Indstil forbrugsalarmer til 75 % og 90 % af tilgængelige kreditter, og begræns batchstørrelser for at forblive inden for kreditbudgettet for hver cyklus.
- Skemafeltgrænse – arkitektonisk begrænsning: Dokument-AI håndhæver en grænse på 50 felter for felter på rodniveau i en skemakonfiguration. Dette er en tidsbegrænsning for design – ikke en kørselsfejl – og arkitekter skal tage højde for det under datamodel- og skemadesign.
- For anvendelsessituationer, der kræver bredere udtrækning:
- Prioriter ubarmhjertigt. Indsnævr skemaet til felter, der styrer automatiseringsværdien, ikke omfattende dokumentdækning.
- Anvend indlejrede objekter (op til 3 niveauer, batchtilstand med kun kildeobjekt) for at reducere antallet af felter på rodniveau uden at ofre udtrækningsdybde.
- Opdel komplekse dokumenter på tværs af flere Dokument AI-konfigurationer, der er målrettet mod forskellige dokumentafsnit, og skriv resultaterne til at adskille DLO’er, der sammenføjes downstream i Data 360.
- For anvendelsessituationer, der kræver bredere udtrækning:
- API-frekvensgrænser: Dokument-AI håndhæver en grænse på 50 udtræknings-API-kald pr. minut pr. lejer. Det teoretiske loft er 300 opkald pr. minut, som er styret af Einstein LLM Gateway. Højvolumen transaktionsmæssige integrationer skal designes med eksponentiel afvisning, anmodningskø og budgettering af gennemsnit på lejerniveau. Antag ikke, at udbrudskapacitet er tilgængelig i produktionsmiljøer med flere lejere.
- API-forsinkelsesprofil: Dokument-AI-udtræknings-API’er er fuldt synkrone. Typiske svartider varierer fra 5-15 sekunder, og de varierer efter filstørrelse og skemakompleksitet.
- Dette har direkte implikationer for integrationsarkitektur:
- Indstil opkaldstimeouts til et 30-sekunders minimum.
- Kald ikke Dokument-AI i forløb med under-sekunders SLA-krav.
- Faktorforsinkelse i beregninger af gennemsnit i forhold til grænseværdien for batchbearbejdningspipelines.
- Indstil opkaldstimeouts til et 30-sekunders minimum.
- Dette har direkte implikationer for integrationsarkitektur:
- Krypterede og adgangskodebeskyttede dokumenter: Dokument-AI behandler ikke adgangskodebeskyttede filer (brugeradgangskoder kræves for at åbne filer) eller PDF’er, der er krypteret med en ejer-/tilladelsesadgangskode, herunder filer, der åbnes normalt, men som begrænser kopiering, udskrivning eller redigering på PDF-tilladelsesslaget.
- Denne begrænsning findes ved overførselsgrænsen:
- Design pipelines til indsamling af dokumenter til at registrere og distribuere krypterede filer til en afvisning eller en manuel behandlingssti, før de når frem til Dokument AI.
- Afhæng ikke af kørselsfejlhåndtering som den primære gate.
- Denne begrænsning findes ved overførselsgrænsen:
Data 360 Document AI er i overensstemmelse med flere søjler i Salesforce Well-Architected Framework.
- Trust: ETL håndhæver nul datatilbageholdelse med LLM-udbydere, maskerer PII-input, før de når modellen, og scanner output for følsomt indhold. Architekter skal udvide denne holdning til udtrukne data, der er inaktive. Maskering på feltniveau i DLO’er anvendes ikke af ETL, og det kræver downstream-politikker for datastream og tilladelsessæt.
- Pålidelighed: Hver fejltilstand i afsnittet Design Overvejelser – nulfeltudtrækning, OCR-fejllæst, skemaversionsfejlmatch, filstørrelsesbrud, LLM-kontekstoverløb, ETL-maskeringsinterferens, RDBMS-skrivebeskyttelse og kreditudtømning – repræsenterer en særskilt fejlklasse med et dokumenteret registreringssignal og en løsningssti.
- Operational Excellence (ændringsstyring): Den skemastyrede udtrækningsmodel adskiller udtrækningslogikken fra dokumentlayoutet. Når en leverandør ændrer et fakturaformat, eller en bestemmelsesformular opdateres, behøver arkitekter kun at opdatere en skemakonfiguration i stedet for at redigere integrationskode.
- Operational Excellence (vedligeholdelighed): Centralisering af skemakonfigurationer i Data 360 i stedet for at integrere udtrækningslogik i applikationskode gør udtrækningshensigten eksplicit, versioneret og auditerbar. Alle downstream-mål forbruger den samme skemakontrakt, uanset deres målniveau.
- Operational Excellence (integrationsgenbrug): Dokumentet AI viser ekstraktion på tværs af flere integrationsoverflader: REST API, Apex, Flow, MuleSoft, Agentforce Actions og MCP-serveren. En enkelt skemakonfiguration udvider til flere målniveauer samtidigt uden at genopbygge udtrækningsfunktionen pr. forbruger.
- Optimering af ressourcer og omkostninger: Vejledningen for pipelinevalg, grænsen for filstørrelse på 10 MB og begrænsningerne for længden på før-assembly-LLM-kontekst repræsenterer præstationsbevidste designbeslutninger. Afsnittet Når skal der bruges formaliserer betingelserne for, hvornår Dokument-AI ikke er det rigtige værktøj (f.eks. forsinkelseskrav under sekunder, fuldt strukturerede kildedata og maskingenererede dokumenter med fast skema).
Dette er et struktureret udgangspunkt for konfiguration af Data 360 Document AI i et sandbox-miljø. Fuldfør alle faser i sandboxen, før du går videre til produktion.
Før du starter konfigurationen, skal du bekræfte:
- Fillestørrelse: Valider, at de repræsentative dokumentstørrelser er under 10 MB.
- Pipeline: Bekræft, om anvendelsessituationen kræver batch-pipelinen (UDMO-støttet, højvolumen) eller transaktionsbehandlingspipelinen (API-drevet, enkelt dokument). Dette styrer al efterfølgende konfiguration.
- Målniveau: Bekræft, hvor de udtrukne data lander – Salesforce SObject, Data 360 DLO/DMO, eksternt RDBMS eller en kombination.
- Agentforce-afhængighed: Før du implementerer enhver Agentforce-drevet dokumentbehandling, skal du bekræfte, at en understøttet LLM (f.eks. GPT-4o) er aktiveret i din organisation via ETL-indstillingerne. Agentforce er en hard platform forudsætning for Dokument AI. Hele funktionsområdet Dokument AI – inklusive alle udtræknings-API’er – er ikke tilgængelig, før Agentforce er aktiv i målorganisationen. Faktorer dette i organisationsparathedsvurderinger og klargøringssekvensering. Giv et par minutter til API-tilgængelighed for at stabilisere efter aktivering.
- Agentforce Inaktivering-påvirkning: Hvis Agentforce er inaktiveret efter konfiguration og implementering af Dokument AI, blokeres al udtrækningsbehandling (UI og API) med det samme. Det samme gælder for modelinaktivering. Inaktivering af den underliggende model har en tilsvarende effekt på tilgængeligheden af Dokument-AI. I begge tilfælde bevares de eksisterende skemakonfigurationer og vil forblive synlige – ingen konfiguration eller tab af data vil forekomme – men funktionaliteten er fuldstændig inaktiveret, indtil Agentforce og modellen er genaktiveret. Design operationelle kørselsbøger til at behandle Agentforce-tilgængelighed og modelaktivering som _Dokument-AI-_tilstandsafhængigheder.
- Kreditforbrug/prissætning: Brug Data 360-kreditter eller Flex Credits til TCO-estimater, der er afledt fra repræsentative eksempeldokumenter.
- Opret skemakonfigurationen. Definer udtrækningsfelter, datatyper og instruktioner i JSON Schema-format i opsætningen af Data 360 Document AI. For batchpipelinen skal du binde den til et UDMO. For transaktionsbehandlingspipelinen skal du oprette den uden et kildeobjekt. Registrer skema-id’et.
- Juster feltnavne til målniveauet. Match feltnavne med DLO-kolonnedefinitioner, SObject API-navne eller RDBMS-kolonnenavne. Ikke-justerede navne opretter tilknytning overhead i integrationslaget.
- Konfigurer UDMO-kildeobjektet (kun batch). Definer dokumenter i omfang og konfigurer overførselskildeforbindelse (f.eks. S3, Google Cloud Storage, Salesforce Files eller MuleSoft). Bekræft, at overførselstjenestekontoen har det krævede omfang for IAM- eller OAuth-legitimationsoplysninger.
- Anvend politikker for personligt identificerbare oplysninger. Konfigurer datamaskeringspolitikker i ETL-indstillingerne, før du behandler noget reguleret indhold. Definer, hvilke felttyper (PHI, PII og finansielle identifikatorer) der maskeres, før input når LLM. Udskyd dette trin ikke.
- Tildel dataområdets omfang og tilladelsessæt. Omfangsbehandling til det relevante datarum og konfigurer tilladelsessæt til at styre skemaoprettelse, batchjobkørsel, REST API-kald og downstreamaktivering.
- Konfigurer API-godkendelse (kun transaktionel behandlings-pipeline). Opret en tilsluttet app med OAuth omfang cdp_ingest_api og api. For interne opkald skal du bruge en navngiven legitimationsoplysning, der linker til en ekstern legitimationsoplysning. For eksterne opkald skal du konfigurere OAuth 2.0-klientlegitimationsoplysninger eller et JWT-bearer-forløb. Test og valider udtrækning, før du fortsætter.
- Subject-skriv tilbage: Implementer et Apex (@InvocableMethod) eller et forløbselement, der knytter JSON-svarfelter til SObject-felter. Brug Database.upsert() med et eksternt id for at forhindre dubletter. Anvend sikkerhed på feltniveau på målfelter for SObject.
- Data 360 DLO/DMO-pipeline: Tilknyt udtrukne DLO-felter til DMO’er, der er i overensstemmelse med Customer 360-datamodellen. Konfigurer regler for identitetsløsning for at linke dokumentregistreringer til forenede enkeltpersoner. Definer beregnede indsigter, og tilføj DMO’er for Agentforce. For den transaktionelle behandlings-pipeline skal du distribuere JSON-dataene til en DLO via overførsels-API’en først.
- Eksternt RDBMS eller datalager: Vælg integrationsmønsteret: MuleSoft (eksisterende integrationsstruktur), Apex HTTP-udkald (letvægt, organisation-indbygget), platformsbegivenheder med Pub/Sub-abonnenten (begivenhedsstyret) eller ETL (højvolumen batch). Implementer idempotente upserts ved brug af et dokumentfingeraftryk eller et eksternt id på alle eksterne skrivestier.
- Aktiveringsstier: Tilslut Agentforce til skemakonfigurationer for interaktiv udtrækning. Konfigurer forløbs- eller Apex-udløsere for automatiserede behandlingsarbejdsflows, og fastsæt aktiveringsmålene for hver feltgruppe.
- Fejlhåndtering (kun transaktionsbehandlingspipeline). Konfigurer den fulde HTTP-svaroplevelse: 200 (vundet, herunder delvise nul svar), 400 (forkert udformet anmodning eller skema-id ikke fundet), 413 (fil overstiger 10 MB), 5xx (servicefejl). Implementer eksponentiel tilbagerulning for 5xx-forsøg med maksimalt 3 forsøg. Registrer det rå JSON-svar og skema-id på hvert kald.
- Testskemaer mod prøvedokumenter. Indsend repræsentative prøver via Document AI-grænsefladen eller REST API. Bekræft udtrækningsnøjagtighed, feltdækning og null-håndtering på tværs af layoutvariationer.
- Valider nul-felthåndtering. Bekræft, at alle downstream-mål kan håndtere nulværdier for felter, der ikke findes i et dokument. Husk på, at Ikke nul-begrænsninger mislykkes uden eksplicit nul-håndtering.
- Valider filstørrelser på forhånd. Bekræft, at produktionsdokumenter forbliver under 10 MB. Implementer forbehandling for at opdele eller komprimere dokumenter, der regelmæssigt nærmer sig grænsen.
- Valider end-to-end ekstraktion. For batchpipelinen skal du starte en fuld kørsel og bekræfte, at de udtrukne felter lander korrekt i hvert målniveau. For transaktionel behandling kan du spore JSON-svaret gennem integrationslaget til målet. Bekræft udløseren og forløbsudførelsen for SObject-målene, linket til identitetsløsning for DLO/DMO-målene og idempotensen for RDBMS-målene.
- Bekræft Trust Layer-adfærd. ETL anvender ikke PII-maskering på dokumentindhold, så LLM returnerer PII-data i udtrukne felter som de er. Bekræft, at dine skemafelter, datadistribution og downstream-lagring er designet til at håndtere PII-beholderoutput korrekt, og sørg for, at eventuelle overensstemmelses- eller bevarelseskrav håndteres uden for platformen.
- Angiv Digital Wallet-advarsler. Konfigurer forbrugsalarmer ved 75 % og 90 % af tilgængelige kreditter. Etabler batchstørrelsesgrænser og ad hoc-frekvensestimater i kreditbudgettet for hver cyklus.
- Valider batchovervågning (kun batchpipeline). Gennemse succesfrekvenser for udtrækning, feltfrekvenser til nul og jobfuldførelse i overvågningskonsollen Data 360. Bekræft tagudbredelsen fra UDLO gennem DLO til DMO i dataafstamning.
- Valider API-fejlhåndtering (kun transaktionsbehandlingspipeline). Test alle fejlbetingelser: 413 (dokumenter over 10 MB), 400 (ugyldige skema-id’er), 200 (gyldige udtrækninger med delvise nuller). Bekræft, at genprøvelogikken udløses på simulerede 5xx-svar uden at oprette dubletskrivninger.
Dette dokument fremhæver det arkitektoniske grundlag for Data 360 Document AI:
- To behandlingspipelines, og hvornår de skal bruges
- Skemakonfigurationsmodellen
- Beslutningsstrukturen for målniveau
- Kerneteknologibegrænsninger
- Fejltilstande
- Tilpasning af den veludformede ramme
Guiden Hurtig start for arkitekter indeholder konfigurationssekvensen for en sandbox-konceptbevis.
Kernearkitekturen understøtter dokumentafledte data, der styres på skema-laget, behandles via en ETL-håndhævet LLM-pipeline og leveres til den samme Data 360-datalivscyklus, der styrer alle vores andre virksomhedsdata.
Architekter, der anvender disse principper – vælger den korrekte pipeline, designer skemaer på dokumenttypeniveau og designer til fejltilstande før produktion – opbygger udtrækningsfunktioner, der skaleres og kan udholdes under regulerede krav til branchestyring.
Yugandhar Bora er Software Engineering Architect hos Salesforce, der er specialiseret i dataarkitektur inden for platformen Data and Intelligence Applications. Han fører initiativer i EARB (Enterprise Architecture Review Board), der fokuserer på datastyring og forenede datamodeller, samtidig med at han bidrager til automatiserede platformsprovisioneringsløsninger.
Ananth Anto er direktør for produktstyring hos Salesforce Data 360, der fører initiativerne Dokument AI og Data Graph. Baseret i Bangalore samarbejder han med virksomhedskunder om at løse udfordringer i forbindelse med dokumentbehandling og dataintelligens i den virkelige verden. Han nyder at udforske Enterprise anvendelsessituationer for generativ AI (Gen AI).
Nishan Naseer er Software Engineering Architect hos Salesforce, der arbejder med ustruktureret databehandling, RAG pipelines og Dokument Intelligence. Han er passioneret for at udnytte styrken i AI til at håndtere udfordringer i den virkelige verden og finde kreative løsninger på komplekse kundeproblemer.