Virksomhedsdataarkitekturer findes sjældent i ét system. Salesforce administrerer kundeengagement, pipeline- og serviceinteraktioner. Analytiske platforme som Snowflake opbevarer historiske transaktioner, økonomiske registreringer, anvendelsesdata og driftsmæssige metrikker. Oprettelse af bro mellem disse to verdener betød traditionelt opbygning og vedligeholdelse af ETL-pipelines: planlagte job, der udtrækker data fra kilden, transformerer dem og indlæser kopier i Salesforce. Som et resultat af disse pipelines ankommer dataene forsinket, styringspolitikker multipliceres på tværs af systemer, og pipelines kræver løbende driftsmæssig behandling.
Salesforce-datavirtualisering tilbyder en anden model. I stedet for at flytte data ind i Salesforce, gør det det muligt for Salesforce at forespørge på data direkte ved dens kilde på kørselstidspunktet uden replikering. Brugere ser eksterne livedata gennem Salesforce-standardgrænseflader. Dataene forlader aldrig deres godkendte hjem. Dette dokument forklarer, hvordan mønsteret fungerer, hvornår det skal bruges, og hvordan du kommer i gang, ved brug af Snowflake som et konkret arbejdet eksempel.
Salesforce-datavirtualisering er et integrationsarkitekturmønster, der gør det muligt for Salesforce at forespørge på data direkte fra eksterne systemer på kørselstidspunktet, uden at kopiere eller replikere disse data i Salesforce-lageret. I stedet for at flytte data ind, sender platformen forespørgslen ud.
Som resultat interagerer Salesforce-brugere med eksterne data gennem velkendte Salesforce-grænseflader (f.eks. sidelayouts, relaterede lister, rapporter eller forløb), mens dataene forbliver i deres autoriserede kildesystem. Styring, adgangskontrol og dataplacering forbliver der, hvor de hører til.
Dette mønster bygger på et enkelt arkitektonisk princip: data forbliver ved kilden. Beregning flyttes til dataene.
De fleste Salesforce-virksomhedsimplementeringer integreres med eksterne dataplatforme (f.eks. datalager, driftsmæssige databaser eller analytiske butikker) gennem replikeringspipelines. Pipelines udtrækker, transformerer og indlæser data i Salesforce efter en tidsplan. Denne tilgang fungerer, men replikering introducerer strukturelle afvejninger:
- Replikerede data forsinkes altid. Pipelines introducerer forsinkelser, og forældede data skaber dårlige beslutninger.
- Hver kopi af data udvider overensstemmelsesomfanget. Følsomme data (f.eks. personligt identificerbare oplysninger, økonomiske registreringer eller helbredsdata) i flere systemer kræver vedligeholdelse af flere styringspolitikker.
- Pipelines kræver løbende driftsinvesteringer, overvågning, fejlhåndtering, skemaafledningsstyring og genbehandlingslogik.
Datavirtualisering håndterer disse afvejninger direkte. Den fjerner pipelinen fuldstændigt for læsbare anvendelsessituationer, bevarer data på deres godkendte placering og giver Salesforce-brugere en realtidsstyret visning af eksterne data uden replikeringens overhead.
Eksterne objekter er den primære mekanisme, hvorigennem datavirtualisering viser eksterne data i Salesforce. De fungerer som Salesforce-standardobjekter: kan forespørges på via SOQL, synlig på sidelayouts og relaterede lister og tilgængelig gennem Salesforce-standard-API’er. Nøgleforskellen er, at der ikke lagres nogen data i Salesforce. Det eksterne objekt er en skemaprojicering: en definition af, hvordan de eksterne data ser ud, ikke en kopi af selve dataene.
Når en bruger indlæser en side eller kører en rapport, der refererer til et eksternt objekt, udfører Salesforce en liveforespørgsel mod det eksterne system og returnerer kun det resultat, der er angivet for denne interaktion.
Når Salesforce udfører en SOQL-forespørgsel mod et eksternt objekt, oversætter det filtre (WHERE-sætninger), sorteringsrækkefølger (ORDER BY) og begrænsninger (LIMIT) til den ækvivalente SQL og sender dem til det eksterne system. Det eksterne system kører forespørgslen på sit eget computing system og returnerer kun det filtrerede resultatsæt. Arbejde sker der, hvor dataene findes, og det er kun svaret, der rejser tilbage til Salesforce.
Datavirtualisering håndhæver to uafhængige sikkerhedslag samtidigt. Det eksterne system anvender sine egne adgangskontroller på forespørgselsudførelsestidspunktet, herunder sikkerhed på rækkeniveau, kolonnemaskering og rollebaseret adgang. Salesforce anvender sin egen sikkerhedsmodel øverst: profiler, tilladelsessæt, sikkerhed på feltniveau og delingsregler. Begge lag er aktive på hver forespørgsel. Ingen af dem erstatter den anden.
Architekter beskriver ofte datavirtualisering som et “nulkopier”-mønster. Nulkopiering betyder ingen vedvarende replikering i Salesforce-lageret. Der er ingen ETL-pipeline, der skriver registreringer i Salesforce-objekter. Der er ingen planlagt synkronisering, der opretter en lokal kopi. Det eksterne objekt indeholder ingen rækker.
Nulkopiering betyder ikke nul datatransmission. Hver gang en bruger forespørger på et eksternt objekt, rejser et resultatsæt fra det eksterne system til Salesforce over netværket. For store resultatsæt eller høj forespørgselsfrekvens er dataudløbsomkostninger og netværksforsinkelse virkelige faktorer, som arkitekter skal designe for. Dette er ikke en begrænsning for at skjule: det er en designbegrænsning, der skal tages højde for.
Overvej disse arkitektoniske forskelle, hvis din anvendelsessituation kræver høje mængder, hyppig adgang eller lav forsinkelse.
Snowflake er et af de mest almindelige eksterne systemer, der er tilsluttet til Salesforce via Data Virtualization. Den fungerer som et konkret eksempel på, hvordan mønsteret fungerer fra ende til ende.
I denne konfiguration opretter Salesforce forbindelse til Snowflake ved brug af Salesforce Connect med SQL-adapteren til Snowflake. Snowflake-tabeller og -visninger vises som eksterne objekter i Salesforce. Når en bruger forespørger på et eksternt objekt, oversætter Salesforce SOQL til SQL og sender det til Snowflake-erklærings-API via et godkendt HTTPS-udkald. Snowflake kører forespørgslen på dets virtuelle lagerbygning, anvender sin egen sikkerhed på rækkeniveau og kolonnemaskering og returnerer kun resultatsættet. Der skrives ingen data til Salesforce-lageret på noget tidspunkt.
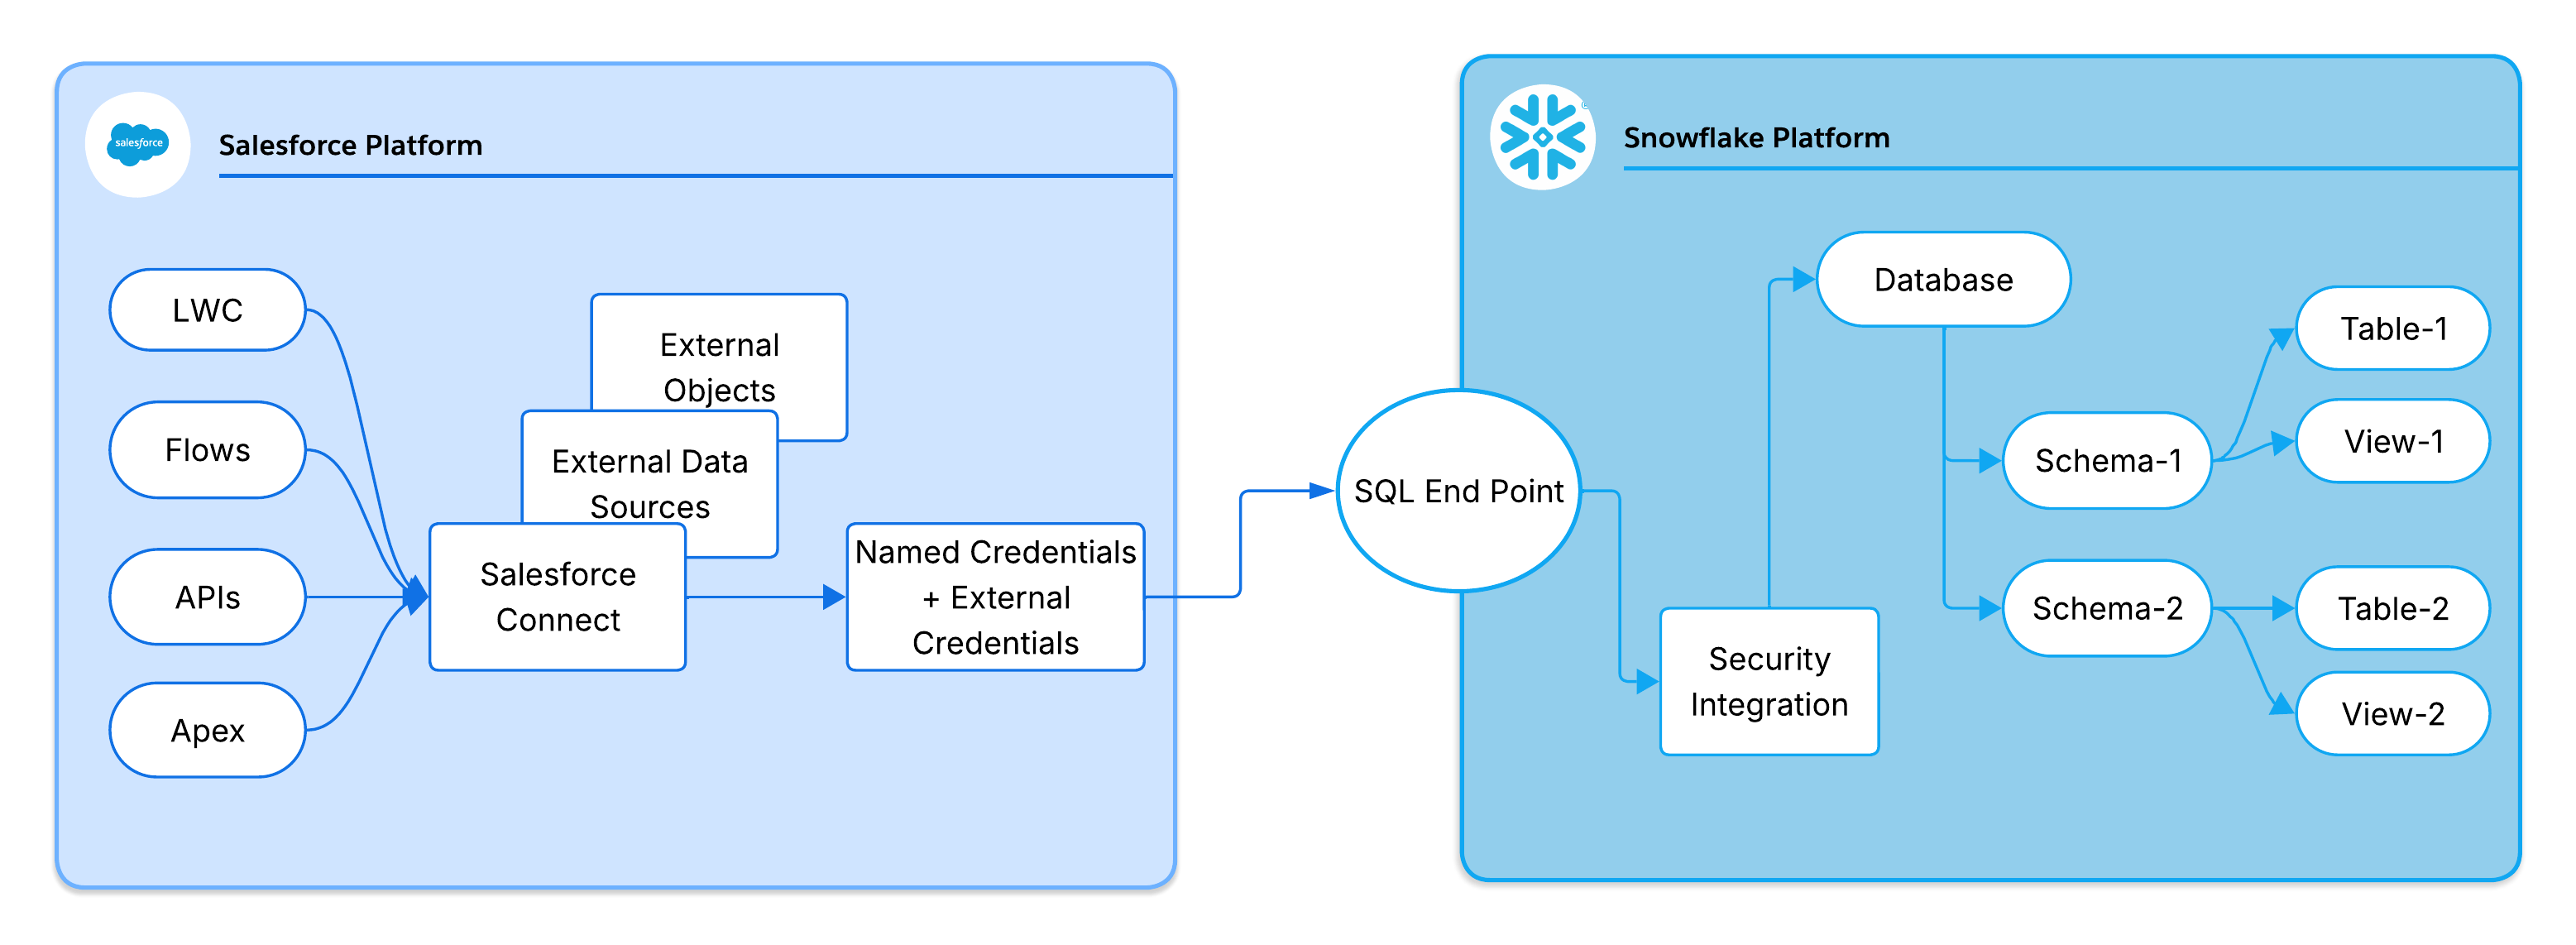
Salesforce Connect bruger en uddelegeret OAuth 2.0-model til at godkende med Snowflake. Nøglekomponenterne er:
- Godkendelsesudbyder: Administrerer OAuth-håndtrykket med Snowflake. Håndterer tokenanmodninger og tilknytter det returnerede token til Salesforce-legitimationsoplysningerne.
- Eksterne legitimationsoplysninger: Bevarer OAuth-adgang og opdateringstokener sikkert i det Salesforce-krypterede legitimationsoplysningslager og injicerer dem i udgående udkald.
- Navngiven legitimationsoplysning: Definerer Snowflake-slutpunkts-URL’en og refererer til de eksterne legitimationsoplysninger.
- Snowflake-sikkerhedsintegration: Registrerer Salesforce som en betroet OAuth-klient i Snowflake. Definerer den tilladte omdirigerings-URI, OAuth-forløb og token-TTL.
Disse komponenter udgør en afhængighedskæde: Ekstern datakilde refererer til de navngivne legitimationsoplysninger, som refererer til de eksterne legitimationsoplysninger, som refererer til godkendelsesudbyderen. Forståelse af denne kæde er vigtig, når du fejlfinder forbindelse eller adgangsfejl.
Salesforce understøtter to identitetsuddelegeringsmodeller, når du godkender med Snowflake:
- Navngivet direktør: En delt servicekonto godkender alle Salesforce-brugere mod Snowflake. Dette er enklere at konfigurere, men har ikke pr. bruger-revisibilitet eller detaljeret Snowflake-adgangskontrol.
- Pro-User Principal: Hver Salesforce-bruger godkendes med sit eget OAuth-token. Dette aktiverer Snowflake-sikkerhed på rækkeniveau og fulde pr. bruger-revisionsspor med en afvejning af overhead for højere tokenadministration (pr. bruger OAuth-forløb, opdatering, tilbagekaldelse).
Beslutningsvejledning: Brug Pr. bruger-kontekst for regulerede data eller personligt identificerbare oplysninger (PII). Brug Navngivet konto, når Salesforce-delingsregler giver tilstrækkelig adgangskontrol, og enkelhed er prioritet.
Disse Salesforce-styring begrænser direkte formatering af design af løsninger, når du bruger eksterne objekter med Snowflake:
- Udkaldsbegrænsning: 100 pr. Apex. Sider eller forløb med flere External Object-forespørgsler kan nå denne grænse hurtigt.
- Timeout opkald: Maksimum 120 sekunder. Langvarige Snowflake-forespørgsler forårsager en kørselsundtagelse.
- SOQL-rækkegrænse: 50.000 rækker. Sideinddel store resultatsæt.
- Asynkrone begrænsninger: Apex og de fleste asynkrone kontekster begrænser udkald. Bevar adgangen Eksternt objekt inden for synkrone transaktionsgrænser. For asynkrone anvendelsessituationer, der forespørger på eksterne objekter, kan du overveje fortsættelsesudkald for brugerinitierede asynkrone interaktioner eller arkitektere forløbet for at udføre ekstern dataadgang i en synkron transaktion og levere resultater asynkront.
Design vejledning: Forespørg ikke på eksterne objekter i løkker. Overfør WHERE-sætningsfiltre til Snowflake for at reducere resultatstørrelse og udkaldsfrekvens.
Hver forespørgsel, som Salesforce sender til Snowflake, logføres i Snowflake-forespørgselshistorik med fulde kørselsmetadata: forsinkelse, rækker scannet, anvendt lager og kørselsidentitet. Denne historik giver end-to-end revisionsmuligheder fra Salesforce-brugerhandling til Snowflake-kørsel og er det primære diagnostiske værktøj til ydeevnetuning og adgangsvalidering.
Datavirtualisering er velegnet til at bruge sager, hvor realtidsadgang, styring og reduceret replikeringsoverhead vejer op over begrænsningerne i en forenet forespørgselstidsadgangsmodel.
Brug den når:
- Læsbar analytisk adgang er det primære krav. Hvis brugerne har brug for at forespørge på og vise eksterne data i Salesforce-brugergrænseflader, rapporter eller forløb uden at skrive tilbage, eliminerer datavirtualisering pipelineoverhead for skrivebeskyttede scenarier.
- Dataklariteten er vigtig. Hvor forældede replikerede data skaber forretningsrisiko (f.eks. forældede finansielle saldi, lagerniveauer eller overensstemmelsesstatus), garanterer den forenede model, at hver forespørgsel afspejler live data.
- Kravene til styring og dataopbevaring er strenge. Når bestemmelsesmæssige eller kontraktmæssige begrænsninger forbyder kopiering af følsomme data i Salesforce, bevarer virtualisering data på deres autoriserede placering, mens de gør dem tilgængelige i Salesforce. Der er kun et system, der indeholder dataene.
- Dobbeltlagsadgangskontrol er påkrævet. Når både det eksterne systems oprindelige adgangskontroller og Salesforce-sikkerhedsmodellen anvendes samtidigt, håndhæver den forenede model begge uden dataduplikering.
- Det eksterne system er allerede det autoritative registreringssystem. Hvis dataene allerede er rene, administrerede og kan forespørges på i kildesystemet, undgår virtualisering af dem overflødig transformation, lagringsomkostninger og uoverensstemmelsesrisiko.
Undgå det, når:
- Skrivning med lav forsinkelse er påkrævet. Eksterne objekter er skrivebeskyttede. Tilbageskrivne anvendelsessituationer kræver et andet integrationsmønster.
- Der er brug for komplekse sammenføjninger med flere objekter. SOQL på tværs af flere eksterne objekter understøtter ikke sammenføjninger. Forhåndsmaterialiser sammenføjede data som en enkelt visning i kildesystemet.
- Salesforce AI- eller Agentforce-funktioner kræver oprindelige data. I øjeblikket fungerer Einstein og Agentforce (herunder grounding for Einstein Copilot, forudsigende scoring og Agentforce) på oprindelige Salesforce-objekter. Disse funktioner understøtter ikke eksterne objekter som en landings- eller aktiveringsdatakilde. Hvis AI-aktivering er i omfang for disse data, er Salesforce Data 360 den anbefalede supplerende løsning.
- Højfrekvent, højvolumen adgangsmønstre. Eksterne objekter er designet til on-demand-adgang. Arbejdsbelastninger, der udløser hundredvis af forespørgsler pr. minut, begrænser udstødningsstyring og nedsætter ydeevnen.
Følgende anvendelsessituationer illustrerer, hvordan Salesforce-datavirtualisering anvendes på tværs af almindelige virksomhedsscenarier. Hvert eksempel bruger Snowflake som det eksterne system, men det underliggende mønster gælder for enhver SQL-kompatibel datakilde, der understøttes af Salesforce Connect.
Udfordring: Supportteams skal have forenede rapporter, der kombinerer Salesforce-sagsdata med billetvolumen, løsningstider og eskaleringsmetrikker, der er lagret i Snowflake. Opbygning og vedligeholdelse af en replikeringspipeline for denne dataintroducerede forsinkelse og tilføjet driftsmæssig overhead for en skrivebeskyttet rapporteringsanvendelsessituation.
Løsning: Teamet viste Snowflake-visninger, der indeholder billetmetrikker som eksterne objekter i Salesforce. Teamet konfigurerede Salesforce-rapporter til at forbinde oprindelige sagsobjekter med de eksterne billeddata.
Resultat:
- Rapporter afspejler altid live Snowflake-data. Ingen pipeline-lag.
- Styring af følsomme supportmetrikker forbliver i Snowflake.
- Ingen ETL-pipeline til at opbygge, overvåge eller vedligeholde.
Udfordring: Et finansieringsteam har bevaret godkendte kreditgrænse- og saldodata i Snowflake. Replikering af disse værdier i Salesforce via omvendt ETL introducerede replikeringsforsinkelse, hvilket medførte, at sælgere forpligtede sig til handler baseret på forældede kreditoplysninger. Overensstemmelsesteamet markerede også risikoen for at opbevare følsomme økonomiske data i Salesforce-lageret.
Løsning: Teamet virtualiserede Snowflake-finansieringsvisningen som et eksternt objekt og viste den på kontosidelayoutet. Sælgere ser nu live-kreditstatus som en del af deres standardkontovisning i Salesforce.
Resultat:
- Kreditdata i realtid på hver kontoside. Ingen forsinkelse.
- Omvendt ETL-pipeline elimineret for finansielle data.
- Følsomme økonomiske data kopieres aldrig til Salesforce-lageret. Overensstemmelsesomfang forbliver i Snowflake.
Udfordring: Under en fusion skulle det overtagende firma give Salesforce-brugere synlighed i driftsdata fra 6 højvolumen Snowflake-datasæt, der dækker transaktioner, fakturering og anvendelse. Replikering af terabyte data i Salesforce var ikke levedygtig på flettetidslinjen, og opbygning af tilpassede ETL-pipelines for hvert datasæt ville have krævet betydelige tekniske investeringer.
Løsning: Teamet konfigurerede eksterne objekter for alle 6 Snowflake-datasæt ved brug af Salesforce Connect med en integrationsrolle med mindst rettigheder. Der kræves ingen tilpasset kode. Forespørgsler køres direkte i Snowflake, og al aktivitet logføres i Snowflake-forespørgselshistorik for overensstemmelsesrapportering.
Resultat:
- Fuldt deklarativ konfiguration. Der kræves ingen tilpasset kode eller pipelines.
- Dataopdatering garanteret. Hver forespørgsel afspejler live Snowflake-data på kørselstidspunktet.
- Fuldt revisionsspor i Snowflake-forespørgselshistorik for rapportering af bestemmelser og overensstemmelse.
Datavirtualisering introducerer en særskilt driftsmæssig profil. Design til disse fejlscenarier:
- OAuth-tokenudløb: Tokener har en begrænset levetid (TTL). Udløbne tokener forårsager udkaldsfejl. Overvåg for 401 uautoriserede svar, og implementer opdateringslogik.
- Lagerkoldstart (Snowflake-specifik): Automatisk suspenderede lagerbygninger tilføjer 5-30 sekunder på den første forespørgsel. For brugerorienterede anvendelsessituationer med forsinkelseskrav, skal du forhåndsvare med en planlagt letvægtsforespørgsel i arbejdstider.
- Rolle mismatch: En forkert konfigureret rolle i det eksterne system kan returnere nulrækker i stilhed snarere end en fejl. Valider rolle-til-objekt-rettigheder i det eksterne system uafhængigt af Salesforce.
- Resultatsætoverløb: Overstørrede data overskrider API-grænser. Anvend altid LIMIT-sætninger, og vis filtrerede visninger i stedet for rå tabeller.
- Ekstern systemnedbrud: Der findes ingen tilbagerulning eller cache. Ombryd udkald i try/catch, og vis informative fejltilstande i brugergrænsefladen. For missionskritiske data kan du overveje en niveauleret tilgang: virtualiser for adgang i realtid, og bevar en let replikeret tilbagerulning for de mest vigtige felter for at garantere tilgængelighed under kildesystemnedbrud.
Salesforce-datavirtualisering er i overensstemmelse med følgende søjler i den veludviklede Salesforce-struktur.
- Trust: Den uddelegerede OAuth 2.0-model og vejledning for roller med færrest rettigheder er i overensstemmelse med Trust. Dobbeltlagsadgangskontrol (kildesystem + Salesforce) håndhæver forsvaret i dybden.
- Pålidelighed (fejltolerance): Afsnittet Fejltilstande håndterer pålidelighed direkte: tokenudløb, koldstart, fejlkonfiguration af rolle, resultatsætoverløb og afbrydelseshåndtering repræsenterer hver en særskilt fejlklasse med en dokumenteret løsningssti.
- Pålidelighed (skalerbarhed): Forespørgsels-push-down, vejledning til lagerstørrelse og udkaldsbegrænsningsbevidsthed optimerer kørselseffektivitet inden for Salesforce-styringsbegrænsninger, hvilket er en pålidelighedsbeskyttelse for løsninger, der fungerer på skala.
- Operational Excellence: Snowflake-forespørgselshistorik som det primære observationsværktøj understøtter driftsmæssig excellence: arkitekter foretager et bevidst, sporbart valg til at bruge platform-oprindelige værktøjer til end-to-end-revisibilitet og ydeevnediagnostik i stedet for at opbygge tilpasset logføringsinfrastruktur.
Dette afsnit giver arkitekter og designere et struktureret udgangspunkt for opbygning af datavirtualiseringsmønsteret i et sandbox-miljø. Det er ikke en komplet implementeringsvejledning – behandl den som en valideret rækkefølge af beslutninger og konfigurationstrin for at orientere din første bevis på konceptet.
Bekræft følgende, før du starter noget konfigurationsarbejde:
- Licensberettigelse: Salesforce Connect er ikke inkluderet i alle Salesforce-versioner. SQL Adapter for Snowflake kræver en separat tilføjelsesprogramlicens ud over basisberettigelsen Salesforce Connect. Bekræft begge i din organisation, før du fortsætter.
- Sandbox først: Fuldfør alle faser i et sandbox-miljø, før du promoverer din konfiguration til produktion.
- Snowflake adgang: Bekræft, at du har tilladelse til at oprette en sikkerhedsintegration i Snowflake og adgang til måldatabasen, skemaet og objekterne.
- Adapterversion: Bekræft, at SQL-adapteren til Snowflake er tilgængelig i din organisationsversion, og at din Snowflake-konto-URL ikke indeholder understregninger (erstat med bindestreger, hvis den gør det. Dette er en Salesforce Platform-begrænsning for løsning af udkaldsværtsnavn).
Opsætning af datavirtualisering med et eksternt SQL-system som Snowflake er en deklarativ, konfigurationsstyret proces – der kræves ingen tilpasset kode. Opsætningen følger tre sekventielle faser: etablering af identitet og Trust, konfiguration af dataoverfladen og udsendelse af data til slutbrugere.
Denne fase etablerer en sikker, uddelegeret OAuth 2.0 Trust kæde mellem Salesforce og det eksterne system. Udfør denne fase, før du starter en datakonfiguration.
- Opret en godkendelsesudbyder i Salesforce. Brug OpenID Connect-typen. Brug pladsholderværdier i denne fase – vend tilbage for at fuldføre den efter hentning af værdier fra det eksterne system. Når du har gemt, genererer Salesforce en tilbagekalds-URL. Bevar denne værdi.
- Registrer Salesforce som en OAuth-klient i det eksterne system. I Snowflake betyder dette oprettelse af en sikkerhedsintegration (OAuth, fortrolig klienttype). Angiv Salesforce tilbagekalds-URL’en som omdirigerings-URI’en. Hent Klient-id, Klienthemmelighed, Godkendelses-URL og Token-URL fra integrationen efter oprettelse.
- Fuldfør konfigurationen af godkendelsesudbyder. Vend tilbage til Salesforce-godkendelsesudbyderen, og udfyld den med de værdier, der hentes fra det eksterne system: Forbrugernøgle, Forbrugerhemmelighed, Godkendelses-URL og Token-URL.
- Opret de eksterne legitimationsoplysninger. Indstil protokol til OAuth 2.0, link den til godkendelsesudbyderen, og tilføj et konto (navngivet eller Pr. bruger, baseret på din beslutning om identitetsmodel). Dette objekt administrerer OAuth-tokenlivscyklussen.
- Opret de navngivne legitimationsoplysninger. Angiv slutpunktet til det eksterne systems API-URL (f.eks.
https://<account>.snowflakecomputing.com/api/v2/statements/), og link det til de eksterne legitimationsoplysninger. - Tildel profiladgang til eksterne legitimationsoplysninger. Uden dette trin kan brugerne ikke kalde forenede forespørgsler, selvom alle andre konfigurationer er korrekte.
- Starte OAuth-forløbet for at fuldføre godkendelse. Udløs OAuth-håndtrykket fra Salesforce. Platformen omdirigeres til det eksterne systemlogin, validerer legitimationsoplysninger og lagrer de resulterende tokener sikkert i de eksterne legitimationsoplysninger. Dette trin binder brugerkontekst til et gyldigt token. Alle forenede forespørgsler mislykkes, indtil dette trin er fuldført.
Denne fase tilslutter Salesforce til det eksterne dataskema og opretter de eksterne objektdefinitioner, som brugere og platformen forespørger på.
- Opret den eksterne datakilde. Vælg den relevante adapter (f.eks. SQL-adapter for Snowflake), peg den på måldatabasen og skemaet, og link den til de navngivne legitimationsoplysninger, du oprettede i fase 1.
- Valider forbindelsen. Brug den indbyggede validering på den eksterne datakilde. Et vellykket resultat bekræfter, at OAuth Trust kæden er fuldført, og at det eksterne system er tilgængeligt.
- Synkroniser metadata. Start en metadatasynkronisering fra den eksterne datakilde. Salesforce undersøger målskemaet og genererer eksterne objektdefinitioner og tilknytter eksterne kolonner til Salesforce-felttyper.
- Vælg og vis de ønskede tabeller eller visninger. Vælg, hvilke eksterne tabeller eller visninger der skal vises som eksterne objekter. Som en bedste fremgangsmåde kan du vise organiserede visninger i stedet for rå tabeller. Visninger tillader forudfiltrering af kolonner, begrænsninger på rækkeniveau og strengere kontrol over, hvad Salesforce-laget har adgang til.
Denne fase gør eksterne objekter synlige og brugervenlige for slutbrugere i Salesforce Lightning Experience.
- Opret faner for eksterne objekter. Faner gør eksterne objekter direkte navigerbare i Lightning.
- Føj eksterne objekter til sidelayouts. Vis relevante eksterne data sammen med oprindelige Salesforce-registreringer (føj f.eks. en Snowflake-finansieringsvisning til kontosidelayoutet).
- Føj til relaterede lister. Inkluder eksterne objekter på relaterede lister for at give brugere en forenet visning af oprindelige og eksterne data i konteksten.
- Valider end-to-end-forespørgselsfederation. Indlæs en side, eller kør en forespørgsel, der refererer til et eksternt objekt. Undersøg derefter det eksterne systems forespørgselshistorik (f.eks. Snowflake-forespørgselshistorik) for at bekræfte, at forespørgslen blev afviklet ved kilden. Bekræft, at den korrekte rolle, lagerbygning og identitet kørte forespørgslen.
Når alle tre faser er fuldført, kan Salesforce-brugere interagere med live eksterne data gennem Salesforce-standardgrænseflader uden at være klar over, at dataene stammer fra uden for Salesforce.
Salesforce-datavirtualisering erstatter replikeringsbaseret integration med forespørgselstidsfederation. Data forbliver i deres autoritative kilde. Salesforce-brugere interagerer med dem gennem standardplatformsgrænseflader. Der er ingen pipeline at opbygge, ingen kopi at styre og ingen forsinkelse at administrere.
Dette mønster er det rigtige valg, når læsbar adgang, opdatering af data i realtid, streng styring og dobbeltlagsadgangskontrol er de primære drivkræfter. Det er det forkerte valg, når der kræves skrivning, når AI- eller automatiseringsfunktioner afhænger af oprindelige Salesforce-objekter, eller når adgangsmønstre er for høje frekvenser for styringsbegrænsninger til at tage højde for.
Snowflake illustrerer mønsteret godt: en administreret, forespørgselstidsforenet forbindelse, der er etableret deklarativt uden nogen tilpasset kode, kan observeres end-to-end gennem Snowflake-forespørgselshistorik og kan håndhæves gennem både de indbyggede Snowflake-adgangskontroller og den fulde Salesforce-sikkerhedsmodel.
Før du bekræfter denne arkitektur, skal du validere licensberettigelse, vurdere styringsbegrænsning eksponering mod dine forventede adgangsmønstre og bekræfte OAuth-parathed i et sandbox-miljø. Mønsteret belønner tankevækkende opstartsdesign: Få identitetsmodellen, legitimationsoplysningskæden og vis strategi korrekt, og det driftsmæssige fodaftryk er minimalt.
Yugandhar Bora er Software Engineering Architect hos Salesforce, der er specialiseret i dataarkitektur inden for platformen Data & Intelligence Applications. Han leder EARB-initiativer (Enterprise Architecture Review Board), der er fokuseret på dataadministration og forenede datamodeller, mens han bidrager til automatiserede platformsprovisioneringsløsninger.