De fleste enterprise-integrationspipelines mellem Salesforce og eksterne analyseplatforme er afhængige af tilpasset kode. De fungerer, indtil noget går ned. Skemaforskydning, API-udmattelse og huller i permanent sletning kræver konstant ingeniørintervention. Efterhånden som firmaer bevæger sig mod smidige, borgerudvikleraktiverede arkitekturer, bliver denne model til en flaskehals: analyseteams venter på tekniske sprints for at føje et Salesforce-felt til et downstream-skema, mislykkede natlige indlæsninger forsinker mandag morgen-rapportering, og enkle konfigurationsændringer kræver kodegennemgange og implementeringer.
CRM Analytics, Salesforce’s oprindelige analyser og forretningsintelligensplatform, løser dette problem ved at gøre det muligt for firmaer at udforske data, opbygge interaktive dashboards og afdække AI-styrede indsigter uden at forlade Salesforce-økosystemet. Central for denne funktionalitet er en deklarativ, datasynkroniseringsfunktion med lav kode, der er indbygget som standard i platformen: CRM Analytics SyncOut og CRM Analytics SyncIn.
CRM Analytics SyncOut flytter Salesforce-registreringer til eksterne datalager efter en konfigureret tidsplan ved brug af Change Dataregistrering (CDC) til trinvise indlæsninger og indbygget sporing med permanent sletning til at markere permanent fjernede registreringer. CRM Analytics SyncIn henter eksterne data tilbage i Salesforce, tilknytter kolonner til objektfelter og upsert registreringer ved brug af Bulk API 2.0. Begge er konfigureret fuldstændigt gennem Salesforce-opsætning. Ingen pipelines, ingen midlertidige scripts, ingen tilpasset overvågning. Administratorer konfigurerer et synkroniseringsjob i en enkelt opsætningssession. Platformen håndterer kørsel, forsøg, fejllogning og skematilknytning automatisk.
Denne vejledning forklarer mønsteret, hvornår det skal bruges, hvordan det skal implementeres med Snowflake som et udarbejdet eksempel og de arkitektoniske overvejelser, der bestemmer, om det passer til et givent integrationsproblem.
Licensnotat: CRM Analytics SyncIn og SyncOut er ikke tilgængelige på Salesforce-basisversioner uden et CRM Analytics-licenstilføjelsesprogram. Bekræft licensberettigelser, før du designer en synkroniseringsarkitektur, der afhænger af disse funktioner.
Dataintegration er en af de højeste friktionsoverflader i virksomhedsarkitekturen. En tilpasset ETL-pipeline fra Salesforce til en analyseplatform kræver typisk en tilsluttet app til godkendelse, et planlagt job til SOQL-udtrækning, et transformationslag til at afstemme felttyper, et faseinddelt område til masseindlæsning og et overvågningslag til at fange fejl. Hver komponent i tilpasset kode repræsenterer et fejlopunkt.
Omkostningerne ved disse friktionsforbindelser over tid. Skemaforskydning i Salesforce (et omdøbt felt, en ny pluklisteværdi, et ændret API-navn) afbryder pipelinen i stilhed. API-udmattelse under spidsbelastning stopper udtrækningen. Permanent slettede registreringer vises aldrig i måltabellen, hvilket efterlader forældede data, som downstream-analyser behandler som live. Det tekniske team bliver flaskehalsen for rutinemæssige datahandlinger.
CRM Analytics SyncIn og SyncOut ændrer operativmodellen. Konfiguration erstatter kode. Platformen påtager sig ansvaret for kørsel, fejlhåndtering, skematilknytning og observabilitet. Administratorer kan definere, redigere og overvåge synkroniseringsjob uden at hæve en udviklingsbillet.
Resultatet af denne nye driftsmodel er reduceret tid fra integrationsdesign til driftssynkronisering, lavere engineeringoverhead og en integrationsmodel, der skaleres inden for platformsbegrænsninger i stedet for at kræve tilpasset kodevedligeholdelse.
SyncIn og SyncOut er de to retningsgivende tilstande for CRM Analytics-datasynkronisering. SyncOut flytter Salesforce-registreringer til en ekstern platform. SyncIn henter eksterne registreringer ind i Salesforce. Begge fungerer på en deklarativ konfigurationsmodel uden nogen tilpasset kode påkrævet.
Declarative konfiguration betyder, at al synkroniseringsadfærd defineres gennem peg-og-klik-brugergrænsefladen i Opsætning i Salesforce. Kildeobjekt, måltabel, felttilknytninger, synkroniseringstidsplan, synkroniseringstilstand og filtre angives alle gennem konfigurationsmetadata. Platformen afleder kørselsplanen fra disse metadata og administrerer den end til end.
Fuld synkronisering kontra trinvis synkronisering styrer, hvilke data der flyttes på hver kørsel. En fuld synkronisering forespørger på alle registreringer, der matcher filterkriteriet på hver kørsel. En trinvis synkronisering bruger CDC til kun at forespørge på registreringer, der er ændret siden sidste kørsel. Trinvis synkronisering er den anbefalede tilstand for højvolumen objekter, da det reducerer API-forbrug og synkroniseringsvarighed betydeligt.
Change Dataregistrering (CDC) er en Salesforce Platform-funktion, der registrerer ændringer på feltniveau til objekter som begivenhedsstreams. SyncOut bruger CDC til at registrere oprettelser, opdateringer og sletninger uden at udføre fulde tabelscanninger. CDC skal være aktiveret pr. objekt i Salesforce-opsætning, før der kan refereres til det af en synkroniseringskonfiguration.
Sporing ved permanent sletning løser et af de mest vedvarende problemer i Salesforce-til-ekstern ETL. Når en registrering slettes permanent i Salesforce, forsvinder den fra SOQL-standardforespørgsler. Uden eksplicit sporing får den eksterne platform aldrig at vide, at registreringen blev fjernet. SyncOuts sporing med permanent sletning, når det er aktiveret, markerer slettede registreringer i måltabellen med DEL_FLAG = 'Y', hvilket giver downstream-systemer et pålideligt signal til at filtrere forældede data.
Synkroniseringsfrekvensen kan konfigureres fra 15 minutter til ugentligt. Valget er en afvejning mellem dataopdatering, API-forbrug og Snowflake-lagerberegningsomkostninger. 15-minutters synkroniseringstilgang næsten i realtid for driftsmæssige dashboards. Daglige synkroniseringer er passende for batchrapporteringsarbejdsbelastninger.
Governor begrænser synkroniseringsjobdesign: Salesforce API-anmodningsgrænsen (15.000 opkald pr. 24 timer på Unlimited Edition), Bulk API 2.0-batchstørrelsen på 10.000 registreringer og SOQL-forespørgselsrækkegrænsen på 50.000 pr. transaktion giver alle oplysninger om, hvordan synkroniseringsjob skal dimensioneres og planlægges. Platformen håndterer segmentering og sideinddeling automatisk, men arkitekter skal tage højde for begrænset plads på tværs af alle synkroniseringsjob, der kører i organisationen.
Snowflake er et primært mål og en kilde til datasynkronisering med Salesforce CRM Analytics. Den fungerer som et konkret eksempel på, hvordan batch- og trinvis databevægelse fungerer slut på slut.
Dette afsnit giver en oversigt over implementering af CRM Analytics SyncOut og SyncIn ved brug af Snowflake som den eksterne analyseplatform. Den dækker hver metode, de delte godkendelsesmodeller, sikkerhedsstrukturer, nøgleplatformsovervejelser og observationspraksisser.
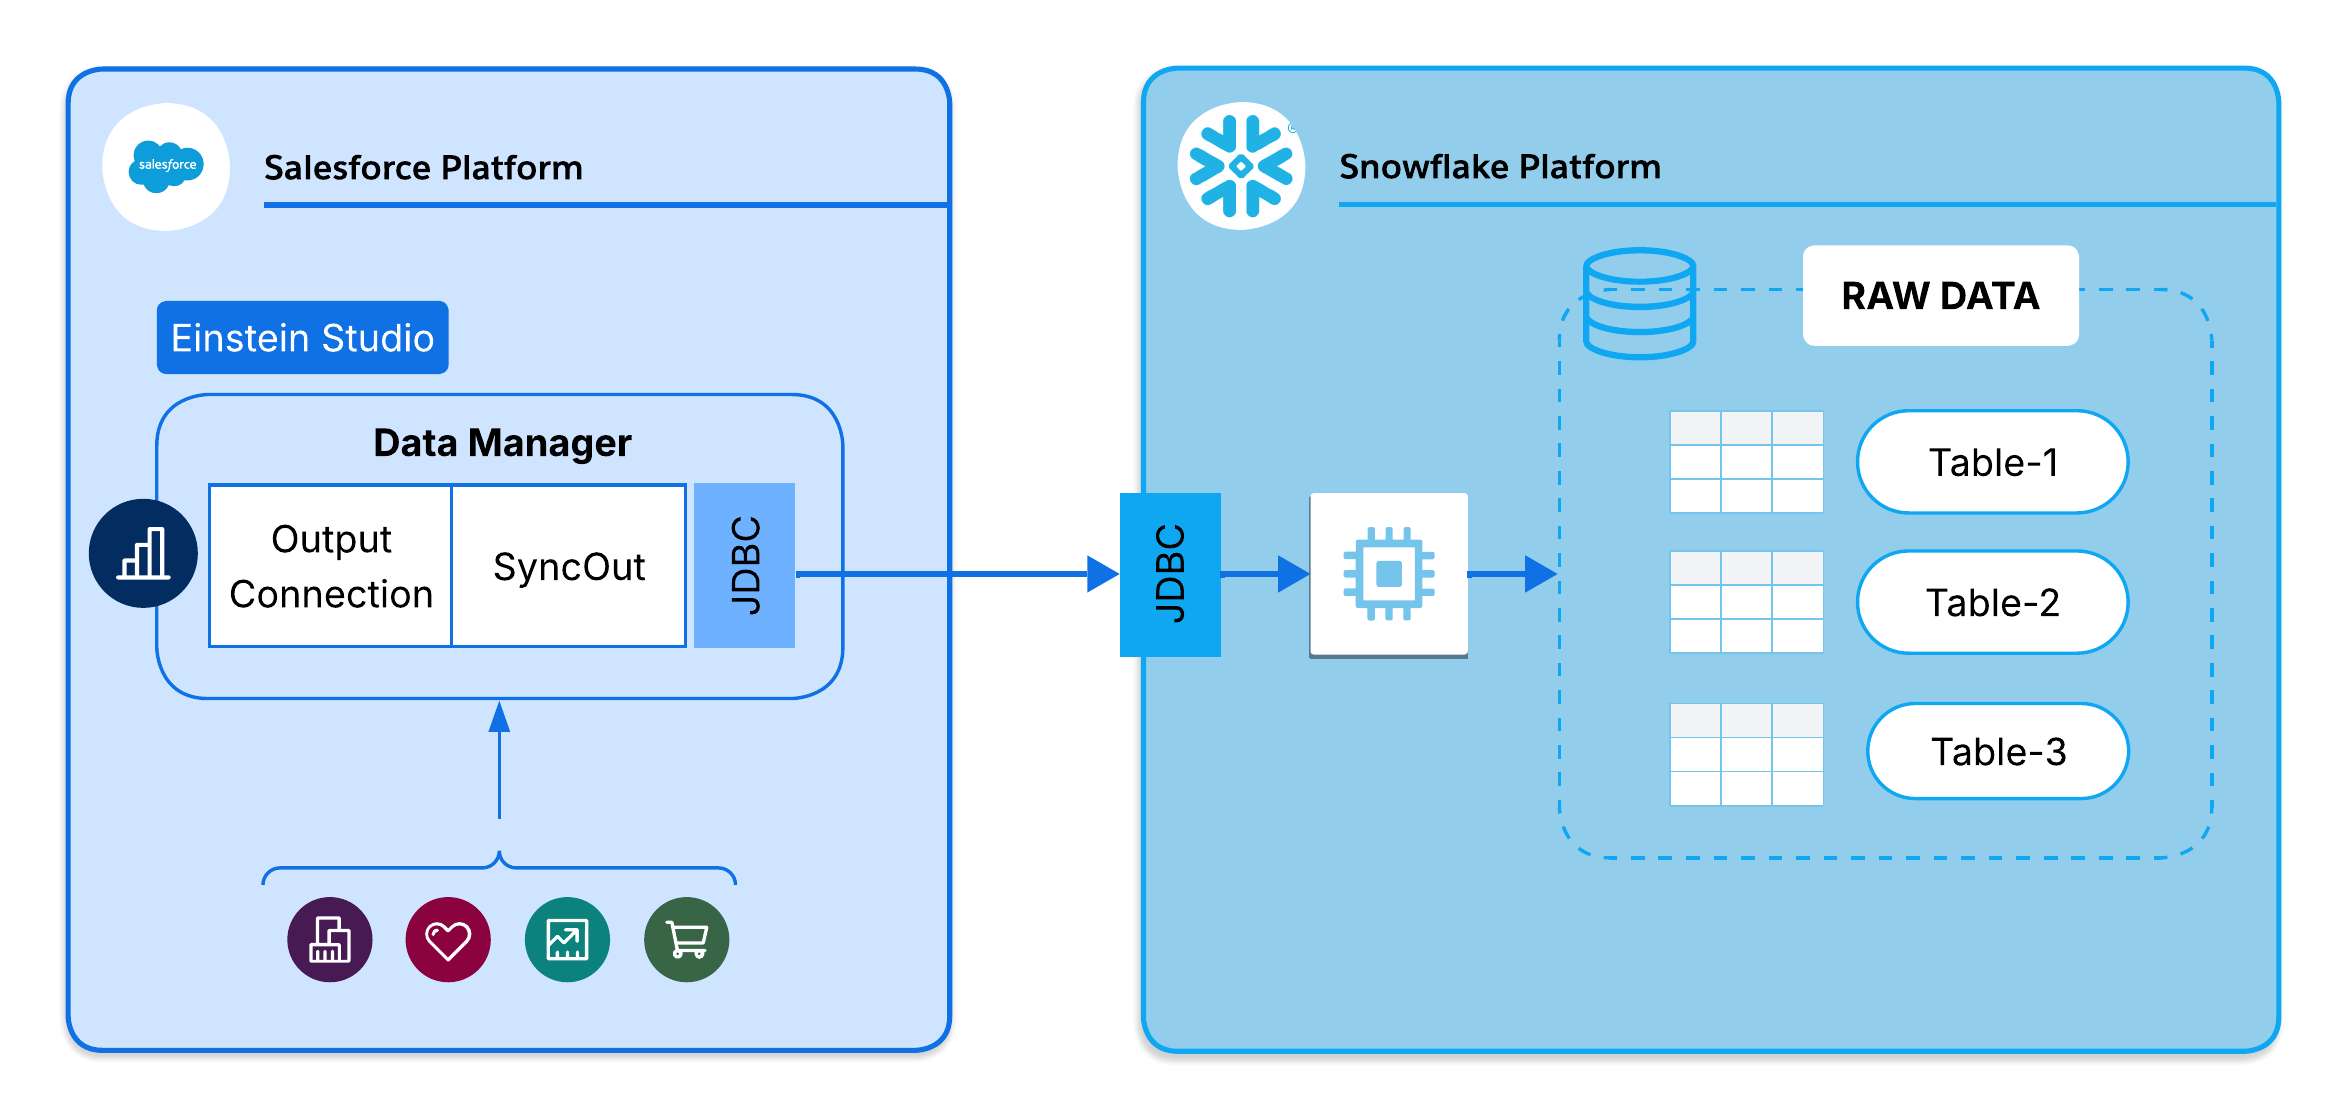
I denne SyncOut-konfiguration bruger Salesforce CRM Analytics SyncOut til at overføre registreringer til Snowflake. Platformen udtrækker data via SOQL, håndterer typekonverteringer automatisk og indlæser dem i Snowflake-tabeller efter en konfigureret tidsplan (fra 15 minutter til ugentligt). Se i den aktuelle Salesforce- og Snowflake-dokumentation for specifik indlæsningssemantik.
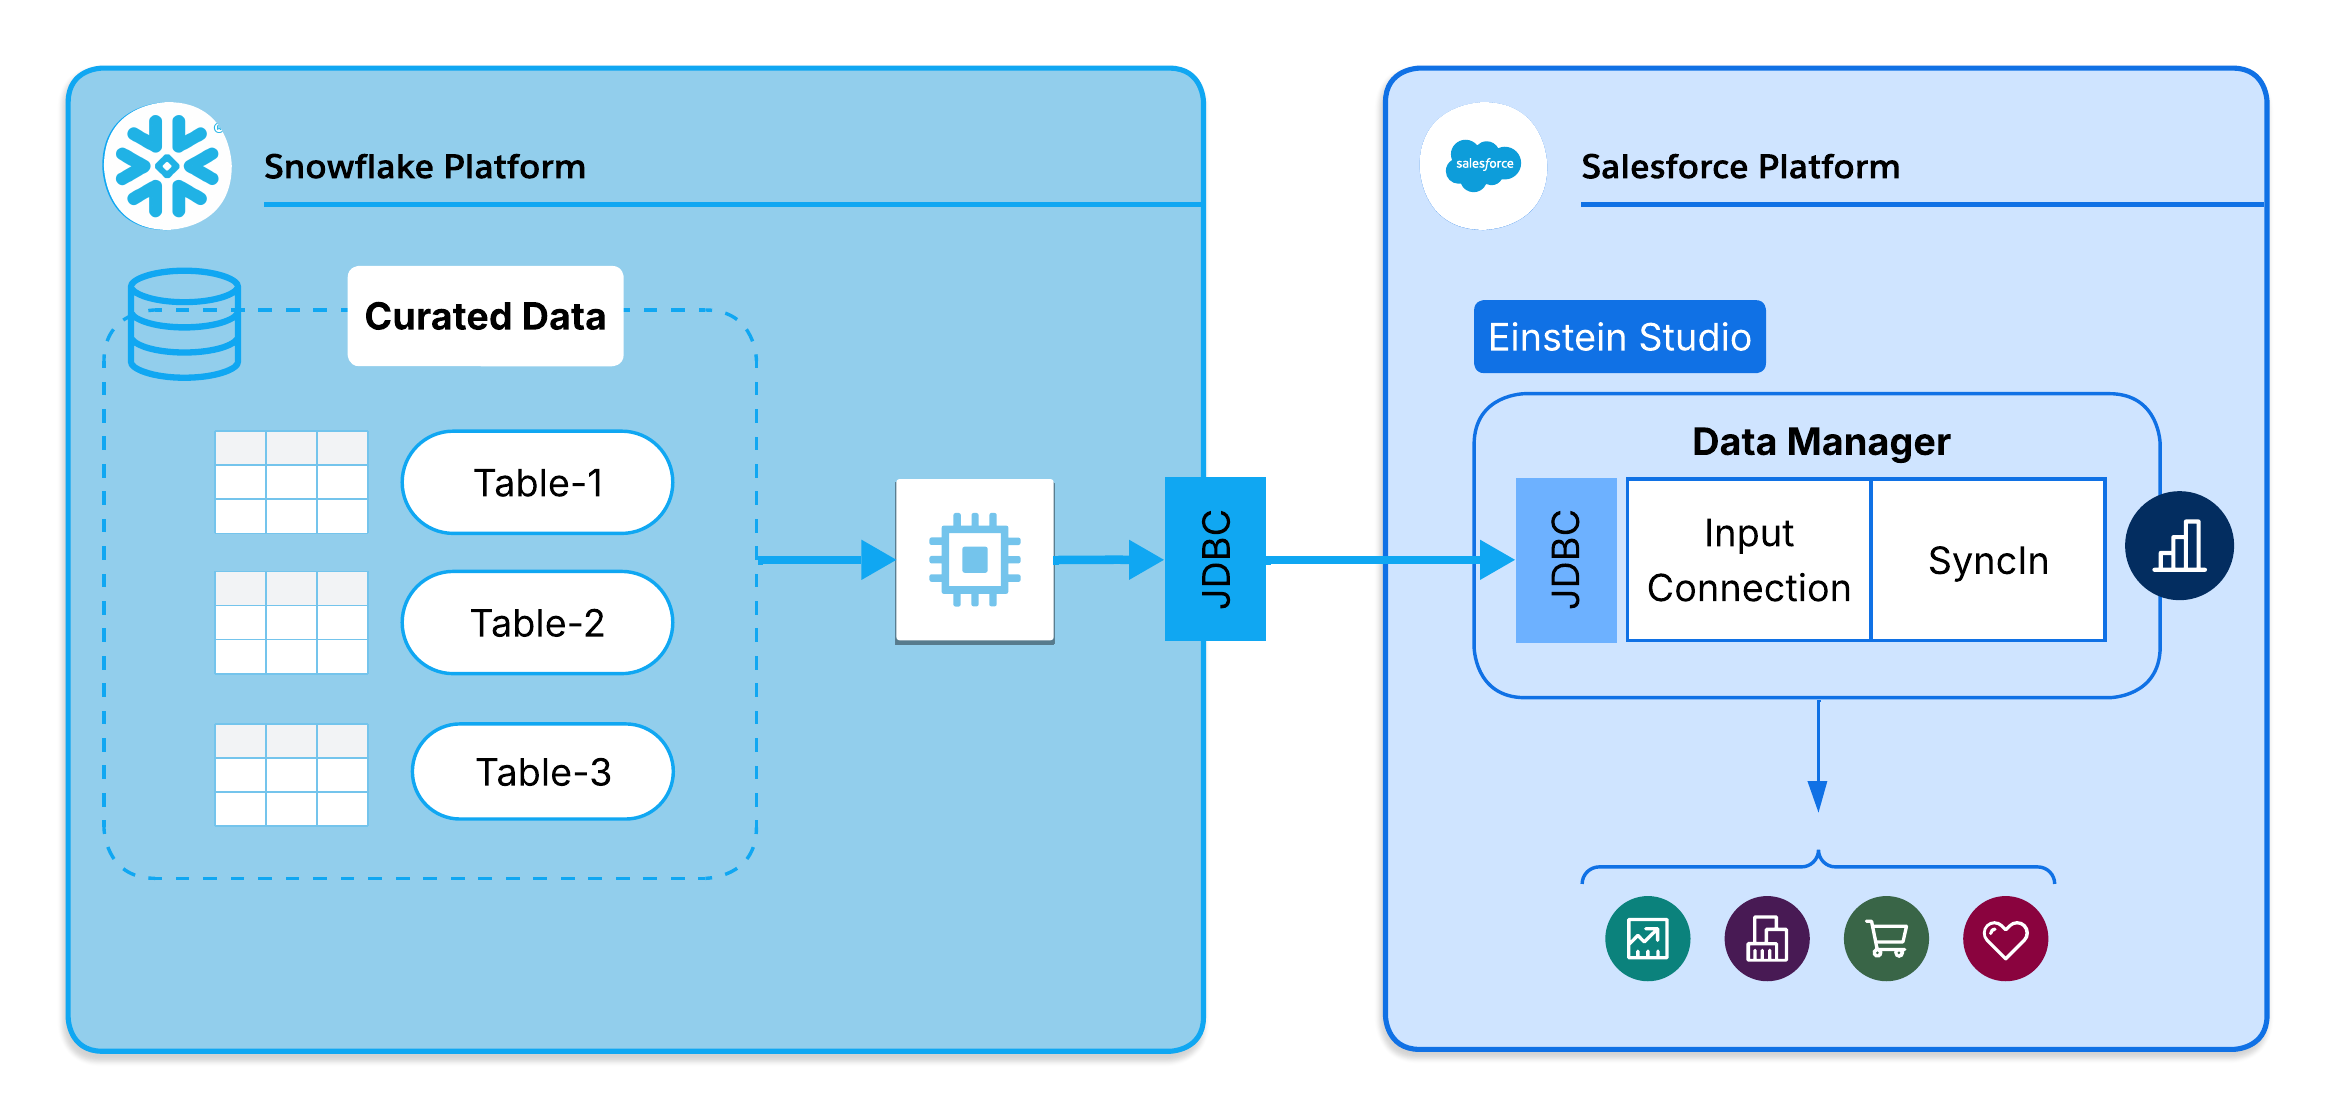
I denne SyncIn-konfiguration bruger Salesforce CRM Analytics SyncIn til at trække data tilbage til Salesforce. Platformen forespørger på Snowflake via erklærings-API og upserts resultaterne i Salesforce ved brug af Bulk API 2.0. Store resultatsæt sættes automatisk på side for at forblive inden for API-grænser. Synkroniseringen kører efter en konfigureret tidsplan, der strækker sig fra 15 minutter til ugentligt.
Salesforce-synkronisering understøtter flere godkendelsesmetoder for at oprette en sikker forbindelse til Snowflake. De to primære tilgange for virksomhedsintegrationer er nøgle-par (privat nøgle) og uddelegeret OAuth 2.0.
Metode 1: Nøgle-par (Privat nøgle) godkendelse: Nøglepargodkendelse er den anbefalede tilgang til automatiseret system-til-system-dataflytning, f.eks. CRM Analytics SyncIn og SyncOut. Godkendelse er baseret på JSON-webtokener (JWT) snarere end adgangskoder eller tokener, der kan opdateres, hvilket gør det velegnet til ikke-overvågede planlagte job, der ikke kræver tokenopdatering.
- Salesforce-certifikat: Generer en privat nøgle, og gem den sikkert i Salesforce-certifikat- og nøglestyring.
- Eksterne/navngivne legitimationsoplysninger: Konfigureret til at bruge en JWT-udveksling. Salesforce bruger den lagrede private nøgle til at signere udgående forbindelsesanmodninger.
- Snowflake bruger offentlig nøgle: Den matchende offentlige nøgle tildeles direkte til den dedikerede Snowflake-servicekonto (f.eks. ALTER USER CRM_ANALYTICS_SYNC_USER SET RSA_PUBLIC_KEY = ’…’). Snowflake bruger derefter denne nøgle til at bekræfte den indgående JWT-signatur. Der kræves ingen sikkerhedsintegration for denne metode.
Metode 2: Uddelegeret OAuth 2.0-godkendelse: Alternativt kan Salesforce bruge et OAuth-håndtryk til at godkende. Nøglekomponenterne er:
- Godkendelsesudbyder: Administrerer OAuth-håndtrykket med Snowflake ved brug af de klientlegitimationsoplysninger, der hentes fra Snowflake-sikkerhedsintegrationen.
- Eksterne legitimationsoplysninger: Indeholder OAuth-tokener sikkert i Salesforce og injicerer dem automatisk i synkroniseringskaldene.
- Navngiven legitimationsoplysning: Definerer Snowflake-slutpunkts-URL’en (f.eks. https://<konto>.snowflakecomputing.com) og henviser til de eksterne legitimationsoplysninger.
- Snowflake-sikkerhedsintegration: Registrerer Salesforce som en betroet OAuth-klient i Snowflake (OAUTH_CLIENT = CUSTOM). Definerer den tilladte omdirigerings-URI og aktiverer opdateringstokener.
Konfigurationsafhængighed: Uanset den valgte metode danner disse komponenter en afhængighedskæde, der forbinder synkroniseringskonfigurationen med slutpunktet. Tildeling af de relevante Salesforce-profiler adgang til de navngivne legitimationsoplysninger er påkrævet. Uden denne adgang mislykkes synkroniseringsjob på grund af godkendelsesfejl, uanset alle andre konfigurationer.
Baggrundssynkronisering er baseret på en enkelt integrationsidentitet.
- Dedikeret servicekonto: Opret en dedikeret Snowflake-servicekonto med en mindste-rettighedsrolle, der kun omfatter de databaser, skemaer og tabeller, der er påkrævet for synkroniseringen.
- Granular Permissions: For SyncOut kræver denne rolle INSERT, UPDATER og SELECT på måltabeller. Brug aldrig roller med høje rettigheder, f.eks. ACCOUNTADMIN, SECURITYADMIN eller SYSADMIN.
- Governor grænser og segmentering: Under SyncOut-udtrækning segmenteres store resultatsæt automatisk for at overholde Salesforce SOQL-styringsbegrænsninger. SyncIn henter store resultatsæt fra Snowflake-erklærings-API’en via automatisk sideinddeling for at administrere datamængder effektivt.
- Change Dataregistrering (CDC): Trinvis synkronisering er afhængig af Salesforce CDC-begivenhedsstream til at identificere registreringer, der er oprettet, opdateret eller slettet. Hvis sporing af permanent sletning er aktiveret, droppes slettede Salesforce-registreringer ikke, men markeres med
DEL_FLAG = 'Y'i Snowflake. - Upsert-begrænsninger: SyncIn er afhængig af Bulk API 2.0 til at indlæse data tilbage i Salesforce. Dette kræver, at der konfigureres et udpeget eksternt id-felt på Salesforce-målobjektet for at fungere som upsert-nøglen.
- Design vejledning: Synkroniser altid fra organiserede Snowflake-visninger i stedet for rå tabeller. Visninger tillader forhåndsfiltrering af rækker, kolonnevalg og anvendelse af forretningslogik, hvilket reducerer datamængde, synkroniseringsvarighed og Snowflake-lagerberegningsomkostninger i forhold til den anvendte forhåndsfiltrering.
Hver synkroniseringskørsel genererer omfattende revisionsspor for at validere dataforflytning. Dashboardet Synkroniser jobovervågning leverer status i realtid, behandlede registreringsantal, kørselsvarigheder og detaljerede fejllogfiler for både SyncIn og SyncOut. På Snowflake-siden logføres hver forespørgsel, der sendes af Salesforce, i Snowflake-forespørgselshistorik, hvilket giver fuld indsigt i kørselsforsinkelse, rækker, der scannes, og lagerkomputeringsanvendelse. Endvidere definerer arkitekter dedikerede Snowflake-revisionstabeller til at registrere metadata for synkroniseringskørsel – tidsstempel, registreringsantal og fejl. Disse genereres ikke automatisk af platformen. For end-to-end-validering kan du sammenligne registreringsantal på tværs af begge platforme: bekræft aktive registreringer i Snowflake (WHERE DEL_FLAG = 'N') for SyncOut-kørsler, og sammenlign Salesforce-målobjektantal direkte mod den oprindelige Snowflake-kildevisning for SyncIn-kørsler.
Brug CRM Analytics SyncIn og SyncOut, når:
- Bidirektionel synkronisering er et krav: Data flyder både ind i Salesforce via SyncIn og ud til en ekstern platform via SyncOut.
- Sporing ved permanent sletning er vigtigt: SyncOuts indbyggede markering løser et historisk komplekst ETL-problem uden tilpasset afstemningslogik.
- CDC-baseret trinvis synkronisering er muligt: For højvolumen Salesforce-objekter reducerer CDC API-forbrug og synkroniseringsvarighed betydeligt i forhold til fulde scanninger.
- Planlagt batchesynkronisering opfylder forsinkelseskrav: Den mindste synkroniseringsfrekvens er 15 minutter, der er egnet til driftsmæssige dashboards og rapportering af analyser i næsten realtid.
- Lave driftsmæssige overhead er en prioritet: Indbyggede dashboards giver fuld synkroniseringssynlighed uden tilpasset logføring eller advarselsinfrastruktur, og den deklarative opsætningsbrugergrænseflade giver administratorer mulighed for at definere, redigere og overvåge synkroniseringsjob uden at hæve en udviklingsbillet.
Brug ikke dette mønster, hvis:
- Der kræves komplekse transformationer: Sammenføjning af flere tabeller, JSON-parsing eller håndtering af avanceret forretningslogik i Snowflake-visninger eller et dedikeret transformationslag før eller efter synkronisering.
- Under 15 minutters forsinkelse kræves: For anvendelsessituationer i realtid skal du bruge Platformsbegivenheder eller Streaming-API’er.
- Meget højvolumen streaming-arbejdsbelastninger er omfattet af: Objekter med millioner af transaktioner pr. time vises bedre af dedikerede streaming-pipelines (Kafka, Platformsbegivenheder).
- Tilpasset fejlhåndteringslogik er nødvendig: Platformen leverer standardforsøg og fejllogføring. Komplekse prøvemønstre eller tilpasset advarsel kræver Apex eller ekstern orkestrering.
- Multi-org- eller cross-cloud-synkronisering: CRM Analytics SyncIn og SyncOut fungerer i en enkelt Salesforce-organisation. MuleSoft eller et tilpasset integrationslag er påkrævet for multi-organisationscenarier.
Et team kørte komplekse ETL-pipelines for at uploade Snowflake-analysedata i CRM Analytics-datasæt. Pipelines var langsomme, skrøbelige og krævede konstant teknisk vedligeholdelse.
CRM Analytics SyncIn blev konfigureret til at synkronisere organiserede Snowflake-aggregerede visninger direkte i tilpassede Salesforce-objekter. Teamet omkonfigurerede CRM Analytics-dashboards til at læse fra disse objekter i stedet for CRM Analytics-datasæt. Resultatet: to ETL-pipelines elimineret, synkroniseringsvarighed reduceret fra fire timer til 30 minutter, og administratorer, der kan redigere synkroniseringskonfigurationer uden at hæve en teknisk billet.
Et datateam, der skal spore permanent slettede Salesforce-registreringer i deres driftsmæssige Snowflake-datalager. Traditionelle tilgange krævede opdelingsjob og kompleks id-justeringslogik, der tog timer at køre og var skrøbelig på tværs af skemaændringer.
Teamet konfigurerede CRM Analytics SyncOut med CDC og sporing af permanent sletning aktiveret. Slettede registreringer markeres nu automatisk med DEL_FLAG = ‘Y’ i Snowflake-forbrugstabellen. Downstream-analyseforespørgsler gælder WHERE DEL_FLAG = ‘N’ for kun at se aktive registreringer. Afstemningslogik blev elimineret fuldstændigt, og synkroniseringsvarigheden faldt fra otte timer til trinvise kørsler på 15 minutter.
Under et køb synkroniserede det erhvervende firma seks højvolumen Salesforce-objekter i Snowflake for krydsorganisationsrapportering og overholdelse af bestemmelser inden for en fast tidslinje.
Teamet konfigurerede CRM Analytics SyncOut for alle seks objekter med CDC-baserede trinvise synkroniseringer. Overvåg metadatatabeller, der sporer skemaændringer og registreringsantal på tværs af integrationsperioden. De skrev ikke nogen tilpasset kode. Datafriskheden blev forbedret fra daglige intervaller til 15-minutters intervaller, og revisionsmetadatatabellerne leverede den sporbarhed, der kræves for overensstemmelsesrapportering.
Synkroniseringsjob deler organisationens API-budget. En organisation, der kører mange højfrekvente synkroniseringsjob mod store objekter, risikerer at udnytte grænsen på 15.000 API-kald pr. 24 timer. Lager alle synkroniseringsjob, estimer API-forbrug pr. kørsel og midlertidige tidsplaner for at distribuere indlæsning. For objekter med lave til moderate ændringsfrekvenser kan CDC-baseret trinvis tilstand reducere API-forbrug pr. kørsel væsentligt sammenlignet med fuld synkronisering.
SyncIn og SyncOut eksekverer forespørgsler og dataindlæsninger mod en Snowflake-lagerbygning og forbruger beregningskreditter. For enkle SELECT-forespørgsler er en X-Lille- eller Lille-lager typisk tilstrækkelig. For store SyncOut-indlæsninger kan der kræves Medium eller Large. Konfigurer automatisk suspendering (5 minutters inaktivitet) og genoptag automatisk på lageret. Brug en dedikeret lagerbygning til produktionssynkroniseringsjob til at isolere omkostninger og forhindre tvister med brugerforespørgsler.
Hvis et Salesforce-felt omdøbes, fjernes eller ændres API-navn, mislykkes den tilsvarende SyncOut-felttilknytning eller registrerer fejl. Etabler en ændringsstyringsproces, der inkluderer gennemgang af aktive synkroniseringskonfigurationer som en del af enhver Salesforce-metadataændring. Snowflake-revisionstabellerne leverer en ændringshistorik, der hjælper med at identificere, hvornår der forekom en afledningsbegivenhed.
Sporing af permanent sletning i SyncOut kræver, at CDC aktiveres på Salesforce-objektet. Hvis CDC ikke er aktiveret, har indstillingen “Spor permanente sletninger” ingen effekt. Valider CDC-aktivering som en del af tjeklisten for synkroniseringskonfiguration, især under den indledende opsætning eller efter organisationsmigreringer.
Den mest almindelige fejlklasse er udløb af legitimationsoplysninger eller tab af tilladelse. Navngivne legitimationsoplysninger skal forblive gyldige, og Snowflake-servicekontoen skal bevare dens lageranvendelsestildelinger og tabeltilladelser. For OAuth-baserede opsætninger kan fejl ved tokenopdatering stille stoppe synkroniseringsjob. Overvåg dashboardet Synkroniser jobovervågning for godkendelsesfejlmønstre, og konfigurer Chatter eller mailadviseringer for jobfejl.
SyncIn bruger et Salesforce External ID-felt som upsert-nøglen. Hvis kilde Snowflake-visningen indeholder dubletværdier på nøglefeltet, mislykkes upsert for påvirkede registreringer. Håndhæv entydighed på nøglefeltet i Snowflake-visningslaget, før det når synkroniseringskonfigurationen.
Når synkroniseringsjob mislykkes, logfører platformen detaljerede fejlmeddelelser pr. registrering i Overvågning af synkroniseringsjob. Almindelige fejlscenarier og deres løsninger:
- Godkendelsesfejl: bekræft status for navngivne legitimationsoplysninger og Snowflake-kontoens udløb. Godkend OAuth igen, hvis tokenopdatering mislykkedes.
- Felttilknytningsfejl: Kontroller typekompatibilitet mellem Snowflake-kolonner og Salesforce-felter. Gennemse sikkerhed på feltniveau for den løbende bruger.
- Governor grænse overskredet: reducer synkroniseringsfrekvens, eller flyt til trinvis CDC-tilstand for at sprede API-forbrug.
- Snowflake lager suspenderet: konfigurer automatisk genoptagelse på lageret, eller udløs en manuel genoptagelse før den næste planlagte synkronisering.
- Hard-slete sporing fungerer ikke: bekræft, at CDC er aktiveret på objektet, og at “Spor permanente sletninger”-flaget er angivet i synkroniseringskonfigurationen.
CRM Analytics-datasynkronisering er i overensstemmelse med flere søjler i Salesforce Well-Architected Framework.
- Pålidelighed (fejltolerance): Platformen administrerer kørsel, logik for at prøve igen og delvis fejlhåndtering automatisk. Mislykkede registreringer logføres individuelt i Overvågning af synkroniseringsjob. Implementer afstemning af registreringsantal efter fejl for at bekræfte ensartethed, supplere med fejladviseringer, og overvåg Synkroniseringsjobovervågning for tilbagevendende fejlmønstre. CDC-baseret trinvis synkronisering reducerer blastradiussen for en mislykket kørsel ved at begrænse datavinduet i omfanget.
- Trust: Legitimationsoplysningsmodellen (navngivne legitimationsoplysninger, eksterne legitimationsoplysninger, godkendelsesudbyder) håndhæver krypteret lagring, automatisk tokenopdatering og centraliseret administration. Mindste-rettighedsadgang på Snowflake-siden begrænser eksplosionsradiussen for en kompromitteret legitimationsoplysning. Sikkerhed på feltniveau håndhæves under synkronisering. Brugere kan ikke synkronisere felter, som de ikke er godkendt til at få adgang til.
- Optimering af ressourcer og omkostninger: Trinvis CDC-tilstand er den primære håndtag for optimering af ydeevne. Det reducerer API-forbrug, synkroniseringsvarighed og Snowflake-beregningsomkostninger sammenlignet med fuld synkronisering. Forudfiltrering af Snowflake-visning reducerer datamængden yderligere under overførsel. Lager automatisk suspendering forhindrer ledigt beregningsforbrug.
- Operational Excellence: Den deklarative konfigurationsmodel betyder, at synkroniseringsjob er defineret i metadata, ikke kode. Dette gør dem reviderbare, reproducerbare og administrerbare uden ingeniørengagement. Indbyggede overvågningsdashboards giver fuld observation uden tilpasset logføringsinfrastruktur.
- Pålidelighed (skalerbarhed): Platformen håndterer segmentering, sideinddeling og masse-API-batching automatisk. For objekter med meget høje registreringsvolumener er trinvis CDC-tilstand og planlægning uden for spidsbelastning de primære arkitektoniske løftelever til vedligeholdelse af gennemsnit inden for styringsbegrænsninger.
Denne tjekliste dækker de mindste trin til at opsætte og validere en synkroniseringskonfiguration.
Konfigurationskontrolliste:
- Aktiver Skift dataregistrering på alle Salesforce-objekter, der er beregnet til trinvis synkroniseringstilstand (Opsætning → Skift dataregistrering).
- Opret en dedikeret Snowflake-servicekonto med en mindste-rettighedsrolle. Tildel kun påkrævede tabel- og lagertilladelser.
- Opret en Snowflake-sikkerhedsintegration, hvis du bruger OAuth-godkendelse.
- Identificer feltet Eksternt id på hvert Salesforce-objekt, som SyncIn vil bruge som upsert-nøglen. Bekræft entydighed i kildedataene.
Forbindelse:
- Opret godkendelsesudbyder i Salesforce (Opsætning → Godkendelsesudbydere).
- Opret eksterne legitimationsoplysninger og link til godkendelsesudbyder (Opsætning → Navngivne legitimationsoplysninger → Eksterne legitimationsoplysninger).
- Opret navngivne legitimationsoplysninger, og link til eksterne legitimationsoplysninger (Opsætning → Navngivne legitimationsoplysninger).
- Tildel navngivne legitimationsoplysninger adgang til relevante Salesforce-profiler.
SyncOut-konfiguration:
- Opret Snowflake-forbindelse (Opsætning → Analytics Studio → Datamanager → Forbindelser → Snowflake-forbindelser).
- Opret SyncOut-konfiguration: kildeobjekt, måltabel, synkroniseringstilstand, felttilknytninger, CDC, sporing med permanent sletning, tidsplan.
- Start med daglig synkronisering. Valider denne datakvalitet og -ydeevne, før du øger frekvensen.
SyncIn-konfiguration:
- Opret ekstern datakilde (Opsætning → Analytics Studio → Datamanager → Forbindelser → Snowflake-forbindelser).
- Opret SyncIn-konfiguration: kildevisning, målobjekt, Eksternt id-felt, felttilknytninger, tidsplan.
- Synkroniser fra Snowflake-visninger, ikke rå tabeller.
Validering:
- Gennemse Synkroniser jobovervågning efter første kørsel (Opsætning → Analytics Studio → Datamanager → Synkroniser jobovervågning).
- Forespørg på Snowflake-revisionsoversigten for at bekræfte, at synkroniseringsmetadata blev skrevet.
- Valider markering af permanent sletning ved at bekræfte, at kolonnen DEL_FLAG findes og er udfyldt.
- Sammenlign registreringsantal mellem kilde og mål.
- Konfigurer fejlmeddelelser via Chatter eller mail.
Brug dette mønster, når planlagt batchesynkronisering opfylder forsinkelseskravene, tosidet dataforløb er nødvendigt, og reduktion af teknisk afhængighed af integrationshandlinger er en prioritet.
Snowflake-arbejdseksemplet i denne vejledning illustrerer den fulde livscyklus: opsætning, konfiguration, kørselsforløb og validering af forbindelser. De samme principper gælder for enhver understøttet ekstern dataplatform.
Når forsinkelse på under 15 minutter, komplekse transformationer eller multi-organisationscenarier er i omfang, skal du evaluere platformsbegivenheder, streaming-API’er eller MuleSoft som supplerende eller alternative tilgange.
Yugandhar Bora er Software Engineering Architect hos Salesforce, der er specialiseret i dataarkitektur inden for platformen Data & Intelligence Applications. Han leder EARB-initiativer (Enterprise Architecture Review Board), der er fokuseret på dataadministration og forenede datamodeller, mens han bidrager til automatiserede platformsprovisioneringsløsninger.