Agenter forstår over mål, udleder parametre fra kontekst, og vælger handlinger dynamisk. Som resultat skal hver integration, som en agent rører ved, håndtere tvetydighed, understøtte sikker gentagelse og mislykkes på måder, som agenten kan gendanne automatisk.
Agentiske systemer gør adskillige antagelser ugyldige, som traditionelt integrationsdesign tager for givet. Input vil ikke altid være korrekt udformet. En enkelt brugerhandling kan udløse en kæde af agenter på tværs af organisationsgrænser, hvor hver af dem har brug for uddelegeret autoritet til at reagere.
Dette dokument tilknytter de arkitektoniske vagter, der følger fra denne virkelighed: de nye designprincipper, agentmønstre, og hvordan Salesforce Platform leverer dem.
Hvert mønster i dette dokument følger den samme struktur:
Navn: Den mønsteridentifikator, der angiver den type integration, der er indeholdt i mønsteret.
Kontekst: Det generelle integrationsscenarie, som mønsteret håndterer. Kontekst giver oplysninger om, hvad brugere forsøger at opnå, og hvordan applikationen optræder i forhold til deres behov.
Problem: Den udfordring (udtrykt som et spørgsmål), som mønsteret er designet til at løse. Når du gennemser mønstrene, kan du læse dette afsnit for hurtigt at forstå, om mønsteret gælder for dit integrationsscenarie.
Kræfter: De begrænsninger og omstændigheder, der kan gøre problemet vanskeligt at løse.
Salesforce-mønsterapplikation: Den anbefalede måde at anvende mønsteret på scenariet.
Skitser: Et UML-sekvensdiagram (United Modeling Language), der viser, hvordan mønsterapplikationen håndterer scenariet.
Resultater: Hvordan mønsteret løser de kræfter, der er knyttet til scenariet. Dette afsnit indeholder også nye udfordringer, der kan opstå som et resultat af anvendelse af mønsteret.
Design Overvejelser: Platformagnostisk vejledning til at anvende løsningen korrekt efterfulgt af Salesforce-specifikke implementeringsbemærkninger. Disse overvejelser dækker handlingsdesignprincipper og platformsspecifikke konfigurationskrav.
Fejlhåndtering og gendannelse: Vejledning til administration af fejl under mønsterapplikation. Denne parameter dækker fire områder:
- Hvordan handlinger kommunikerer fejl til agenten gennem strukturerede, handlingsrettede fejlsvar, der giver tilstrækkelig kontekst til downstream-beslutningstagning
- Hvordan agenten bestemmer, om han eller hun skal prøve igen, selvkorriger eller stoppe kørsel
- Hvordan kompensationshandlinger håndterer delvise resultater og uoverensstemmende tilstand på tværs af platforme
- Krav til idempotens for tilbagetrukne skrivehandlinger
Sikkerhedsovervejelser: Sikkerhedskrav til at anvende mønsteret sikkert. Disse overvejelser omfatter administration af legitimationsoplysninger, omfang med mindst rettigheder for integrationsbrugere og tilsluttede apps, revisionsregistrering af agent-invocated handlinger og krav til inputvalidering for parametre, der stammer fra brugerangivet eller LLM-overført indhold, blandt andre.
Eksempel: Et end-to-end-scenarie, der beskriver, hvordan designmønsteret bruges i et Salesforce-scenarie i den virkelige verden. Eksemplet forklarer målene, og hvordan du anvender mønsteret for at nå disse mål.
Følgende tabel viser de implementeringsmønstre, der er dækket.
Liste over mønstre
| Mønster | Hvad den gør |
|---|---|
| Sekvenshandlingskald | En agent kalder en række handlinger, hvor hvert trin afhænger af det bekræftede resultat af det forrige. Agenten vedligeholder konteksten på tværs af kæden som id’er, statuskoder, mellemliggende data og bruger den til at beslutte, om det næste trin kan fortsætte. |
| Parallel handlingskald | Når et sæt handlinger er uafhængige af hinanden, kalder agenten dem samtidigt snarere end i rækkefølge. Den samlede arbejdsflowtid er bundet af det langsomste opkald snarere end summen af alle opkald. |
| Asynkron handlingskald | En agent udsender en handling til et downstream-system via en platformsbegivenhed, en meddelelseskø eller et baggrundsjob uden at vente på resultatet. Agentens forpligtelse slutter ved bekræftet kald. Downstream-systemet tager ejerskab af kørsel uafhængigt af agentens session. |
| On-Demand Agent-kald | En ekstern applikation eller en AI-orkestrator kalder en agent programmeringsmæssigt, leverer kontekst og venter på et struktureret svar. Agenten fungerer som en intelligent backendtjeneste, som opkalderen initierer, agenten begrunder og handler, og resultatet forbruges af opkalderen. |
| Autonom begivenhedsstyret agentkørsel | En datatilstand som efterladelse af indkøbsvogn, betalingsfejl, anvendelsesdrop udløser automatisk en agent uden nogen person, der starter interaktionen. Der er ingen opkalder, der venter på et svar. Agenten modtager begivenhedsdata som grundlæggende kontekst og kører et svararbejdsflow fuldstændigt på egen hånd. |
| Knowledge Grounding fra Enterprise Content | Før du genererer et svar, henter agenten relevante dokumenter fra et virksomheds Knowledge og indsætter dem i dets kontekstvindue. LLM leverer argumentationen. Hentlaget leverer fakta. |
| Bekræftet kundeindsprøjtning | Bekræftede strukturerede attributter fra en forenet kundeprofil udfyldes på forhånd som handlingsinput, før agenten kalder en handling. Agenten modtager fakta som segment, niveau, afgangsrisiko og livstidsværdi i stedet for at udlede dem. |
| Tværsystemsværktøjsintegration | En agent opretter forbindelse til eksterne systemer uden for Salesforce-platformen gennem en ensartet værktøjsgrænseflade baseret på MCP-standarden (Model Context Protocol). Hvert eksternt system viser dets funktioner som beskrevne, kaldbare værktøjer. Agenten finder og kalder dem uden at skulle kende hvert systems oprindelige API eller skema. |
| Forretningsfunktioner som værktøjer, der kan kaldes | Virksomhedsforretningsfunktioner som forretningsenheder, processer og indsigter vises som MCP-værktøjer, som enhver ekstern agent på enhver struktur kan finde og kalde. |
| Tværgående delegation | En opkaldsagent nedbryder en kompleks anmodning og uddelegerer domænespecifikke underopgaver til specialiserede ligestillede agenter på forskellige platforme eller leverandørsystemer ved brug af A2A-protokollen (Agent-to-Agent). Den kaldende agent administrerer opgavens livscyklus og aggregerer resultater fra fjernagenterne. |
| Agenter som Callable Services | En intern Agentforce udgiver sine domænefunktioner som et administreret, opdageligt A2A-slutpunkt, så eksterne orkestratorer eller ligestillede agenter kan uddelegere opgaver til den. Agenten administrerer den indgående opgavelivscyklus og returnerer strukturerede resultater til fjernopkalderen. |
Mønstrene i dette dokument er klassificeret i tre kategorier. Denne kategorisering hjælper arkitekter med hurtigt at identificere, hvilke mønstre der er relevante for den integrationsudfordring, de løser, uanset om de designer, hvad en agent kalder, hvad der udløser en agent, eller hvordan en agent er baseret på Knowledge, før den handler. I stedet for at læse hvert mønster, kan du navigere direkte til den kategori, der matcher dit designproblem.
Handlingsanmodning:
Disse mønstre dækker, hvordan en agent ringer til eksterne systemer for at hente data eller udføre handlinger som en del af dens overvejelsescyklus. Dette er udgående mønstre, hvor agenten er initiatoren. De håndterer sekvensering (når trin afhænger af hinanden), parallelisme (når de ikke gør), idempotens og delvis fejlhåndtering. Brug disse mønstre, når du designer de værktøjer, en agent kalder for at få arbejdet udført.
Agentkald:
Disse mønstre håndterer, hvordan eksterne systemer eller begivenheder får en agent til at reagere. Dette er indgående mønstre, hvor eksterne systemer udløser disse agenter. Udløseren kan være en applikation rettet mod mennesker, der foretager et programmeringsmæssigt opkald og venter på et svar, eller en autonom datatilstand, der udløser agenten. Brug disse mønstre, når du designer, hvordan og hvornår en agent udløses.
Grundlægning med Enterprise Data:
Mønstrene i denne kategori dækker, hvordan agenterne er baseret på nøjagtig, aktuel, organisationsspecifik Knowledge, før de begrunder eller handler.
Valg af den rigtige strategi er ikke trivielt. Hvert mønster målretter mod et specifikt problem: systemfunktioner, datamængde, fejlhåndtering og transaktionalitet.
Valgmatrikstabellerne viser mønstrene og deres nøgleaspekter for at hjælpe dig med at bestemme, hvilket mønster der bedst passer til dine integrationskrav. Mønstrene kategoriseres ved brug af disse dimensioner.
| Aspekt | Beskrivelse |
|---|---|
| Type | Angiver integrationskategorien: Handlingsfremkald, Agentfremkald eller grundlægning med Enterprise Data Handlingsfremkald: Disse udgående integrationer strækker sig fra enkle ettrinsværktøjskald til komplekse sekvenser med flere trin og parallelle fanouts og kræver omhyggelig overvejelse af bestillingsbegrænsninger, idempotens og delvis fejlhåndtering på tværs af heterogene backends. Agentkald: Agentkald er de måder, eksterne systemer eller begivenheder får en agent til at reagere på. Disse indgående integrationer strækker sig fra synkrone programmeringsmæssige opkald, der foretages af applikationer, der er rettet mod mennesker, og som venter på et struktureret svar, til fuldt autonome begivenhedsstyrede udførelser, hvor en datatilstand udløser agenten uden nogen menneskelig initiering eller vente på interaktionen. Grundlægning med Enterprise Data: Grundlæggende integrationer er måder, hvorpå en agent får nøjagtig, aktuel, organisationsspecifik Knowledge, før vedkommende begrunder eller handler. Disse integrationer strækker sig fra hentning af ustrukturerede dokumenter fra virksomhedsindholdsbutikker til indsættelse af bekræftede strukturerede attributter fra forenede kundeprofiler, hvilket sikrer, at agenten arbejder på fakta i stedet for hallucineret konklusion. |
| Timing (Tid) | Angiver integrationstypografien baseret på timing: Synkron eller Asynkron Synkron kontra Asynkron i dette dokument refererer til, hvordan agenten selv udløses, eller hvordan den kalder handlingerne. Det dækker ikke, hvad der sker internt. Men generelt venter en bruger, mens agenten kalder handlinger og behandler resultater. Agenten håndterer ikke den næste brugermeddelelse, før den har afsluttet den aktuelle drejning. Synkron: Blokering og anmodninger i realtid er anmodnings-/svarhandlinger. Resultatet returneres straks til opkalderen via denne handling. Asynkron: Ikke-blokerende, købaserede eller meddelelsesbaserede anmodninger kaldes af en envejshandling, der er næsten realtid. Resultaterne og eventuelle fejl returneres ved at kalde andre envejshandlinger. Opkalderen foretager derfor anmodningen og fortsætter uden at vente på et svar. |
Denne tabel viser mønstrene og deres nøgleaspekter for at hjælpe dig med at bestemme, hvilket mønster der bedst passer til dine krav, når din integration er fra Salesforce til et andet system.
| Type | Timing (Tid) | Nøglemønster, du bør overveje |
|---|---|---|
| Handlingskald | Synkron | Sekvenshandlingskald Parallel handlingskald Tværsystemsværktøjsintegration Tværgående delegation |
| Handlingskald | Asynkron | Asynkron handlingskald |
| Agentkald | Synkron | On-Demand Agent-kald Agenter som Callable Services |
| Agentkald | Asynkron | Autonom begivenhedsstyret agentkørsel |
| Fastgørelse med virksomhedsdata | Synkron | Knowledge Grounding fra Enterprise Content Bekræftet kundeindsprøjtning |
Hvert afsnit af mønstre beskriver, hvordan du opbygger dem. Hvert mønster er en gentaget løsning på et specifikt integrationsproblem i agentarkitekturer. Den dækker, hvornår mønsteret skal bruges, hvilke kræfter der formidler beslutningen, og hvordan Salesforce-platformen leverer den.
Kontekst
Mange forretningsarbejdsflows er iboende sekventielle – hvert trin kræver et bekræftet resultat fra det forrige, før det kan fortsætte. En refusion kan f.eks. ikke startes, før berettigelsen er bekræftet, en faktureringskonto kan ikke oprettes, før bestillingsregistreringen findes, og en overensstemmelseskontrol kan ikke logføres, før kontrollen er gennemført.
I traditionel automatisering kodes disse afhængigheder som hardcodede forløbslogik. I et agentsystem evaluerer agenten resultatet af hver handling og bestemmer, om forudsætningerne for det næste trin er opfyldt.
Dette mønster beskriver den grundlæggende udgående integrationsmodel. Her fungerer en enkelt agent inden for et domæne og kalder en sekvens, hvor hver handlings output fører til kald af den næste handling i kæden. Orkestreringsagenten bevarer transaktionsmæssig kontekst på tværs af kæden og akkumulerer id’er, statuskoder og data, der returneres efter hvert trin. Den bruger denne kontekst til at styre efterfølgende beslutninger.
Dette mønster er den agentiske modstykke til fjernproceskald – anmodning og svar fra guiden for integrationsmønstre, der beskriver et enkelt synkront udkald. Det agentiske mønster udvider mønsteret til en agentstyret kæde af afhængige opkald inden for en enkelt overvejelsescyklus.
Problem
Når en agent kører et arbejdsflow med flere trin, der strækker sig over værtssystemet og et eller flere fjernsystemer, skal der håndteres fire udfordringer:
- Sequencing - Handlinger skal kaldes i den korrekte rækkefølge, med hvert trin indstillet på en vellykket gennemførelse af det foregående.
- Dataudbredelse - Svardata fra hvert trin skal overføres som input til det næste.
- Fejlsisolering - Fejl på noget punkt i kæden må ikke skabe delvis eller inkonsekvent tilstand på tværs af systemer.
- Fuldførelsesbekræftelse - Agenten skal bekræfte, at alle trin er fuldført korrekt, før der rapporteres et resultat.
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål:
-
Afhænger hver handling i kæden af data, der returneres af den forrige handling, eller er afhængighederne kun på succes- eller fejlstatus?
Dataafhængigheder kræver, at agenten bærer id’er og attributter på tværs af trin.
-
Er alle fjernslutpunkter i stand til at svare i agentens overvejelsescyklustimeout?
Et langsomt eksternt system på ethvert trin i kæden blokerer hele sekvensen.
-
Kræver kæden fuldstændig end-to-end-succes, eller er delvis fuldførelse acceptabel?
-
Hvis der kræves fuld end-to-end-succes, skal du definere en kompensationsstrategi for trin, der skal rulles tilbage, når der forekommer en downstream-fejl.
-
Kan nogen af skrivehandlingerne i kæden forsøges igen sikkert?
Alle skrivehandlinger skal være idempotente. Agentens grundlæggende løkke kan kalde den samme handling mere end en gang på grund af LLM-forsøg eller tvetydige bekræftelser.
-
Kaldes kæden af en brugerinteraktion (samtale, lav samtidighed) eller af en automatisk udløser (potentielt høj samtidighed)?
Dette bestemmer, om synkron blokering er acceptabel, eller om der kræves et asynkront mønster.
Salesforce-mønsterapplikation
| Løsning | Tilpas | Kommentarer |
|---|---|---|
| Apex | Bedst til eksterne udkald og kompleks logik | Et trin kræver et HTTP-udkald til et fjernsystem, tilpasset datatransformation eller fejlhåndteringslogik, der overskrider forløbets deklarative funktioner. Apex viser den fulde platform til integration, mens de forbliver kaldbare af agenten via @InvocableMethod-anmærkningen. |
| Forløbshandlinger (automatisk startet) | Bedst til forretningsregeltrin og lette CRM-handlinger | Et trin anvender deklarativ forretningslogik, forespørger på eller opdaterer CRM-registreringer eller orkestrerer en proces, der ikke kræver tilpasset kode. Automatisk startede forløb kan kaldes som standard fra Agentforce og returnerer typede outputvariabler, som agenten bruger til at bestemme det næste trin. |
| Eksterne tjenester (OpenAPI-import) | Bedst til skrivning af ekstern API-integration, der kan findes | Et eksternt system viser en OpenAPI-specifikation. Eksterne tjenester genererer stærke Apex, der kan kaldes direkte som agenthandlinger, hvilket eliminerer manuel skematilknytning og gør den eksterne API’s handlinger synlige for agenten som navngivne funktioner. Hver handling i den importerede specifikation bliver en navngivet handling, der kan kaldes. Agenten vælger handlinger baseret på deres genererede semantiske betegnelser. Registrer genererede handlinger i Agentforce, så agenten kan finde dem på tidspunktet for begrundelse. Notat: Hvis den eksternt hostede tjeneste er RESTful, men OpenAPI-specifikationen ikke er tilgængelig eller mulig, skal du bruge navngivne legitimationsoplysninger i Apex eller forløb til at foretage HTTP-udkald direkte. Apex er nødvendig for at parse resultaterne. |
| MuleSoft-tilsluttede handlinger | Bedst til kompleks middleware-fan-out eller forældet systemintegration | Bruges, når fjernsystemet kræver protokolloversættelse, datatransformation eller orkestrering på tværs af flere backendsystemer, før der returneres et svar. Agenten foretager et enkelt udkald til MuleSoft, og MuleSoft håndterer downstream-kompleksiteten og returnerer et samlet svar. |
Skitser
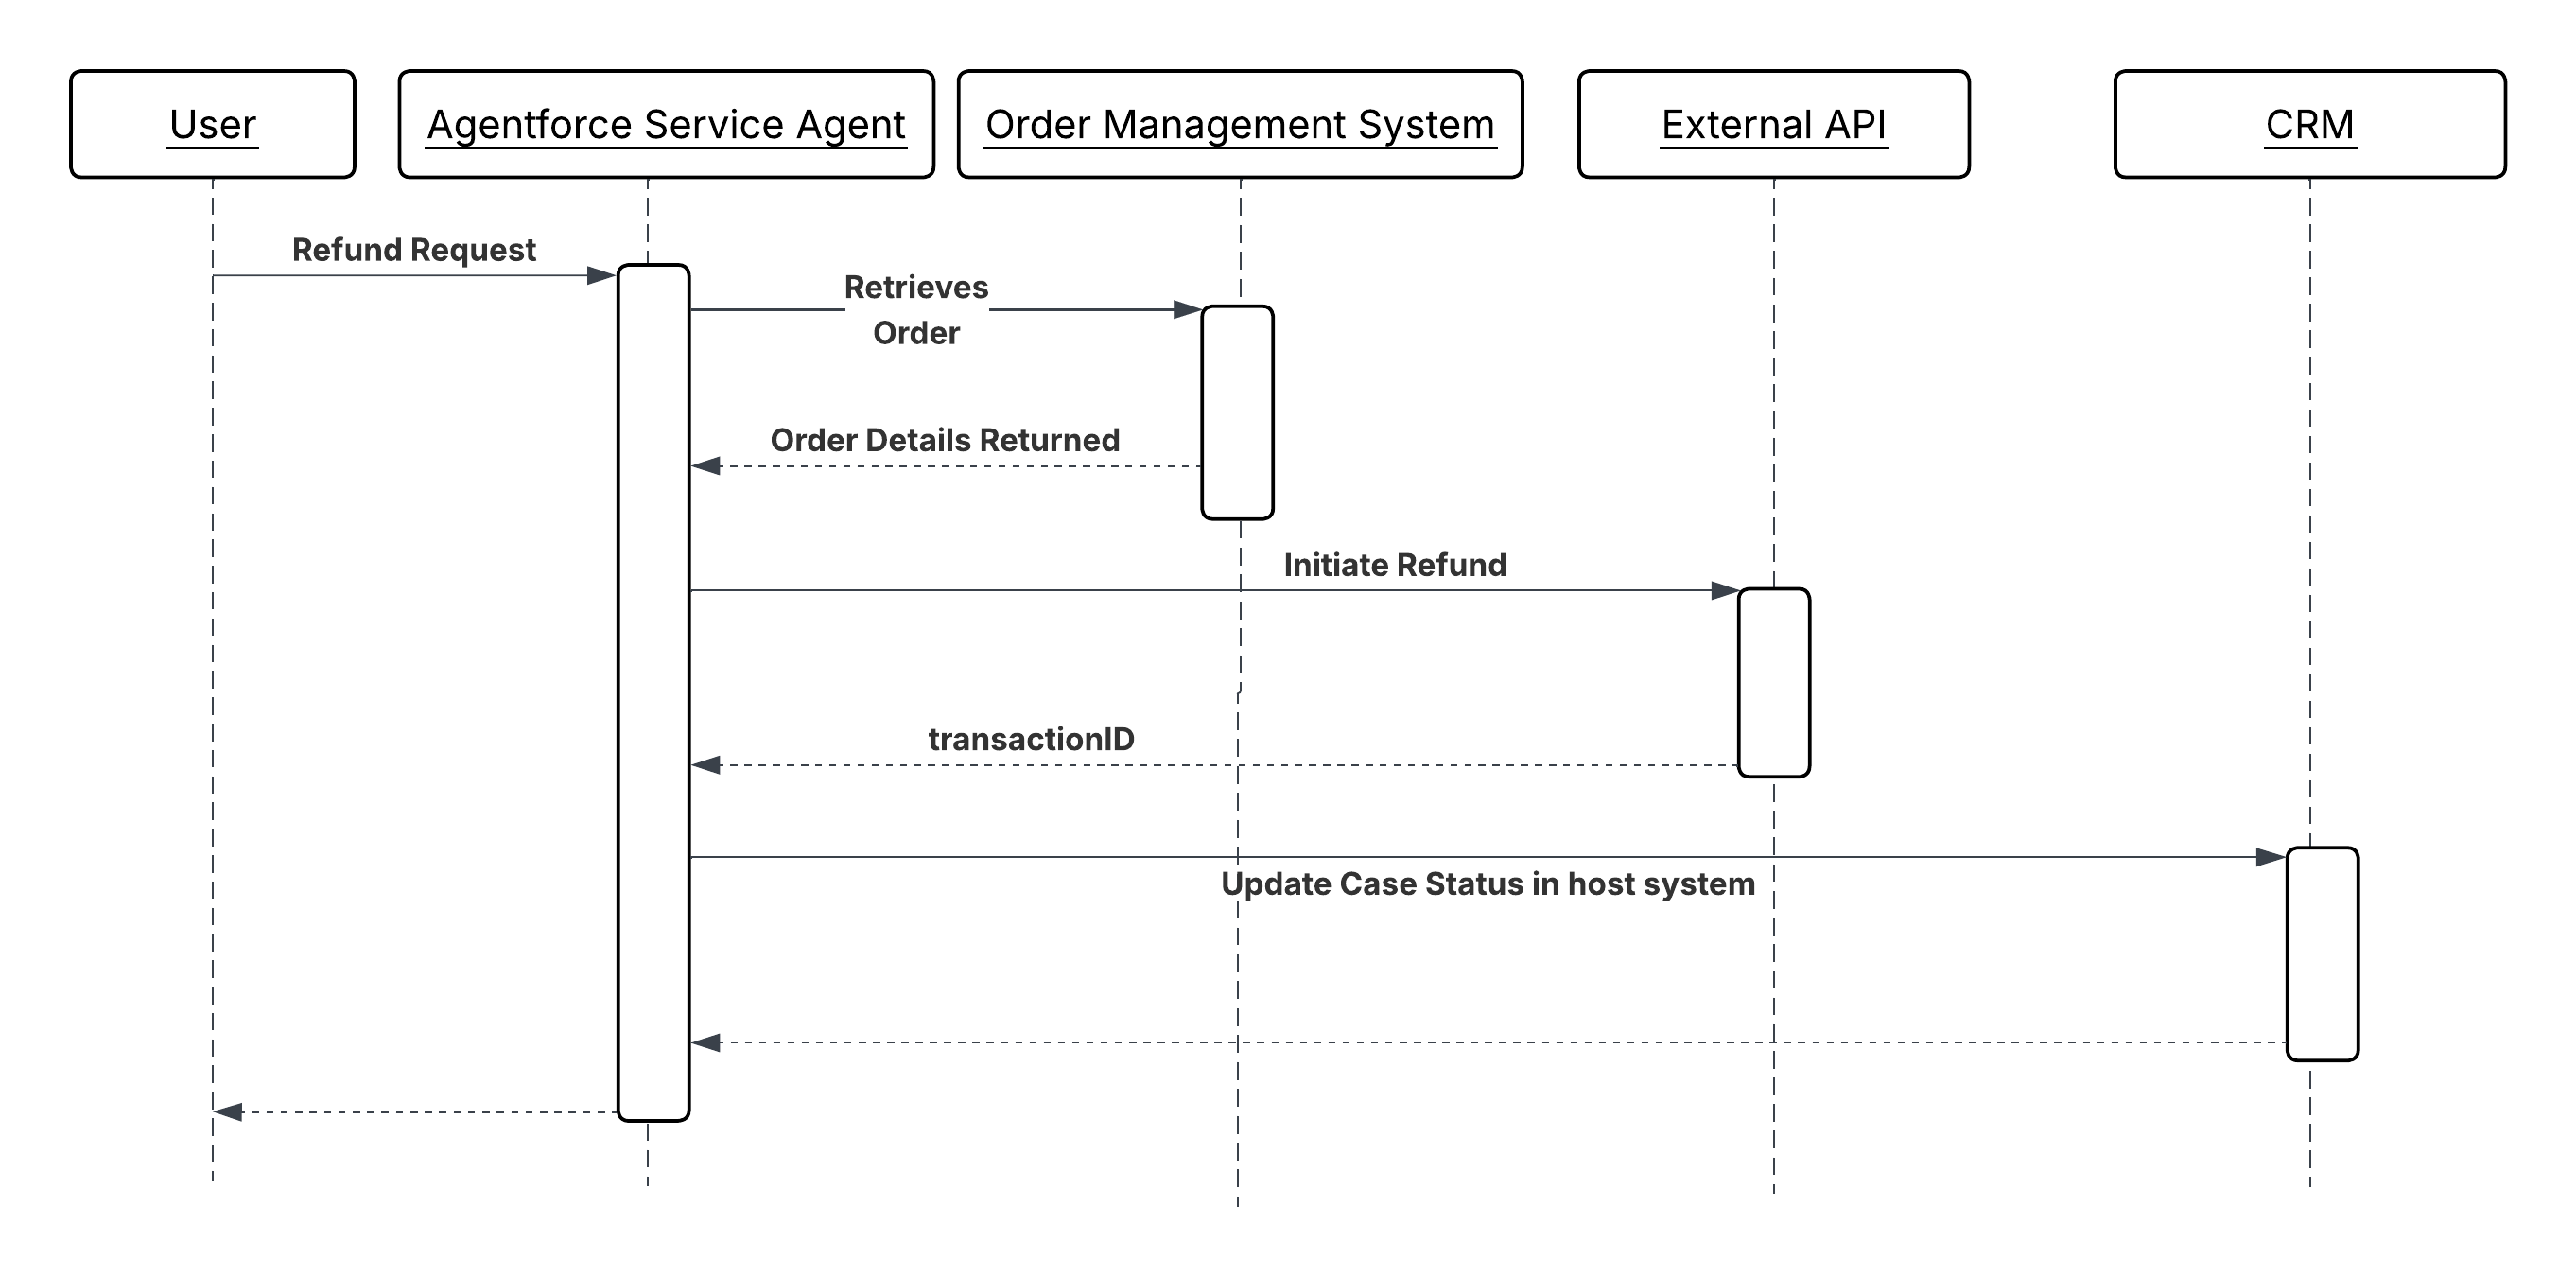
Sekvensdiagram for sekventiel handlingskald
Resultater
Agenten kører et tværgående systemarbejdsflow som en sammenhængende, superviseret sekvens og ikke et fire-and-glem-script. Hvert trins resultat evalueres, før det næste trin kaldes, så agenten registrerer fejl på det tidligst mulige tidspunkt i stedet for at opdage delvis fuldførelse efter fakta.
Værtssystemet (Salesforce CRM) opdateres kun, når fjernhandlingen har bekræftet statussen (succes eller fejl). Identifikatorer og tilstande, der returneres af eksterne systemer, som faktureringskontonumre, transaktions-id’er, bekræftelseskoder udbredes gennem kæden og bevares, hvilket skaber en komplet, sporbar registrering af arbejdsflowresultatet.
Agenten er ansvarlig for begrundelse over resultater og sekvenseringsbeslutninger. Hver handling er kun ansvarlig for sin egen handling og for returnering af et struktureret resultat. Ingen lag koder den anden persons logik.
Design overvejelser
Platform-agnostisk vejledning
- Sørg for, at hver handling i kæden indeholder en semantisk beskrivelse skrevet på hensigtsbaseret sprog og ikke som en teknisk metodesignatur. Agenten vælger handlinger baseret på disse beskrivelser. En beskrivelse, der lyder “kalder fakturerings-API” er mindre nyttig end en beskrivelse, der lyder “opretter en faktureringskonto i faktureringssystemet og returnerer det nye konto-id”.
- Gør alle skrivehandlinger i kæden idempotent. Agentens grundlæggende løkke kan prøve en handling igen, hvis den modtager et tvetydigt svar. Handlingen skal producere det samme resultat ved gentaget kald.
- Valider alle LLM-udledte inputparametre defensivt ved handlingsgrænsen. Antag aldrig, at parametre, der overføres af agenten, er korrekt udformet, inden for området eller af den forventede type.
- Design hver handling til et enkelt ansvar. En handling, der opretter en faktureringskonto og sender en bekræftelsesmail i det samme opkald, er sværere at prøve igen, sværere at teste og sværere for agenten at begrunde end to diskrete handlinger.
Implementeringsbemærkninger til Salesforce
- For Apex-handlinger skal du annotere med @InvocableMethod(label=’…’ description=’…’). “Beskrivelsen” læses af agenten for at bestemme, hvornår handlingen skal kaldes. Erklær alle input- og outputvariabler med @InvocableVariable ved brug af beskrivende “betegnelse”- og “beskrivelse”-felter. Returner strukturerede resultatobjekter med eksplicitte succes-/fejlsindikatorer og fejlmeddelelser, der kan læses af mennesker.
- For forløbshandlinger skal du kun bruge automatisk startede forløb. Skærmforløb understøttes ikke i autonome agentkontekster. Bevar hvert forløb atomisk, en handling, et ansvar. Konfigurer fejlstier på hvert eksternt udkaldselement for at fange integrationsfejl og returnere fejlmeddelelser, der kan handles på, til agenten i stedet for at lade ikke-registrerede undtagelser afslutte sessionen.
- For Eksterne tjenester skal du importere målsystemets OpenAPI-specifikation og registrere de genererede handlinger i Agentforce-emnet. Ombryd de genererede bindestreger i navngivne legitimationsoplysninger for at undgå hardcodede slutpunkter eller legitimationsoplysninger i handlingsdefinitionen.
- For alle eksterne udkald skal du angive eksplicitte udkaldstimeouts. Et udkald, der afventer uden en timeout, blokerer agentens overvejelsescyklus, indtil sessionsgrænsen er nået. Returner en god fejl med en beskrivende fejlmeddelelse, når timeouten overskrides. Alle eksterne udkald har en konfigurerbar timeout på op til 120 sekunder. De er også underlagt Apex synkrone transaktionsstyringsbegrænsninger, så sørg for at reducere risikoen for at oprette flere end 50 transaktioner, der kører i mere end fem sekunder hver.
Fejlhåndtering og gendannelse
- Agenten fører hvert trin til den eksplicitte succes af trinnets forgænger. Handlinger skal returnere et struktureret resultat, der inkluderer en tydelig succes- eller fejlindikator. Agenten kan ikke pålideligt udlede fejl fra et manglende eller nul-svar alene.
- Når en handling mislykkes, bruger agenten den fejlmeddelelse, der returneres af handlingen, til at bestemme dens næste bevægelse: bed brugeren om at få rettet input, forsøg på et selvhjælpningsforsøg med justerede parametre, eller stop kæden og logfør fejlen til human gennemgang. Derfor skal fejlmeddelelser være specifikke og kan handles på: “Ugyldigt datoområde: endDate kan ikke komme før startDate” er anvendeligt. 400-statuskode alene er ikke.
- For kæder, hvor delvis fuldførelse opretter inkonsekvent tilstand (f.eks. faktureringskontoen blev oprettet, men CRM-registreringen blev ikke opdateret), kalder agenten en kompensationshandling for at rulle tilbage eller markere den delvise tilstand, før fejlen vises. Design kompensationsstier som navngivne handlinger sammen med fremadstien.
- Hvis en skrivehandling potentielt lykkedes, men returnerede et tvetydigt svar (netværkstimeout, ingen bekræftelse), skal forsøget bruge den samme idempotensnøgle eller det eksterne reference-id som det oprindelige kald. Udgiv aldrig et ikke-markeret forsøg på et ikke-idempotent-skriv.
Sikkerhedsovervejelser
- Ombryd alle eksterne udkald i navngivne legitimationsoplysninger. Aldrig hardcode-slutpunkter eller legitimationsoplysninger i Apex eller forløbskonfigurationer. Disse skal administreres gennem platformens sikre legitimationsoplysningslager og roteres uden kodeændringer.
- Anvend principperne for mindste rettighed på integrationsbrugeren eller den tilsluttede app, der bruges af hver handling. En handling, der kun læser bestillingsdata, bør ikke indeholde skrivetilladelser på faktureringssystemet. Opret omfangslegitimationsoplysninger til de mindste handlinger, som handlingen kræver.
- Registrer kald af hver handling i kæden med dens sessions-id, inputparametre (saneret af følsomme værdier) og resultat. Hvis resultatet er omtvistet, er dette revisionsspor den primære mekanisme til at rekonstruere, hvorfor agenten afviklede en given række handlinger.
- Saniter alle inputparametre, der stammer fra brugerangivet tekst, før du overfører dem til eksterne systemer. Brugerinput, der overføres gennem agenten til et eksternt API-udkald, er en potentiel injektionsvektor. Valider type, format og område ved handlingsgrænsen, før udkaldet foretages.
Eksempel
En kundeservicerepræsentant, der håndterer en refusionsanmodning, udfører en sekventiel kæde på fire trin:
GetOrderDetails(Apex Action) henter bestillingsregistreringen fra bestillingsstyringssystemet ved brug af det bestillings-id, der er angivet af brugeren. Den returnerer bestillingsstatus, linjevarer, købsdato og betalingsmetode. Agenten evaluerer, om bestillingen er i en tilstand, der kan refunderes, før den fortsætter.ValidateRefundEligibility(Autostarted Flow) anvender forretningsreglerne for refusionsberettigelse, herunder returvindue, produktkategoribegrænsninger og tidligere refusionshistorik. Den returnerer en “berettiget” boolesk og, hvis den ikke er berettiget, en almindelig sproglig årsag til, at agenten kan blive vist for brugeren.InitiateRefund(Apex Action) kalder den eksterne betalingsgateway-API med bestillings-id’et og refusionsbeløbet. Returnerer et “refundTransactionId” ved gennemførelse. Denne handling er idempotent. Hvis der kaldes en anden gang med det samme bestillings-id, returnerer det det eksisterende transaktions-id i stedet for at oprette en dubletrefusion.UpdateCaseStatus(Autostarted Flow) opdaterer CRM-sagsregistreringen med refusionstransaktions-id’et, indstiller sagsstatussen til “Løst refusion udstedt” og opretter en opfølgningsopgave for kontoejeren. Dette trin udføres kun, når “InitiateRefund” har returneret et bekræftet transaktions-id.
Hvis InitiateRefund udløber eller returnerer en fejl, stopper agenten kæden, kalder ikke UpdateCaseStatus og viser en meddelelse, der kan handles på, til brugeren. Sagen forbliver åben og uløst, hvilket bevarer nøjagtig tilstand i CRM.
Kontekst
Sekventielle handlingskæder er effektive, når kørselstrin er afhængige af hinanden. Et trin åbner døren for det næste. Men mange arbejdsflows indeholder et sæt trin, der ikke har nogen afhængigheder. Trin, der f.eks. inkluderer hentning af produktlager, hentning af kundeberettigelser og kontrol af en forsendelsesestimat kan alle ske samtidigt, da ingen trins input kræver outputtet af et andet. Kørsel af disse trin i rækkefølge sparer tid i forhold til antallet af trin.
I et parallelt kaldmønster identificerer agenten, at et sæt handlinger er uafhængige og kalder dem samtidigt snarere end i rækkefølge. Den generelle arbejdsflowtid er bundet af den langsomste individuelle handling snarere end summen af alle handlingstider. Når alle resultater returneres, aggregerer agenten dem i et enkelt sammenhængende svar eller bruger dem sammen som input til den næste fase af argumentation.
Den vigtigste arkitektoniske udfordring er ikke selve den parallelle kald. Det administrerer fan ud inden for begrænsninger for platformssamtidighed og sikrer, at aggregeringstrinnet håndterer delvise fejl uden at kassere de resultater, der lykkedes.
Problem
Hvordan orkestrerer en agent effektivt den samtidige kørsel af flere, uafhængige funktioner og aggregerer de individuelle resultater i et enkelt, sammenhængende svar for brugeren eller efterfølgende trin?
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål:
- Hvad er overvejelserne for handlinger vedrørende trådssikkerhed og deling af tilstanden kan ændres?
- Hvordan vil løsningen administrere og undgå at nå Salesforce-styringsbegrænsninger for parallelle Apex i en enkelt transaktion?
- Er der behov for at bruge asynkrone mønstre (f.eks. Apex eller platformsbegivenheder) for at undgå styringsbegrænsninger?
- Kræves der synkron aggregering af resultaterne, før agenten kan fortsætte?
Salesforce-mønsterapplikation
| Løsning | Tilpas | Kommentarer |
|---|---|---|
| Mellemvaretilgang | Bedst til høje fanouts (>5 slutpunkter) og krydsplatformsaggregering | Du skal bruge et middleware-lag. Agenten foretager et udkald til middleware. Derefter aggregerer middleware-fanerne, der ud til 10 systemer parallelt, dataene og sender et enkelt svar tilbage til agenten. Dette foretrækkes, når agenten skal kalde mange heterogene eksterne systemer. Mellemprogrammet absorberer fan-out-kompleksitet og returnerer et enkelt aggregeret svar. |
| Apex, der kan sættes i kø | Bedst til intern Salesforce-parallelisme | Du skal udløse flere job, der kan sættes i kø. Mens Salesforce administrerer køen, kan disse afvikles samtidigt, hvis du har nok “intervaller” i din grænse for samtidighed. Bruges, når der er parallelle handlinger i Salesforce-organisationen, og der er samtidige intervaller tilgængelige. Dette er ikke passende, når der kræves øjeblikkeligt aggregeret svar. |
| Platformsbegivenheder | Bedst til glemt brand eller eventuel ensartethed | Resultater behøver ikke at blive aggregeret synkront. Hver begivenhed udløser en isoleret transaktion, der maksimerer gennemsnit, men kræver downstream afstemning. Brug denne mekanisme, når eventuel ensartethed er acceptabel, og gennemsnit er vigtigere end svarforsinkelse. |
Skitser
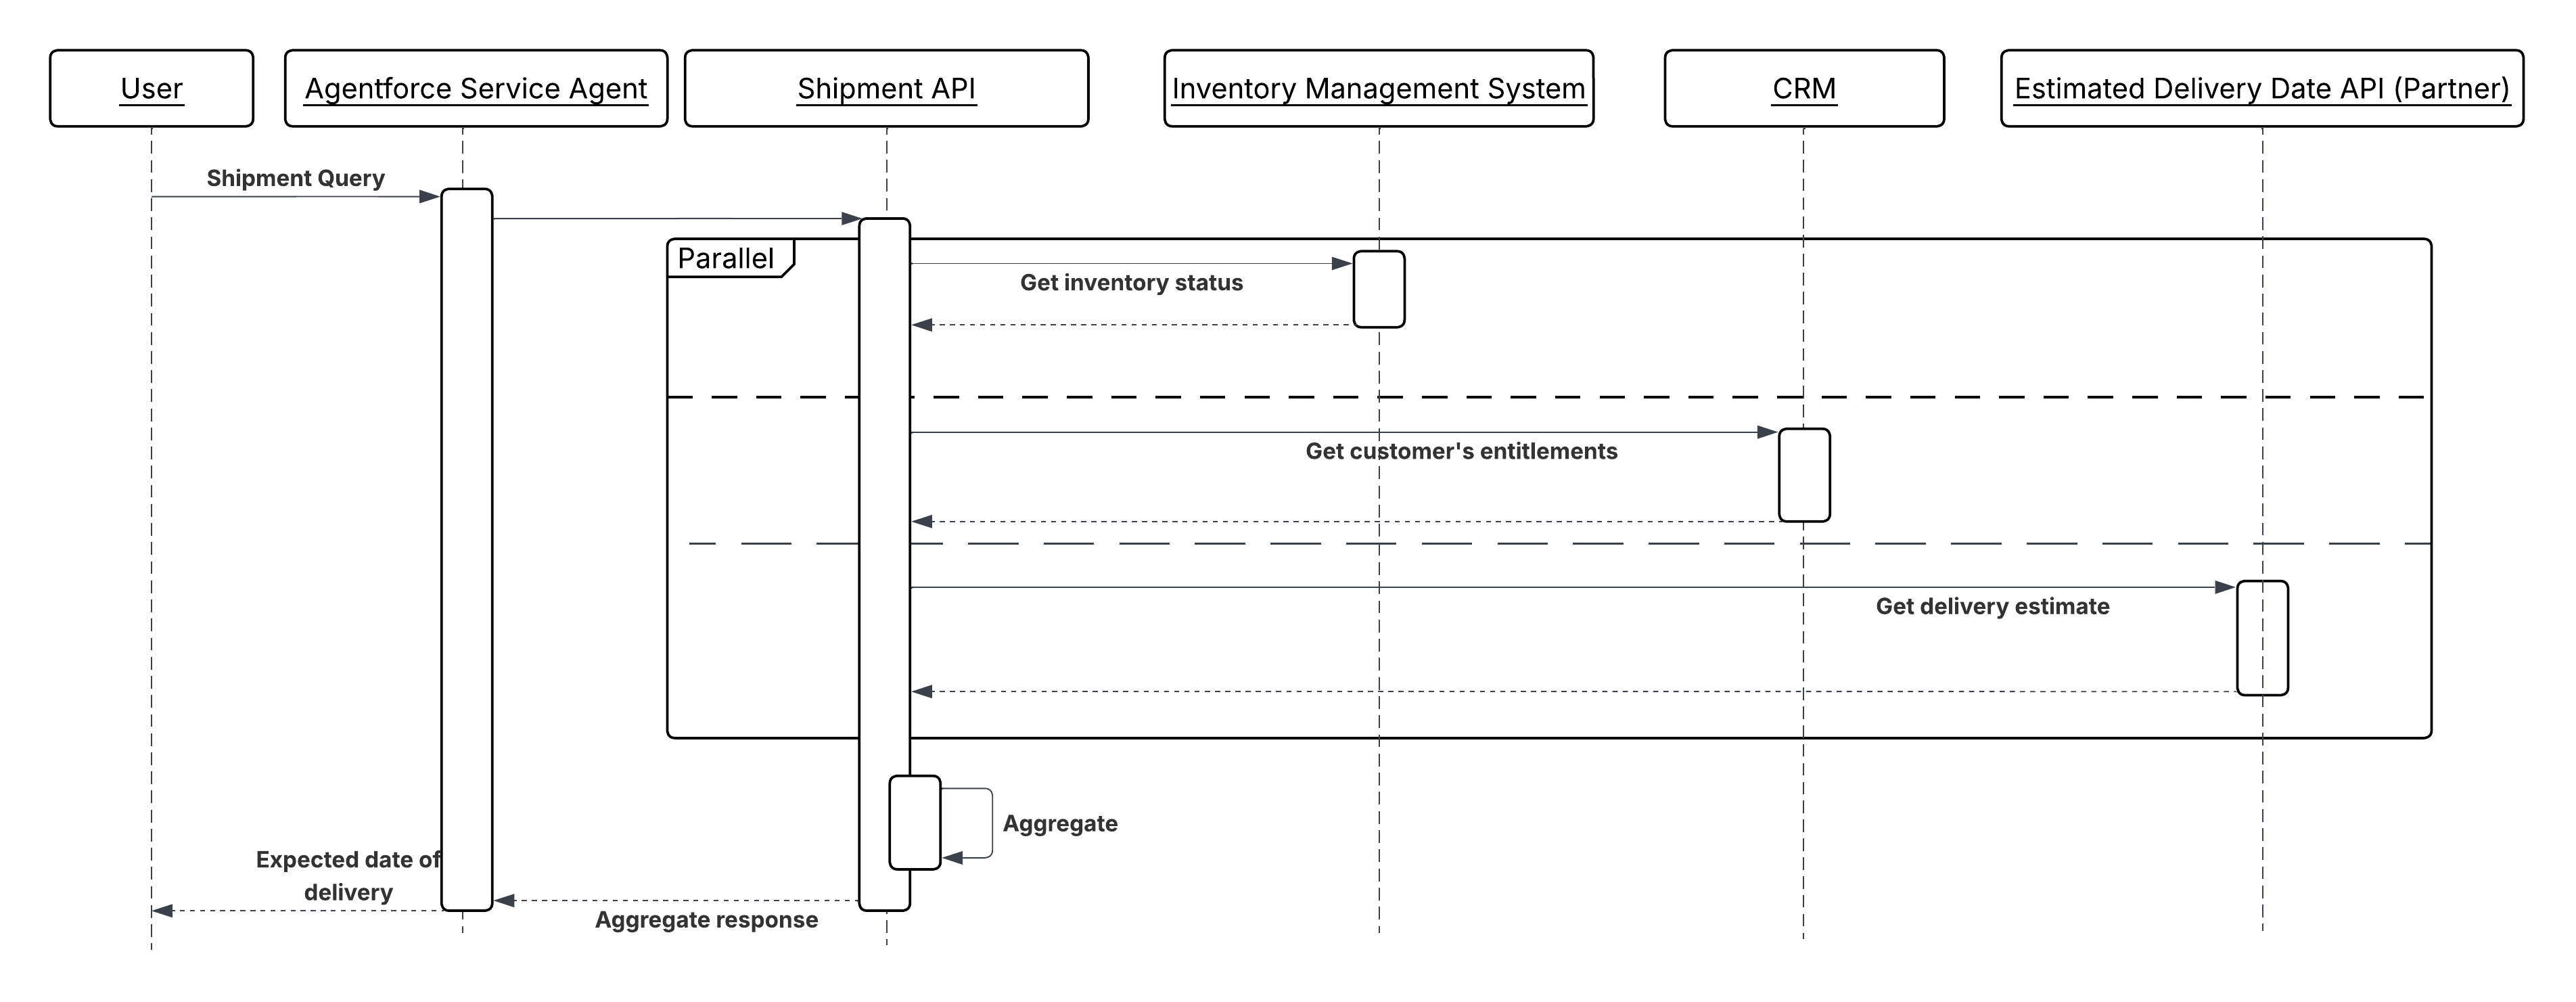
Sekvensdiagram for parallel handlingskald
Resultater
Når uafhængige handlinger afvikles parallelt, er end-to-end-arbejdsflowtiden bundet af den langsommeste individuelle handling snarere end summen af alle handlinger. For et arbejdsflow med tre uafhængige udkald på gennemsnitligt 300 ms hver, fuldføres parallel kørsel på ~300 ms. Sekventiel kørsel tager ~900 ms. På skala sammensættes denne forskel på tværs af hver agentsession, der kører samtidigt.
Design overvejelser
Platform-agnostisk vejledning
- Bekræft uafhængighed, før parallellering. Handlinger er kun sikre at køre parallelt, hvis ingen handling læser tilstanden skrevet af den anden, og ingen af handlingens fejl bør annullere den anden. Hvis der findes en afhængighed, selv en soft afhængighed, skal du bruge sekventiel kæde i stedet for.
- Design aggregeringstrinnet eksplicit. Definer på forhånd, hvordan et komplet resultatsæt ser ud, hvad et delvist resultatsæt betyder for downstream-regnskab, og om agenten skal vente på alle resultater eller fortsætte, når en tærskel (f.eks. fem ud af syv opkald i alt) er returneret.
- Alle parallelle skrivehandlinger skal være idempotent. Hver handling kører isoleret uden en delt transaktionsgrænse, så hvis du forsøger en enkelt forgrening igen, kan der ikke forekomme dubletbivirkninger.
Implementeringsbemærkninger til Salesforce
- For Apex, der kan sættes i kø: Indsend alle job inden for en enkelt transaktion for at maksimere sandsynligheden for samtidig kørsel. Vær opmærksom på, at tilgængelige samtidige intervaller deles på tværs af organisationen. Design med antagelsen om, at intervaller måske ikke altid er tilgængelige, og opbyg en tilbagerulning til sekventiel kørsel, når de ikke er.
- For platformsbegivenheder: Skriv hver handlings resultat til en dedikeret midlertidig registrering (nøglet af et delt korrelations-id) i stedet for at opdatere målregistreringen direkte. Et endelig aggregeringsforløb eller en Apex læser alle midlertidige registreringer, når det forventede antal er nået, og anvender derefter den konsoliderede opdatering atomisk.
- For mellemvarer: Angiv en eksplicit timeout på det enkelte udkald, der er længere end den forventede værste sagssvartid for den langsommeste backend, men stadig inden for Salesforce-udkaldstimeoutgrænsen. Mellemprogrammet returnerer delvise resultater med en tydelig angivelse af, hvilke backends der mislykkedes, snarere end at udløse hele svaret.
Fejlhåndtering og gendannelse
- Behandl delvis succes som et førsteklasses resultat. Hvis tre eller fire parallelle handlinger lykkes, bruger agenten de tre vellykkede resultater og håndterer fejlen ved eksplicit at vise den til brugeren, registrere den til at prøve igen eller kalde en kompenserende handling i stedet for at kassere alle resultater eller fortsætte, som om fejlen ikke forekom.
- For mønstre for Købegivenhed og Platformsbegivenhed skal du bruge et korrelations-id (genereret på tidspunktet for fan-ud) til at linke alle parallelle forgreninger tilbage til den oprindelige agentsession. Dette id kræves for at samle resultaterne igen og for at spore fejl tilbage til deres kilde i logfiler.
- Hvis en parallel forgrening mislykkes, og handlingen er sikker at prøve igen, skal du kun sætte den mislykkede forgrening i kø igen ved brug af det oprindelige korrelations-id og idempotency-nøglen. Kald ikke alle forgreninger igen.
- Definer en timeoutstærskel for aggregeringstrinnet. Hvis ikke alle resultater ankommer inden for tærsklen, skal du fortsætte med tilgængelige resultater og markere det ufuldstændige sæt i stedet for at vente uendeligt.
Sikkerhedsovervejelser
- Hver parallel kørselskontekst, uanset om det er et job, der kan sættes i kø, en platformsbegivenhedsudløser eller et middleware-udkald, skal anvende de samme adgangskontroller som et sekventielt udkald. Parallelitet lemper ikke dataadgangsregler. Hver forgrening skal fungere under samme mindste-rettighedslegitimationsoplysninger, som den ville, hvis den blev kaldt alene.
- For middleware-fanout cachelagrer og logfører middleware-laget ikke svardata fra individuelle backends ud over aggregeringsvinduet. Hvert backends svar kan indeholde følsomme data, der ikke bør forblive uden for omfanget af den øjeblikkelige handling.
- Sørg for, at de midlertidige registreringer, der bruges til platformsbegivenhedsaggregering, ikke er læsbare for agentens slutbruger. Disse registreringer kan indeholde mellemliggende, delvist dannede data, der endnu ikke er egnet til forbrug.
Eksempel
En serviceagent besvarer et komplekst fuldførelsesspørgsmål: “Kan du sende denne bestilling til mig inden fredag?” Svaret kræver data fra alle uafhængige systemer samtidigt, som forklaret nedenfor:
- Agenten identificerer tre uafhængige databehov: det aktuelle lagerniveau, kundens aktive berettigelser og udbyderens anslåede leveringsvindue for kundens placering.
- Tre handlinger kaldes parallelt:
GetInventoryStatus(fra det eksterne lagersystem via middleware),GetCustomerEntitlements(fra Salesforce CRM) ogGetDeliveryEstimate(fra udbyder-API via middleware). - Hver handling returneres uafhængigt. Agenten venter, indtil alle tre svar modtages (eller aggregeringstimeout er nået).
- Med alle tre tilgængelige resultater begrunder agenten over de kombinerede data, vurderer om lageret er tilstrækkeligt, kundens berettigelse dækker ekspresforsendelse, og udbyderen bekræfter, at fredaglevering er muligt for kundens postnummer.
- Agenten returnerer et enkelt, jordbaseret svar til brugeren, trukket fra tre systemer, i det tidspunkt, det tog den langsomste af de tre opkald at svare.
Kontekst
Nogle agentinitierede handlinger producerer ikke et resultat, som agenten har brug for for at fortsætte sin aktuelle argumenteringscyklus. Afsendelse af en advisering, udløsning af en downstream-batchproces, udgivelse af en begivenhed til en meddelelseskø eller indsendelse af et længe kørende job er alle handlinger, hvor agentens forpligtelse slutter ved udsendelse. Downstream-systemet tager ejerskab og fuldfører arbejdet uafhængigt.
I traditionel automatisering er disse udarbejdet som fire-og-glem-udkald eller platformsbegivenhedsudgivelser. I et agentsystem beslutter agenten under begrundelse, at handlingen ikke blokerer, udsender den, registrerer bekræftelse af udsendelse og fortsætter eller afslutter omgangen uden at vente på downstream-resultatet.
Dette mønster er den agentiske modstykke til Fjernproceskald – Fire og glem fra integrationsmønstre guide. Det agentmæssige mønster udvider det ved at gøre udsendelsesbeslutningen til en del af agentens argumentation og ved at sikre, at udsendelsen kan spores, selvom der ikke returneres noget svar til agenten.
Problem
Når en agent har brug for at starte en downstream-handling, der kører ud over agentens session eller grundlæggende cyklus, skal der håndteres tre udfordringer:
- Ikke-blokerende kald: Agenten skal starte handlingen og bekræfte leveringen uden at holde argumentationscyklussen åben og vente på et resultat.
- Forsendelsesbekræftelse: Agenten skal skelne mellem en vellykket udsendelse (meddelelsen blev accepteret) og et vellykket resultat (downstream-processen fuldført). Den kan kun bekræfte den tidligere.
- Sporbarhed: Da agenten ikke modtager nogen resultater, skal handlingen være observerbar gennem logfiler, begivenhedsregistreringer eller platformsovervågning uafhængigt af agentens session.
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål:
-
Skal agenten have resultatet af denne handling for at fuldføre sin aktuelle drejning? Hvis ja, er dette ikke det rigtige mønster. Brug i stedet for Sekventiel handlingskald.
-
Er downstream-systemet i stand til at modtage og pålideligt behandle den udsendte meddelelse eller begivenhed uden en synkron bekræftelse? Målsystemet skal være holdbart. Den må ikke miste meddelelsen, hvis den midlertidigt er utilgængelig.
-
Er handlingen idempotent, eller skal dubletudsendelse beskyttes? Forsøg på netværksniveau og forsøg med agentrådgivning kan medføre, at den samme udsendelse forsøges mere end en gang. Hvis downstreamhandlingen ikke er idempotent, skal handlingen indeholde en afduplikeringsnøgle.
-
Har brugeren eller en downstream-proces brug for at vide, hvornår handlingen fuldføres? Agenten kan kun bekræfte udsendelse. Hvis der kræves fuldførelsesstatus, skal du designe en separat advisering eller opfølgningsmekanisme. En platformsbegivenhed, en sagsopdatering eller et tilbagekald - som er uden for denne overvejelsescyklus.
Salesforce-mønsterapplikation
| Løsning | Tilpas | Kommentarer |
|---|---|---|
| Pub/Sub API | Bedst til streaming af høj gennemsnit eller ekstern begivenhed | Agenten kalder en Apex, der udgiver en begivenhed til Salesforce Pub/Sub API over gRPC. Handlingen returnerer et PublishResult replayId til agenten som bekræftelse af udsendelse. Bruges, når downstream-forbrugere er eksterne systemer, der abonnerer via Pub/Sub API i stedet for Salesforce-oprindelige forløbs- eller Apex, eller når der kræves streaming af begivenheder med høj gennemsnit. |
| Platformsbegivenheder (Apex) | Bedst til intra-Salesforce asynkron udsendelse | Agenten kalder en Apex, der udgiver en platformsbegivenhed. Begivenheden leveres til alle abonnenter asynkront. Handlingen returnerer en udgivelsesbekræftelse til agenten. Den returnerer ikke et behandlingsresultat. Bruges, når downstream-forbrugeren er i Salesforce-platformen. Agenten kalder en Apex-handling, der kalder EventBus.publish(). Handlingen returnerer en SaveResult, der bekræfter accept. |
| Apex (Apex) | Bedst til længerevarende baggrundsbehandling | Agenten kalder en Apex, der sætter et kø- eller batchjob i kø. Jobbet kører uden for agentens transaktion. Handlingen returnerer et job-id, som agenten kan vise til brugeren som en reference. Bruges, når downstream-arbejdet er en langvarig Salesforce-handlingsdatabehandling, opdateringer af flere objekter eller eksterne udkald, der overskrider synkrone grænser. System.enqueueJob() returnerer et job-id, som agenten registrerer som en reference. |
| MuleSoft Async-forløb | Bedst til udsendelse af eksterne meddelelseskøer | Agenten kalder en MuleSoft-visningshandling, der placerer en meddelelse på en ekstern kø (Kafka, JMS, SQS). MuleSoft håndterer protokoloversættelse og leveringsbekræftelse. Agenten modtager bekræftelse på, at meddelelsen blev accepteret af MuleSoft, ikke at den blev behandlet downstream. |
| Eksternt REST-slutpunkt (Apex) | Bedst til indsendelse af ekstern systembegivenhed | Målsystemet viser et slutpunkt, der accepterer en indsendelse og returnerer et bekræftelses-id med det samme og fuldfører behandling asynkront. Agenten modtager bekræftelses-id’et og registrerer det. |
Skitser
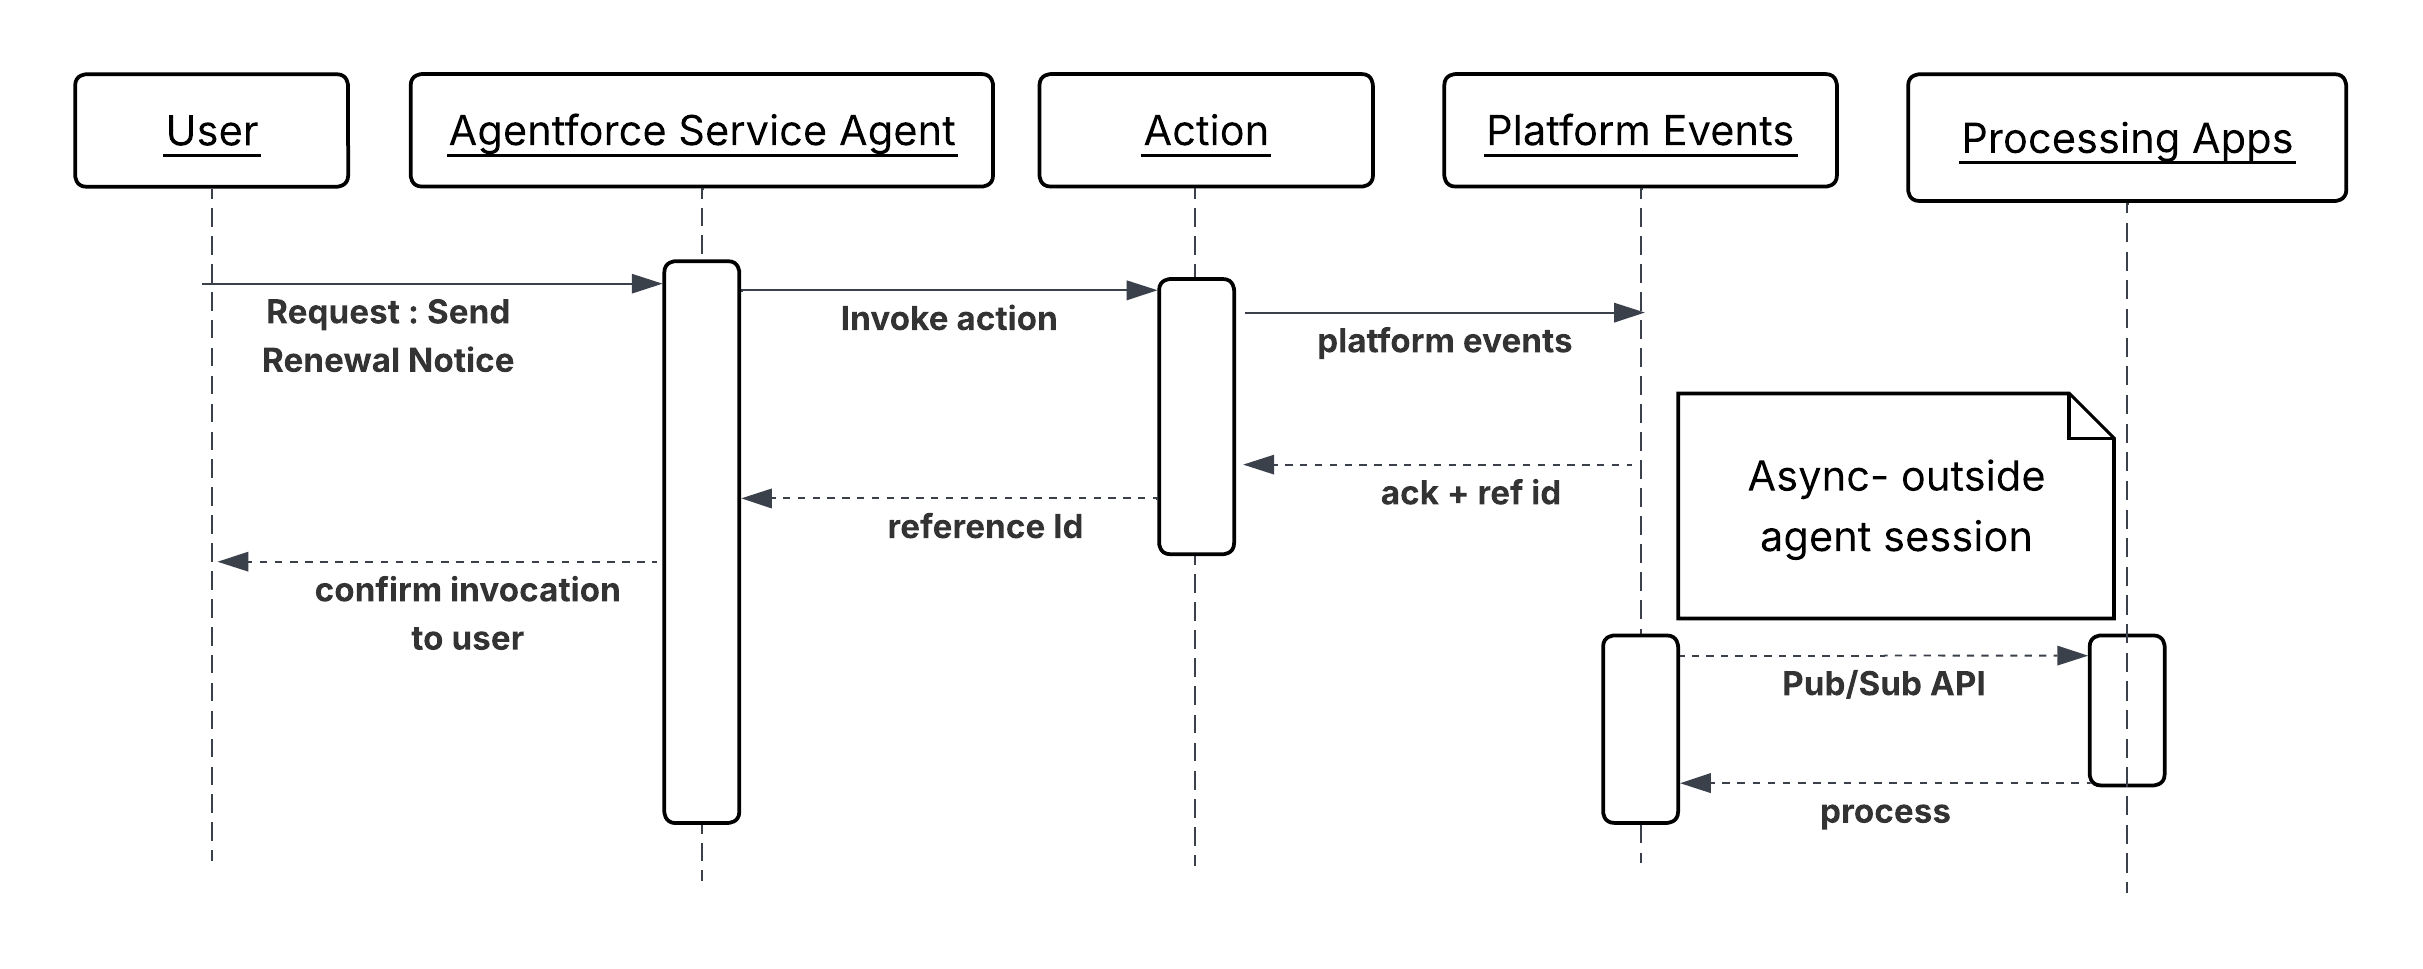
Sekvensdiagram for asynkron handlingskald
Resultater
Agenten kalder en downstream-handling uden at blokere dens overvejelsescyklus på resultatet. Omskifteren afsluttes med bekræftelse på, at handlingen blev accepteret, ikke at den blev fuldført. Downstream-systemet tager fuld ejerskab over kørsel. Den udsendte handling kan spores gennem platformsbegivenhedsabonnenter, job-id’er eller eksterne købekræftelses-id’er, der registreres i CRM på udsendelsestidspunktet. Hvis downstreamhandlingen mislykkes, vises denne fejl gennem downstream-systemets egen overvågning, ikke gennem den agentsession, der startede den.
Design overvejelser
Platform-agnostisk vejledning
- Skriv handlingsbeskrivelser på hensigtsbaseret sprog. F.eks. er “Sender en fornyelsesadvisering til meddelelseskøen og returnerer et udsendelsesreference-id” mere nyttigt for agenten end “kalder adviseringsslutpunktet”.
- Beskriv aldrig en udsendelseshandling som “sender og bekræfter levering af”. Agenten kan kun bekræfte accept. Downstream-levering og -behandling er uden for agentens observationsevne.
Implementeringsbemærkninger til Salesforce
- Returner et reference-id fra hver kaldshandling, f.eks. et platformsbegivenheds-
ReplayId, et job-id, der kan købes, et Pub/Sub APIPublishResultreplayId eller et eksternt bekræftelsestoken. Registrer den i en CRM-registrering på kaldtidspunktet. Dette er det eneste revisionsspor, som en agentsession vil oprette. - For Pub/Sub API kalder agenten en Apex, der foretager et gRPC-udkald til slutpunktet Pub/Sub API ‘/Udgiv’. Handlingen skal håndtere skemaregistreringstrinnet - begivenheder skal serialiseres i Avro-format op mod det registrerede skema. Returner
PublishResult ‘replayId’til agenten som udsendelsesreferencen. - For platformsbegivenheder skal du kalde
EventBus.publish()i Apex-handlingen og kontrollere SaveResult for fejl, før du returnerer en succesindikator til agenten. Antag ikke, at udgivelsen lykkedes. Valider den. - For Køjob skal du implementere Køgrænsefladen og kalde System.enqueueJob() inde fra handlingen. Returner det resulterende AsyncApexJob-id til agenten.
- For eksterne asynkrone slutpunkter skal målslutpunktet straks returnere en bekræftelse (HTTP 202 Accepteret) med et reference-id. Hvis slutpunktet blokerer, indtil behandlingen er fuldført, er det synkront, og dette mønster gælder ikke.
Fejlhåndtering og gendannelse
- En kaldshandling skal skelne mellem udsendelsesfejl (meddelelsen blev ikke accepteret) og behandlingsfejl (meddelelsen blev accepteret, men downstreamhandlingen mislykkedes senere). Agenten kan kun håndtere den tidligere.
- Hvis kald mislykkes, skal handlingen returnere en struktureret fejl med en tydelig årsag. Agenten kan prøve udsendelsen igen, eskalere til et menneske eller registrere en mislykket udsendelsesregistrering, men den kan ikke gendanne en downstream-behandlingfejl i den samme session.
- For handlinger, hvor downstream-fejl til sidst skal vises, skal du designe en separat feedbackkørsel som en platformsbegivenhed, der er udgivet af downstream-processen, et planlagt forløb, der kontrollerer jobstatus, eller en opfølgningssag, der er uden for agentens session.
Sikkerhedsovervejelser
- Ombryd alle eksterne asynkrone udkald i navngivne legitimationsoplysninger. Handlingen Kald integrerer ikke slutpunkts-URL’er eller legitimationsoplysninger i kode.
- Valider og saniter alle parametre, der er overført til kaldshandlingen, før de integreres i begivenhedsdata eller meddelelsesbrødtekst. Brugerangivet tekst, der overføres til en asynkron meddelelse, er en potentiel indsættelsesvektor i downstream-forbrugeren.
- Registrer hver udsendelse med sessions-id, reference-id og saniteret data på udsendelsestidspunktet. Da der ikke returneres noget svar til agenten, er denne logfil den primære mekanisme til at rekonstruere det, som agenten startede.
- Anvend mindst-rettighed på integrationsbrugeren eller den tilsluttede app. En udsendelseshandling, der udgives til en adviseringskø, bør ikke indeholde legitimationsoplysninger, der tillader læsning eller skrivning på ikke-relaterede systemer.
Eksempel
En fornyelsesstyringsagent, der håndterer en kontrakt, der nærmer sig udløb, bestemmer, at kunden er kvalificeret til en automatisk fornyelsesadvisering. Agenten behøver ikke bekræftelse på, at mailen blev leveret, før skiftet blev afsluttet.
CheckRenewalEligibility(Autostarted Flow) evaluerer kontraktvilkår, kundeniveau og frameldingsstatus. Returnerer en “berettiget” boolesk og den foretrukne adviseringskanal.DispatchRenewalNotification(Apex Action) udgiver enRenewalNotification\_\_ePlatform-begivenhed, der indeholder kontrakt-id’et, kunde-id’et, adviseringskanalen og en genereret idempotency-nøgle. Returnerer et ReplayId, der bekræfter, at begivenheden blev accepteret af platformen.UpdateContractRecord(Autostarted Flow) skriverReplayIdog udsendelsestidsstemplet til kontraktregistreringen og angiver statusflaget “Advisering udsendt”.
Kontekst
Eksterne applikationer som kundeportaler, mobilapps, tredjeparts SaaS-platforme og partnersystemer skal kalde agenter programmeringsmæssigt for at håndtere serviceanmodninger, starte arbejdsflows eller vise AI-styrede svar i deres egne grænseflader. Agenten fungerer som en intelligent backendtjeneste. Det eksterne system leverer kontekst, agentens årsager og handlinger, og opkalderen forbruger svaret.
I stigende grad er opkalderen selv en AI-agent eller orkestrator snarere end en applikation rettet mod mennesker. I disse AI-til-AI-mønstre uddelegerer en orkestreringsagent et argumentationstrin, et CRM-opslag eller en handling til Agentforce som et diskret værktøjsopkald. Vi skal vise en MCP-server (Model Context Protocol) for at understøtte dette mønster.
Problem
Når et eksternt system eller en AI-agent har brug for at udnytte en Agentforce funktioner efter behov, hvordan godkendes det, opretter en agentsession, overfører de nødvendige samtale- og kontekstdata og modtager pålideligt agentens strukturerede svar for at styre sin egen downstream-logik?
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål:
- Forventer den eksterne opkalder et synkront svar med lav forsinkelse, eller accepteres et asynkront tilbagekald?
- Hvordan etableres og udbredes opkalderens identitet til agentens kørselskontekst for dataadgang og personliggørelse?
- Hvad er den forventede mængde af samtidige API-udløste sessioner, og hvordan interagerer det med Salesforce API-frekvens og begrænsninger for samtidighed?
- Skal det eksterne system vedligeholde sessionskontinuitet på tværs af flere vagter (samtale med flere vagter), eller er hver anmodning statløs?
- Hvordan skal agentens svar struktureres, så opkaldssystemet kan parse og reagere på det programmeringsmæssigt?
- Er opkalderen en applikation rettet mod mennesker, der kræver direkte REST-integration, eller en AI-agent eller orkester, der kan kalde Agentforce som værktøj via en standardprotokol, f.eks. MCP?
Salesforce-mønsterapplikation
| Løsning | Tilpas | Kommentarer |
|---|---|---|
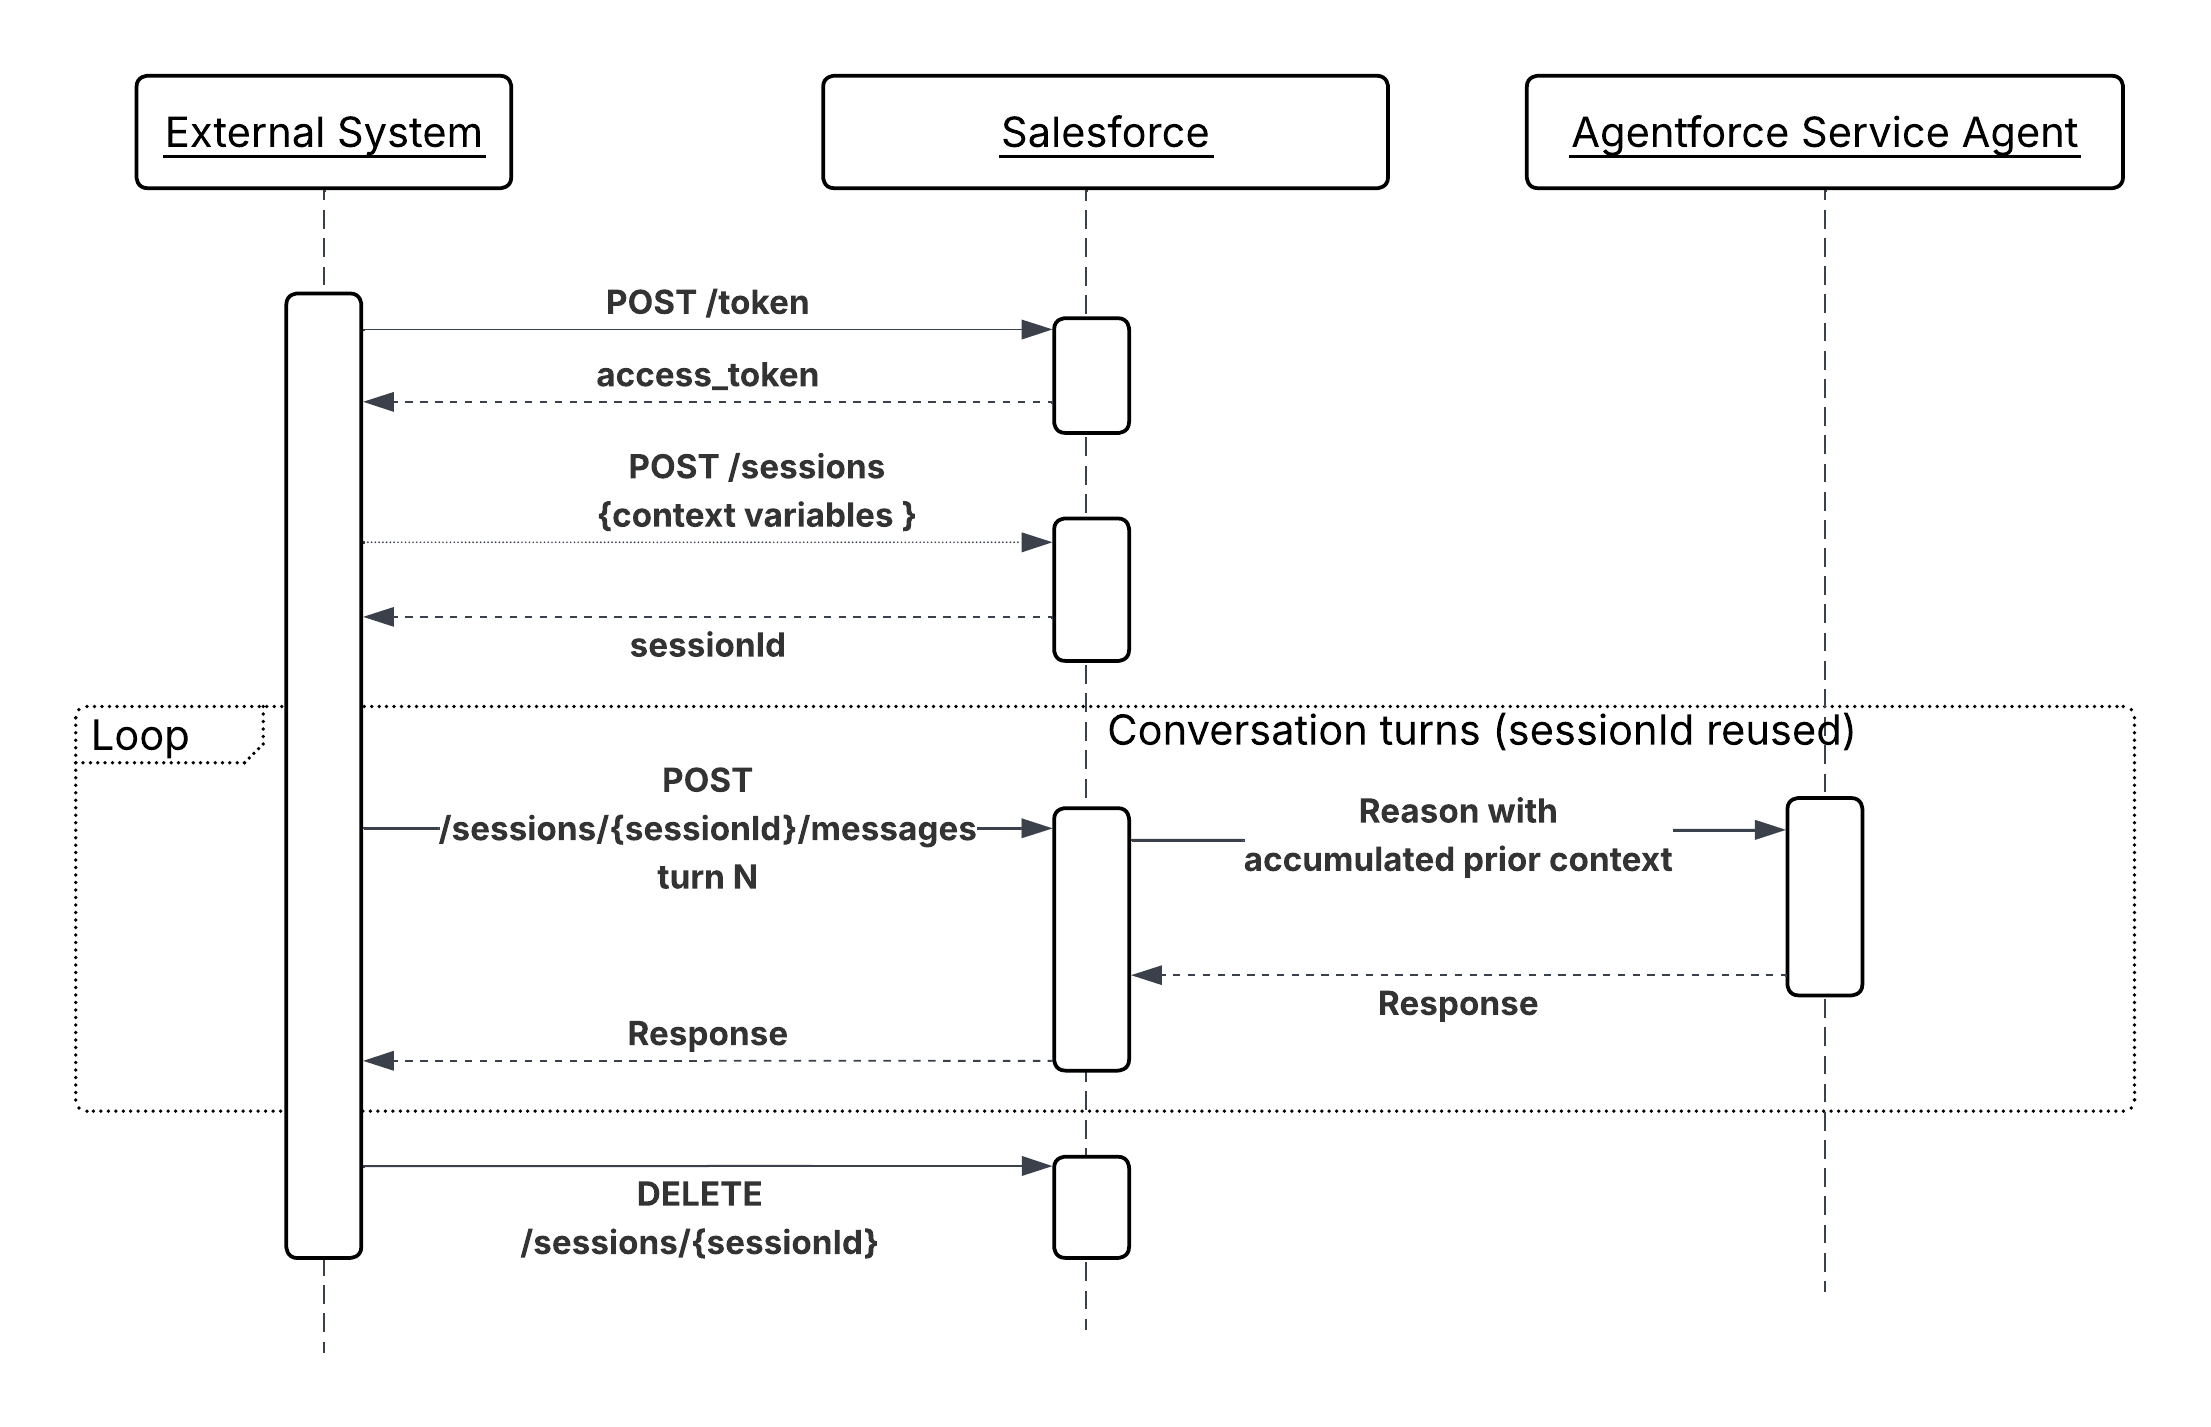
| Agentforce Agent-API - enkelt drejning (synkron) | Bedst til statsløse, anmodnings-svar-integrationer | Opkaldssystemet kræver et øjeblikkeligt, struktureret svar, og agentens argumentation forventes at blive fuldført inden for opkalderens timeouttolerance. Opkaldssystemet administrerer faserne for den fulde sessions livscyklus - oprettelse, skift og afslutning. Det eksterne system godkendes, opretter en session med kontekstvariabler, sender en enkelt meddelelse, modtager agentens svar og lukker sessionen. Denne Agentforce API er den primære REST-grænseflade, hvorigennem eksterne systemer opretter sessioner, udveksler meddelelser og lukker sessioner programmeringsmæssigt. Hele udvekslingen fuldføres inden for en HTTP-anmodnings-svar-cyklus. Svar inkluderer agentens naturlige sprogoutput og eventuelle strukturerede outputvariabler, der er oprettet af handlinger, som agenten kaldte under argumentation. |
| Agentforce Agent API - Multi-Turn (Sessionskontinuitet) | Bedst til konverserende integrationer, der kræver tilstand på tværs af vagter | Den eksterne grænseflade er konverserende (f.eks. en chatwidget eller voice-grænseflade), og interaktionen kræver flere udvekslinger for at nå en løsning. Det eksterne system opretter en session en gang og genbruger sessions-id’et på tværs af flere meddelelsesudvekslinger. Agenten bevarer samtalekonteksten mellem skift som tidligere spørgsmål, hentede data, foretagede beslutninger uden, at opkalderen leverer dem igen. |
| Asynkront med afstemning eller Webhook-tilbagekald | Bedst til arbejdsflows med høj forsinkelse eller tidsfølsomme brugergrænseflader | Agentens behandlingstid er ikke triviel, og bevarelse af en åben HTTP-forbindelse vil nedsætte opkalderens brugeroplevelse eller udløse upstream-timeouts. Det eksterne system indsender anmodningen og modtager straks en bekræftelse med et job- eller sessions-id. Det afstemmer derefter et statusslutpunkt eller registrerer et webhook for at modtage agentens svar, når argumentationen er fuldført. I øjeblikket kan dette mønster implementeres med en wrapper-API, der hostes på en middleware som MuleSoft. Ekstern forbruger kalder denne Wrapper API og registrerer webhook-slutpunktet. Wrapper API sender bekræftelsen tilbage til det eksterne system efter kald af Agentforce. Denne wrapper-API vedligeholder også Agentforce session og returnerer svaret tilbage til det eksterne system ved brug af det registrerede webhook-slutpunkt, når agenten svarer. |
| Agentforce via MCP (Salesforce Headless 360) | Bedst til AI-til-AI-kald, hvor opkalderen er en MCP-kompatibel klient | Den kaldende MCP-klient kalder Agentforce som et værktøj gennem den køreklare MCP-server, der leveres af Salesforce Headless 360. Sessionslivscyklussen administreres gennemsigtigt af MCP-serveren, og den kaldende agent interagerer via standardværktøjsopkald uden at opbygge en tilpasset REST-integration. Brug denne løsning, når opkalderen er en MCP-klient, der har brug for at uddelegere begrundelse, CRM-kontekst hentning eller handlingskørsel til Agentforce som et diskret trin i et bredere agentisk arbejdsflow. |
Skitser
Sekvensdiagram for On-Demand Agent-kald
Resultater
Dette mønster viser Agentforce som en AI-tjeneste, der kan kaldes. Eksterne systemer får adgang til agentens argumentation, værktøjer og CRM-kontekst uden at replikere denne logik. Opkalderen forbliver ansvarlig for administration af sessionslivscyklus og gengivelse af svaret. Agenten forbliver ansvarlig for al grundlægning, værktøjsvalg og svarsyntese.
Når opkalderen er en AI-agent eller orkestrator, fjerner Agentforce via MCP-mekanismen (tilgængelig fra kassen via Salesforce Headless 360) behovet for en tilpasset REST-integration fuldstændigt. MCP-serveren håndterer sessionslivscyklussen på vegne af den opkaldende agent, hvilket gør det muligt for Agentforce at deltage som et førsteklasses værktøj i arbejdsflows med flere agenter uden yderligere ledninger.
Design overvejelser
Platform-agnostisk vejledning
- Undgå at gøre det eksterne API-kald synkront og blokere i tidsfølsomme brugergrænsefladeforløb. Indfør et polling- eller webhook-tilbagekaldsmønster, hvor agentsvartider ikke er trivielle, for at adskille brugeroplevelsen fra agentens behandlingstid.
- Vælg opkaldsmekanismen baseret på opkalderens karakter, ikke tilgængelighed. Anvendelsesorienterede applikationer og systemintegrationer skal bruge agent-API direkte. Værktøjer, der understøtter MCP’er, skal bruge Agentforce MCP-serveren. Blanding af mekanismer for den samme opkaldstype tilføjer unødvendig kompleksitet uden arkitektonisk fordel.
Implementeringsbemærkninger til Salesforce
- Indsæt sessionskontekst i sessionoprettelses POST-anmodningen, ikke i den første brugermeddelelse. Når det eksterne system opretter sessionen, har det en mulighed for at overføre strukturerede kontekstvariabler (konto-id, berettigelsesdata, tidligere interaktionssammendrag) direkte som navngivne sessionsparametre. Disse variabler er tilgængelige for agenten, før den behandler en enkelt drejning, så den begynder at argumentere fra en jordbaseret tilstand uden at udstede opkald for at fastslå, hvem kunden er, eller hvad de er berettiget til. Overførsel af de samme data i meddelelsens brødtekst tvinger i stedet agenten til at parse ustruktureret tekst for at udtrække fakta, den kunne have modtaget som indtastede variabler - øger forsinkelsen, introducerer udtrækningsfejl og forbruger argumentationstrin, der ikke tilføjer nogen forretningsværdi.
- Design agentsvar til at være strukturerede og maskinparsable. Brug outputvariabelkonventioner og meddelelsesinstruktioner, der guider agenten til at returnere JSON-venlige eller tydeligt afgrænsede svar, når opkalderen er et system i stedet for et menneske.
- Administrer sessionslivscyklus eksplicit. Afslut sessioner straks efter brug af
DELETE /einstein/ai-agent/v1/sessions/{sessionId}for at frigøre samtidige intervaller og undgå, at forældet kontekst fortsætter på tværs af ikke-relaterede interaktioner. - Konto for begrænsninger for samtidige Salesforce-sessioner. For scenarier med høj gennemsnit kan du implementere en sessionspulje eller et kølag i opkaldssystemet for at forhindre afvisning af anmodninger under spidsbelastning.
- Når du kalder Agentforce via MCP, skal du overføre kontekst som værktøjsinputparametre i stedet for som sessionsvariabler. MCP-serveren administrerer sessionens livscyklus gennemsigtigt, så den kaldende agent ikke kan angive navngivne sessionsparametre direkte på oprettelsestidspunktet. Sørg for, at al den påkrævede kontekst (registrerings-id’er, brugeridentitet, berettigelsesdata) er inkluderet i værktøjsopkaldsdata, så agenten begynder at argumentere fra en jordet tilstand.
- Behandl MCP-serverens gennemsigtige sessionsstyring som en bekvemmelighed, ikke en samtidig tilsidesættelse. Hver værktøjskald forbruger stadig et Salesforce-agentsessionsinterval. Højfrekvente orkestratorer, der ringer Agentforce via MCP på skala, skal tage højde for de samme begrænsninger for samtidige sessioner, der gælder for direkte agent-API-kaldere.
Fejlhåndtering og gendannelse
- Agent-API returnerer HTTP-standardfejlkoder. Opkaldssystemet skal håndtere “429 For mange anmodninger” (frekvensgrænse) med eksponentiel tilbagerulning og “503 Tjenesten utilgængelig” med logik for at prøve igen.
- Når agenten selv støder på en uløselig værktøjsfejl, returnerer den en god naturlig sprogfejl i svarbrødteksten. Opkaldssystemet registrerer disse sentinelsvar (f.eks. kontrollerer for et “fejl”-statusfelt i svaret) og distribuerer tilsvarende enten ved at prøve igen med yderligere kontekst, præsentere en tilbagerulningsoplevelse eller eskalere til et menneske.
- Når der kaldes via MCP, vises der fejl på to forskellige lag: MCP-transportfejl (forkert udformede værktøjskald, servertilgængelighed) og Agentforce (værktøjsudførelsesfejl, handlinger, der ikke kan løses). Orkestreringsagenten skal håndtere begge lag uafhængigt. MCP-transportfejl bør udløse forsøg på protokolleniveau. Agentforce, der returneres i værktøjssvaret, skal håndteres af orkestratorens egen tilbagerulnings- eller eskaleringslogik.
Sikkerhedsovervejelser
- Brug de smalest mulige OAuth-omfang for den eksterne klientapp. En integration, der kun skal kalde en agent, bør ikke indeholde omfang for dataadgang ud over, hvad agenten selv kræver.
- Valider og saniter alle input fra det eksterne system, før du injicerer dem som sessionsvariabler. Eksterne input er en angrebsoverflade for prompt-injektion. Et ondsindet opkald kan f.eks. udarbejde et “customerQuery”-felt, der er designet til at tilsidesætte agentinstruktioner.
- Anvend IP-tilladelseslister på den eksterne klientapp for at begrænse, hvilke eksterne systemer der kan godkende og kalde agent-API’en.
- Registrer alle indgående API-udløste sessioner med opkalderidentitet, sessions-id og anmodnings-/svarmetadata til revision og sikkerhedsformål.
- Når Agentforce kaldes via MCP, godkendes MCP-serveren til Salesforce på vegne af den opkaldende bruger. Sørg for, at MCP-serverens tilsluttede applegodkendelsesoplysninger er tilpasset de mindste krævede tilladelser, og at slutbrugerens identitet (ved brug af MCP-værktøjer som Claude) -identitet udbredes til sessionskonteksten eksplicit via værktøjsinputparametre.
Eksempel
En finansiel tjenesteportal udløser en Agentforce til at håndtere en pantforespørgsel.
- Portalen godkendes ved brug af OAuth-forløbet Client Credentials (Klientlegitimationsoplysninger) og henter et bearertoken.
- Det kalder “POST / Einstein/ai-agent/v1/sessioner” med sessionsvariabler: ”{ “accountId”: “001xx…”, “productType”: “mortgage”, “loanAmount”: 450000 }”.
- Brugeren indsender sit spørgsmål: “Hvilke dokumenter har jeg brug for for at fuldføre min ansøgning?”
- Portalen kalder “POST / Einstein/ai-agent/v1/sessioner/{sessionId}/meddelelser” med brugerens tekst.
- Agentforce kalder en “GetDocumentChecklist”-forløbshandling, henter de lånetypespecifikke krav og returnerer en struktureret liste.
- Portalen gengiver agentens svar direkte og lukker sessionen ved brugerafslutning.
Kontekst
Ikke alle agentarbejdsflows stammer fra en human-anmodning. Forretningskritiske signaler som et pludseligt fald i produktanvendelsesmetrikker, et afbrud af en indkøbsvogn af høj værdi eller en betalingsfejl, der overskrider en risikotærskel, forekommer hyppigt i driftsdata. Når disse signaler kræver intelligente, trinvise svar, introducerer det at vente på, at et menneske bemærker og handler, forsinkelse, der sammensættes til reelle forretningsomkostninger.
Dette mønster beskriver, hvordan begivenheder i realtid fungerer som autonome indgangspunkter for agenter. Agenten kaldes af en databetingelse snarere end en bruger, årsager over begivenhedskonteksten og kører et svararbejdsflow, alt sammen uden menneskelig initiering.
Problem
Når en forretningsbegivenhed i realtid forekommer i Data 360 eller Salesforce-platformen, hvordan kan denne begivenhed selvstændigt oprette en agentsession, levere begivenhedsdata som grundlæggende kontekst og føre et ikke-samtalehandlingsarbejdsflow til fuldførelse uden, at en person initierer eller guider interaktionen?
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål:
- Kræves der et svar med det samme i det øjeblik begivenheden udløses, eller er næsten realtidsbehandling (sekunder til minutter) acceptabel?
- Indeholder begivenhedsdataet tilstrækkelig kontekst til at placere agenten, eller skal agenten foretage yderligere opslag, før den kan begrunde effektivt?
- Hvad er den forventede begivenhedsmængde og frekvens? Begivenhedsstreams med høj gennemsnit kræver vurderingsstyring for at undgå at udnytte begrænsninger for agentsamtidighed.
- Kan den samme begivenhed udløses mere end en gang for den samme forretningsenhed (mindst en levering)? Hvis det er tilfældet, skal handlingerne være idempotent.
- Er der en menneskelig eskaleringssti, hvis agenten ikke kan løse begivenheden selvstændigt?
- Hvordan skal mislykket begivenhedsbehandling vises? Med en dødstavskø, en advarsel eller sagsoprettelse?
Salesforce-mønsterapplikation
| Løsning | Tilpas | Kommentarer |
|---|---|---|
| Data 360-udløste forløb | Bedst til adfærdsmæssige og metrikbaserede signaler | Dette er bedst, når udløserbetingelsen er defineret som en ændring af Data 360-segmentmedlemskab eller en metriktærskel. Data 360 registrerer forretningsbetingelsen (f.eks. afbrud af indkøbsvogn, brugsafbrydelse) og udløser et udløst forløb. Forløbet tilknytter begivenhedsdataattributter til agentsessionsvariabler og opretter Agentforce. |
| Platformsbegivenheder + automatisk startet forløb eller Apex | Bedst til interne platformsbegivenheder og krydssystembegivenheder | Brug denne løsning, når begivenhedskilden er i Salesforce-platformen, eller når et middleware-lag udgiver begivenheden efter registrering af betingelsen i et eksternt system. En platformsbegivenhed, der er udgivet af en Salesforce-proces eller et eksternt system, udløser en Apex eller et automatisk startet forløb, som konstruerer agentens session med begivenhedsdata som kontekst. |
Skitser
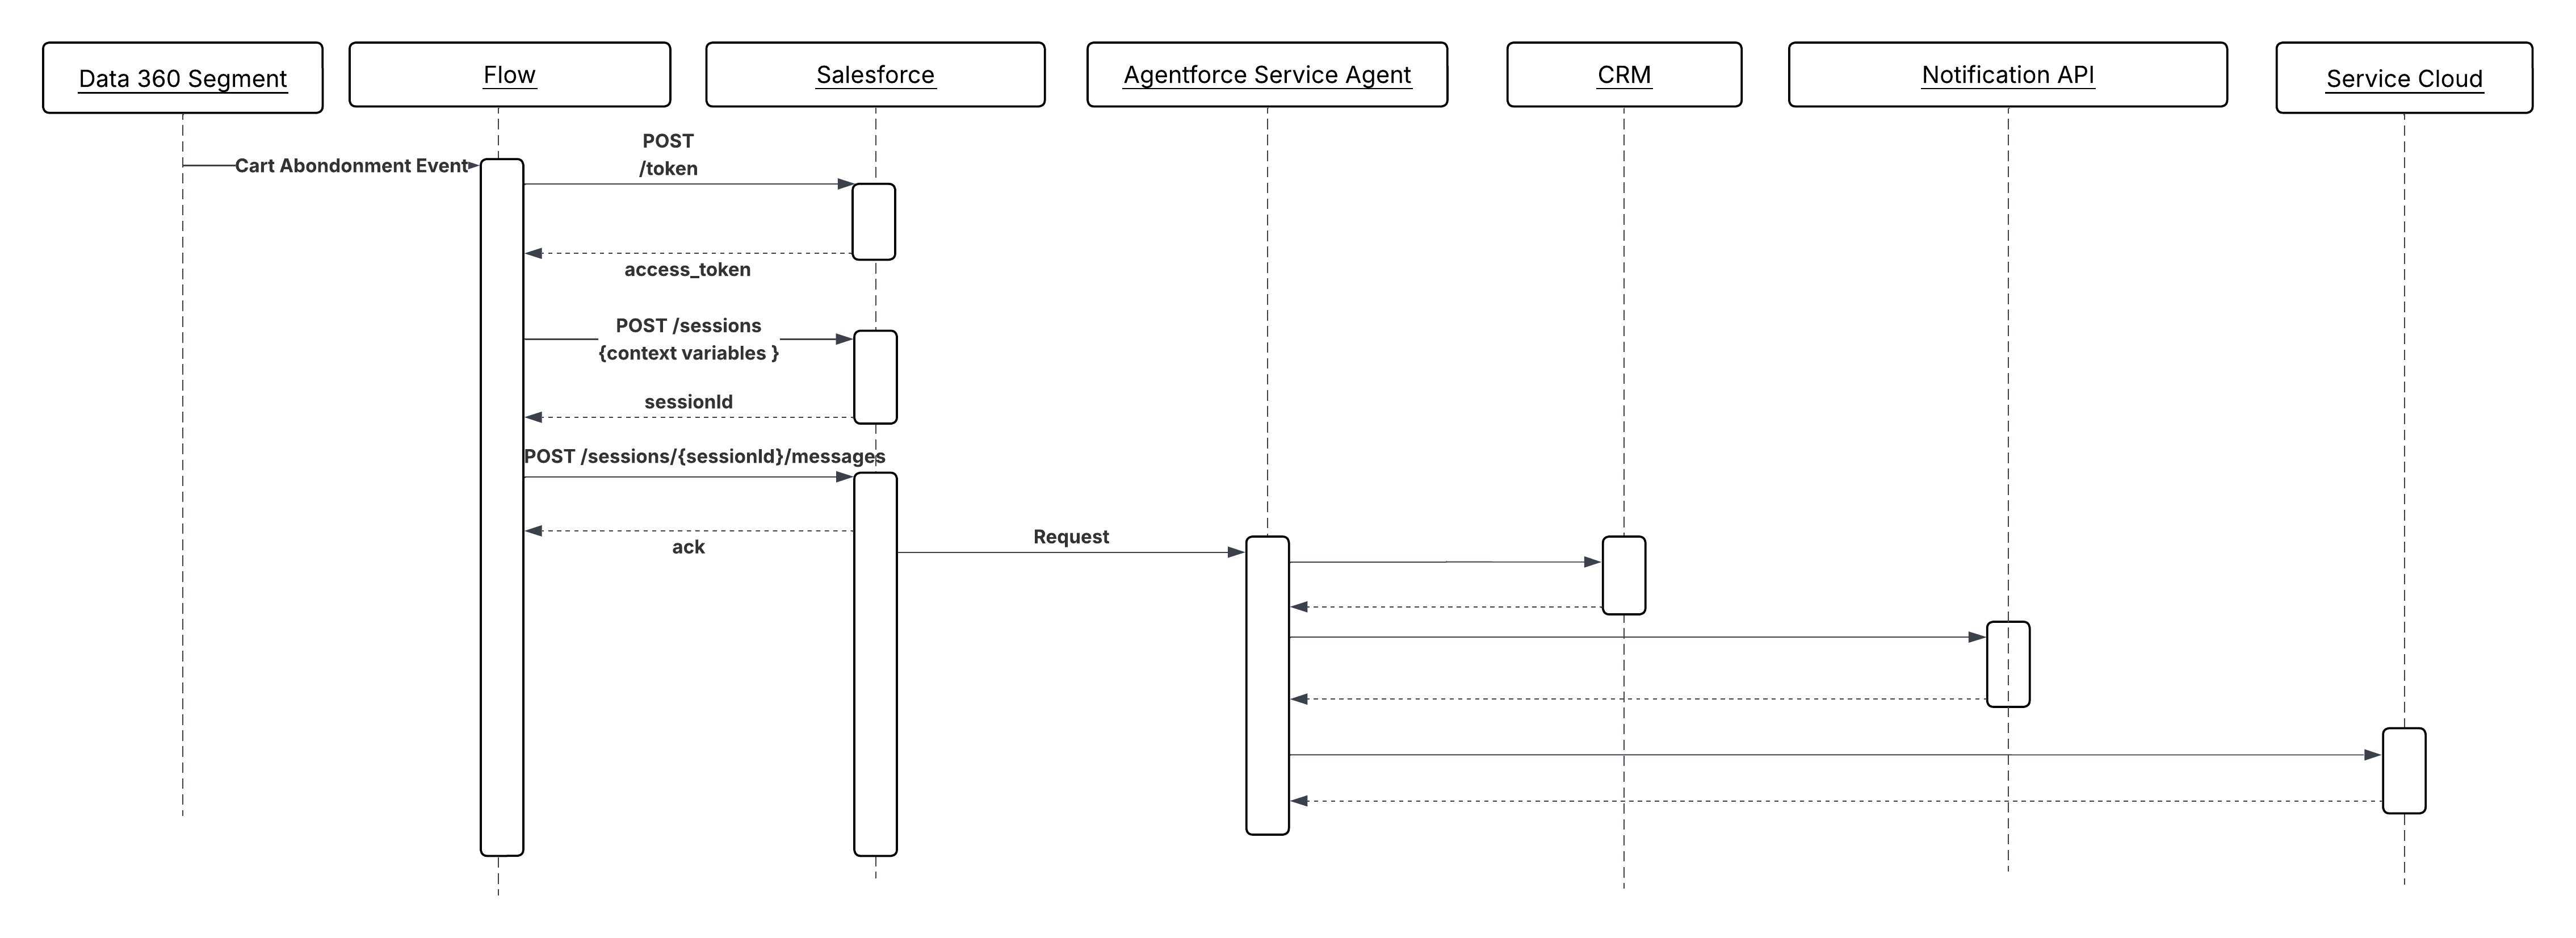
Sekvensdiagram for begivenhedsstyret agentkørsel
Resultater
Agenter bliver reaktive deltagere i forretningsdriften i realtid, ikke passive respondenter på menneskelige anmodninger. Begivenhedsudløste agenter kan udføre gendannelses-, sorterings- og eskaleringsarbejdsflows med hastigheden af data i stedet for hastigheden af menneskelig opmærksomhed.
Udløsningssystemet (Data 360 eller platformsbegivenheder) forbliver ansvarlig for begivenhedsregistrering og formatering af data. Agenten forbliver ansvarlig for at overveje denne dataindlæsning og vælge den korrekte handlingskæde. Der kræves ingen konverserende drejning. Begivenhedsdataene er det komplette input.
Design overvejelser
Platform-agnostisk vejledning
- Design alle handlinger til ikke-samtale-kald. Der er ingen brugeromdrejning. Agenten skal kun nå en løsning fra den indledende grundlæggende kontekst. Handlinger skal returnere strukturerede, deterministiske resultater i stedet for at bede om en præcisering.
- Sørg for, at begivenhedsdataene indeholder tilstrækkelig grundlæggende kontekst, før agentens session oprettes. En lean data, der tvinger agenten til at foretage flere opkaldsopkald, før den kan begrunde, øger forsinkelsen og samtidig forbrug.
- Gør alle skrivehandlinger, der udløses af begivenhedsstyrede agenter, idempotente. Begivenhedsleveringssystemer giver typisk mindst-en-garantier. Dubletbegivenhedsbehandling kan ikke oprette dubletbivirkninger.
Implementeringsbemærkninger til Salesforce
- I Data 360-udløste forløb skal du tilknytte begivenhedsdataattributter (f.eks. “accountId”, “eventType”, “metricValue”, “productIds”) direkte til navngivne sessionsvariabler på sessionsoprettelsestidspunktet. Dette justerer agenten fra det første argumenttrin uden at kræve en hentningshandling.
- For platformsbegivenhedsudløsere skal du bruge et automatisk startet forløb i stedet for et skærmforløb. Skærmforløb understøttes ikke i autonome, ikke-samtalekontekster.
- Angiv en eksplicit sessionstimeout på begivenhedsudløste sessioner. I modsætning til samtalesessioner er der ingen bruger, der kan udvide interaktionen. En session, der stopper på en mislykket handling, bør ikke indeholde et samtidig interval uendeligt.
- Brug forløbsfejlstier til at håndtere fejl ved oprettelse af agentsessioner. Hvis sessionen ikke kan oprettes, skal fejlstien udgive en kompenserende begivenhed eller oprette en sag for menneskelig opfølgning i stedet for at stoppe begivenheden.
Fejlhåndtering og gendannelse
- Begivenheder, der ikke kan udløse en agentsession korrekt på grund af samtidige grænser, sessionsoprettelsesfejl eller fejl ved validering af data, skal distribueres til en fejlsti, der opretter en sag, udløser en advarsel eller udgiver begivenheden til en død bogstavskø til genbehandling.
- Agentefejl midt i kørslen (f.eks. timeout af en krævet handling) skal logføres med det oprindelige begivenheds-id. Da udløsningen er asynkron, og der ikke er nogen ventende opkald, er fejloverfladen fuldstændig observationsbaseret: logfiler, dashboards og advarselstærskler.
- Implementer et prøvetak. Hvis en begivenhed pålideligt forårsager agentfejl, vil ubegrænsede forsøg udtone begrænsninger for samtidighed. Efter et konfigurerbart maksimalt antal forsøg skal du distribuere begivenheden til en menneskelig gennemgangskø med fuld kontekst vedhæftet.
- Spor begivenheds-id’et gennem den fulde livscyklus for agentens session. Denne sporing aktiverer korrelation mellem det oprindelige datasignal og alle downstream-handlinger til revision og fejlfinding.
Sikkerhedsovervejelser
- Valider og saniter alle begivenhedsdataattributter, før du injicerer dem som agentsessionsvariabler. Begivenhedsdata fra Data 360 eller eksterne handlingsområder er en angrebsoverflade for prompt-injektion. Et udarbejdet dataindlæsningsfelt kan f.eks. være designet til at tilsidesætte agentinstruktioner.
- Kør begivenhedsudløste agentsessioner under en dedikeret, mindst-rettighedsintegrationsbruger i stedet for en høj-rettigheds-administratoridentitet. Agenten har kun de tilladelser, der kræves for at udføre dets definerede handlingssæt.
- Registrer alle begivenhedsudløste sessioner med det oprindelige begivenheds-id, begivenhedstype og de sessionsvariabler, der blev indsendt ved oprettelse. Dette revisionsspor er påkrævet for at rekonstruere, hvorfor agenten foretagede en given handling, hvis resultatet er omtvistet.
Eksempel
Et detailfirma bruger Data 360 til at spore adfærd for indkøbsvogn i realtid. Når en indkøbsvogn med en værdi over en defineret tærskel er afbrudt:
- Data 360 registrerer afvisningssignalet og udløser et udløst forløb med begivenhedsdata: “customerId”, “cartValue”, “productIds” og “abandonmentTimestamp”.
- Forløbet tilknytter disse attributter til Agentforce og opretter en ny agentsession. Der kræves ingen brugerinteraktion.
- Agenten evaluerer kundens købshistorik, aktuelle berettigelser og indkøbsvognssammensætning ved brug af dens tilgængelige hentningshandlinger.
- Agenten kalder en
SelectRecoveryOffer-handling, der anvender det relevante rabatniveau baseret på kundesegment og enSendProactiveNotification-handling for at levere tilbuddet via kundens foretrukne kanal. - Agenten kalder
CreateFollowUpTaskfor at registrere interaktionen i CRM for kontoejerens synlighed. - Sessionen lukkes automatisk, når handlingskæden er fuldført. Det oprindelige begivenheds-id bevares i sessionsloggen af hensyn til sporbarheden.
Kontekst
LLM’er trænes i offentlige data. De har ingen Knowledge om din organisations produkter, politikker, sagshistorik eller kontrakter, medmindre disse oplysninger er udtrykkeligt angivet på tidspunktet for begrundelsen. Uden grundlæggende oplysninger vil en agent, der bliver spurgt om en kundes serviceberettigelse eller vilkårene for en bestemt kontrakt, enten hallucinere et svar eller indrømme, at vedkommende ikke ved noget. Ingen af resultaterne er acceptable i en virksomhedskontekst.
Hentningsudvidet generering (RAG) løser dette ved at hente relevante dokumenter fra et virksomheds Knowledge og indsætte dem i agentens kontekstvindue, før det genererer et svar. Agenten begrunder over hentet indhold som en Knowledge, en tidligere sagsløsning, en produktspecifikation, som om den havde fået disse oplysninger direkte. LLM leverer argumentationen. Hentlaget leverer fakta.
For eksempel behøver en serviceagent, der håndterer et komplekst garantikrav, ikke at have garantipolitikbetingelser indlejret i sine instruktioner. Når kunden i stedet beskriver deres problem, udfører agenten en semantisk eller hybrid søgning (nøgleordsøgning + semantisk søgning) mod et vektorindeks af garantidokumentationen, henter de relevante udtryk og bruger dem til at bestemme berettigelse og næste trin. Svaret baseres på det aktuelle, autoritative politikdokument, ikke på modellens træningsdata.
Problem
En agent skal besvare et spørgsmål eller træffe en beslutning, der afhænger af proprietær organisatorisk Knowledge som politikker, kontrakter, produktdokumentation eller historiske sagsdata, der ikke var en del af LLM’s uddannelsesdata. Hvordan henter agenten det mest relevante indhold på tidspunktet for begrundelse, sikrer, at hentet indhold er aktuelt og autoriseret, og injicerer det i konteksten med tilstrækkelig præcision til at undgå støj?
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål
- Er Knowledge statisk og sjældent opdateret (f.eks. produktmanualer), eller ændres det kontinuerligt (f.eks. sagsløsninger, lagerbeskrivelser)? Opdateringsfrekvens bestemmer design af overførselspipeline.
- Hvor stort er indholdet? En lille Knowledge base kan hentes udtømmende; en stor kræver segmentering, integrering og semantisk indeksering for kun at returnere de mest relevante passager.
- Giver forespørgslen fordel af en enkelt målrettet hentning, eller vil kombinationen af resultater fra flere Knowledge kilder (f.eks. dokumentation og tidligere sager samtidigt) give et bedre baseret svar? Sidstnævnte kræver samlings hentning.
- Er der behov for at filtrere hentet indhold efter metadata før semantisk rangering, f.eks. begrænse resultater til dokumenter, der er relevante for kundens produktniveau eller geografi?
- Hvor følsomt er Knowledge? Hentet indhold injiceres i LLM-kontekstvinduet og påvirker agentens svar. Indhold, der ikke skal vises for bestemte brugere, skal styres på hentningslaget, ikke antages at være filtreret af LLM.
Salesforce-mønsterapplikation
| Løsning | Tilpas | Kommentarer |
|---|---|---|
| RAG (Recovery-Augmented Generation) med Data 360 | Bedst til virksomhedsanvendelsessituationer | Agenten foretager en semantisk søgning op mod Data 360-vektorindekser, før der genereres et svar. Det hentede indhold som Knowledge, tidligere sager, produktdokumentation indsættes i LLM-konteksten som basis. Dette kan kaldes ved brug af Retriever-handlinger, Forløb eller tilpasset Apex. Bemærk, at Data 360 understøtter en integreret pipeline fra rå indhold til agentklar kontekst, ikke kun en vektorbutik:
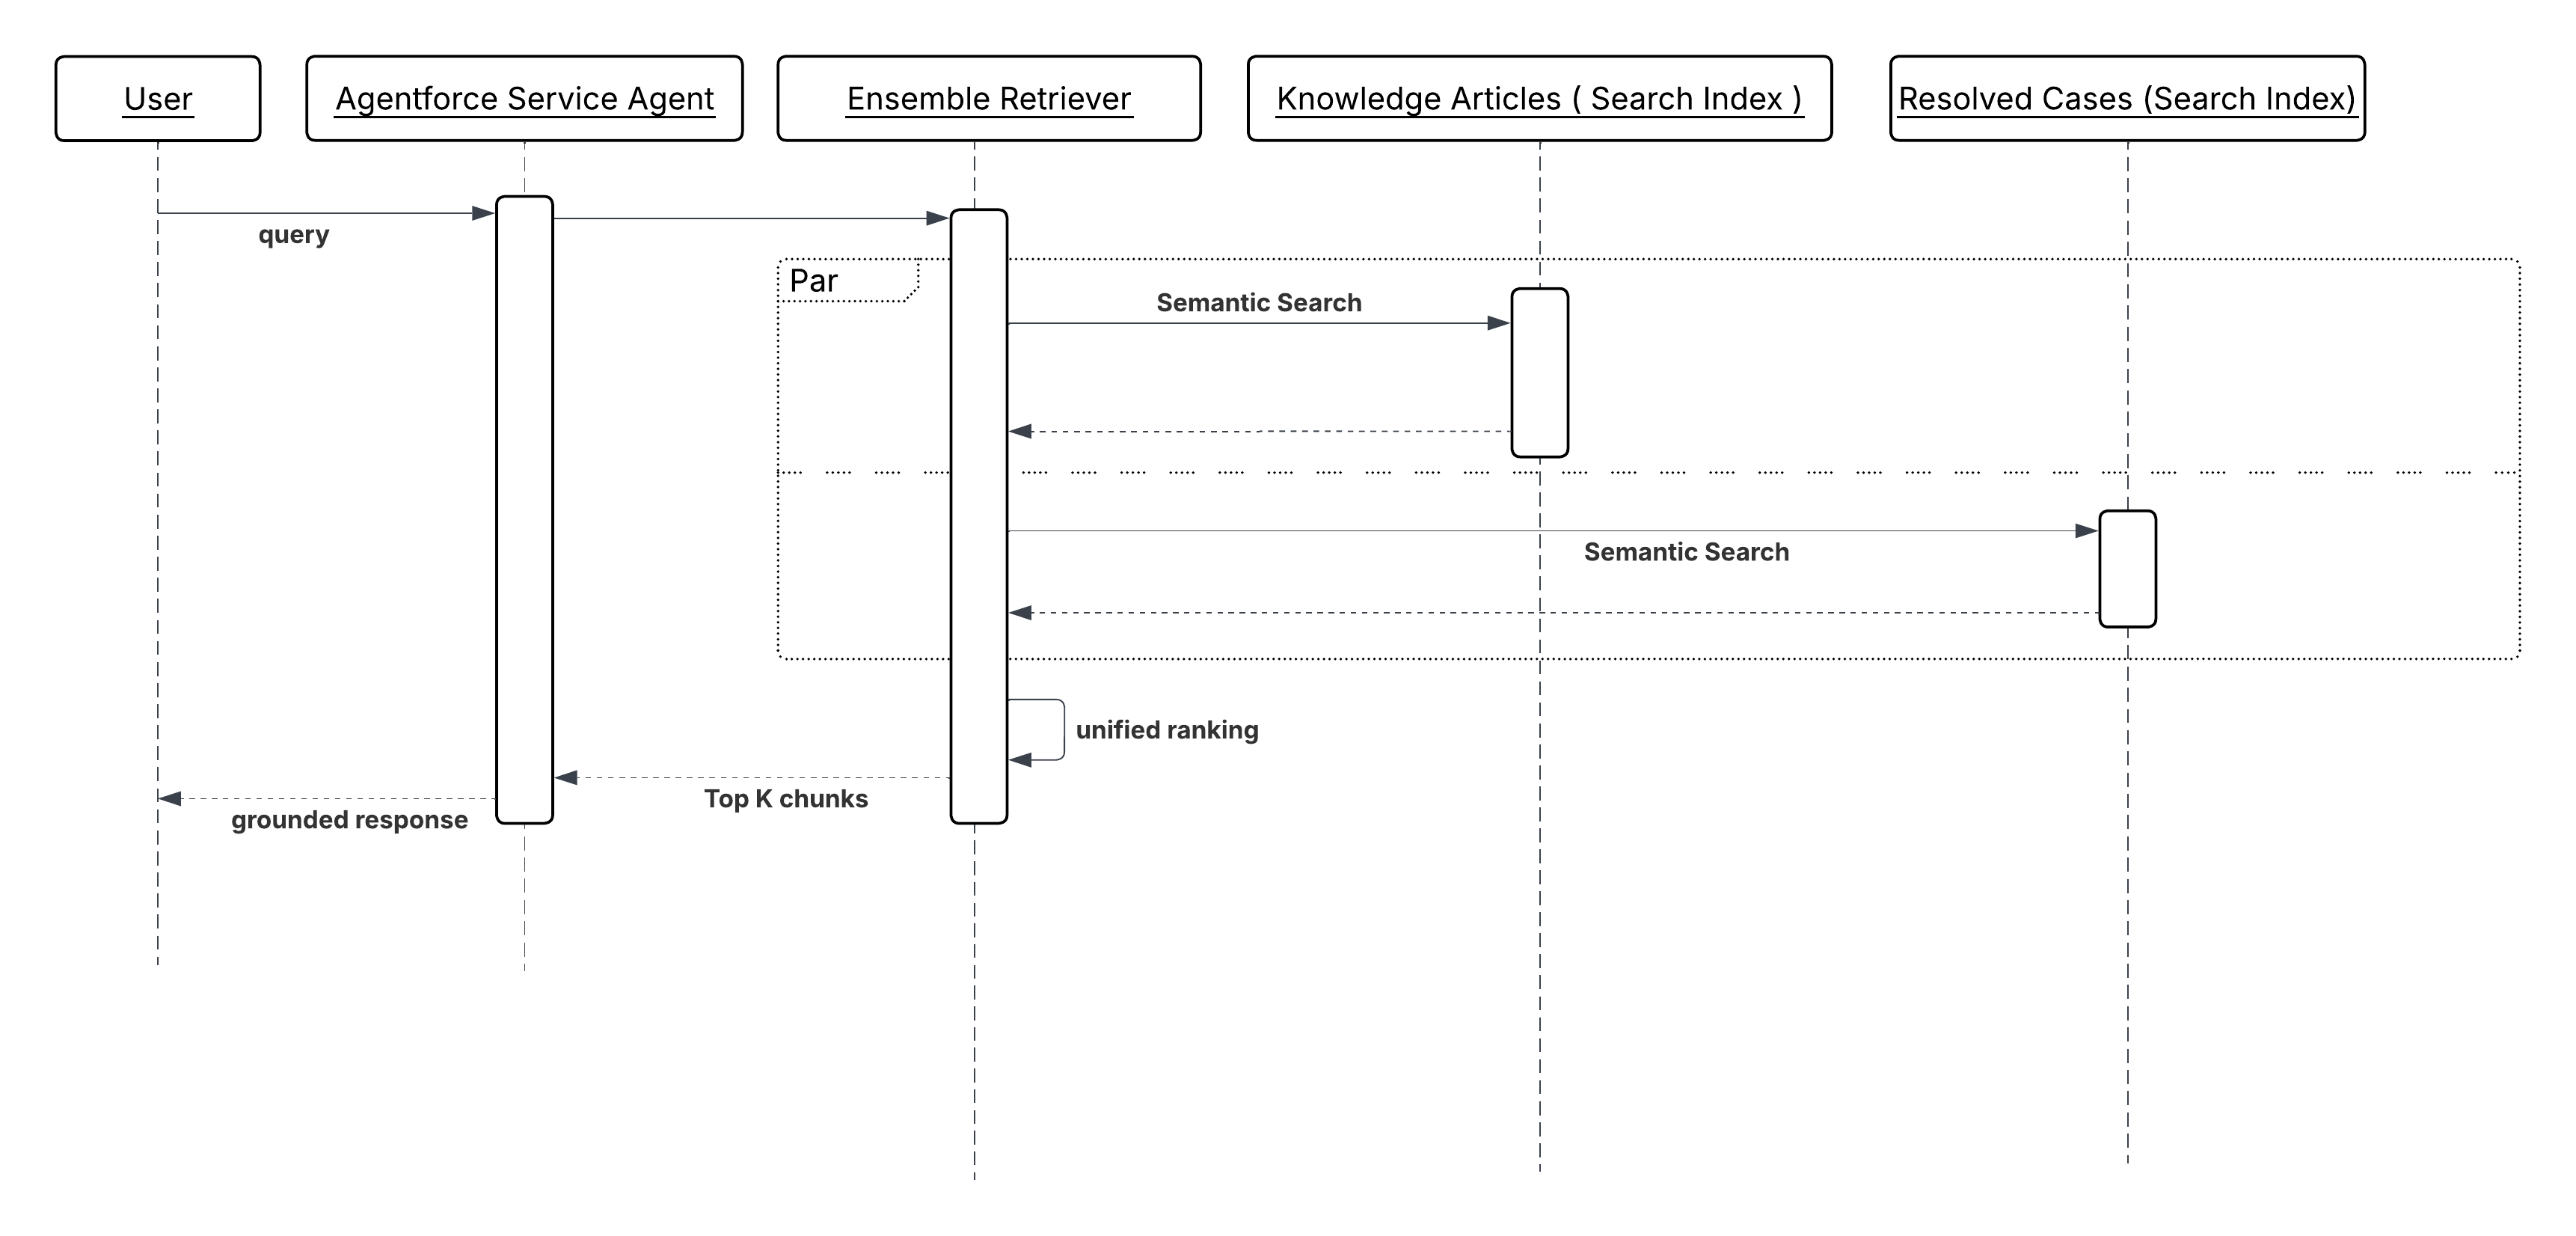
Alle disse funktioner tilbydes i begge tilpassede tilstand med fuld konfigurerbarhed. Vi har to typer af hentere for Data360: Individual Retriever: En konfigureret Salesforce Retriever-handling udfører en semantisk søgning mod et enkelt defineret søgeindeks og returnerer de mest relevante indholdsskranker. Resultater indsættes direkte i LLM-meddelelsen som grundlæggende kontekst. Brug Individuel hentningshandling, når forespørgslen bedst vises af en enkelt fokuseret Knowledge. Ensemble Retriever: En Ensemble Retriever-handling kombinerer resultaterne af flere individuelle hentere, f.eks. et produktdokumentationsindeks og et indeks for løste sager. Ensemble retrievers kombinerer ikke relevansscores fra individuelle retrievers, da disse scores ikke kan sammenlignes på tværs af heterogene indekser. I stedet overføres alle hentede segmenter gennem en krydskodermodel, der uafhængigt scorer hvert par (forespørgsel, segment), hvilket opretter en forenet rangering. Dette er arkitektonisk vigtigt: det betyder, at kvaliteten af krydskilderangering forbedres med reranker-modellen, ikke med manuel scorekalibrering. Når du har rangeret dem igen, stiller det det forenede resultat til rådighed for LLM-meddelelser som grundlæggende kontekst. Brug Ensemble Retriever-handling, når et mere komplet svar kræver beviser fra mere end et Knowledge. |
| RAG med tredjepartsvektordatabaser | Velegnet, når du arbejder inden for eksisterende infrastrukturbegrænsninger | Denne tilgang integrerer tredjepartsvektorbutikker, der måske allerede findes i din infrastruktur, til at indeksere egne dataintegrationer og udnytte dem til semantisk søgning i realtid og hentning af indhold. Dette kan implementeres ved brug af forløb eller tilpasset Apex. |
Skitser
Sequence Diagram for Knowledge Grounding fra Enterprise Content
Resultater
Agentens svar er forankret på organisationens aktuelle, autoritative Knowledge snarere end LLM’s uddannelsesdata. Hallucinationsrisiko på faktaspørgsmål som politikudtryk, produktspecifikationer, berettigelsesdetaljer reduceres, fordi modellen begrunder over hentede beviser, ikke genererer fra hukommelsen.
Knowledge forbliver uafhængigt vedligeholdeligt. Opdatering af et politikdokument eller tilføjelse af en ny sagsløsning til indekset træder i kraft med det samme for alle efterfølgende agentinteraktioner uden at træne eller genimplementere modellen.
Hentning leverer også et implicit revisionsspor. Da agentens svar er afledt fra specifikke hentede dokumenter, kan kildeindholdet logføres sammen med svaret, hvilket gør det muligt at spore, hvorfor agenten gav et bestemt svar.
Design overvejelser
Platform-agnostisk vejledning
- Opdel og integrer Knowledge i de rigtige detaljer. Fragmenter, der er for store fortynder relevans. Fragmenter, der er for små, mister den omgivende kontekst, som LLM har brug for for at begrunde korrekt. For de fleste virksomhedsdokumenttyper opretter segmentering på afsnitsniveau med overlappende kontekstvinduer den bedste hentningskvalitet.
- Behandl hentningsnøjagtighed som et førsteklasses designproblem. Indsættelse af indhold af lav relevans i agentens kontekstvindue er ikke neutralt. Det introducerer støj, der nedsætter svarkvaliteten. Tilpas hentningstærskler og top-k-grænser for at afbalancere tilbagekaldelse mod præcision for hvert Knowledge.
- Overførselsforsinkelse er en operativ SLA. Hvis et politikdokument opdateres, men vektorindekset ikke er blevet opdateret, henter agenten og reagerer på forældede oplysninger. Definer acceptabel forældelsestolerance for hver type indhold, og design overførselspipelines tilsvarende.
Implementeringsbemærkninger til Salesforce
- Udfyld Data 360-vektorindekser via den relevante overførselspipeline for indholdsopdateringsfrekvensen. Brug batchoverførsel til statiske dokumenter og streaming eller Change Dataregistrering (CDC) til registreringer, der ændres kontinuerligt.
- For Ensemble Retrievers skal du konfigurere relevansrangering vægte pr. kilde. Et indeks for løste sager kan have brug for en tendensbias. Et indeks for politikdokumentation behøver måske ikke. Tilpas vægte baseret på de forespørgselstyper, som agenten forventes at håndtere.
- Brug metadatafiltre i tilpassede Apex eller forløbsregistreringsprogrammer til at hente omfang, før semantisk søgning udføres. Filtrering efter produktlinje, område eller dokumenttype før rangering reducerer støj og forbedrer præcisionen af, hvad der indsættes i konteksten.
- Indsæt ikke det fulde hentede dokument i LLM-konteksten. Videregiv kun de relevante segmenter eller uddrag. Store kontekstinjektioner forbruger tokenbudget, øger forsinkelsen og reducerer andelen af kontekstvinduet, der er tilgængeligt for agentens argumentation.
Fejlhåndtering og gendannelse
- Hvis hentning ikke returnerer nogen resultater, skal du returnere en eksplicit “ingen resultater fundet”-status i stedet for at fortsætte ubundet. Agenten kan derefter udvide forespørgslen, bede brugeren om en præcisering eller eskalere til et menneske.
- Hver returneret del fra hentere indeholder en relevansscore. Afhængig af anvendelsessituationen skal der konfigureres en bestemt tærskelkonfidens-/relevansværdi, over hvilken agenten skal behandle hentningen som sikker, ellers skal den falde tilbage til afklaring eller eskalering.
- Hvis vektorindekset eller hentningstjenesten midlertidigt er utilgængelig, skal hentningshandlingen eller Apex returnere en struktureret fejl med en beskrivende årsag. Registrer fejlen med sessions-id’et og forespørgsel, så hentmangler kan identificeres, og indekset eller tjenesten kan overvåges for tilgængelighed.
- For tidsfølsomme Knowledge skal du implementere en opdateringskontrol som del af hentningssvaret. Hvis det seneste matchende dokument sidst blev opdateret ud over en defineret forældelsestærskel, skal du markere dette til agenten, så den kan kvalificere sit svar eller sin meddelelse til bekræftelse.
Sikkerhedsovervejelser
- Hentning skal respektere dataadgangstilladelserne for den bruger, som agenten handler på vegne af. En agentsession, der kører i konteksten af en kundeorienteret interaktion, må ikke hente interne driftsdokumenter, notater om prissætningsstrategi eller registreringer, som slutbrugeren ellers ikke ville have adgang til. Anvend sikkerhed på feltniveau og registreringsniveau på hentningslaget. Brug ikke LLM til at tilbageholde følsomt hentet indhold.
- Hentet indhold indsættes i LLM-kontekstvinduet og kan påvirke eller blive vist i agentens svar. Behandl hvert dokument i hentningsindholdet som potentielt synligt for slutbrugeren, og styr indholdsmedlemskab tilsvarende.
- Registrer alle hentningsforespørgsler og dokumentidentifikatorer for hentede segmenter sammen med sessions-id’et. Dette revisionsspor aktiverer rekonstruktion af det beviser, som agenten brugte, da han svarede, hvilket kan være påkrævet for overensstemmelse, konfliktløsning eller forklarbarhedsforpligtelser.
Eksempel
En finansiel serviceagent håndterer en kundeforespørgsel om sanktioner for tidlig indløsning på et fastsparingsprodukt:
- Kunden spørger: “Hvilken straf vil jeg få, hvis jeg trækker mine midler seks måneder tidligere?”
- Agenten kalder en Individuel hentningshandling, der er konfigureret op mod et vektorindeks af produktvilkår og betingelsesdokumenter.
- Henteren udfører en semantisk søgning ved brug af forespørgselskonteksten, f.eks. produkttype og kundekonto og det specifikke spørgsmål og returnerer de tre mest relevante dokumentkodestykker - tidlig indløsning-sætningen, tabellen for beregning af sanktioner og undtagelserne, der er gældende for vanskeligheder.
- De hentede segmenter indsættes i agentens kontekstvindue sammen med kundens spørgsmål.
- Agenten begrunder de hentede udtryk, identificerer den gældende sanktionsfrekvens for kundens produktniveau og indløsningstidslinje og returnerer et præcist, politikbaseret svar med angivelse af ikrafttrædelsesdatoen for de anvendte udtryk.
- Dokumentidentifikatorerne for de hentede segmenter logføres med sessionsregistreringen af hensyn til revisionsmuligheder.
Kontekst
LLM’er er sandsynlighedsmæssige af natur. Når de bliver bedt om at give en forklaring om en specifik kunde, udleder, estimerer eller hallucinerer de fakta, som de ikke eksplicit har givet. En agent, der kalder en prissætningshandling uden at vide, at kunden er en virksomhedskonto med høj værdi på et foretrukket niveau, kan anvende forkert rabatlogik. En agent, der eskalerer en supportsag uden at kende kundens afgangsrisikoscore, kan fjerne prioriteten af en konto, der er dage væk fra afgang.
Bekræftet kundekontekstinjektion håndterer dette ved at udfylde handlingsinputparametre på forhånd med bekræftede strukturerede attributter fra den forenede profil, før agenten kalder en handling. Agenten udleder ikke kundens segment, livstidsværdi eller kundetilfredshedstendens. Den modtager disse fakta som grundlæggende input og årsager over dem. Dette mønster reducerer hallucinationsrisiko på kundespecifikke beslutninger og eliminerer overflødige opkaldsopkald under grundlægningscyklussen.
Før f.eks. en prissætningsagent kalder en “GenerateQuote”-handling, indsætter underagentkonfigurationen automatisk kundens segment, niveau og livstidsværdi fra deres forenede profil. Handlingen modtager bekræftede fakta i stedet for LLM-angivne tilnærmelser, og tilbuddet er forankret i kundens faktiske kommercielle relation.
Dette er ikke et alternativ til mønsteret “Knowledge Grounding from Enterprise Content”. En veldesignet agent kan bruge begge: “Knowledge Grounding from Enterprise Content” giver dokumentbaseret Knowledge, mens “Verified Customer Context Injection” etablerer kundeidentitet.
Problem
Hvordan sikrer du, at en agent har nøjagtige kundespecifikke fakta som segment, niveau, livstidsværdi, afgangsrisiko eller andre profilattributter, før vedkommende foretager en handling, i stedet for at gætte disse fakta alene?
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål:
- Hvilke handlingsinputparametre repræsenterer kundespecifikke fakta, der, hvis de udledes frem for at blive oprettet, ville resultere i ukorrekte eller inkonsekvente resultater?
- Er de krævede profilattributter tilgængelige som standard Data 360-forenede profilfelter, eller kræver de beregnede indsigter, der er afledt fra rå adfærdsmæssige og transaktionsmæssige data?
- Hvor ofte ændres de relevante profilattributter? Attributter som afgangsrisikoscore eller kundetilfredshedstendens kræver en opdateringsgaranti. Forældede profildata fører til de samme ukorrekte resultater som hallucinerede data.
- Skal profilattributter injiceres på sessionsoprettelsestidspunktet (konstant for sessionens varighed) eller hentes forfra på tidspunktet for handlingskald (for at afspejle tilstandsændringer midt i sessionen)?
- Skal agenten overveje profilattributterne direkte, eller er de kun forbrugt af handlingen og uigennemsigtige for agentens argumenteringsløkke?
Salesforce-mønsterapplikation
| Løsning | Tilpas | Kommentarer |
|---|---|---|
| Underagentkonfiguration - profilattributtilknytning | Bedst til statisk jordning på sessionsniveau | Det passer bedst, når profilattributterne er stabile i en enkelt interaktion. Tilknyt Data 360-forenede profilattributter (f.eks. “customerSegment”, “tier”, “lifetimeValue”) direkte til handlingsinputparametre i Agentforce. Attributter løses ved sessionsoprettelse og bevares konstant i sessionens varighed. |
| Data 360-tilsluttede forløb | Bedst til dynamisk eller mid-sessionsopdatering | Bruges, når profilattributter ændres hyppigt, eller når handlingen kræver den mest aktuelle tilstand. Brug et Data 360-tilsluttet forløb som et handlingstrin til at vise den seneste profiltilstand på tidspunktet for kald.Forløbet forespørger på den forenede profil, anvender enhver nødvendig transformation og returnerer attributterne som outputvariabler, der forbruges af den næste handling i kæden. |
| Beregnede indsigter som handlingsinput | Bedst til komplekse afledte metrikker | Bruges, når agenter har brug for at overveje beregnede forretningsmetrikker (afgrænsningsrisikoscore, kundetilfredshedstendenser, produktindeks) i stedet for at fortolke rå data. Defineret i Data 360 som afledte metrikker, der beregnes over adfærdsmæssige, transaktionelle og engagementsdata. Beregnede indsigter vises som profilattributter, der kan forespørges på, og kan knyttes til handlingsinput via emnekonfiguration eller et tilsluttet forløb. |
Skitser
Sekvensdiagram for bekræftet kundeindsprøjtning
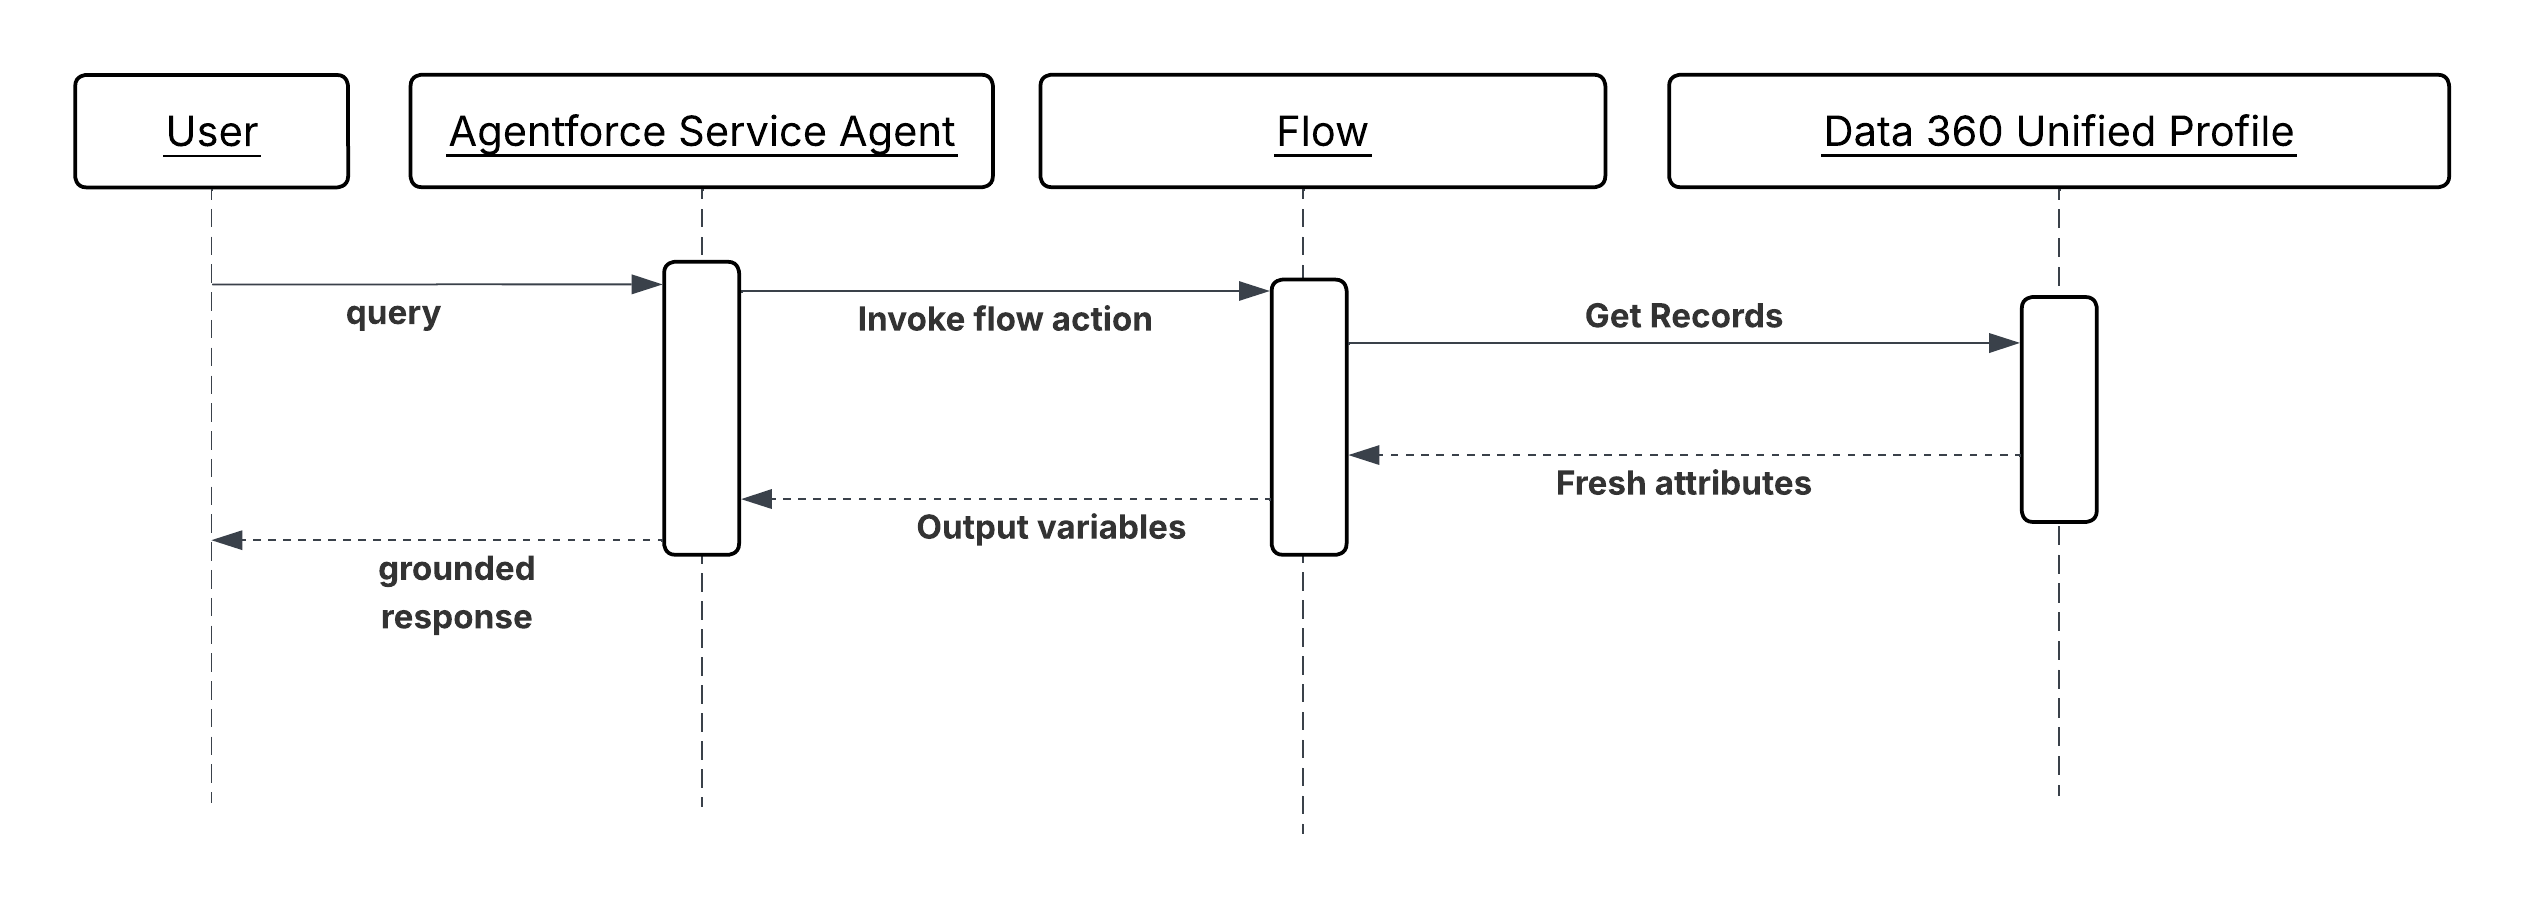
Resultater
Handlinger modtager bekræftede, strukturerede kundefakta i stedet for LLM-angivne tilnærmelser. Agentens argumentation er forankret i kundens faktiske profiltilstand, hvilket reducerer hallucinationsrisiko på beslutninger, hvor faktisk nøjagtighed bestemmer resultatkvalitet som prissætning, berettigelseskontroller, eskaleringsdistribution, tilbageholdelsestilbud.
Profil-landestandard reducerer også forsinkelse med begrundelse. Når agenten ikke behøver at udstede opkaldsopkald for at etablere grundlæggende kundekontekst, er begrundelsescyklussen kortere, og samtidig forbruges for færre vagter.
Den forenede Data 360-profil forbliver den autoritative kilde til kundefakta. Underagentkonfigurationen eller det tilsluttede forløb er integrationssømmen. Agenten er ansvarlig for at argumentere over disse fakta og vælge handlinger, ikke for at kende selve fakta.
Design overvejelser
Platform-agnostisk vejledning
- Identificer alle handlingsinputs, der bærer hallucinationsrisiko – hvor LLM-afledning kan oprette et forkert resultat i stedet for en bekræftet værdi. Inputter med hallucinationsrisiko er kandidater til profilgrænsning. Ikke alle input kræver jordning. Overindsprøjtning af profildata føjer støj til agentens kontekstvindue.
- Behandl profilfriskhed som en designbeslutning, ikke en eftertænkning. Definer den acceptable forældelsestolerance for hver landestandardattribut, og vælg injiceringsmekanismen tilsvarende: tilknytning på sessionsniveau for stabile attributter, forløbsbaseret opdatering for flydende attributter.
- Beregnede indsigter skal kode forretningslogik, ikke rå metrikker. En agent, der argumenterer over en “churnRiskScore” på 0,87, er mere effektiv end en agent, der argumenterer over 14 rå adfærdssignaler. Beregn fortolkningen i Data 360, og overfør resultatet til agenten.
Implementeringsbemærkninger til Salesforce
- Profil-landestandard er kun så pålidelig som den forening, der ligger bag den. Værdien af den forenede profil afhænger f.eks. fuldstændigt af kvaliteten af identitetsløsning upstream. Hvis en kunde har fragmenterede identiteter på tværs af kildesystemer, der ikke er blevet forenet, vil de profilattributter, som agenten modtager, være ufuldstændige, eller de repræsenterer kun en delvis visning (f.eks. Livstidsværdi beregnet med data fra en kanal, men ikke en anden).
- For Data 360-tilsluttede forløb skal du bruge Hent registreringer-elementet med et filter på den aktuelle sessions “recordId” eller “accountId” for kun at hente den relevante profilregistrering. Returner kun de attributter, der er påkrævet af downstream-handlingen. Returner ikke det fulde profilobjekt.
- Beregnede indsigter skal holdes opdaterede via Data 360-overførselspipelines. Opsæt streaming eller opdatering næsten i realtid for indsigter, der bruges i tidsfølsomme beslutninger (f.eks. afgangsrisiko i et bevarelsesarbejdsflow). Batchopdaterede indsigter er acceptable for attributter med langsommere bevægelse (f.eks. årligt kontraktværditype).
- Valider, at tilknyttede profilattributter ikke er nul før handlingskald. En nul “customerTier”, der overføres til en prishandling, er lige så skadelig som en hallucineret værdi. Brug forløbsbeslutningselementer til at registrere manglende profildata og distribuere til en tilbagerulning, der enten henter en standard eller beder om en tydeliggørelse.
- I underagentkonfigurationen skal du tilknytte profilattributter til handlingsinputparametre ved brug af beskrivende, semantisk tydelige variabelnavne (f.eks. “customerTier”, “lifetimeValueUSD”, “churnRiskScore”). LLM læser disse navne, når der vælges og oprettes handlinger. Tvetydige navne nedsætter valgnøjagtigheden.
Fejlhåndtering og gendannelse
- Hvis en krævet profilattribut er nul eller utilgængelig på tidspunktet for handlingskald, bør agenten ikke fortsætte med en potentielt ukorrekt standard. Handlingen skal returnere en struktureret fejl, der angiver den manglende attribut, og agenten skal enten bede brugeren om en præcisering eller eskalere til et menneske, hvis det fungerer ikke-samtalemæssigt.
- Hvis et Data 360-tilsluttet forløb ikke kan hente profildata (f.eks. på grund af en Data 360-serviceafbrydelse), skal forløbets fejlsti returnere en struktureret fejl til agenten med den specifikke fejlårsag. Agenten kan derefter beslutte, om han eller hun vil prøve igen, fortsætte med en degraderet oplevelse eller vise fejlen for brugeren.
- Registrer alle profilattributværdier, der er indsendt ved sessionsoprettelse eller handlingskald sammen med sessions-id’et. Dette sikrer, at enhver omtvistet agentbeslutning kan rekonstrueres med de nøjagtige kundefakta, som agenten blev givet på tidspunktet.
Sikkerhedsovervejelser
- Profilattributter, der er indsendt i agentkontekst, er underlagt de samme dataadgangskontroller som enhver CRM-registrering. Sørg for, at integrationsbrugeren eller den tilsluttede app, der bruges til at løse profilattributter, kun har de tilladelser på feltniveau, der kræves for de attributter, der vises, og ikke bredere profillæseadgang.
- Beregnede indsigter, der koder følsomme afledte metrikker (f.eks. forudsagt tilstandsscore, niveau for finansiel risiko), skal behandles som følsomme felter og styres af de samme adgangskontroller som de underliggende data. Visning af en score for høj afgangsrisiko til en agent, der opererer i en kontekst, der er rettet mod kunder, kræver omhyggelig overvejelse af, hvad agenten kan kommunikere.
- Vis ikke profilattributter, der ikke er påkrævede af handlingen. Hver yderligere attribut i agentens kontekstvindue er et yderligere dataelement, der kan gengives i agentens svar. Anvend et minimum-nødvendigt princip til at profilere landing.
- Overvåg alle sessioner, hvor Beregnede indsigter eller følsomme profilattributter blev indsendt som input. Disse sessioner repræsenterer beslutninger, der træffes på grundlag af afledt Kundeintelligens og kan være underlagt forklarbarhed eller reguleringsmæssige krav i visse brancher.
Eksempel
Et telekommunikationsfirma bruger Agentforce til at håndtere bevarelsessamtaler med kunder, der har startet en annulleringsanmodning.
- Når en annulleringssag åbnes, oprettes agentens session med kundens “accountId” som kontekst.
- Underagentkonfigurationen tilknytter tre Data 360 Unified Profile-attributter til sessionsvariabler på oprettelsestidspunktet: “customerTier” (Enterprise), “lifetimeValueUSD” (42.000) og “contractRenewalDate” (60 dage).
- En beregnet indsigt som “churnRiskScore” (0,91, beregnet fra anvendelsesnedgang, supportbilletfrekvens og NPS-tendens) tilknyttes som en yderligere sessionsvariabel via et Data 360-tilsluttet forløb, der kaldes som det første handlingstrin.
- Agenten, der nu er baseret på bekræftede kundefakta, kalder en “SelectRetentionOffer”-handling. Da inputs inkluderer “customerTier = Enterprise”, “lifetimeValueUSD = 42000” og “churnRiskScore = 0,91”, returnerer handlingen tilbuddet for maksimal bevarelse på niveau snarere end et standardtilbud.
- Agenten kalder “PresentOffer” for at levere tilbuddet i samtalen og “LogRetentionAttempt” for at registrere interaktionen i CRM med alle jordede attributter bevaret til revisionsmuligheder.
Kontekst
Virksomhedsdata er fragmenterede. En agent, der kun kan reagere på det, der findes i Salesforce-platformen, er begrænset til en brøkdel af de oplysninger, den har brug for for at begrunde effektivt. Besvarelse af et servicespørgsmål kan kræve læsning af en kundes åbne billet i Service Cloud. Forberedelse af et forslag kan kræve hentning af en fil fra Google Drev. Analyse af produktanvendelse kan kræve forespørgsel på en datalager. Hvert af disse systemer har sine egne API’er, sin egen godkendelsesmodel og sit eget dataskema, og omkostningerne ved at skrive tilpasset integrationskode for hvert af disse systemer er det, der historisk har gjort agent-til-system-forbindelser dyre og skrøbelige.
MCP er en åben standard, der håndterer dette direkte. Den definerer en ensartet grænseflade, hvorigennem en agent kan finde og kalde værktøjer, der vises af enhver MCP-kompatibel server, uanset det underliggende system. Hver MCP-server fungerer som en adapter: det ombrydes et målsystems oprindelige grænseflader i en standardiseret, værktøjscentrisk grænseflade, som agenten kan forespørge på, kalde på og oprette uden at vide noget om systemets specifikke protokoller eller skemaer.
Fra agentens perspektiv ser tilslutning til Slack, en SQL-database (Structured Query Language) og et dokumentstyringssystem identisk ud, tre MCP-servere, der hver viser et sæt beskrevne, kaldbare værktøjer. Agenten vælger og sekvenserer dem baseret på deres semantiske beskrivelser og det mål, den forsøger at nå.
Problem
Når en agent har brug for at hente oplysninger eller udløse handlinger på tværs af flere eksterne systemer - hver med forskellige API’er, godkendelse og skemaer - hvordan kan vedkommende finde, kalde og oprette deres egenskaber uden tilpasset integrationskode pr. system eller tæt tilknytning til et systems implementering?
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål:
- Skal agenten nå til systemer uden for Salesforce-platformen, f.eks. dokumentbutikker, samarbejdsværktøjer, databaser, tredjepartssaaS, hvis API’er ikke er repræsenteret som Agentforce som standard?
- Er dynamisk værktøjsdækning påkrævet, hvor agenten identificerer det rigtige integrationsslutpunkt på grundlæggende tidspunkt baseret på den aktuelle anmodning i stedet for at have integrationer hardcodet i dens konfiguration?
- Ændres integrationslandskabet ofte. Tilføjes nye systemer, eksisterende opdateres, og andre ændringer kan kræve, at en tilpasset-pr. system-tilgang vil skabe uholdbar vedligeholdelsesoverhead?
- Er der behov for at adskille agentens argumenteringslag fra implementeringsdetaljerne for downstream-systemer, så en ændring i et målsystems API ikke kræver ændringer af agentens instruktioner eller underagentkonfiguration?
- Ejes målsystemerne af forskellige teams eller leverandører, der hver især er ansvarlige for at vise deres egne funktioner, hvilket gør en MCP-servermodel på udbydersiden mere praktisk end en integration på forbrugersiden pr. agent?
Salesforce-mønsterapplikation
| Løsning | Tilpas | Kommentarer |
|---|---|---|
| Salesforce MCP-servere | Bedst til Salesforce-økosystemmål | Bruges, når målsystemet er i Salesforce-økosystemet, og der er en førsteparts-MCP-server tilgængelig. Salesforce Headless 360 leverer MCP-servere til sine egne platformsfunktioner og viser CRM-data, forløb og platformshandlinger som MCP-kompatible værktøjer. Reducerer implementeringsindsatsen til konfiguration snarere end udvikling. Notat: I øjeblikket understøtter Salesforce MCP-servere kun slutbrugerlegitimationsoplysninger til godkendelse og autorisation. |
| Tilpassede MuleSoft MCP-servere | Bedst, når der ikke findes nogen MCP-server fra førstepart | Brug til forældede systemer, private interne applikationer eller tredjeparts SaaS-platforme er før MCP-standarden. Når et målsystem ikke leverer sin egen MCP-server, kan et MuleSoft-integrationslag pakkes ind i en tilpasset MCP-server, der viser systemets funktioner som værktøjer. Det kan også bruges med Salesforce-API’er, hvis der kræves MCP’er for, at agenter kun skal bruges med systembrugerlegitimationsoplysninger. MuleSoft håndterer protokoloversættelse, godkendelse og datatransformation. MCP-laget gør resultatet synligt for agenter. |
| Tredjeparts-MCP-servere | Bedst til råvaresystemer med aktive MCP-økosystemer | Der findes en leverandørvedligeholdt MCP-server for din platform (GitHub, Google Workspace) og opfylder sikkerheds- og vedligeholdelseskrav. Et stigende antal virksomhedsplatforme som GitHub, Google Workspace og andre udgiver deres egne MCP-servere. Hvor der findes en produktionsklar, leverandørvedligeholdt server, skal du foretrække den frem for at opbygge en tilpasset. Evaluer for sikkerhedstilstand og vedligeholdelsesforpligtelse, før du anvender. |
Skitser
Sekvensdiagram for bekræftet kundeindsprøjtning
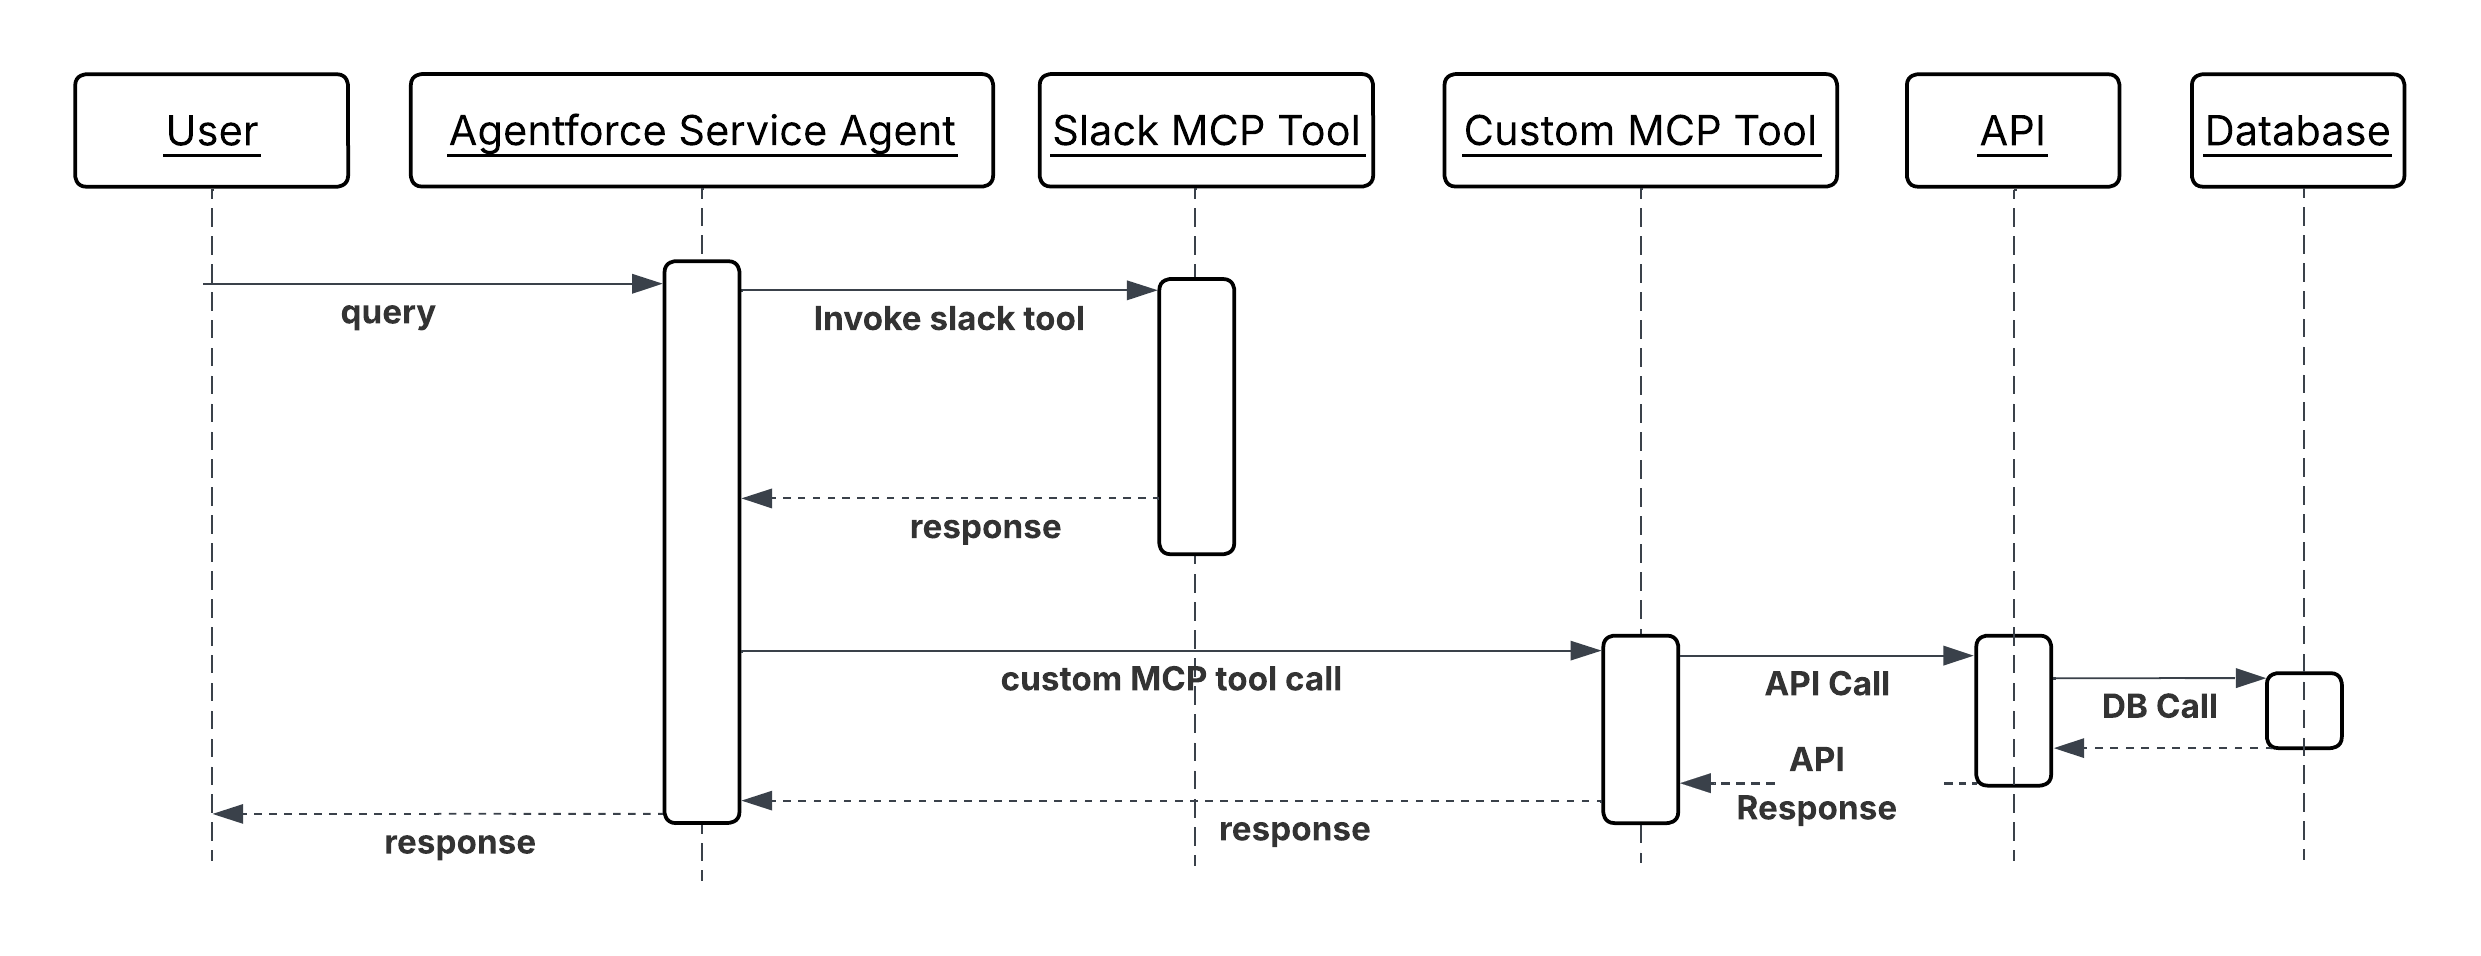
Resultater
Agentens tilgængelige område udvides uden at øge dens integrationskompleksitet. Tilføjelse af et nyt eksternt system betyder implementering eller konfiguration af en MCP-server for det og ikke skrivning af tilpassede Apex eller forløbsintegrationer pr. agent. Agentens argumenteringslag forbliver uændret. Det opdager og kalder de nye værktøjer baseret på deres semantiske beskrivelser alene.
MCP-standarden opretter også en tydelig adskillelse af ejerskab: teamet, der er ansvarlig for et system, viser dets funktioner som en MCP-server. Agentteamet forbruger disse funktioner uden at skulle forstå systemets interne funktioner. Denne grænse reducerer koordineringsoverhead, efterhånden som antallet af integrerede systemer vokser.
Værktøjskomponibilitet er et direkte resultat. Da alle værktøjer deler den samme kaldgrænseflade, kan agenten kæde værktøjer fra forskellige systemer, hente en fil fra Google Drive, udtrække data fra den og skrive resultatet til en CRM-registrering lige så naturligt som kædehandlinger i et system.
Design overvejelser
Platform-agnostisk vejledning
- Værktøjsbeskrivelser er agentens eneste basis til at beslutte, om og hvordan et værktøj skal kaldes. Skriv beskrivelser på et tydeligt hensigtsbaseret sprog, der angiver, hvad værktøjet gør, hvornår det anvendes, og hvad det returnerer. En beskrivelse, der siger “forespørger på CRM-databasen”, er mindre nyttig end “henter kontoens åbne sager, sorteret efter prioritet, for et givent konto-id”. Dårlige beskrivelser resulterer i dårligt værktøjsvalg.
- Tilpas hvert MCP-værktøj til en enkelt, atomisk funktionalitet. Et værktøj, der henter et dokument og også skriver et sammendrag tilbage til kildesystemet, er sværere for agenten at argumentere over, sværere at prøve igen ved fejl og sværere at sikre end to diskrete værktøjer. Et værktøj, et ansvar.
- Design værktøjer, så output er komponerbare input. Resultatet af et hentningsværktøj skal struktureres på en måde, der knytter sig naturligt til inputparametrene for de handlingsværktøjer, der typisk følger det, hvilket reducerer det transformationsarbejde, som agenten skal udføre mellem trin.
- Fjernværts-MCP-servere. Lokale binære installationer skaber implementerings- og versioneringskompleksitet, der vokser med antallet af agentmiljøer. En fjernstyret server kan opdateres uafhængigt af de agenter, der bruger den.
Implementeringsbemærkninger til Salesforce
- Hvis du ønsker ensartet MCP-godkendelse, frekvensgrænse, datavalideringer på tværs af alle udgående MCP-kald, skal du bruge AI-gateway som MuleSoft Omni Gateway, der understøtter MCP-servere, og konfigurere det, før du viser en MCP-server til agenter.
- Brug OAuth 2.0-legitimationsoplysninger til alle legitimationsoplysninger, der er påkrævet af MCP-serverforbindelser. Legitimationsoplysninger må ikke vises i værktøjsparametre, handlingskonfigurationer eller Apex.
- Nogle MCP-værktøjer kan have brug for slutbrugerlegitimationsoplysninger til at udføre nogle handlinger afhængigt af forretningsanvendelsessituationen (f.eks. overførsel af midler). Hvis du vil udbrede slutbrugeridentitetstokener, skal du bruge politikken OAuth 2.0 på vegne af legitimationsoplysninger, som aktuelt understøttes med MuleSoft Omni Gateway.
- For tilpassede MuleSoft MCP-servere: definer MCP-værktøjsskemaet i MuleSoft’s API-specifikation, og registrer serverens slutpunkt i Agentforce. Test værktøjsbeskrivelser op mod repræsentative agentforespørgsler for at bekræfte, at agenten vælger det rigtige værktøj til den rigtige opgave, før den implementeres i produktion.
Fejlhåndtering og gendannelse
- Når et MCP-værktøjskald returnerer en fejl, undersøger agenten den maskinlæsbare fejlkode for at bestemme den relevante gendannelseshandling: anmode om manglende parametre fra brugeren, prøve igen med korrigeret input eller eskalere til et menneske. Det forbruger aldrig fejl eller fortsætter med at argumentere, som om værktøjsopkaldet lykkedes.
- Agenten implementerer forsøgslogik for midlertidige fejl direkte.
- Logfør hvert MCP-værktøjskald fra klientsiden med værktøjsnavnet, de sanerede inputparametre og resultatet. Denne klientsidesporing kombineret med serversidelogfiler er den primære mekanisme til at diagnosticere, hvorfor en agent tog en bestemt handlingssti, når et arbejdsflow ikke producerer det forventede resultat.
Sikkerhedsovervejelser
- Alle udgående MCP-serverforbindelser passerer gennem gatewayen. Gatewayen håndhæver godkendelsesbekræftelse, frekvensbegrænsning for at forhindre værktøjsmisbrug og datainspektion for at registrere forsøg på promptinjektion i værktøjsparametre. Direkte, ikke-medierede forbindelser fra agenter til MCP-servere tilsidesætter disse kontroller og er ikke tilladt.
- Tilpas hver agents MCP-serverforbindelser til kun de servere, hvis værktøjer den pågældende agent faktisk kræver. En agent, der er konfigureret med adgang til alle tilgængelige MCP-servere, har en større angrebsoverflade end en, der kun er tilsluttet de værktøjer, som dens definerede opgaver kræver.
- Valider og saner værktøjsinputparametre, før du overfører dem til værktøjet, især når parameterværdier afledes fra brugerangivet tekst eller LLM-genereret indhold. Overfør ikke ikke-valideret LLM-output direkte som værktøjsparametre. En angriber, der kan påvirke agentens argumentation, kan bruge denne sti til at indsætte ondsindede værdier i downstream-systemkald.
- Behandl agentens liste over tilsluttede MCP-servere og deres værktøjsopgørelser som en følsom konfiguration. En angriber, der ved, hvilke værktøjer en agent har tilgængelige, og hvilke parametre vedkommende accepterer, har et kort til oprettelse af promptinjektionsdata, der er designet til at misbruge disse værktøjer.
Eksempel
En salgsagent forbereder en omfattende kontoundersøgelse før et kundeopkald af høj værdi:
- Agenten modtager anmodningen: “Forbered en orientering om Acme Corp før fornyelsesdiskussionen i morgen.”
- Agenten forespørger på MCP-værktøjskataloget og identificerer tre relevante værktøjer på tværs af to MCP-servere:
GetRecentEmails,GetOpenOpportunitiesogGetSupportTicketSummary. - Agenten kalder alle tre værktøjer parallelt. Hver MCP-server oversætter kaldet til dets målsystems oprindelige API, henter de relevante data og returnerer et struktureret resultat.
- Agenten modtager de tre resultater. Seneste mailtråde, den åbne fornyelsesmulighed med handelsstørrelse og fase og et sammendrag af åbne supportbilletter efter prioritet, og syntetiserer dem til en struktureret kontooversigt.
- Agenten kalder
CreateAccountNotefor at gemme briefingen i kontoregistreringen og returnerer et sammendrag til den anmodende bruger. - Alle fire MCP-værktøjskald logføres af gatewayen med værktøjsnavne, serveridentiteter og resultater for sessionsrevisionsregistreringen.
Kontekst
Det udgående MCP-mønster beskriver en Agentforce-agent, der bruger værktøjer fra eksterne MCP-servere. Det indgående mønster inverterer dette. Salesforce Platform-funktioner som CRM-registreringer, forløb, Apex og Data 360-indsigter vises som MCP-værktøjer, som eksterne agenter, der kører på enhver LLM-struktur, kan finde og kalde.
Dette mønster betyder noget, fordi virksomheds-AI-implementeringer sjældent er enkelt udbyder. En partners agent, der bygger på en anden struktur, skal muligvis slå en kundes kontostatus op i Salesforce. Et internt datavidenskabsteam, der kører en Python-baseret agent, skal muligvis udløse et Salesforce-forløb for at starte en godkendelsesproces. Uden en standardiseret eksponeringsmekanisme kræver hver ekstern forbruger en skræddersyet integration. Visning af Salesforce-funktioner som en MCP-server giver hver MCP-kompatibel agent en ensartet, opdagelig grænseflade til platformens værktøjer, uanset hvordan opkaldsagenten er bygget.
En partners indkøbsagent, der bygger på en tredjepartsstruktur, skal f.eks. bekræfte en leverandørs kontraktstatus i Salesforce, før den godkender en købsbestilling. I stedet for at opbygge en direkte REST-integration kalder den et GetContractStatus på Salesforce MCP-serveren. Værktøjet håndhæver de samme adgangskontroller som enhver indbygget Salesforce-handling. Den kaldende agent ser kun resultatet.
Problem
Når en ekstern agent, der bygger på en anden struktur, ejes af en partner eller på anden måde kører uden for Salesforce-platformen, har brug for at kalde Salesforce-funktioner som en del af sit eget arbejdsflow, hvordan kan disse funktioner vises på en standardiseret, opdagelig og sikkert administreret måde, der ikke kræver en tilpasset integration pr. ekstern forbruger?
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål:
- Er de eksterne agenter, der skal bruge Salesforce-funktioner, bygget på strukturer, der understøtter MCP-standarden? Hvis ikke, kan en REST API eller en webhook-tilgang være mere relevant end MCP.
- Hvilke Salesforce-funktioner skal vises - skrivebeskyttet hentning af data, skrivehandlinger, forløbskald eller en kombination? Omfanget af eksponering bestemmer direkte det sikkerhedsområde, der skal styres.
- Hvordan skal identiteten af den eksterne opkaldsagent bekræftes, og hvilke Salesforce-tilladelser skal dens kald køre under? Agent-til-platform-kald må ikke overtage bredere tilladelser, end den specifikke handling kræver.
- Er Salesforce MCP-serveren beregnet til interne forbrugere (andre teams agenter i samme organisation) eller eksterne forbrugere (partner- og kundeagenter)? Trust og godkendelseskravene varierer væsentligt mellem disse målgrupper.
- Hvordan vil sættet af viste værktøjer udvikle sig over tid? Nye Salesforce-funktioner, der føjes til MCP-serveren, bliver straks tilgængelige for alle tilsluttede agenter. Utilsigtet værktøjseksponering skal styres gennem en bevidst udgivelsesproces.
Salesforce-mønsterapplikation
| Løsning | Tilpas | Kommentarer |
|---|---|---|
| Salesforce som MCP-server (oprindelig) | Bedst til visning af Salesforce-funktioner fra førstepart | Bruges, når de værktøjer, der skal vises, er tilknyttet direkte til eksisterende Salesforce Platform-handlinger, og de kaldende agenter er MCP-kompatible. Salesforce Headless 360’s oprindelige MCP-serverfunktionalitet tillader platformshandlinger som registreringsforespørgsler, forløbskald og Apex at blive erklæret som MCP-værktøjer og vist til enhver MCP-kompatibel ekstern agent. Adgang styres af Salesforce-tilladelsesmodellen. Bemærk, at disse Headless 360 MCP-servere kun kan åbnes med slutbrugerlegitimationsoplysninger i øjeblikket. |
| MuleSoft som MCP-serverfacade | Bedst, når der kræves transformation eller multi-system-aggregering | Bruges, når den kaldende agent har brug for en funktion, der kræver data fra mere end et Salesforce-objekt, transformation før levering eller sammensætning med data fra andre systemer. MCP-grænsefladen forbliver ren og enkel. Kompleksiteten absorberes af MuleSoft. Et MuleSoft MCP-lag sidder foran Salesforce og viser det aggregerede resultat af flere platformshandlinger som et enkelt MCP-værktøj. Denne løsning kan også bruges af agenter, hvor slutbrugeridentiteten ikke kan udbredes til Salesforce-godkendelse og autorisation. Hvis Agentforce Agenter f.eks. har brug for MCP-servere med systemlegitimationsoplysninger, skal vi være afhængige af tilpassede MCP-servere som en, der er bygget med og hostet på MuleSoft. |
Skitser
Sekvensdiagram for forretningsfunktioner som kaldbart værktøj
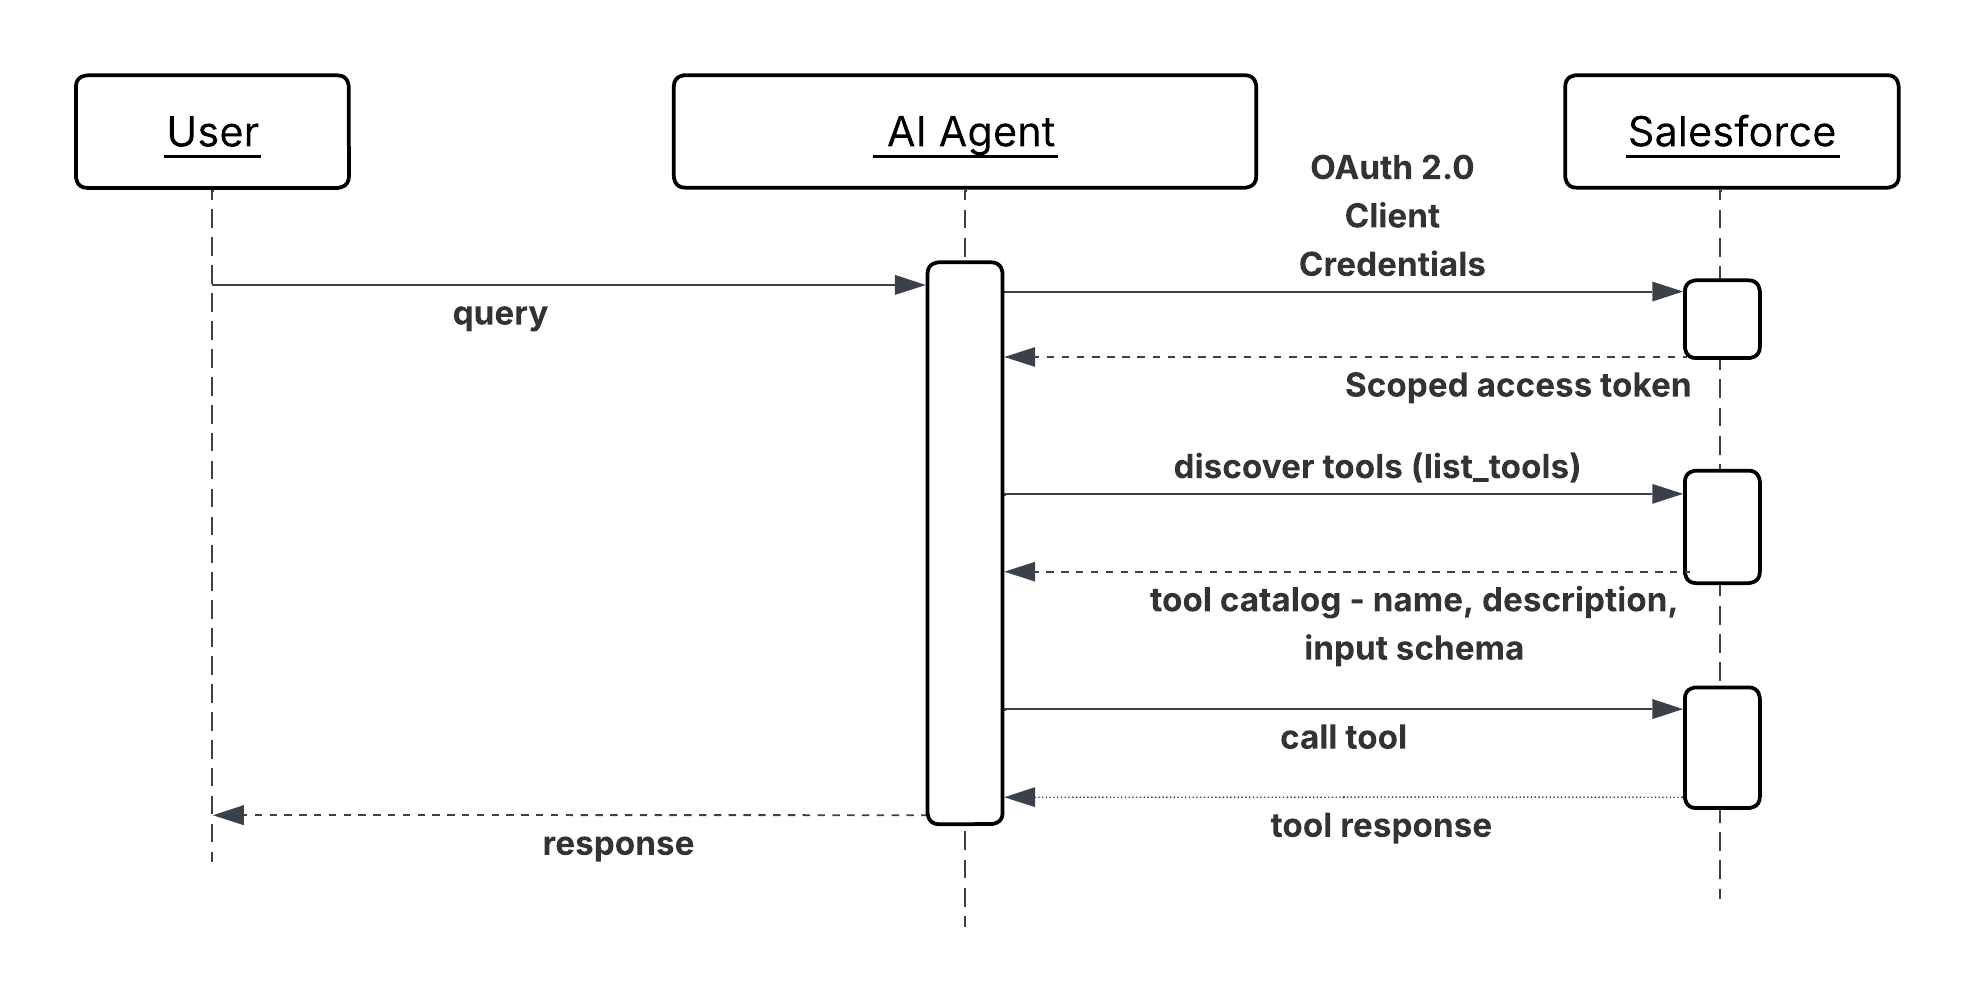
Resultater
Salesforce bliver en førsteklasses deltager i multi-vendor-agentøkosystemer. Eksterne agenter kan finde og forbruge platformsfunktioner uden at kræve en tilpasset REST-integration pr. forbruger eller pr. anvendelsessituation. Antallet af forbrugere kan vokse uden proportional vækst i integrationsvedligeholdelsesoverhead.
Med Headless 360 styrer Salesforce-tilladelsesmodellen hver indgående værktøjskald. Eksterne MCP-klienter tilsidesætter ikke eksisterende dataadgangskontroller. De fungerer i dem. Dette betyder, at sikkerhedstilstanden for visning af funktioner via MCP svarer til visning af dem via enhver anden godkendt API-overflade.
Værktøjsdækbarhed er en sammensat fordel. Når nye Salesforce-funktioner føjes til MCP-serverens værktøjskatalog, bliver de straks tilgængelige for alle tilsluttede eksterne agenter uden at kræve, at disse agenter opdaterer deres konfigurationer.
Design overvejelser
Platform-agnostisk vejledning
- Udgiv kun det, som eksterne agenter har brug for. Hvert værktøj, der føjes til MCP-serverens katalog, udvider angrebsområdet og styringsbelastningen. Overvåg værktøjslageret med vilje. Definer, hvilke funktioner der godkendes til ekstern forbrug, og behandl ikke-godkendt eksponering som et konfigurationsmangel, ikke en standard.
- Skriv værktøjsbeskrivelser for eksterne forbrugere. En ekstern agents operatør har ingen Knowledge om din interne datamodel eller navngivningskonventioner. Bevar beskrivelser selvstændige: hvad værktøjet gør, hvad hver parameter betyder, hvad resultatet repræsenterer, og eventuelle begrænsninger eller forudsætninger, som opkalderen skal opfylde.
- Versionsværktøjer eksplicit, når deres input- eller outputskemaer ændres. En ekstern agent, der er afhængig af et værktøjs aktuelle skema, vil afbryde i stilhed, hvis skemaet ændres uden varsel. Håndter afbrydelse af ændringer til et MCP-værktøjs grænseflade med den samme disciplin som en afbrydelse af ændringer til en offentlig REST API.
Implementeringsbemærkninger til Salesforce
- Kør hver indgående Salesforce OOTB-værktøjskald (Headless 360) under en slutbruger, hvis tilladelser er tilpasset til kun de handlinger, som de viste værktøjer kræver. Kør ikke indgående agentopkald under en administratoridentitet med høj rettigheder.
- Hvis du vil anvende godkendelse, vurderingsbegrænsning, skemavalidering og PII-registrering ensartet på tværs af alle MCP-værktøjer, skal du bruge AI-gateway som MuleSoft Omni Gateway.
- For MuleSoft MCP-facader skal du definere MCP-værktøjsskemaet i MuleSoft uafhængigt af det underliggende Salesforce API-skema. MCP-grænsefladen skal afspejle den opkaldende agents konceptuelle behov og ikke formen på det Salesforce-objekt, der understøtter det. Denne afkobling gør det muligt for Salesforce-implementeringen at udvikle sig uden at bryde den eksterne værktøjskontrakt.
Fejlhåndtering og gendannelse
- Fejl ved værktøjskald skal returnere strukturerede MCP-fejlsvar med en maskinlæsbar kode og en beskrivelse på almindeligt sprog. Den kaldende eksterne agent har ingen indsigt i Salesforce-platformens interne oplysninger, ligesom fejlmeddelelser skal være selvstændige og kan handles på uden at kræve Knowledge af Salesforce-specifikke fejlkoder eller objektmodeller.
- Vurderingsbegrænsningsfejl og godkendelsesfejl skal returneres hurtigt med nok oplysninger, så den eksterne agents operator kan diagnosticere og afhjælpe, hvilken frekvensgrænse der blev nået, eller hvilke legitimationsoplysninger der blev afvist uden at vise interne konfigurationsdetaljer.
- Registrer alle indgående MCP-værktøjskald på Omni Gateway med den opkaldende agents identitet, det kaldte værktøj, inputparametrene (saniseret af følsomme værdier) og resultatet. Denne logfil er det primære bevisspor til diagnosticering af fejl, der er rapporteret af eksterne forbrugere, og til revision af, hvad eksterne agenter har adgang til.
Sikkerhedsovervejelser
- Hver indgående MCP-forbindelse skal godkendes, før ethvert værktøj kan nås. Tillad ikke ikke-godkendt udforskning af værktøjskataloget. Listen over viste funktioner er i sig selv følsomme oplysninger.
- Anvend godkendelse på værktøjsniveau i tillæg til godkendelse på forbindelsesniveau. En registreret ekstern agent skal kun kunne kalde de specifikke værktøjer, som den eksplicit har fået adgang til, ikke det fulde katalog. Håndhæv dette ved gatewayen, ikke på applikationslaget.
- Valider og saniter alle indgående værktøjsparametre, før du overfører dem til Salesforce Platform-handlinger. Parametre fra eksterne agenter er en usikret inputoverflade – en ondsindet udarbejdet parameter kan forsøge at tilsidesætte forespørgselsfiltre, indsætte SOQL-fragmenter (Salesforce Object Query Language) eller påvirke forløbsvariabler. Valider type, format og område ved MCP-serveren eller facadegrænsen.
- Udfør en regelmæssig adgangsgennemgang af registrerede eksterne forbrugere. Tilbagekald legitimationsoplysninger for agenter, der ikke længere er aktive, eller hvis adgangsområde er ændret. En inaktiv, men gyldig legitimationsoplysning for en deaktiveret partnerintegration er en unødvendig permanent risiko.
- Beskyt dig mod at overtræde platformsbegrænsninger ved at begrænse frekvensen for indgående MCP-meddelelser i gatewayen. Begræns trafikken for ikke-kritiske agenter under indlæsning ved brug af SLA-baserede niveaupolitikker.
Eksempel
En indkøbsagent, der administreres af en logistikpartner, skal bekræfte en leverandørs kontrakt og kreditstatus, før den godkender en købsbestilling af høj værdi:
- Partnerens agent godkendes til gatewayen ved brug af dens registrerede OAuth 2.0-klientlegitimationsoplysninger og modtager et omfangsrigt adgangstoken.
- Agenten forespørger på Salesforce MCP-servers værktøjskatalog og identificerer to relevante værktøjer:
GetSupplierContractStatusogGetAccountCreditSummary. - Agenten kalder
GetSupplierContractStatusmed leverandørens id. MCP-serveren oversætter dette til en Salesforce-registreringsforespørgsel, anvender integrationsbrugerens sikkerhed på feltniveau og returnerer kontraktens aktuelle status, udløbsdato og eventuelle markerede overholdelsesholdninger. - Agenten kalder
GetAccountCreditSummary, som distribuerer gennem MuleSoft MCP-facaden. Facaden aggregerer leverandørens udestående fakturasaldo og betalingshistorik fra to Salesforce-objekter og returnerer et enkelt sammensat kreditsammendrag. - Med begge resultater bestemmer partnerens agent, at kontrakten er aktiv, og at kreditpositionen er inden for acceptable grænser og godkender købsbestillingen i sit eget system.
- Begge værktøjskald logføres af gatewayen med partneragentens identitet, de kaldte værktøjer og resultaterne, der opretter en revisionsbar registrering af, hvilken ekstern adgang der blev tildelt, og hvilke data der blev returneret.
Kontekst
Virksomhedssystemer er nu afhængige af samarbejdsagentudbredelser eller netværk, hvor komplekse anmodninger nedbrydes og uddelegeres til specialiserede agenter på tværs af forskellige domæner eller leverandørplatforme. Disse agenter, der hver især har deres egen rolle, funktioner og værktøjer, skal bruge en standardiseret, sikker kommunikationsmetode til at koordinere mod delte mål uden at kræve menneskelig intervention på hvert trin.
Problem
Hvordan kan en tilkaldende AI-agent dynamisk finde, interagere sikkert med og uddelegere komplekse eller domænespecifikke opgaver til en fjernpeer-agent, der kan være bygget på en anden struktur eller drevet af en anden leverandør og modtage strukturerede resultater for at fuldføre et større virksomhedsarbejdsflow?
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål:
- Hvordan interagerer agenter, der er udviklet ved brug af forskellige strukturer eller fungerer på tværs af enkeltstående applikationslokaliteter?
- Hvordan kan agenter samarbejde og uddelegere opgaver uden at vise deres interne logik, hukommelse eller egne værktøjer?
- Hvordan understøtter agenter komplekse, langsigtede opgaver, mens de leverer opdateringer i realtid, streaming og push-adviseringer?
- Hvordan håndhæver agenter sikkerhed på virksomhedsniveau (godkendelse, autorisation) og politikoverholdelse for krydsagentkommunikation?
- Hvordan håndterer agenter strukturerede opgavearbejdsflows (initiering, status, fuldførelse), der går ud over enkle API-kald?
Salesforce-mønsterapplikation
A2A-protokollen er en åben standard, der gør det muligt for agenter at finde, uddelegere til og samarbejde med andre agenter som ligestillede. Det giver agenter et fælles sprog til at udveksle oplysninger sikkert og koordinere handlinger på tværs af forskellige platforme og leverandører. A2A fokuserer på peer-to-peer-kommunikation, der supplerer MCP, som fokuserer på at tilslutte agenter til værktøjer og API’er.
| Løsning | Tilpas | Kommentarer |
|---|---|---|
| Single-Org Multi-Agent Orchestration (SOMA) | Bedst, når alle domæneagenter er i en organisation, og der ikke kræves nogen krydsudbyderdistribution | En superagent (orkestrator) nedbryder anmodninger og distribuerer til op til ~ 7 tilsluttede underagenter ved brug af LLM-baseret distribution (Atlas Reasoning Engine læser underagentbeskrivelser) eller deterministisk distribution (Agentscript). Dette er det anbefalede standardmønster, før du når til A2A. Understøttede kombinationer: Agentforce Serviceagent→Agentforce Serviceagent Agentforce Medarbejder Agent→Agentforce Medarbejder Agent Agent Agentforce Medarbejder Agent→Agentforce Serviceagent Det er kun orkestratoren, der kan eskalere til et menneske. Underagenter kan ikke. |
| Orkestrator-ledet delegation med flere agenter | Bedst til komplekse arbejdsflows, der kræver flere specialiserede agenter | Bruges, når arbejdsflowet strækker sig over flere domæner, f.eks. indkøb, bekræftelse og godkendelse, hver ejet af en anden agent. En orkestreringsagent nedbryder anmodningen på topniveau og uddelegerer underopgaver til to eller flere ligestillede agenter i rækkefølge eller parallelt. Hver ligestillet agent kører sin specialdomænefunktion og returnerer en artefakt. Orkestrator aggregerer resultaterne og kører det næste trin. |
Skitser
Arkitekturen involverer en opkaldsagent, der starter kommunikation, faciliteret af et agentkatalog/registrering til opdagelse:
Sekvensdiagram for krydsagentdelegation
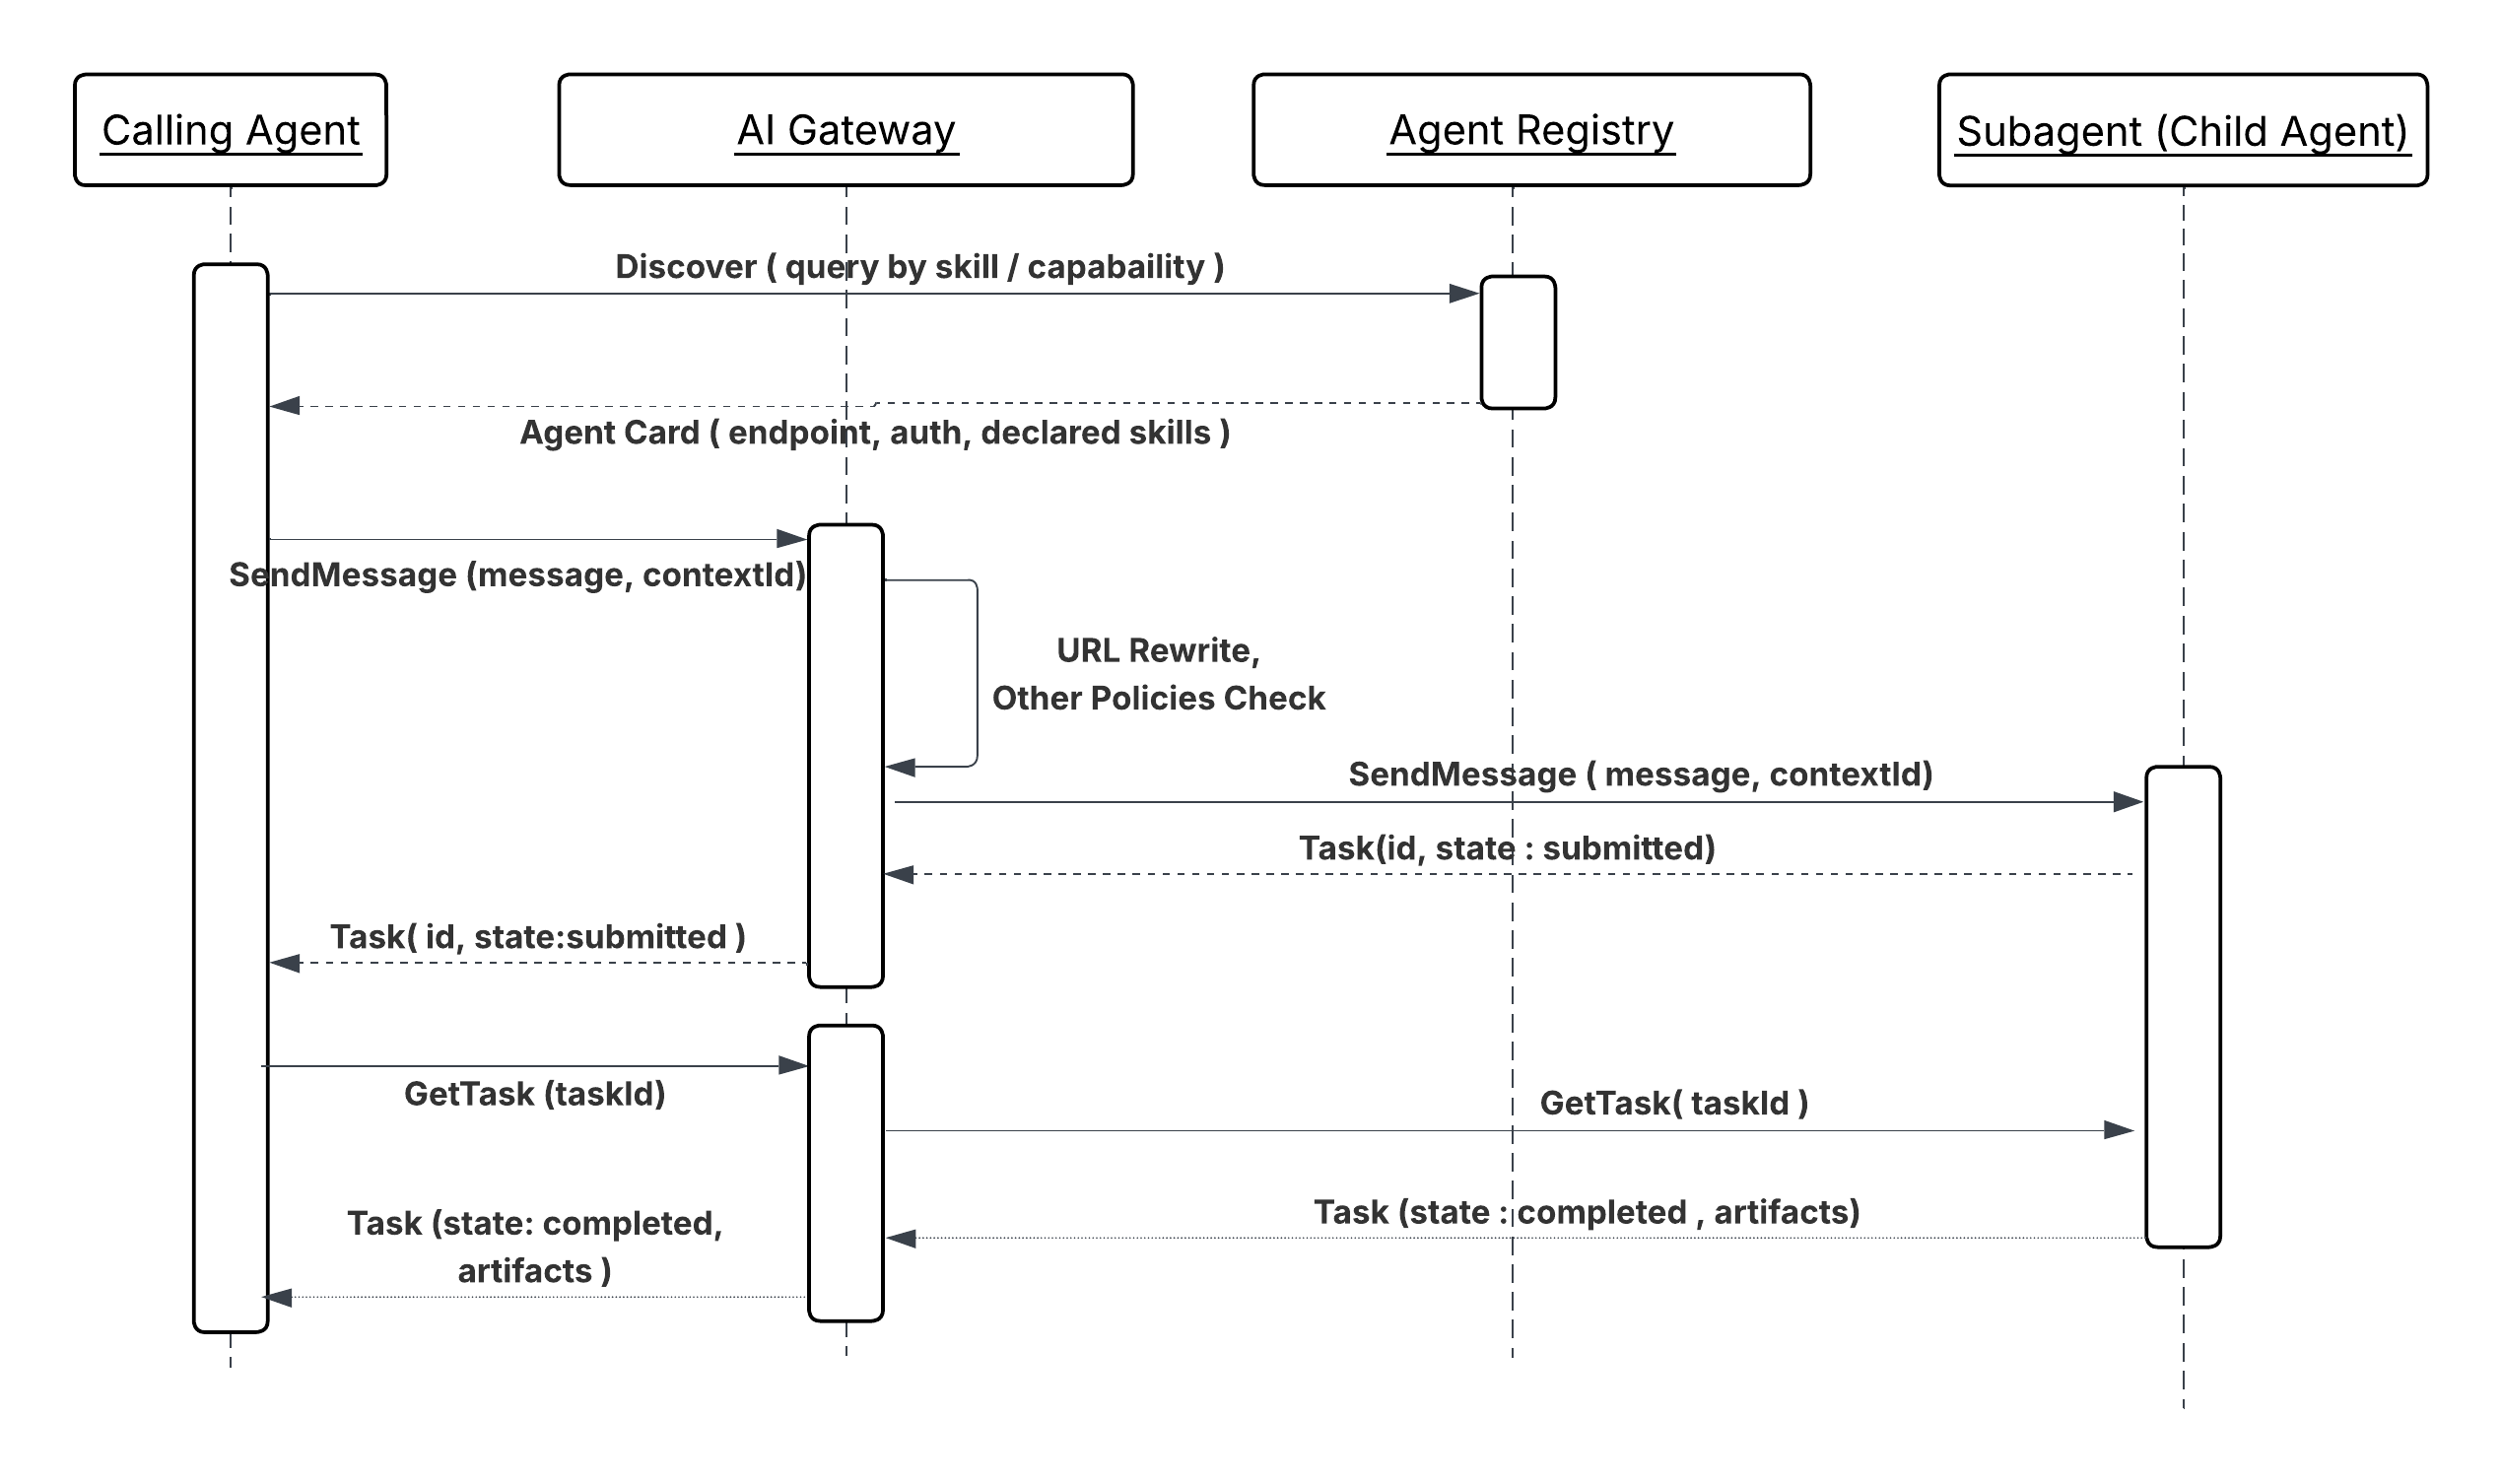
Ligestillet agent behandler anmodningen ved brug af dens domænespecifikke logik, hukommelse og værktøjer og returnerer derefter strukturerede resultater til den kaldende agent.
Resultater
A2A-delegation adskiller domæneejerskab fra arbejdsfloworkestrering. Den kaldende agent behøver ikke vide, hvordan peer-agenten er bygget, hvilken platform den kører på, eller hvilke værktøjer den bruger internt. Den uddelegerer en opgave og modtager en struktureret artefakt. Denne grænse betyder, at en specialiseret agent (baggrundsbekræftelse, finansiel risikoscoring, logistisk distribution) kan udvikles, implementeres og forbedres uafhængigt af de arbejdsflows, der kalder den.
Protokolens opgavelivscyklusmodel (sendt, arbejdet, fuldført, mislykkedes) understøtter
lange kørselshandlinger som standard. Den kaldende agent kan registrere sig til statsopdateringer i stedet for
end at holde en blokerende forbindelse, hvilket betyder, at A2A-opgaver kan strække sig over minutter eller timer
uden at kræve, at orkestreringsagenten forbliver aktiv gennem tiden.
Design overvejelser
Platform-agnostisk vejledning
- I komplekse scenarier kan en agentbroker fungere som en intelligent distributionstjeneste eller et “smart omskiftertavle” til at koordinere opgavedelegering på tværs af specialiserede agenter og administrere processer med flere trin.
- Da A2A understøtter langsigtede opgaver, skal kommunikationen være orienteret mod opgavefuldførelse, definere en livscyklus for opgaveobjektet og levere opdateringer og adviseringer i realtid.
- Protokollen er designet til at understøtte forskellige indholdstyper, herunder tekst, filer, strukturerede data, lyd og video streaming.
- Relationerne og afhængighederne mellem agenter og deres funktioner er deklarativt defineret i en konfigurationsfil (f.eks. “agent-network.yaml”) og udgivet til agentregistreringen.
Implementeringsbemærkninger til Salesforce
- For effektiv SOMA-orkestrering skal du holde tilsluttede underagenter under 7 for at bevare distributionskvaliteten.
- På nuværende tidspunkt understøttes kun det enkelte delegationslag (superagent → underagent). Dybere kæder overfører forsinkelse til en “uholdbar sats”. På nuværende tidspunkt kan underagenter ikke uddelegere til andre tilsluttede underagenter.
- Overførsel af person understøttes kun på orkesterniveau. Underagenter kan ikke eskalere.
- I SOMA skal du bruge agentscript, når LLM-baseret distribution producerer fejlretning på tvetydige input for deterministisk distribution. Agentsscript aktiverer organiseret delt kontekst mellem agenter.
Fejlhåndtering og gendannelse
A2A-protokollen definerer omfattende fejlkoder for at lette robust fejlfinding og fejlstyring.
- Recovery Logic: Agenter skal indarbejde forsøgspolitikker (forsøg), overførselslogik til alternative agenter og eksplicitte timeouts.
- Opgavestatussporing: Opgavestyringsarbejdsflowet sikrer, at agenter kan forblive synkroniseret med den seneste status for en opgave, hvilket gør det nemmere at gendanne i tilfælde af afbrydelse.
- Observation: Registrering af interaktionsdetaljer, f.eks. forsinkelse, succesfrekvenser og fejlfrekvenser, er afgørende for overvågning af kvalitet og fejlfinding.
Sikkerhedsovervejelser
- Enhedsgodkendelse: A2A er designet til at overholde godkendelses- og autorisationsstandarder på virksomhedsniveau, f.eks. OAuth 2.0 og JWT, der ofte administreres af eksterne platforme som Okta.
- Gateway til at beskytte A2A: En gateway (f.eks. MuleSoft Omni Gateway) er vigtig for at håndhæve politikker på al A2A-kommunikation, der fungerer som både en indgangs- og udgangsgateway for at beskytte agenter og kontrollere udgående trafik til eksterne agenter og tjenester.
- Polic Enforcement: Agentkort-genskrivning, skemavalidering, Spike Control, PII-registrering og andre politikker skal anvendes for A2A-server og databeskyttelse.
Eksempel
Kandidatindkøbsarbejdsflow
En ansættelsesmanager opgiver sin centrale orkestreringsagent til at finde kandidater, der matcher en jobliste og et færdighedssæt.
- Udforskning: Orkestreringsagenten forespørger på agentregistreringen og finder en specialiseret rekrutteringsagent og en baggrundscheckagent (både ligestillede agenter).
- Delegation (A2A): Orkestreringsagenten sender en struktureret opgaveanmodning (A2A-meddelelse) til den rekrutterende agent for at hente kandidater.
- Peer-behandling: Den rekrutterende agent eksekverer sit eget arbejdsflow (f.eks. kald af et eksternt LinkedIn-værktøj via MCP).
- Artifaktreturnering (A2A): Den rekrutterende agent returnerer en liste over foreslåede kandidater (artifakten).
- Sequential Delegation: Orkestreringsagenten uddelegerer derefter en anden opgave (A2A) til agenten for baggrundscheck for den øverste kandidat. Denne agent foretager kontrollen og returnerer resultatet og fuldfører den generelle opgave.
Kontekst
Komplekse virksomhedsarbejdsflows kræver ofte, at specialiserede agenter, der hostes på eksterne platforme eller partnersystemer, starter opgaver, uddelegerer forespørgsler eller leverer opdateringer til interne agenter (f.eks. dem på Salesforce-platformen). Dette mønster håndterer, hvordan en intern Agentforce på en sikker og pålidelig måde modtager og behandler anmodninger fra en fjern, ligestillet agent for at køre en domænespecifik funktionalitet.
Problem
Hvordan kan en intern specialiseret AI-agent (f.eks. en baggrundskontrolagent på Agentforce) vise sin domænespecifikke funktionalitet sikkert for eksterne ligestillede agenter, behandle en indgående struktureret A2A-anmodning og administrere opgavelivscyklussen (herunder statusopdateringer i realtid) for at returnere strukturerede artefakter til fjernopkaldsagenten?
Kræfter
Når du anvender dette mønster, skal du besvare følgende spørgsmål:
- Hvordan viser du interne agentfunktioner sikkert for eksterne agenter uden at kompromittere intern logik eller værktøjer?
- Hvordan håndhæver du sikkerhedspolitikker på virksomhedsniveau for at bekræfte den opkaldende agents identitet og uddelegerede autoritet, før du behandler anmodninger?
- Hvordan håndterer du indgående opgaver, der kører længe, mens du leverer strukturerede, asynkrone tilstandsopdateringer?
- Hvordan sikrer du problemfri interaktion med agenter, der bygger på forskellige eksterne strukturer?
Salesforce-mønsterapplikation
A2A-protokollen leverer den åbne standard til sikker peer-to-peer-uddelegering og samarbejde. Den interne agent fungerer som ligestillet agent og annoncerer sine funktioner gennem et agentkatalog/registrering og bruger A2A over sikre kanaler (HTTPS/SSE) til at modtage og besvare strukturerede anmodninger.
| Løsning | Tilpas | Kommentarer |
|---|---|---|
| Agentforce underagent (SOMA) | Bedst, når den kaldende agent er en anden Agentforce i den samme organisation | Bruges, når begge agenter bor i den samme Salesforce-organisation, og opkalderen er en Agentforce. Agenten forbindes som en underagent via Agentforce Builder og udsættes for orkestratorens beskrivelse og erklærede handlinger. Orkestrator distribuerer opgaver ved brug af LLM-baseret distribution (Atlas Reasoning Engine) eller deterministisk distribution (Agentscript). Der kræves ingen A2A-protokol, gateway eller ekstern registrering. Understøttede kombinationer: Agentforce Serviceagent→Agentforce Serviceagent Agentforce Medarbejder Agent→Agentforce Medarbejder Agent Agentforce Medarbejder Agent→Agentforce Serviceagent Kun orkestrator kan eskalere til et menneske, underagenter kan ikke. |
| Agentbrokerdistribution (indgående) | Bedst, når organisationen er vært for flere Agentforce-agenter med supplerende funktioner, og opkaldsagenten ikke kan eller skal ikke vælge et specifikt mål | Bruges, når den opkaldende agent er ekstern til Salesforce eller en anden Salesforce-organisation, og du ikke behøver at vide, hvilken specifik intern agent (Agentforce eller andre leverandøragenter) der håndterer anmodningen. En MuleSoft-agentbroker findes mellem MuleSoft Omni Gateway og puljen af interne Agentforce. Den modtager den indgående A2A-opgave, evaluerer de erklærede funktioner for tilgængelige interne agenter op mod opgavens krav og distribuerer anmodningen til den agent, der passer bedst. Brokeren håndterer også overførselsfejl, hvis den primære målagent er utilgængelig eller returnerer en fejl, omdirigerer brokeren til en ækvivalent agent uden at vise forsøg på det eksterne opkald. Det eksterne opkald er aldrig klar over interne distributionsbeslutninger eller forsøg på det. |
Skitser
Sekvensdiagram for agenter som tjenester, der kan kaldes
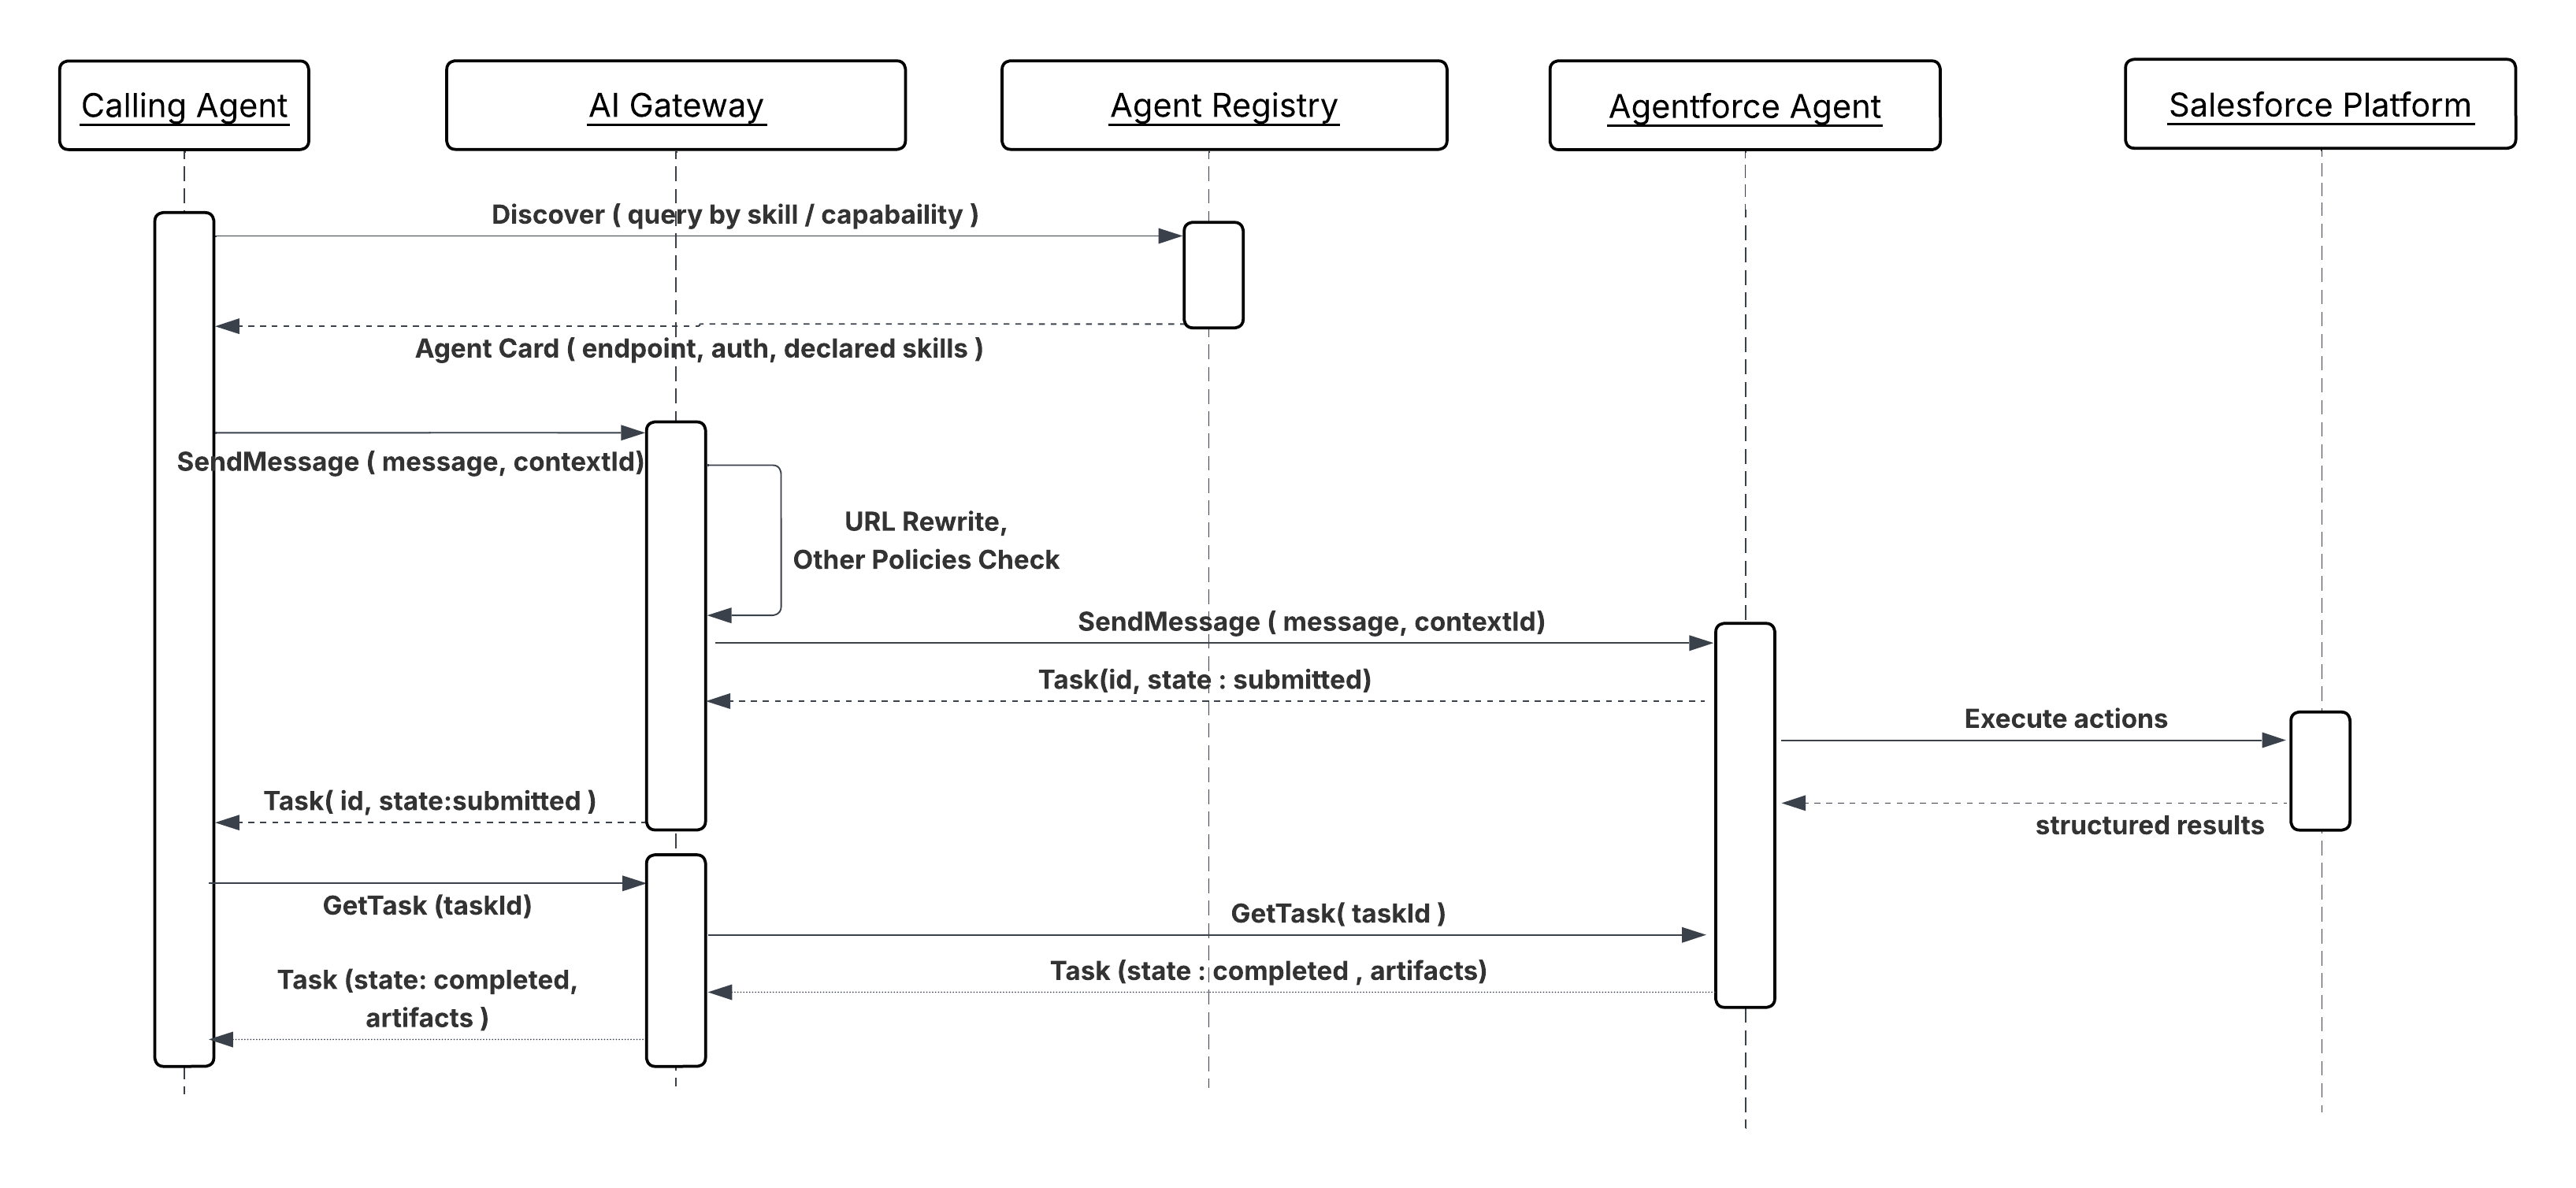
Resultater
Dette mønster viser interne agenter som specialiserede tjenester i et multiagentnetværk. Eksterne agenter kan uddelegere opgaver sikkert til interne funktioner, mens organisationen vedligeholder kontrol, revisionsmulighed og policehåndhævelse.
Design overvejelser
Platform-agnostisk vejledning
- En gateway (f.eks. MuleSoft Omni Gateway) skal placeres som et indgangspunkt for at håndhæve politikker, herunder frekvensbegrænsning, godkendelse og validering af data, på alle indgående A2A-anmodninger.
- Interne agenter skal administrere tilstanden for opgaveobjektet fra ekstern initiering til fuldførelse, så de sikrer, at fjernopkaldsagenten modtager ensartede statusopdateringer, der kan bekræftes.
- Sørg for, at agentens udgivne funktioner på agentkortet er tydelige, hensigtsbaserede og inkluderer de nødvendige sikkerhedsomfang for uddelegering.
Fejlhåndtering og gendannelse
- Strukturerede fejlkoder: Ved fejl skal den interne agent returnere A2A-kompatible strukturerede fejlmeddelelser til den kaldende agent for at aktivere logik for fjernforsøg eller alternative overførselsfejlmekanismer.
- Idempotens: Agenten skal bekræfte, at eventuelle bivirkninger, der udløses af en genprøvet A2A-anmodning fra en ekstern agent (på grund af netværksafbrydelse eller gendannelse), er idempotente.
Sikkerhedsovervejelser
- Håndhævelse af indgående policer: Gatewayen skal håndhæve politikker for tilladelsesliste/blokering af eksterne agenter og validering af JWT/OAuth 2.0-tokener for at bekræfte den opkaldende agents identitet og uddelegerede autoritet.
- Input Sanitation: Valider og saniter alle indgående anmodningsdata for at reducere potentiel meddelelsesinjektion eller ondsindede dataangreb.
- Identitetsfordeling: Tilknyt den eksterne agents identitet og dens uddelegerede autoritet sikkert til interne sikkerhedskontekster (f.eks. Salesforce-brugerprofiler), før du udfører handlinger mod interne systemer.
Eksempel
Ekstern systemforespørgsel
- Anmodning: En rekrutteringsagent på et partnersystem sender en A2A-opgaveanmodning til en intern medarbejderbekræftelsesagent (peer agent) på Agentforce for at bekræfte en ny ansøgers ansættelsesstatus.
- Behandling: Medarbejderbekræftelsesagenten modtager anmodningen via gatewayen, bekræfter partneragentens legitimationsoplysninger, udfører dets interne arbejdsflow (f.eks. kald af et internt HR-system) og formaterer svaret.
- Svar: Ligestillet agent returnerer en struktureret A2A-artifakt (f.eks. ansættelsesstartdato og jobtitel) til fjernrekrutteringsagenten, som derefter fortsætter med sit eksterne arbejdsflow.
-
Gatway til beskyttelse af MCP’er, A2As og API’er
Der kræves en gateway som det enkelte håndhævelsespunkt for al agent-til-system- og system-til-agent-trafik.
-
Sikrede forbindelser: En gateway sikrer, at kun godkendte og autoriserede agenter interagerer med MCP-, A2A- og API-slutpunkter ved at begrænse adgang.
-
Gennemtvingede SLA’er: En gateway kan håndhæve frekvensgrænser og hjælpe organisationer med at opfylde ydeevnekrav og forhindre MCP- og A2A-serveroverbelastning.
-
Forenklet forvaltning: En gateway tilbyder centraliseret synlighed og kontrol over alle serverinteraktioner, hvilket forenkler agentaktivitetsstyring og overvågning.
-
Datakonsekvens og -beskyttelse: Politikker som skemavalidering, håndhæve dataoverensstemmelse og personligt identificerbare oplysninger kan beskytte følsomme oplysninger.
MueleSoft Omni Gateway
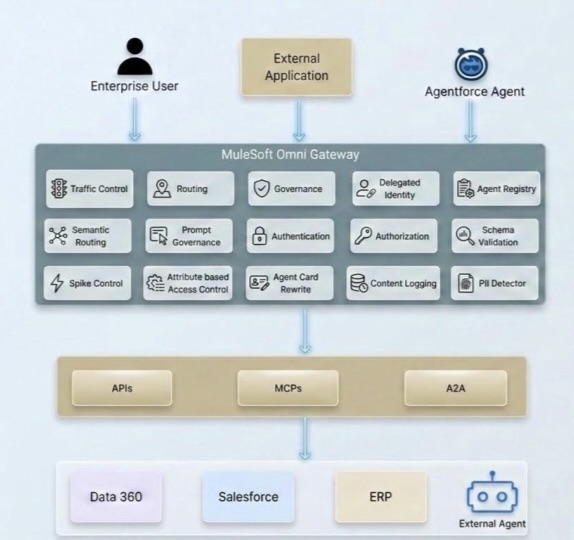
- Identity propagation chain
Efterhånden som virksomhederne anvender det agentmæssige paradigme, opstår der en ny sikkerhedsudfordring: Hvordan flyder slutbrugeridentitet gennem et netværk af autonome AI-agenter? I traditionelle API-arkitekturer godkendes en bruger en gang, og applikationen kalder backendtjenester på brugerens vegne. Identitetskæden er kort, velforstået og administreres typisk i et enkelt Trust.
Agentiske arkitekturer har dog meget længere kæder, hvor en enkelt anmodning udsendes på tværs af forskellige agenter, tjenester og MCP-servere, der hver potentielt krydser servicegrænser, Trust domæner og endda organisationsgrænser. Uden en bevidst strategi for udbredelse af identitet står virksomheder over for et valg mellem sikkerhed og funktionalitet – et dilemma, som ingen arkitekt skal håndtere.
MuleSoft håndterer kompleksiteten af identitetsudbredelse med sin funktion Trusted Agent Identity. Denne løsning bruger en politikbaseret, gatewayadministreret strategi til at sikre, at slutbrugeridentitet bevares på tværs af forskellige interaktionstyper, herunder A2A-protokoller, MCP-værktøjskald og REST API-anmodninger. Ved at centralisere identitetsstyring på Omni Gateway-laget gennem udgående godkendelsespolitikker kan virksomheder sikre hele deres agentnetværk uden at ændre backendtjenester eller agenter. Hvis du ønsker yderligere oplysninger, kan du se Trusted Agent Identity for te Agenttic Enterprise.
- RAG-sikkerhed i Data 360
Data 360 understøtter attributbaseret adgangskontrol (ABAC) på objekt-, felt- og rækkeniveau via indstillinger for datastyringspolitik. Dette er den primære måde at kontrollere, hvilke data der er synlige for hvem, herunder i RAG-søgeindekser. For strukturerede data implementeres brugeradgangsbetingelser ved brug af brugerattributter og tilladelsessæt. For ustrukturerede data kan metadatafiltrering (førfiltre på søgeindekser) begrænse, hvad der hentes.
Kommunikationen med LLM går gennem Einstein Trust Layer, som maskerer fortrolige / PII-oplysninger, før den når modellen, der beskytter datafortrolighed, ikke kun under søgning, men også før generering.
Hvis du vil beskytte mod RAG-forgiftning, skal du sørge for, at der anvendes strenge dataadministrations- og valideringsregler, før data bliver tilgængelige for vektorsøgning. Einstein Trust Layer kan også håndhæve meddelelsesmaskering/toksicitetskontroller. Du kan anvende strenge tilladelsessæt på agentbrugerprofilen.
- Ny model til navngivne legitimationsoplysninger Salesforce har forbedret sin godkendelsesarkitektur ved at introducere en model med navngivne legitimationsoplysninger på to niveauer, der tydeligt adskiller problemer mellem forbindelser og identitet. Brug dette, når du foretager udkald gennem Apex, og undgå at oprette din egen godkendelsesprotokol. Denne model giver også udvidelighed og forbedret sikkerhed. Eksterne legitimationsoplysninger er grundlaget for denne model. De lagrer de faktiske godkendelsesdetaljer og understøtter et avanceret sæt af protokoller, herunder OAuth 2.0-klientlegitimationsoplysninger, JWT Bearer og AWS Signature V4, mens de også definerer, hvordan kontoer tilknyttes: enten som et enkelt navngivet konto (delt på tværs af alle brugere) eller som Pr. bruger-kontoer (hvor hver bruger godkender med sin egen identitet). Navngivne legitimationsoplysninger fungerer til gengæld som slutpunktslaget. De definerer udkalds-URL’en og refererer til en ekstern legitimationsoplysning for at håndtere godkendelseshandshaken, og bevarer slutpunktskonfigurationen rent frakoblet fra legitimationsoplysningsstyring. Hvis du vil aktivere pr. bruger-godkendelsesforløb, skal administratorer tilknytte tilladelsessæt til den relevante eksterne legitimationsoplysningskonstant, så kun brugere med den rigtige tilladelsessættildeling kan kalde udkald under deres egen identitet. Dette design på to niveauer forenkler ikke kun sikker udkaldskonfiguration, men giver også arkitekter meget større fleksibilitet og styringskontrol over, hvordan integrationer godkendes på tværs af Salesforce-tilsluttede systemer. Hvis du ønsker flere oplysninger, kan du se dokumentationen til navngivne legitimationsoplysninger.
Dette afsnit knytter arkitekturens datahåndteringsmønstre til de overensstemmelsesforpligtelser, der oftest opstår i regulerede virksomhedsimplementeringer.
Adgangskontrol: Brugermodellen for integration med mindst rettigheder, der er beskrevet i hele integrationsmønstrene (omfangsnavngivne legitimationsoplysninger, OAuth 2.0-omfang pr. agent, gateway-tilladelseslister) tilknyttes direkte til logiske adgangskontroller. Vedligehold beviser for, at hver agents legitimationsoplysningsomfang er gennemset og godkendt.
Auditlogføring: Krav til pr. mønster-revisionslogføring (sessions-id, værktøjskald, inputparametre, der er saneret af følsomme værdier, resultater) opfylder overvågnings- og logføringskontrollerne. Sørg for, at logfilerne er usikre, bevares i den krævede periode og er tilgængelige for sikkerhedsteamet uden at kræve adgang til produktionssystemer.
Ændringshåndtering: Ændringer af MCP-værktøjsskema og A2A-agentkortopdateringer, der påvirker forbrugere, udgør grænsefladeændringer og bør være underlagt ændringsstyringskontroller. Versionsværktøjer eksplicit (omtales i MCP-indgående mønster), og behandl afbrydelse af ændringer som konfigurationsbegivenheder, der kræver godkendelse.
Tilgængelighed: Begrænsninger for agentens samtidighed, prøvetak på begivenhedsudløste mønstre og dødstavsdistribution for mislykkede begivenheder udgør tilgængelighedskontroller. Dokumenter den forventede gennemsnitsmængde og fejladfærd for hvert implementeret mønster som en del af tilgængelighedsbevispakken.
Notat: Denne liste repræsenterer ikke en komplet vejledning til at sikre overensstemmelsen af dine agentløsninger. Alle gældende bestemmelseskrav skal opfyldes.
- Kom godt i gang med Agent API
- Aktiver sikrede agenter med Data 360
- Oversigt over MuleSoft Omni Gateway
- OAuth 2.0 - politik for indsættelse af legitimationsoplysninger på vegne af
- Trusted Agent Identity for agentvirksomheden
Gulal Kumar er Software Engineering Architect hos Salesforce med over 20 års erfaring. Hans ekspertise strækker sig over AI, integration, API’er og virksomhedsarkitektur med fokus på at fremme forretningstransformation gennem sikre, fleksible og innovative AI-løsninger. Kontakt ham på LinkedIn.