Data 360-interoperabilitet
Virksomheder lagrer ofte data i Salesforce og andre eksterne datalager (f.eks. Snowflake, Google BigQuery, Databricks, Redshift eller objektlagring som Amazon S3). Afgrænsning af data på tværs af flere systemer skaber en udfordring for firmaer, der ønsker at udnytte den fulde værdi af deres data til at styrke AI-styrede oplevelser. Salesforce Data 360 er det grundlæggende intelligenslag, som enhver Agentforce AI-agent bruger til at få adgang til den korrekte kontekst på det rigtige tidspunkt.
Architekter, der arbejder på at samle data på tværs af flere datalager, står over for vigtige arkitektoniske beslutninger om, hvordan de bedst integrerer disse data. Data 360 giver flere muligheder for dataintegration, der hver tilbyder forskellige fordele og ulemper.
Denne vejledning leverer en struktur til at evaluere, hvilket mønster der bedst passer til dine krav til forsinkelse, omkostninger, skalerbarhed, styring og kompleksitet, når du integrerer data, hvilket hjælper dig med at vælge, hvornår du vil bruge dataoverførsel, Zero Copy-dataføderation eller en hybrid tilgang. Vejledningen vil også hjælpe dig med at vælge mellem forskellige metoder til dataoverførsel og dataforening, hvor hver af dem opfylder et forskelligt behov.
Integration af eksterne datalager med Data 360 kræver omhyggelig overvejelse af afvejningen mellem datafriskhed, styring og pipelineeffektivitet. Brug af f.eks. Zero Copy-dataforenings live-forespørgsler maksimerer opdateringen af dataene, men kan reducere pipelineeffektiviteten, efterhånden som flere data flyttes over netværket. For de fleste real-world-implementeringer er kombination af overførsel og federation i et multi-cloud lake house-økosystem den optimale sti. Denne hybrid tilgang sikrer en skalerbar, administreret, interoperabel arkitektur, der understøtter driftsmæssige arbejdsbelastninger med lav forsinkelse (f.eks. tilpasning i realtid og bedrageriregistrering) og analytiske arbejdsbelastninger (f.eks. reguleringsrapportering og historiske tendensanalyser). Denne vejledning hjælper dig med at bestemme, hvordan du navigerer i disse afvejninger ved brug af en relevant strategi.
- Dataoverførsel kopierer data til Salesforce Data 360 og opretter administrerede, kanoniske datamodeller. Dette er ideelt, når du har brug for at:
- Opbyg en omfattende Customer 360. Dette giver dig mulighed for at forene og transformere uensartede kilder til en enkelt, betroet profil.
- Opfylder strenge lovgivning overholdelse. Dette giver dig mulighed for at oprette en reviderbar, centraliseret kopi, så dataadgang og afstamning kan kontrolleres nøje.
- Zero Copy Federation forespørger på eksterne kilder i realtid uden duplikering, hvilket aktiverer realtidstilpasning, live-dashboards og hurtig kildeintroduktion. Denne tilgang indeholder to primære muligheder, men der er afvejninger, der skal afbalanceres:
- Liveforespørgsel: Brug dette til interaktive analyser og realtidsdatadashboards, der findes i eksterne dataplatforme (f.eks. Snowflake, BigQuery, Redshift eller Databricks). Dette hjælper med at undgå langsom, dyr dataduplikering ved at overføre forespørgselsbehandling til kildesystemet og kun returnere de nødvendige resultater. Denne tilgang er optimeret til sjældne eller ad hoc-forespørgsler, hvor friskhed er vigtig. Det er velegnet til arbejdsbelastninger med lav forespørgsel-pr. sekund (QPS) (forespørgselsomkostninger kan stige markant ved høj QPS).
- Cachelagring (Accelerated Query): Brug dette til hyppige dataforespørgsler, der ikke ændres ofte. Accelererede forespørgsler bevarer en lokal cache, der opdateres med konfigurerbare intervaller (15 minutter til 7 dage), hvilket reducerer gentagne kildehits. Denne tilgang afbalancerer dashboard-ydeevne og omkostninger, segmentering og BI-arbejdsbelastninger, hvor lidt forældede resultater er acceptable. Dette er ikke egnet til under-second beslutningstagning.
- Filforening: Brug dette til batchbehandling i stor skala og AI-modeluddannelse for data i din clouds datalager (f.eks. S3 eller ADLS). Denne tilgang undgår langsom, dyr overførsel ved direkte at forespørge på filer i åbne tabelformater, hvilket låser op for massive ETL-datasæt og datavidenskabsarbejdsbelastninger.
- Hybridmodeller kombinerer overførsel for Unified Profiles med forening for friskhed, som understøtter omni-channel-engagement, Agentforce-drevne handlinger og AI/ML-træning.
- Anvend en hybrid arkitektur. Det er ofte nødvendigt at blande dataoverførsel og federation.
- Brug dataoverførsel på kritiske data til kanoniske datamodeller og kerneadministration.
- Brug Zero Copy til alle andre dataforeninger for at bevare opdateringen og minimere de driftsmæssige udgifter ved opbygning og vedligeholdelse af dataoverførselspipelines.
- Frekvens for dataoverførsel betyder noget. Vælg frekvensen baseret på forretningsværdi, forsinkelsesbehov og driftsmæssig kompleksitet.
- Brug realtid til tidsfølsomme arbejdsflows (f.eks. tilpasning, live-dashboards og Agentforce-handlinger).
- Brug næsten realtid til moderat presserende processer (f.eks. kampagner og driftsrapporter).
- Brug batching til historiske datasæt eller datasæt med lav hastighed.
- Match Federation-mønstre til forsinkelse og ydeevne. Vælg den indstilling, der bedst matcher dine adgangsmønstre og krav til opdatering, ydeevne og omkostninger.
- Brug Live Query til driftsmæssige dashboards og tilpasning i realtid, hvor lav forsinkelse er afgørende.
- Brug cache (Accelerated Query), når forespørgsler er hyppige, og der accepteres resultater, der er lidt forældede, hvilket hjælper med at afbalancere ydeevne og omkostninger.
- Brug Filforening til storskalige, højtydende analyser eller batcharbejdsbelastninger, som er ideelle til historiske eller mindre tidsfølsomme datasæt.
- Juster styring med krav til dataplacering.
- Brug overførsel, når centraliseret styring er afgørende.
- Brug føderation, når decentraliseret styre er acceptabelt, samtidig med at man håndhæver streng styre ved den eksterne kilde.
- Brug nulkopiering med hensyn til politikker på kildeniveau (f.eks. sikkerhed på rækkeniveau (RLS) og datamaskering).
- Prioriter overførsel for arbejdsflows med høj værdi. Anvend overførsel selektivt på vigtige processer (f.eks. identitetsløsning, regulerende rapportering og driftsmæssig aktivering).
- Beslutninger om omkostninger og kompleksitet. Overførsel i realtid kan være dyrt og komplekst. Derfor er det vigtigt for arkitekter at veje omkostningerne ved introduktion, lagring og transformation af data op mod omkostningerne ved at forespørge dem direkte via Zero Copy.
Valg af det rigtige integrationsmønster – dataoverførsel, nulkopiering eller en hybrid tilgang – påvirker direkte forsinkelse, styring, driftseffektivitet og omkostninger på tværs af multi-cloud-platforme. Denne beslutning formaterer, hvordan indsigter i realtid, AI-styret aktivering og personligt engagement leveres pålideligt og på en skala.
Denne tabel sammenligner mønstre for dataoverførsel og nulkopiering i Salesforce Data 360 med fokus på funktioner, afvejninger og fordele samt anvendelsessituationer og resultater for virksomheden. Brug dette som en reference til at designe hybride, multi-cloud-dataplatforme, der afbalancerer ydeevne, omkostninger og compliance.
| Mønstertype | Tilstand/værktøj | Fordel | Overvejelser | Resultater |
|---|---|---|---|---|
| Dataoverførsel |
Realtid:
|
|
|
Agentforce:
|
Streaming:
|
|
|
Agentforce:
|
|
Batch:
|
|
|
Agentforce:
|
|
| Nulkopier |
Liveforespørgsel:
|
|
|
Agentforce:
|
Accelereret forespørgsel (cache):
|
|
|
Agentforce:
|
|
Filforening:
|
|
|
Agentforce:
|
Der er tre primære integrationsmønstre for Data 360 - dataoverførsel, nulkopieringsdataforening og en hybrid tilgang.
Med Dataoverførsel kopieres data fysisk til Data 360 og styres fuldt ud, i modsætning til Zero Copy, hvor data forbliver ved kilden. Med andre ord sker beregningen af transformationer i Data 360, som giver centraliseret styring og revision.
Brug dataoverførsel til at lagre kanoniske, administrerede datasæt i Salesforce Data 360 til overensstemmelse og driftskontrol. Brug overførsel, når der kræves fuld kontrol, revision og sporbarhed. Dataoverførsel er ideel til regulerede eller højværdiarbejdsflows, hvor centraliseret beregning og styring er afgørende.
Overførsel er egnet til opbygning af et betroet grundlag for identitetsløsning, regulerende rapportering og missionskritiske AI-styrede arbejdsflows og kundeengagement.

Dataoverførselsmetoder kan variere, afhængigt af hvilken forbindelse du bruger til at overføre dine data. Nogle forbindelser tilbyder en række overførselsmetoder, mens andre kun fungerer i batchtilstand eller streamingtilstand. Hvis du ønsker en komplet liste over Data 360-forbindelser og tilgængelige metoder, kan du se Data 360: Integrations and Connectors.
- Realtid:
- Giver sub-sekund overførsel ved hjælp af ændringsdataregistrering (CDC)
- Velegnet til tidsfølsomme arbejdsflows (f.eks. bedrageriregistrering, tilpasning og driftsmæssige dashboards)
- Funktioner med push-transformationer og aggregeringer i Data 360, hvilket hjælper med at reducere downstream I/O og optimere beregningsanvendelse
- Understøtter brug af trinvis CDC for at minimere dataombrydelse
- Streaming:
- Giver overførsel for hver 1-3 minutter i små trin
- Afbalancerer friskhed og omkostninger
- Velegnet til kampagneorkestrering, næsten live-engagement og driftsmæssig rapportering
- Understøtter brug af mikrobatches til at kontrollere I/O-spikes
- Aggregerer data ved kilden (hvis det er muligt) for at reducere overførselsmængder og optimere lagring
- Batch (planlagte indlæsninger):
- Giver regelmæssig overførsel af store datasæt (f.eks. pr. time, dagligt og ugentligt)
- Giver omkostningseffektivitet og pålidelighed for historiske datasæt, regulerende rapportering og anvendelsessituationer med overholdelse
- Sikrer, at beregningsplaceringen er i samme område som kildelageret for at forbedre ydeevnen og optimere omkostninger
- Anvendelsessituationer for dataoverførsel:
- Generer Customer 360 forenede profiler. Opbyg en enkelt kilde til sandhed for kundeidentiteter og attributter.
- Vedligeholde datasæt til overholdelse af bestemmelser. Håndhæv styring, afstamning og revisionsmulighed for følsomme data.
- Centraliser kampagneorkestrering. Sørg for, at marketing, salg og service alle fungerer fra ensartede, betroede datasæt.
- Designpraksis:
- Tilpas batchoverførsel til historiske eller lavt ventetolerante behov (f.eks. arkiveringsrapportering eller periodiske øjebliksbilleder).
- Brug CDC eller streaming-API'er til at bevare opdatering for driftsmæssige og tilpasningsarbejdsflows for at sikre opdateringer i næsten realtid.
- Kontroller lager- og beregningsvækst ved at anvende trinvise indlæsninger for at optimere omkostninger og effektivitet (i stedet for at genindlæse hele datasæt).
- Juster overførselspipelines med beregningsplacering og trinvis behandling for at reducere netværks-I/O.
- Anvend transformationer i Data 360 for at undgå unødvendig flytning af rå data.
- Overvejelser i forbindelse med omkostninger:
- Overførsel i realtid har de højeste beregnings- og pipelineomkostninger, hvilket kan være berettiget for værdifulde og tidssensitive arbejdsflows (f.eks. tilpasning, driftsmæssige dashboards eller Agentforce-drevne handlinger).
- Streaming Overførsel har moderate beregnings- og lagringsomkostninger, hvilket kan være egnet til hyppige opdateringer, der kan tåle små forsinkelser (f.eks. kampagneorkestrering eller operationel rapportering).
- Batchoverførsel har lavere beregningsomkostninger og forudsigelig lagring, som er velegnet til historiske datasæt eller lavfrekvente opdateringer. Overførsel af batchdata fra Salesforce-organisationer ved brug af bestemte forbindelser er gratis.
- Opdateringstilstand Giver dig mulighed for at vælge Inkrementel opdateringstilstand, hvilket reducerer samlede overførsels- og beregningsomkostninger. Hos Salesforce anbefaler vi, at du bruger trinvis opdatering, når det er muligt, for at optimere effektiviteten på tværs af alle overførselstyper.
- Omkostningen påvirkes også af I/O-mængden fra kilden til Data 360. Optimering af batchstørrelser, partitioner og regional justering reducerer overførselsomkostninger og forbedrer ydeevnen.
- Branchescenarier:
- Finance: Overførselsdatasæt er påkrævet for Knowing Your Customer (KYC), Anti Money Laundering (AML) og svigregistrering, hvor revisionsevne og compliance ikke kan forhandles.
- Sundhedspleje: Brug overførsel til løsning af patientidentitet og HIPAA-kompatible registreringer, hvilket aktiverer sikre, forenede visninger.
- Detail: Konsolider data fra salgssteder (POS), eCommerce og loyalitetsprogrammer i forenede profiler til segmentering og personliggørelse.
- Telekom: Understøt afgangsforebyggelse og anvendelsesanalyser med kanoniske, administrerede abonnentdata.
| Funktion | Overførsel i realtid | Streamingoverførsel | Batchoverførsel |
|---|---|---|---|
| Lateness og friskhed | Funktioner sekunders forsinkelsesoverførsel via overførsels-API'er med understøttelse af ændringsdataregistrering (CDC). Leverer kontinuerlige streaming-pipelines. Velegnet til driftsmæssige anvendelsessituationer med lav forsinkelse. | Funktioner af mikrobatchoverførsel for hver 1-3 minutter via oprindelige forbindelser. Understøtter trinvise opdateringer. Der forventes en lille forsinkelse. | Dataforsinkelse forventes. Tillader planlagte store indlæsninger. Funktioner med periodisk overførsel (time, dagligt og ugentligt). Ikke egnet til tidsfølsomme handlinger. |
| Primære anvendelsessituationer | Ideel til anvendelsessituationer med lav forsinkelse og tilpasning. Bruges til tidssensitive arbejdsflows. Understøtter begivenhedsstyrede arbejdsflows. Bruges til realtidsbedragerialarmer og driftsmæssige advarsler. | Velegnet til moderat vigtige processer. Bruges til kampagneorkestrering, næsten live-engagement og driftsmæssig rapportering. Bruges til rettidige kampagneudløsere. | Omkostningseffektiv for massive datasæt. Pålideligt for historiske analyser. Bruges til historiske aggregeringer eller regulerede rapporteringsarbejdsflows. Velegnet til historiske datasæt eller datasæt med lav hastighed. |
| Arkitektonisk kompleksitet og I/O | Inkluderer høj pris og kompleks arkitektur. Kræver kildesystemer med lav forsinkelse. I/O intensiv. Højvolumen kilder kan forårsage mættede pipelines. | Funktioner med en enklere arkitektur end i realtid. I/O er moderat. Velegnet til forudsigelige, gentagne opdateringsmønstre. Batchstørrelse påvirker hukommelse og beregning. | Nem at implementere. I/O intensiv under indlæsningsvinduer. Netværksgennemstrømning kan blive en flaskehalse for store batches. |
| Overvejelser i forbindelse med omkostninger | Inkluderer de højeste beregnings- og pipelineomkostninger. Kun berettiget for højværdi, tidsfølsomme arbejdsflows. | Inkluderer moderate beregnings- og lagringsomkostninger. Giver en afbalanceret omkostnings- kontra-friskhed-tilgang. Velegnet til hyppige opdateringer, der kan tolerere små forsinkelser. | Funktioner med lavere beregningsomkostninger og forudsigelig lagring. Anbefales til historiske datasæt eller opdateringer med lav frekvens. Overførsel via interne Salesforce-pipelines er gratis. |
| Design Practices | Brug trinvis CDC til at minimere dataombrydning. Filtrer og brug selektive felter til at reducere overhead. | Brug mikrobatches til at kontrollere I/O-spikes. Overvej vinduesaggregering for at reducere behandlingsbelastning. | Bruges til arkiveringsrapportering eller periodiske øjebliksbilleder. Sørg for, at beregningsplaceringen er i samme område som kildelager for at optimere omkostningerne. |
Brug Zero Copy til forespørgsler i realtid på eksterne systemer uden dataduplikering for at muliggøre smidighed, opdatering og skalerbar adgang til store eller midlertidige datasæt. Den er velegnet til live-dashboards, udforskningsanalyser, AI/ML-modeluddannelse og kundeengagement i realtid direkte gennem Salesforce Data 360.
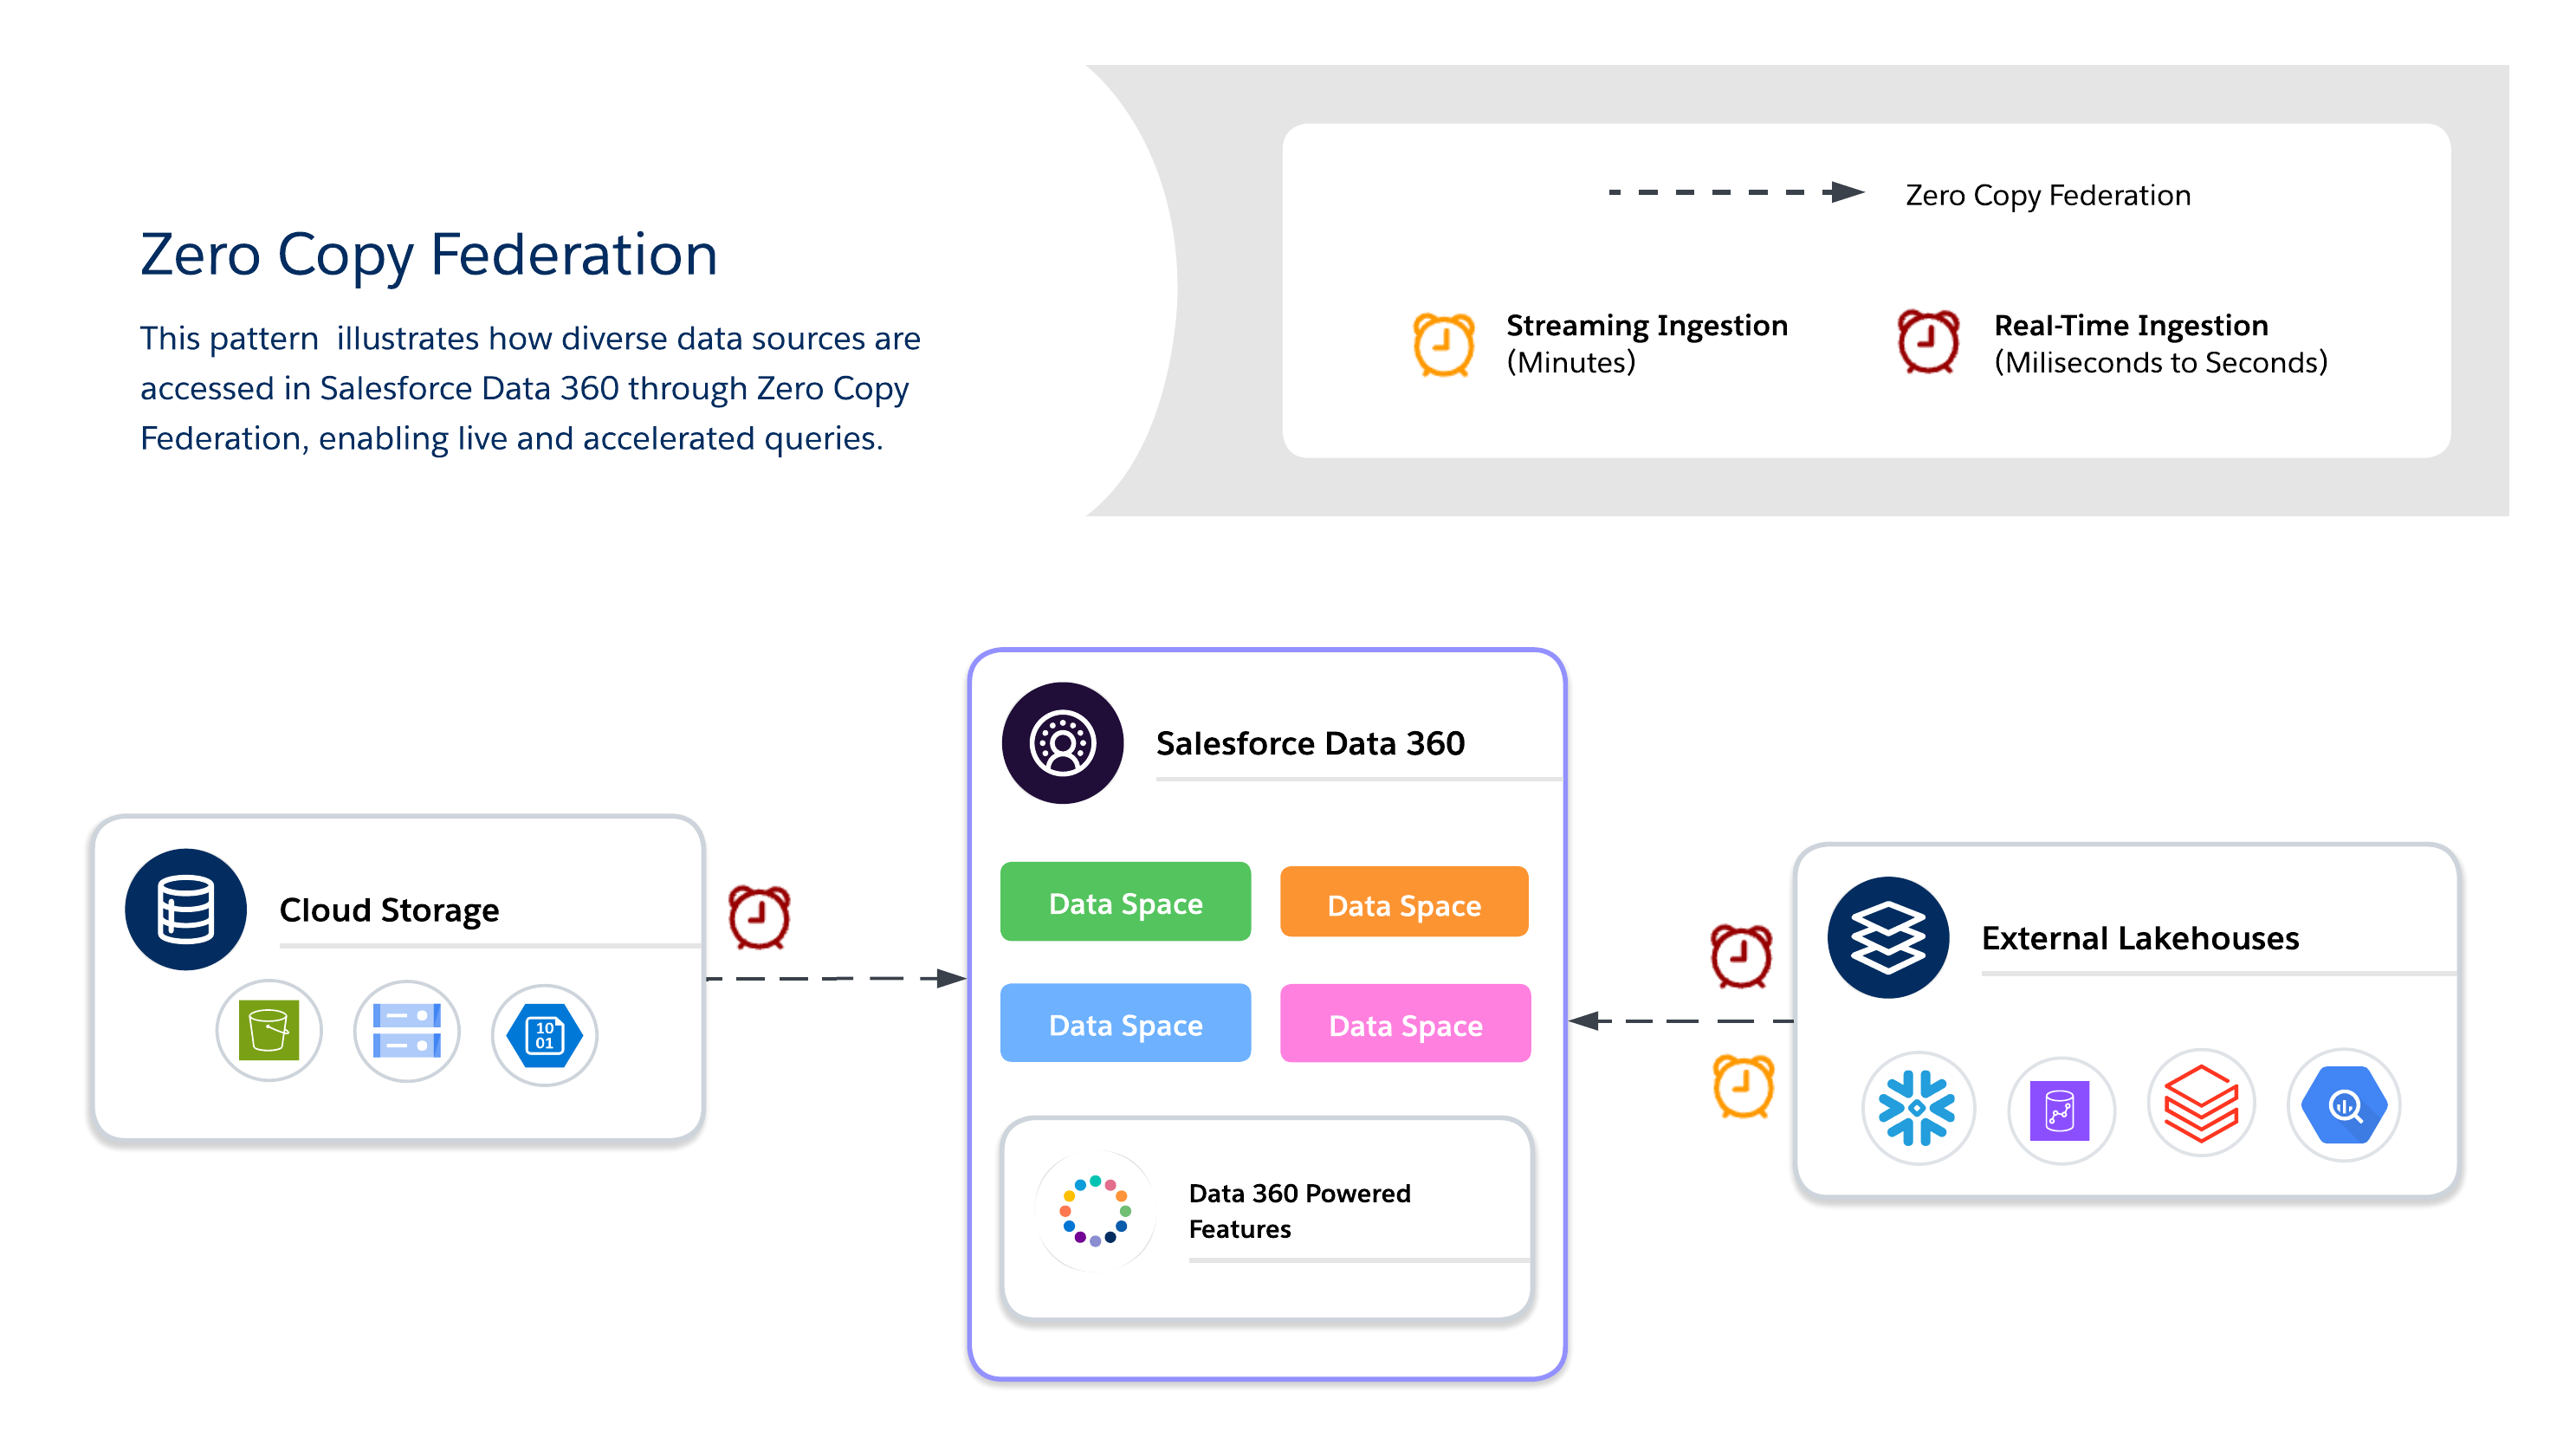
Når du bruger Zero Copy, skal arkitekter vælge mellem tre tilgængelige dataforeningsmetoder, der hver især tilbyder deres egen kompromis mellem friskhed, ydeevne og omkostninger.
- Liveforespørgsel
- Kører forespørgsler direkte mod eksterne systemer (f.eks. Snowflake, Google BigQuery, Redshift, Databricks osv.) uden dataduplikering.
- Minimerer dataoverførsel over netværket og reducerer I/O på Salesforce Data 360-beregningen, hvilket er optimalt, når prædikater og aggregeringer kan skubbes ned.
- Velegnet til indsigter i realtid og driftsmæssige dashboards med lav forsinkelse.
- Afhængig af ekstern systemydeevne.
- Cachelagring (Accelerated Query)
- Gemmer midlertidigt cachelagrede kopier af forenede data i Salesforce Data 360.
- Reducerer gentagne forespørgselsomkostninger og forsinkelse for hyppigt åbnede datasæt med konfigurerbar varighed (minutter til dage).
- Data kopieres ikke permanent eller administreres ikke fuldt ud, så opdatering administreres via planlagte opdateringer fra kilden.
- Inkrementopdatering understøtter kun upserts. Slettede registreringer fjernes ikke fra cachen.
- Udfør en fuld opdatering regelmæssigt for at sikre, at cachen forbliver synkroniseret med kilden.
- Bemærk: Snowflake-forbindelsen understøtter funktionen Uload, som forbedrer accelerationshastigheden ved brug af en Snowflake-initieret faseinddeling. Dette er aktiveret som standard, men det kan inaktiveres ved at redigere forbindelsen.
- Filforening
- Giver direkte skrivebeskyttet adgang til datasæt i stor skala i objektbutikker (f.eks. S3 og GCS med Iceberg).
- Velegnet til AI/ML-arbejdsbelastninger, historiske analyser og petabyte-skalarapportering uden at flytte data.
- Forespørgselsydeevne afhænger i høj grad af objektformat, partitionering og netværks-I/O. Store scanninger kan generere væsentlig I/O, hvis de ikke optimeres.
- Brug sager
- Tilpasning i realtid og adaptive arbejdsflows giver dynamiske tilbud, anbefalinger og de bedste handlinger i takt med, at kundeadfærden ændres.
- Live-dashboards og driftsanalyser styrker forretningskritiske dashboards og KPI'er direkte fra eksterne lagerbygninger.
- AI/ML modeluddannelse med store eksterne datasæt udnytter data i petabyte-skala fra datalager og lagerbygninger uden at flytte dem via filforening.
- Branchescenarier
- Detail/Media: Aktiver personlige anbefalinger og kundeengagement i realtid ved at forbinde clickstream- eller indholdsinteraktionsdata.
- Finance: Kør bedrageriregistrering og risikoscoring i næsten realtid ved at forespørge på eksterne lagerbygninger uden at duplikere følsomme data.
- Tech/Enterprise: Understøt cross-cloud-rapportering, it-servicedashboards og driftsanalyser, når datasæt findes i flere systemer.
- Design Practices
- Liveforespørgsel
- Bruges til forespørgsler med høj QPS og lav forsinkelse, når friskhed er vigtig.
- Overfør prædikater og aggregeringer til det eksterne system for at reducere dataskydning over netværket.
- Undgå forespørgsler, der unødvendigt scanner store datamængder.
- Overvej i stedet partitionsopdelinger og filtre.
- Filforening
- Få adgang til datasæt på petabyte-skala i objektbutikker uden overførsel.
- Minimer forsinkelse og udgangsomkostninger ved at bevare objektlagring i samme Cloud-område som Salesforce-beregning.
- Brug partitionerede, kolonneformater (Parket/ORC) og push-down-filtre til at reducere I/O og netværksoverførsel.
- Anvend forespørgsel og prædikat-push-down for at filtrere og aggregere data ved kilden, hvilket reducerer dataflytning.
- Undgå tværgående dataadgang – medmindre det er absolut nødvendigt – da det øger I/O, forsinkelse og omkostninger.
- Cachelagring (Accelerated Query)
- Sæt hyppigt åbnede datasæt i cache for at afbalancere omkostninger og ydeevne.
- Konfigurer opdateringsintervaller for at afbalancere opdatering kontra forespørgselsomkostninger.
- Overensstemmelse: Håndhæv styring ved kilden ved at udnytte sikkerhed på rækkeniveau (RLS) og maskere politikker direkte i forenede systemer.
- Her er nogle få bedste fremgangsmåder for ensartet RLS og maskering på tværs af platforme:
- Brug et centraliseret virksomheds-id. Tilknyt brugere og enheder i Salesforce Data 360 til en entydig, centraliseret virksomhedsidentifikator, der svarer til identiteter i eksterne systemer.
- Analyser sikkerhedspolitikker. Sørg for, at RLS og maskeringspolitikker i forenede systemer anvendes baseret på den tilknyttede identitet. Dette bevarer overensstemmelse, når der forespørges på eksterne data.
- Standardiser identitetsskemaer. Vedligehold ensartede identitetsattributter (mail, bruger-id, kunde-id osv.) på tværs af alle datakilder for at undgå uoverensstemmelser og adgangsovertrædelser.
- Her er nogle få bedste fremgangsmåder for ensartet RLS og maskering på tværs af platforme:
- Liveforespørgsel
- Overvejelser i forbindelse med omkostninger
- Liveforespørgsel: I betalingsforespørgselsmodellen opkræves omkostninger på beregning af eksternt søhus, hvilket kan medføre spids med høj QPS. Dette er velegnet til anvendelsessituationer, hvor værdien er større end omkostningsvariablen.
- Accelereret forespørgsel (cache): Denne metode reducerer forespørgselsomkostninger (i sammenligning med Live-forespørgsel) ved at reducere hits til kildesystemet, men det tilføjer omkostninger til batchdataoverførsel til udfyldning og opdatering af cachen. Dette er velegnet til hyppigt åbnede datasæt.
- Filforening: Dette er den billigste lagringsindstilling som data i objektlager. Men forespørgselsomkostninger afhænger af filstørrelse, partitionering og beskæring. Dette er velegnet til historiske eller massedata på petabyte-skala.
| Beslutningspunkt | Live-forespørgsel | Cachelagring (Accelerated Query) | Filforening |
|---|---|---|---|
| Datakildeplacering | Eksterne datalager (f.eks. Snowflake, Google BigQuery, Redshift og Databricks) | Eksterne datalager (f.eks. Snowflake, Google BigQuery, Redshift og Databricks) | Objektbutikker eller Cloud-datalager (f.eks. S3, ADLS og GCS), der ofte bruger åbne tabelformater som Iceberg. |
| Formål/anvendelsessituation | Velegnet til interaktive analyser og realtidsdashboards. Velegnet til tilpasning i realtid og dynamiske arbejdsflows. | Velegnet til, når forespørgsler er hyppige, men lidt forældede resultater er acceptable. Velegnet til BI-dashboards og segmentering. | Velegnet til batchbehandling i stor skala og AI/ML-modeluddannelse. Velegnet til historiske analyser og petabyte-skalarapportering. |
| Freshness/Latency | Giver maksimal opdatering Kører forespørgsler direkte i realtid. Understøtter under-sekund beslutningstagning, når kildesystemet optimeres til forespørgsler med lav forsinkelse med effektiv prædikat-pushdown. | Bruges, når lidt forældede resultater er acceptable. Friskheden afhænger af cacheintervallet, som kan konfigureres fra 15 minutter til 7 dage. | Velegnet til batchtunge, gennemsnitskrævende job. Ikke egnet til dashboarding i realtid. |
| Adgangsmønster | Velegnet til sjældne eller ad hoc-forespørgsler, hvor opdatering er kritisk, og forespørgselsvolumen er lav. Omkostninger stiger markant ved høj QPS, så det er vigtigt at evaluere cachelagring (Accelerated Query), når forespørgselsfrekvensen er høj. | Velegnet til højfrekvent læsescenarier. Forbedrer ydeevnen for hyppige adgangsmønstre. | Giver skrivebeskyttetead-only adgang. Velegnet til datasæt på petabyte-skala uden overførsel. |
| Ydeevnedrivere | Højt afhængig af ekstern kildesystemydeevne. Velegnet til, når prædikater og aggregeringer kan overføres ned til kilden. | Reducerer forsinkelse sammenlignet med gentagne live-forespørgsler. Ydeevne afhænger af cachestyring og intervaller. | Ydeevne afhænger i høj grad af objektformat, partitionering og ekstern systemgennemstrømning. Brug partitionerede, kolonneformater (Parket/ORC). |
| Omkostninger | Dette er en betalingsforespørgselsmodel, så omkostninger opkræves på eksterne Lake House-beregninger. Det er omkostningseffektivt for sjældne forespørgsler, men udgifter kan stige med høj QPS-volumen. | Omkostningerne er lavere end gentagne live-forespørgsler. Det reducerer behovet for gentaget at forespørge på den eksterne kilde, men det tilføjer cachelagring og opdatering overhead. | Dette er den billigste lagringsindstilling. For AWS-opsætninger i samme område (f.eks. S3 i US-East-1 med en Data Cloud-lejer, der også er i US-East-1), forbruges kreditter ikke for de rækker, der åbnes. Tværgående eller tværgående konfigurationer (f.eks. Azure, GCS eller forskellige AWS-områder) medfører kreditforbrug for de rækker, der åbnes. Forespørgselsomkostninger afhænger også af filstørrelse, partitionering og prædikat-push-downoptimering. |
| Nøgleovervejelser | Undgå ufiltrerede forespørgsler, der scanner massive datamængder unødvendigt. | Denne tilgang kræver cachestyring. Ikke egnet til under-second-beslutning. | Forespørgselsydeevne er stærkt afhængig af optimering via partitionering og prædikat-push-down. |
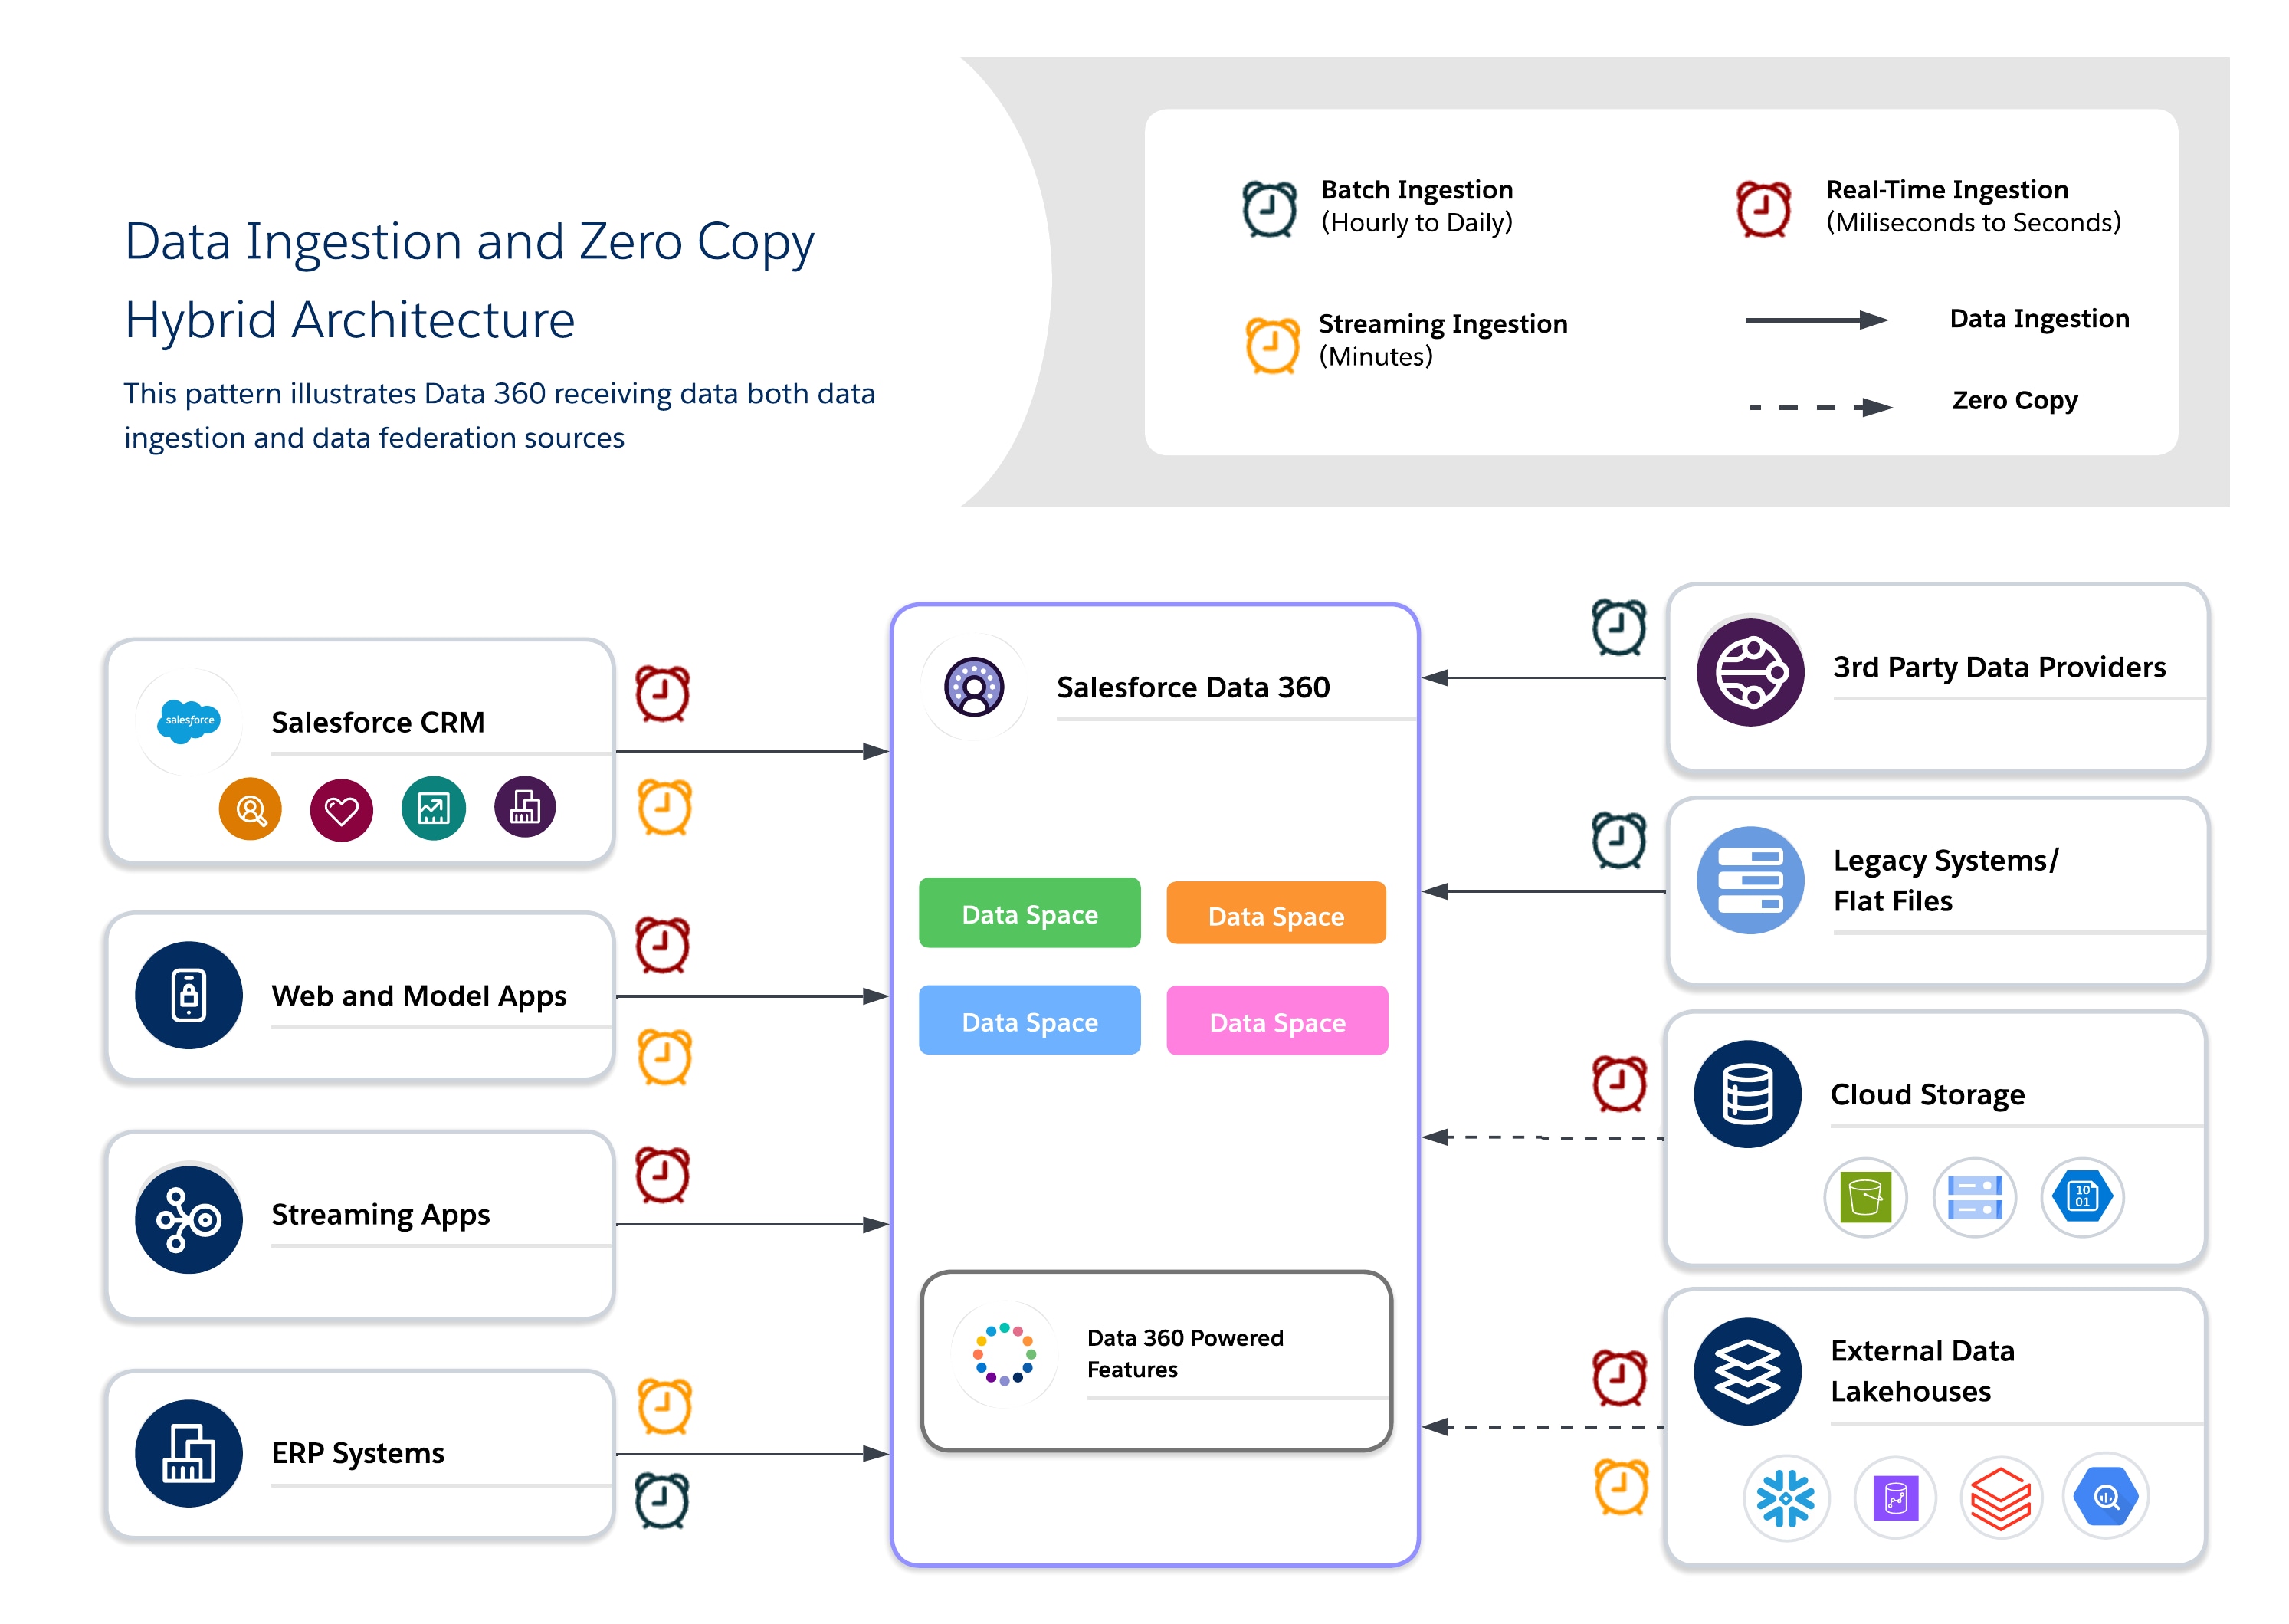
Hybridarkitekturer gør det muligt for arkitekter at forankre kritiske datasæt i Data 360 til centraliseret styring, samtidig med at de udnytter forespørgsler for at opnå opdatering, reducere duplikering og skalerbar adgang til store eksterne datasæt. Denne tilgang afbalancerer I/O, beregningsplacering, omkostninger og compliancekrav.
Brug en hybrid tilgang til afbalanceret styring, opdatering og driftseffektivitet ved at kombinere dataoverførsel og nulkopiering for at levere indsigter, der kan handles på, i realtid. Brug overførsel til højværdi, regulerede datasæt, hvor sporbarhed, RLS og maskering er påkrævet, og federation til midlertidige eller højvolumen datasæt, hvor opdatering og ydeevne er nøglen.
- Brug sager
- Omni-Channel-engagement: Blend historiske kundedata med realtidsadfærd for at levere ensartede kontekstbevidste oplevelser.
- AI/ML-rørledninger: Træn modeller på organiserede, kanoniske datasæt, mens du beriger dem med rå eller realtidssignaler fra eksterne kilder.
- Blandt behov for overensstemmelse og smidighed: Anvend streng styring for følsomme data og federation for driftsmæssig smidighed.
- Branchescenarier
- Detail: Brug overførsel til identitetsløsning og profilforening, og føderation til tilbud i realtid og personliggørelse.
- Sundhedspleje: Vedligehold gyldne patientregistreringer via overførsel, mens du bruger federation på IoT-enhedsstreams og sensordata for øjeblikkelig kontekst.
- Finansielle tjenester: Overfør regulerede data til en overensstemmelsesstyret sø, mens du bruger federation til eksterne forespørgsler om bedrageriregistrering og risikovurdering.
- Design Practices
- Ankerstyring med overførsel: Overfør data af høj værdi eller regulerede data til kanoniske modeller for at sikre Trust og compliance.
- Brug Federation til friskhed: Tillader eksterne lakehuse at levere realtids- eller dataadgang i stor skala uden duplikering.
- Saldoomkostninger vs. ydeevne: Profiler arbejdsbelastninger for at bestemme, hvornår der skal bruges overførsel kontra federation, hvilket minimerer unødvendige lagrings- og forespørgselsomkostninger.
- Anvend lagdelt ledelse: Håndhæv centraliseret ledelse for overførte data, mens du udnytter de forenede systemers sikkerhedskontroller (f.eks. RLS og maskering).
- Bemærk: Når du designer hybride pipelines, er det vigtigt at sikre trinvis overførsel for historiske datasæt og overføre aggregeringer eller filtre til forenede kilder for at optimere I/O og beregningsanvendelse.
- Overvejelser i forbindelse med omkostninger
- Vægt de samlede omkostninger i forhold til ydeevne ved at kombinere overførsel for overensstemmelse eller kritiske data med federation, når der er behov for friskhed.
- Regnskab for I/O og computerdistribution ved blanding af overførsel og federation. Hvis du vil reducere beregningsomkostningerne for gentagne forespørgsler mod kildesystemer, skal du bruge cachelagring (Accelerated Query) for højtlæste, hyppigt tilgængelige forenede datasæt.
- Brug denne regel til at guide beslutningen over overførsel kontra federation: Når der ofte opnås adgang til data, men de ændres sjældent, er Accelerated Query typisk mere omkostningseffektivt. Men når data ændres hyppigt (i forhold til adgangsfrekvens), er liveforespørgsel eller overførsel mere passende. Her er nogle få omkostningseksempler:
- Acceleration vinder: Et dashboard, der er bygget fra 1M registreringer og opdateres dagligt med ~10K ændringer, vises 20 gange pr. dag. Acceleration omkostninger svarer til omkring ~ 600 credits / måned mod ~ 4.200 credits / måned for Live-forespørgsler.
- Live-forespørgsel vinder: Segmenter, der udgives 20 gange pr. dag ved brug af data, der ændres for hver 30 minutter. Live-forespørgsler koster cirka ~ 4.200 credits/måned mod ~ 28.800 credits/måned for acceleration ved denne opdateringsfrekvens.
Lad os se nærmere på nogle få almindelige arketyper, der illustrerer, hvordan denne logik anvendes.
- Den "enkle kilde til sandhed" Archetype: Centraliser og styr
- Scenarie: Du skal opbygge kompatible, forenede Customer 360 profiler for hele din globale virksomhed. Dataene kommer fra et dusin forskellige systemer, det skal overholde strenge GDPR og CCPA bestemmelser, og det vil tjene som kilden til sandheden for alle marketing og serviceinteraktioner.
- Anbefalet mønster: Dataoverførsel. Prioriteten her er styring, Trust og kontrol. Overførsel af dataene til Data 360 er den eneste måde at oprette en fuldt reviderbar, kanonisk profil, der er isoleret fra kildesystemerne.
- Arketypen "Indsigter i realtid": Analyser uden at flytte
- Scenarie: Dit datavidenskabsteam skal køre udforskende forespørgsler på en massiv, konstant opdateret transaktionstabel i Snowflake. Samtidig ønsker dit ledelsesteam et live BI-dashboard, der er drevet af de samme data. Flytning af petabyte af data dagligt er langsom og dyrt.
- Anbefalet mønster: Zero Copy Federation. Prioriteten her er hastighed, smidighed og omkostningseffektivitet på skala. Zero Copy giver dig mulighed for at udnytte styrken i dit eksisterende datalager til forespørgsler i realtid uden overhead og forsinkelse af dataduplikering.
- Arketypen "Hybrid intelligens": Styr kerne, Føderer kanten
- Scenarie: Du ønsker at berige dine administrerede, overførte kundeprofiler med adfærdssignaler i realtid (f.eks. websiteklik) fra en datalake. Du skal have stabiliteten af kerneprofilen, men umiddelbarheden af live-dataene for at styrke tilpasningen i øjeblikket.
- Anbefalet mønster: A Hybrid Approach. Brug dataoverførsel til at oprette en stabil, styret kerne for dine kundedata. Brug Zero Copy til at forbinde de flydende, "kantede" data i realtid og derefter forbinde dem på forespørgselstidspunktet for at få en komplet visning, der går helt op i sekunden.
Virksomhedsdatastrategi er ikke længere fokuseret på valg af et enkelt integrationsmønster – det handler om at arkitektere kontrolleret fleksibilitet i et interoperabelt dataøkosystem. Den korrekte tilgang tilknytter hvert kildesystem til det mønster, der bedst passer til dets opdaterings-, styrings-, omkostnings- og adgangskrav:
- Overfør missionskritiske, regulerede datasæt til Salesforce Data Cloud for overensstemmelse, identitetsløsning og driftsmæssige arbejdsflows.
- Føder data via Zero Copy for live, udforskende og AI-drevne analyser uden at duplikere lageret.
- Anvend cache (Accelerated Query) til at reducere kildesystemets belastning og kreditforbrug, når forespørgselsfrekvensen er høj og dataændringsfrekvensen er lav
Salesforce Data 360 på Hyperforce giver fleksibilitet og skalerbarhed for flere områder. Dens åbne søhus med Iceberg borde muliggør beregning adskillelse og interoperabilitet med platforme som Snowflake, Databricks og S3 Iceberg, som udgør ryggen af en virkelig interoperable, multi-cloud data økosystem.
Efterhånden som dataøkosystemer udvikles, skal vi kontinuerligt afbalancere opdatering, omkostninger, ydeevne og overensstemmelse for at bevare arkitektonisk smidighed. Det er derfor, det er vigtigt at sikre din platform i fremtiden ved at forene overførte, administrerede data med forenet adgang. Dette aktiverer realtidsdata, AI-aktivering og tilpasning på virksomhedsskala på tværs af Clouds, områder og forretningsdomæner.
Husk på, at løsninger, der passer til alle, ikke passer til de fleste forretninger. Den optimale strategi tilknytter det korrekte mønster til den korrekte forretningsdriver.
Yugandhar Bora er Software Engineering Architect hos Salesforce, der er specialiseret i dataarkitektur inden for platformen Data og intelligensapplikationer. Han leder _EARB-_initiativer, der fokuserer på datastyring og forenede datamodeller, samtidig med at han bidrager til automatiserede platformsprovisioneringsløsninger.
Jan Fernando er chefarkitekt på Salesforces Office of Chief Architect (OCA), der tiltrådte Salesforce i 2012. Han har stor erfaring fra sin tid i startup-økosystemet. Før han tilsluttede sig OCA, tilbragte han over ti år i organisationen Platform, hvor han ledede flere vigtige teknologiske transformationer.